
10月12日,全球AI大模型排行榜前30
1
引言
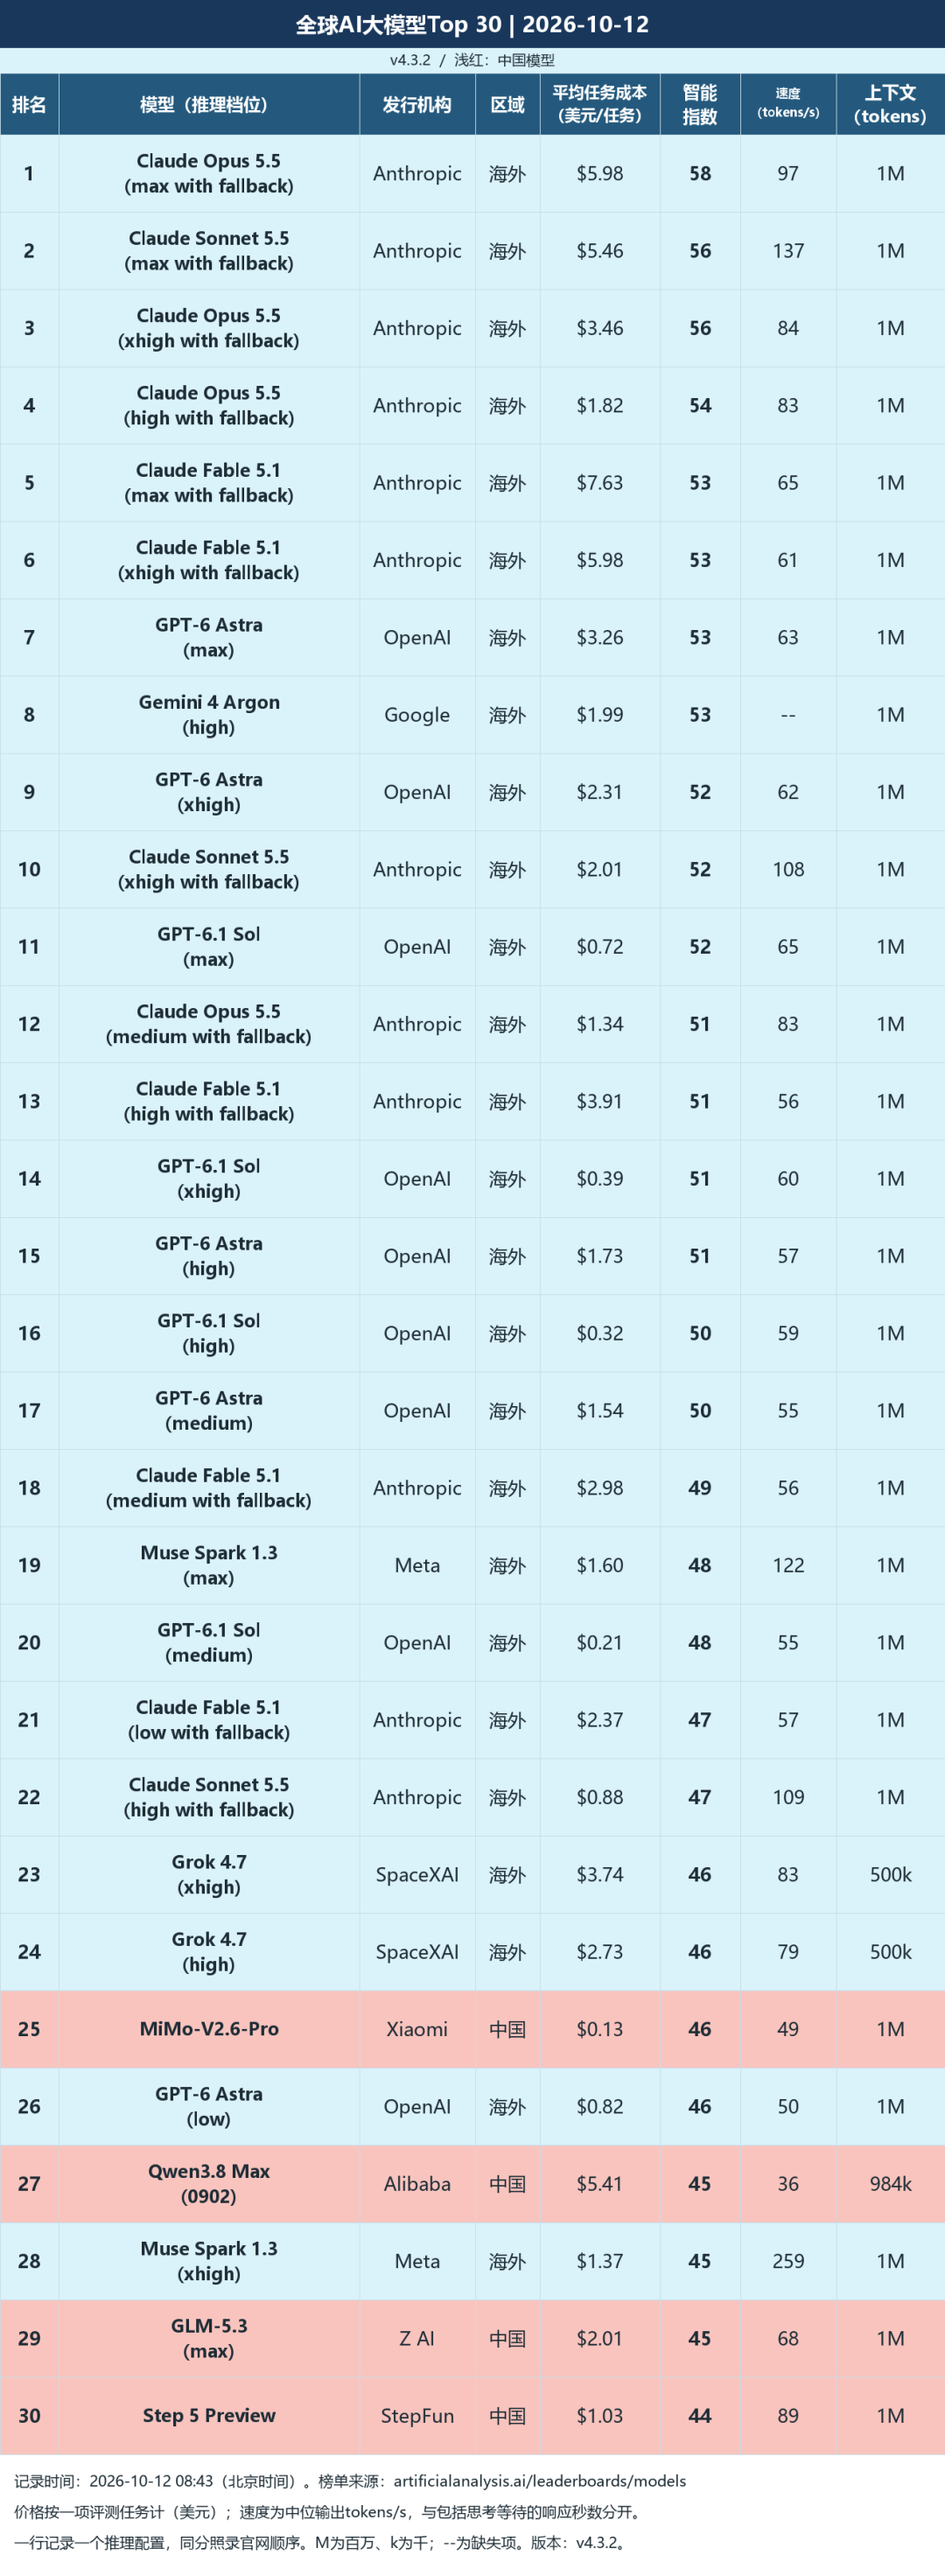
对比10月7日已发布榜单,前30的名单与分数没有变化,但Sonnet 5.5和Step的任务成本更新了。完整30名放在下图,浅红色标出中国模型,图后再看哪些变化值得注意。
2
Top 30完整榜单
3
今天有哪些信息值得注意?
Claude 5.5仍占前四,Sonnet成本降低了
第一名仍是Claude Opus 5.5(max with fallback),58分,每项评测任务平均成本5.98美元。第二名Sonnet 5.5(max with fallback)为56分,成本改为5.46美元。上期这一行是7.67美元,本次低约29%。因此,10月7日文章里“Sonnet max比Opus max贵”的比较,在今天的快照中已经不成立。
不过,同为56分的Opus 5.5(xhigh with fallback)只需3.46美元,比Sonnet max低约37%。Sonnet变便宜,并不意味着它是同分配置里成本最低的一项。第4名Opus high为54分、1.82美元;如果不一定要追求58分,这一档也值得拿自己的材料试一遍。
另外两档Sonnet也变了:xhigh从2.75美元降至2.01美元,high从1.12美元降至0.88美元,显示分数分别仍为52和47。这里记录的是榜单任务成本的变化,不是模型能力提高,也不能直接表述成API单价降了相同比例。完成任务用了多少token、按什么价格核算,需要另查具体评测说明。
GPT-6.1 Sol:52分,成本仍为0.72美元
GPT-6.1 Sol(max)仍排第11,52分、0.72美元;第7名GPT-6 Astra(max)为53分、3.26美元。两行与上期的分数、成本相同。Sol的平均任务成本约为Astra的22%,这个差距没有随着Sonnet成本调整而消失。
Sol进入前30的四档依次是:max为52分、0.72美元,xhigh为51分、0.39美元,high为50分、0.32美元,medium为48分、0.21美元。从medium加到max,多4个显示分数,成本约为原来的3.43倍。综合分数不是准确率,不能把这4分理解成每道题的正确率提高4%。
时间也要单独看。本次Sol max为65 tokens/s,端到端响应时间355.42秒;high为59 tokens/s、73.08秒,medium为55 tokens/s、16.56秒。档位越高,输出速度未必明显变慢,但整次响应的等待可能长得多。这些是官网测量值,不是读一篇论文的固定耗时。
中国模型位置未变,Step成本升至1.03美元
MiMo、Qwen、GLM、Step仍在第25、27、29、30,显示分数依次为46、45、45、44。与10月7日逐行对照,前30没有换入新配置,也没有谁因显示分数提高而升名次。没有发生的排名变化,就不必写成“榜单洗牌”。
变化在Step 5 Preview的成本:上期为0.72美元,本期为1.03美元,高约43%,分数仍是44。它依然比Qwen3.8 Max(0902)的5.41美元和GLM-5.3(max)的2.01美元低,但不能继续沿用上期的0.72美元做预算比较。费用变了,分数没有跟着变,这是这一行应当提醒读者的地方。
MiMo-V2.6-Pro仍是前30中任务成本最低的一项,46分、0.13美元。本次输出速度为49 tokens/s。Kimi K3(max)在第31,同样44分,因截取范围落在图外。官网同分条目的先后照录,不另加成本或速度排序;入围与否不能单独用来判断模型是否适合自己的任务。
Haiku 5.5得43分,为什么没进前30?
官网10月7日的更新日志记录了Claude Haiku 5.5的评测。今天max配置得到43分,每项任务0.21美元,排第32;本期前30最后一行是44分。所以,这张图里看不到Haiku,并不是忘了收录,而是它尚未进入前30的范围。
这行仍有值得看的数字:max输出235 tokens/s,但端到端响应时间为302.13秒。high配置是38分、0.08美元、179 tokens/s,端到端响应时间27.12秒。不能看到235 tokens/s就断定max适合快速交互;开始输出之前的等待,也属于一次回答的时间。
对于批量整理摘要或抽取论文信息,Haiku可以作为榜外候选加入测试,而不是因为没进前30就排除。先固定字段和输出格式,检查漏项、引用是否对应原句,再比较每批材料的费用与总耗时。43分只能帮助定位它在综合榜上的位置,不能替代这类具体任务的验证。
我怎么看这次更新?
这次最值得改的,未必是模型选择,而是比较时使用的数字。Sonnet max从7.67变成5.46美元,Step从0.72变成1.03美元,名次和显示分数却都没变。只记住“第几名”,会漏掉这两项变化;只拿上期截图算账,也可能把成本关系算反。
做论文阅读,我会先比较两档对同一批材料的回答:研究对象、数据集、实验设置和主结果有没有漏掉,引用是否真能在原文找到。回答更长却没有减少这些错误,还不足以说明更高档位值得多付钱。榜单的每项任务成本也不等于我们每篇论文的成本,后者要按实际输入、输出和调用次数记录。
数据来源: Artificial Analysis LLM Leaderboard(https://artificialanalysis.ai/leaderboards/models)
评测方法: Artificial Analysis Intelligence Index v4.3.2(https://artificialanalysis.ai/methodology/intelligence-benchmarking)
官方更新日志: Artificial Analysis Changelog(https://artificialanalysis.ai/changelog)
数据截点: 2026年10月12日;