
ReplaySSM:重新思考状态存储,加速混合模型解码
混合模型在少量注意力层之间穿插状态空间模型(SSM)层。NVIDIA Nemotron 3、Qwen3.5 至 Qwen3.8、Kimi-K3 和 GLM-5.3-Flash 都采用这种架构,其 SSM 层使用 Mamba-2、Gated DeltaNet(GDN)或 Kimi Delta Attention(KDA)。
SSM 层的设计目标就是加速解码:它用固定大小的状态取代随上下文长度增长的 KV cache。然而在实际服务的 batch 规模下,直到 100K token 的上下文长度,延迟瓶颈都可能出在 SSM 层而非注意力层上。此外,推测解码和量化这两种能有效加速注意力解码的技术,在 SSM 层上也变得复杂。
ReplaySSM 让 SSM 层重新成为快的部分。它把 SSM 状态表示为一个 checkpoint 加上一个近期输入的缓冲区,从而把输出计算与状态更新解耦,解决了当前 SSM 解码中的三大难题:状态数据传输、推测解码的回滚,以及量化状态中的误差累积。
ReplaySSM 是 NVIDIA 与普林斯顿大学 Dao AI Lab 的合作成果。论文 ReplaySSM: Cache SSM Inputs, Not State 详细阐述了这三大优势并给出了完整评测,已发布于 arXiv,代码在 GitHub 上。它已集成到 NVIDIA TensorRT-LLM、vLLM 和 FlashInfer 中,并在 GLM-5.3-Flash 和 Kimi-K3 的生产环境中实际运行。
SSM 层为何会成为解码瓶颈
以 NVIDIA Nemotron 3 Ultra 中使用的 Mamba-2 层为例,它通过以下递归公式解码单个 token:
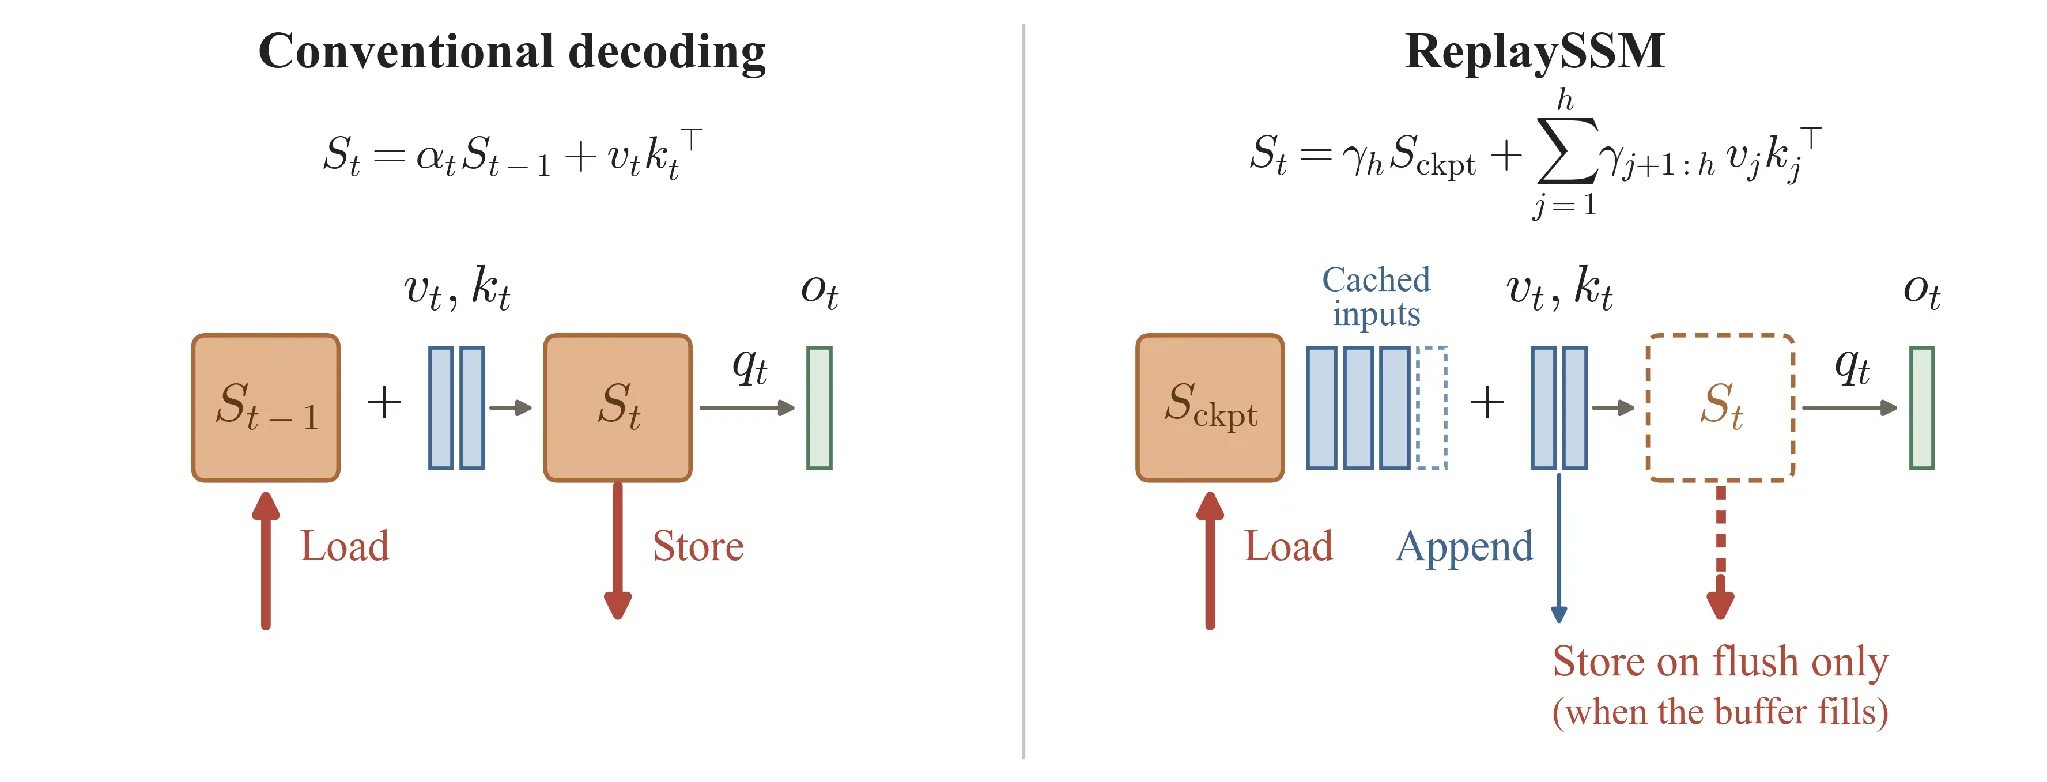
$S_t = \alpha_t S_{t-1} + v_t k_t^\top, \qquad o_t = S_t q_t,$其中 $S_t$ 是状态,$\alpha_t$ 是数据依赖的衰减系数,$v_t$、$k_t$ 和 $q_t$ 分别是 token 的输入。每步先从高带宽内存(HBM)加载 $S_{t-1}$,应用衰减并执行秩-1 更新,计算输出 $o_t = S_t q_t$,再将 $S_t$ 写回。GDN 和 KDA 额外引入了 delta-rule 修正,但其更新也可写成相同的外积形式,因此下文讨论同样适用于它们。
解码过程中,状态承担两项职责:一是读取以生成当前 token 输出,二是更新以得到下一 token 的状态。传统解码将二者合并执行:每步更新状态、读取输出并存储供下一步使用。由此带来的三重挑战皆源于这种融合。
状态内存流量
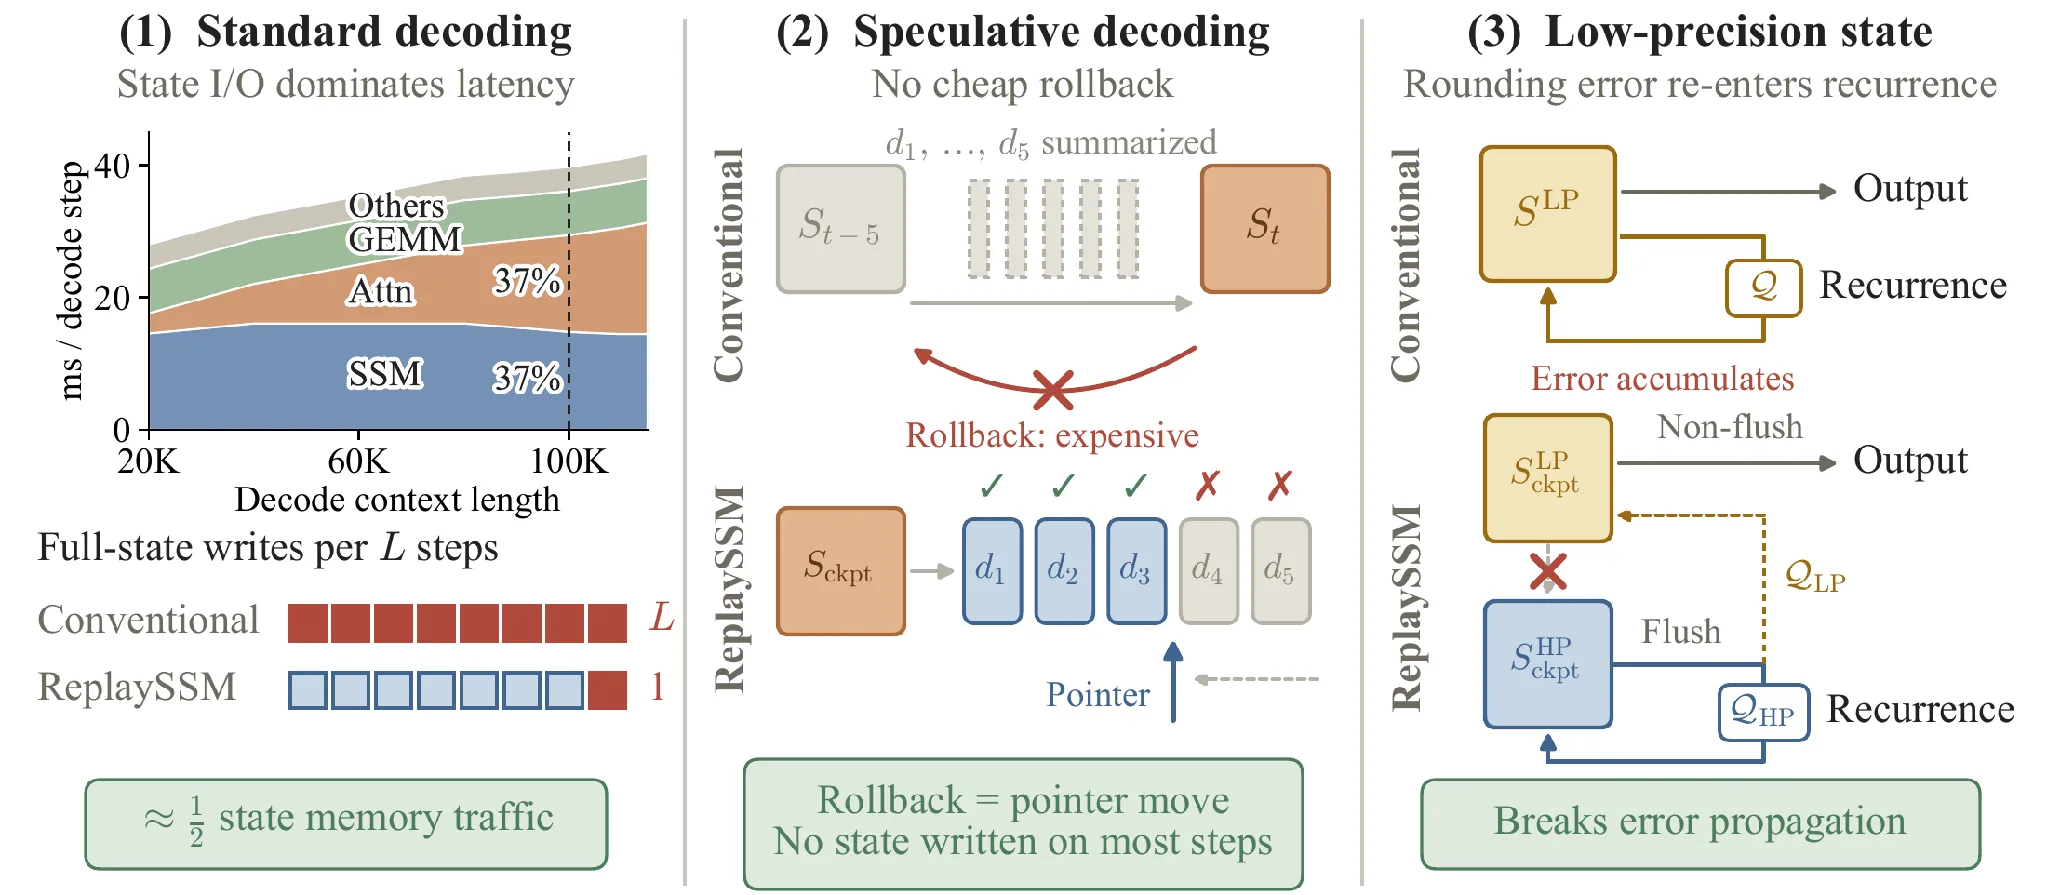
SSM 解码步骤需要加载和存储完整状态,但对状态本身几乎不做算术运算,因此内核性能受限于 HBM 带宽而非计算能力。在较大的服务批大小下,这使得 SSM 层而非注意力层成为解码步骤的主要耗时部分(直到 10 万 tokens 长度),如 Nemotron-3-Super-NVFP4 在单块 NVIDIA Blackwell Ultra B300 GPU 上以批大小 256 运行时所示(图 2,左侧)。
两大因素驱动了这一现象:
- 层数:SSM 层数量是注意力层的五倍。
- 状态大小:每层 FP32 状态占每个序列 4 MiB,而每个 FP8 KV 条目仅占每个 token 0.5 KiB,因此一层 SSM 的状态大小相当于 8K tokens 的注意力层 KV 缓存。
投机解码的回滚
投机解码(Speculative decoding)让草稿模型提出 T 个 token,目标模型一次前向完成验证,再回滚到最后一个被接受的 token。Attention 天然支持回滚——只需移动 KV cache 指针即可。但 SSM 一旦把草稿更新进自身状态,这种更新没有简单的逆操作,回滚就变得代价高昂。vLLM 等推理引擎的应对办法是在每个草稿 token 后都保存一份状态快照,回滚时选取与被接受前缀匹配的那一份。在内存受限的路径上,这意味着每步一次读、T 次写,而且快照还会挤占 GPU 显存中能容纳的请求数。结果是,投机解码对 Transformer 是稳定的提速手段,但在服务端批量规模下对 SSM 几乎没有帮助。
状态量化
量化后的状态既要产生输出,又是下一次更新的输入,舍入误差会随着递推每一步不断累积。KV cache 则没有这种循环:量化条目只被反复读取,从不写回自身,这就是 KV cache 能容忍比 SSM 状态更低精度的原因。例如 Qwen3.5-122B-A10B-NVFP4 的权重采用 NVIDIA NVFP4 4-bit 浮点格式,KV cache 用 FP8,而 SSM 状态仍是 FP32。
ReplaySSM 如何表示状态
SSM 递推可以在一个包含 h 个 token 的窗口上展开:
St=αtSt−1+vtkt⊤=γhSckpt+∑j=1hγj+1:hvjkj⊤,S_t = \alpha_t S_{t-1} + v_t k_t^\top = \gamma_h\, S_{\mathrm{ckpt}} + \sum_{j=1}^{h} \gamma_{j+1:h}\, v_j k_j^\top,其中 SckptS_{\mathrm{ckpt}} 是窗口前的状态,γ\gamma 是累积衰减。传统解码沿左边逐步推进,ReplaySSM 则采用右边的形式:把状态表示为一个检查点加上一小段最近的输入记录(Mamba-2 的 αj\alpha_j、vjv_j、kjk_j)缓冲。
在大多数步骤(我们称为非冲刷步骤,non-flush)中,系统只是把当前输入追加进缓冲区,并基于检查点和缓冲区计算输出,不保存状态。当缓冲区写满 L 条记录时,触发一次冲刷步骤(flush):把缓冲的输入折叠进检查点,将新检查点一次性写入 HBM,然后清空缓冲区。输出与传统解码仅在浮点精度上有差异。ReplaySSM 的思路可以浓缩为三个问题:
1ReplaySSM 做了什么?
它缓存近期的 SSM 输入,并将状态表示为一个检查点加上这些输入。
2这项改动带来了什么变化?
它将输出计算与状态更新解耦:每一步都计算输出,而检查点仅在每个窗口更新一次。
3实现了什么效果?
它降低了状态内存访问压力,简化了推测解码的回滚逻辑,并且支持低精度状态读取,避免其舍入误差通过递归更新传播扩散。
ReplaySSM 的评估方法
我们评估了来自两个系列的四个混合模型:带有 Mamba-2 层的 Nemotron 3 和带有 GDN 层的 Qwen3.5,规模从单张 NVIDIA H100 Tensor Core GPU 上的 4B 稠密模型,到单张 NVIDIA Blackwell Ultra B300 GPU 上的 120B 级混合专家(MoE)模型(见表 1)。我们在 vLLM 中实现了 ReplaySSM,并将其与 vLLM 自身在内核最佳启动配置下的表现进行了对比。
性能测试中,SSM 状态保持 FP32 精度(这些模型的默认精度),并使用窗口大小 L = 16,这是所有四个模型表现最佳的窗口设置。推测解码测试利用各模型的多 token 预测(MTP)头生成草稿 token。
| 模型 | SSM 层 | 权重 | GPU | SSM / 注意力层 |
|---|---|---|---|---|
| Nemotron-3-Nano-4B | Mamba-2 | BF16 | 1×H100 | 21 / 4 |
| Nemotron-3-Super-120B-A12B | Mamba-2 | NVFP4 | 1×B300 | 40 / 8 |
| Qwen3.5-4B | GDN | BF16 | 1×H100 | 24 / 8 |
| Qwen3.5-122B-A10B | GDN | NVFP4 | 1×B300 | 36 / 12 |
收益一:降低状态内存访问压力
在 L 个 token 的窗口内,传统解码方案会对状态执行 L 次读取和 L 次写入。ReplaySSM 在每一步仍会读取 checkpoint,因为输出计算依赖于它,但仅在 flush 阶段写入一次状态。非 flush 步骤的核心任务是计算输出,只写入新输入记录(即若干向量,而非完整矩阵)。这使主要的状态数据流量大约减半。
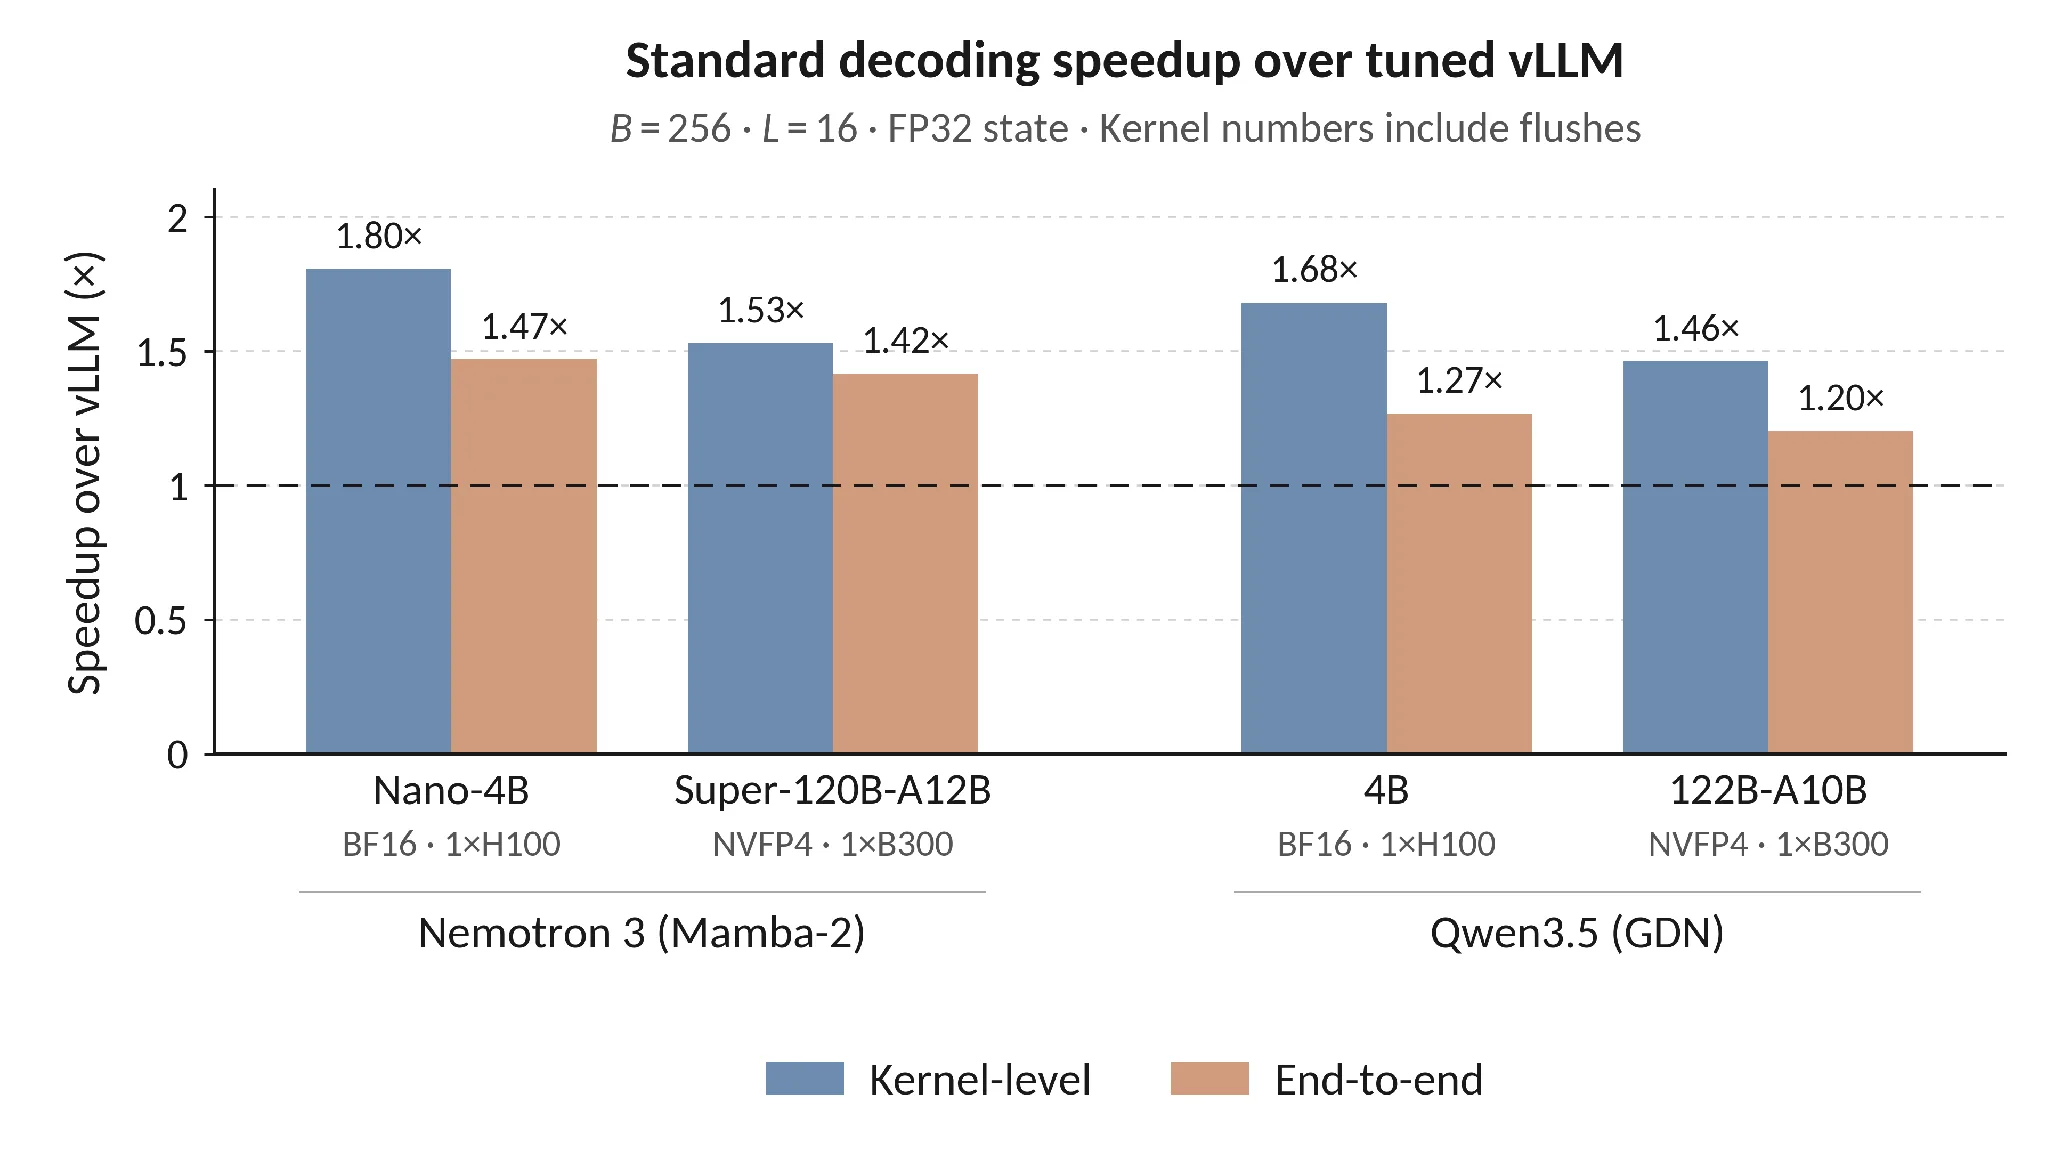
在大批量服务场景下,内存带宽是传统 kernel 的性能瓶颈,因此降低状态内存流量能显著加速解码。但在 batch size 为 1 时,其他延迟源占主导地位,测试结果显示 ReplaySSM 在此情形下没有带来加速。当 batch size 为 256 时,kernel 运行速度提升 1.46× 至 1.80×,四个模型的解码步骤速度提升 1.20× 至 1.47×(见图 3)。由于 SSM 占单步计算的比例随 batch size 增加而增大,端到端的加速效果也随之提升。
优势 2:简化回滚,加速验证
在 speculative decoding 中,ReplaySSM 在验证阶段开始前,将全部 T 个 draft token 的输入追加到 input buffer,验证完成后通过推进 buffer 指针来提交已接受的前缀。与 KV cache 类似,指针之后的记录会被忽略,并在下一次追加时被覆盖。这种方式无需为每个 draft token 保存状态快照,也无需恢复状态(见图 2 中间部分)。由于 flush 仅将已提交的记录合并到 checkpoint 中,它无需等待确定的接受长度。
这种分离还带来另一个好处。传统解码每生成一个 token 都要同时产出两样东西——输出和更新后的状态,因为下一个 token 要用到这个状态。而 ReplaySSM 的非 flush 步骤只需产出输出,只算输出就意味着可以换一种计算方式。对于从零状态出发的一次更新,有 o=(vk⊤)q=v(k⊤q)o = (v k^\top)q = v(k^\top q)。左边的式子要先构建一个 dv×dkd_v \times d_k 的状态再读取它,右边的式子则算出一个标量去缩放向量,完全不需要构建状态。对 T 个 draft 和 h 条已提交记录,同样的思路可以写出下面的表达式:
O=SckptQD+V(W⊙(K⊤Q)),O = S_{\mathrm{ckpt}}\, Q D + V \bigl(W \odot (K^\top Q)\bigr),其中 D 是各 draft 位置的累积衰减,W 是带因果掩码的衰减矩阵。我们称之为“只算输出”的求值方式。checkpoint 只需为全部 T 个查询使用一次,其余计算就是对缓存的 key、value 和 draft 查询做的两个小矩阵乘法。整个过程不构建任何中间状态,节省了片上内存和 FLOPs,而且这些计算还能借助 Tensor Cores 加速。此外,K⊤QK^\top Q 在同一组内的所有 value head 之间共享。这其实就是 prefill kernel 已经在用的 chunkwise 计算,只是把缓冲区和 draft 当作 chunk 而已。GDN 也可以采用这种形式。“只算输出”的求值方式同样适用于标准解码,但在验证阶段价值最大,因为那里每步的算术运算量会乘上 T 倍。
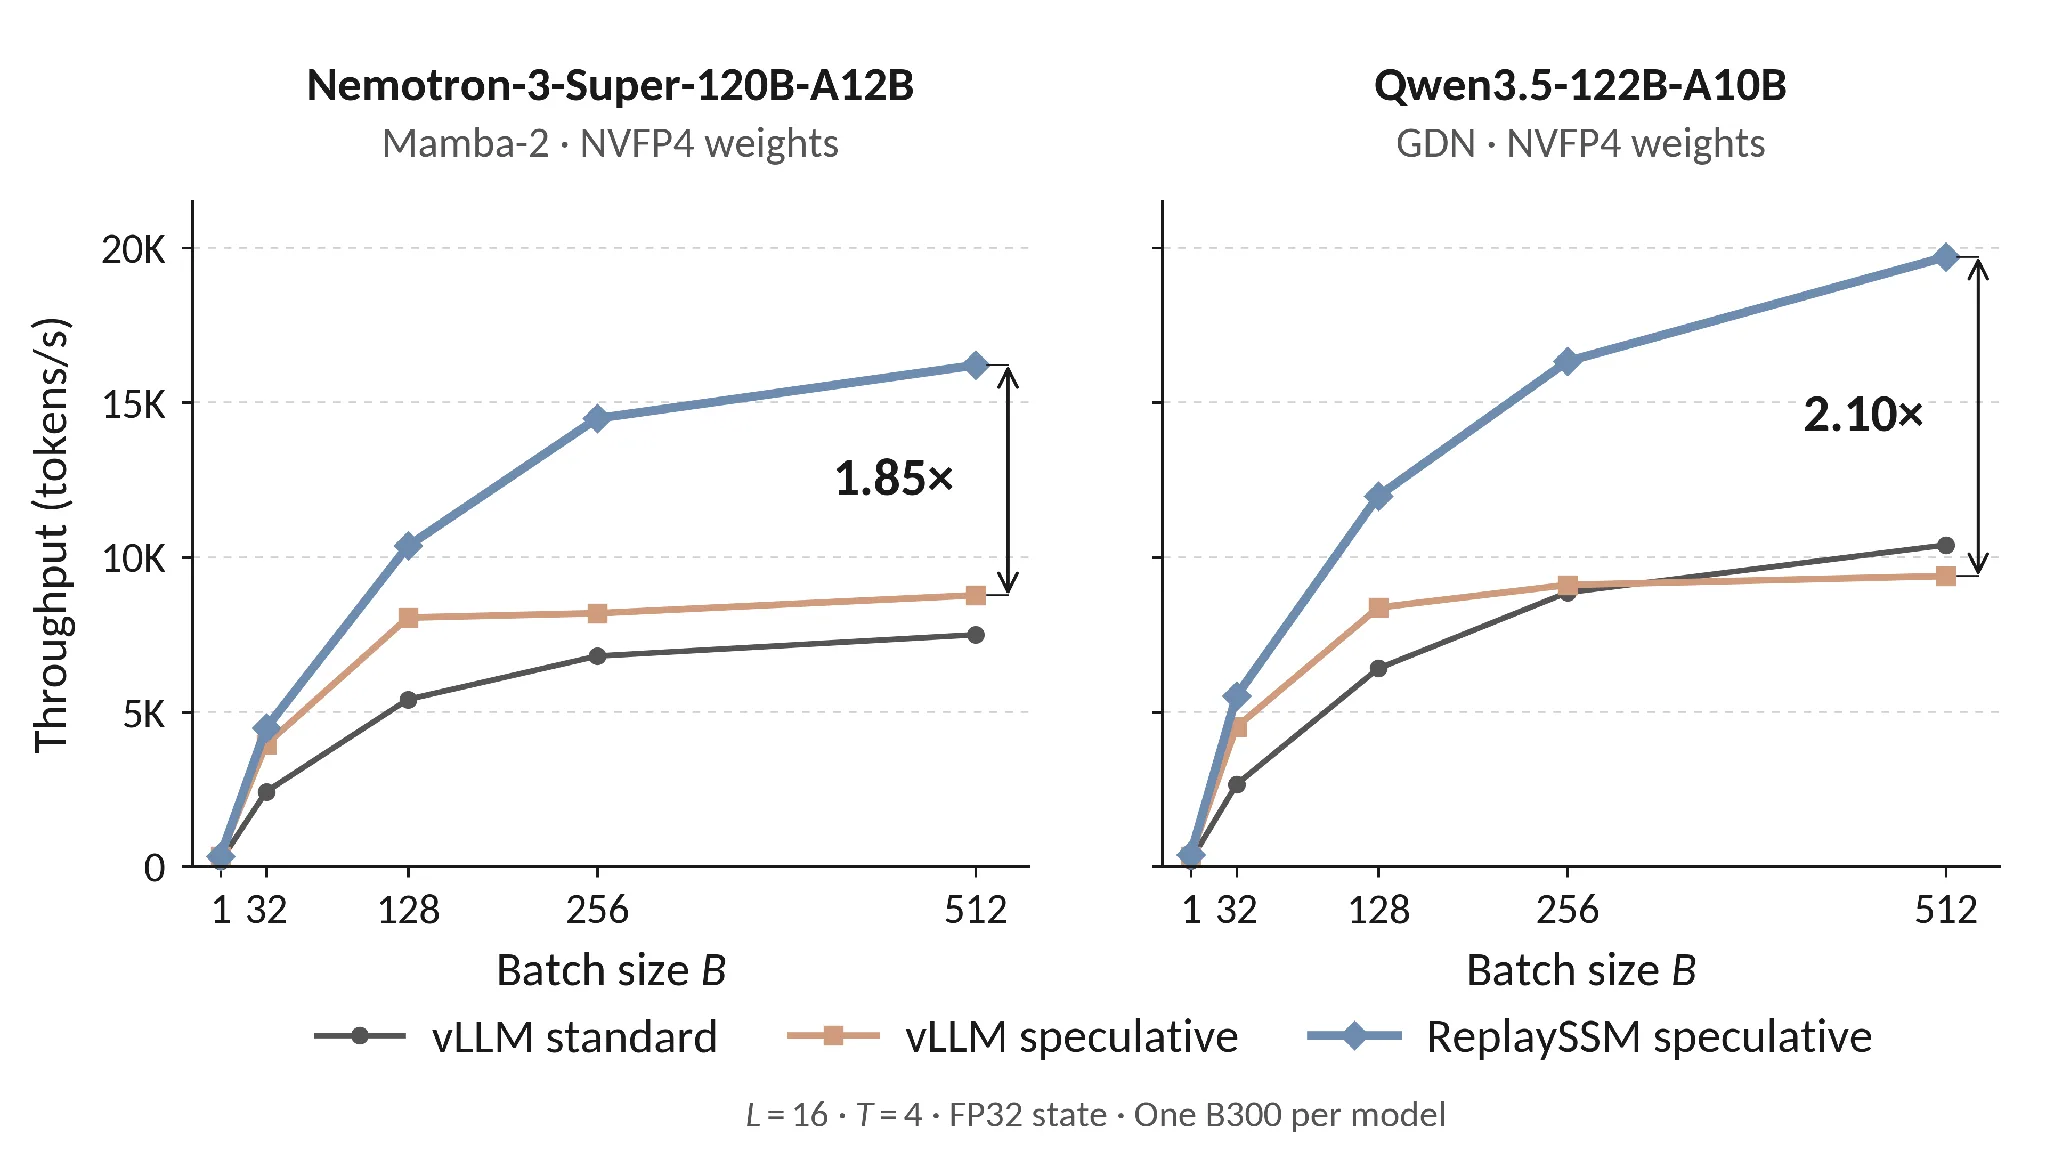
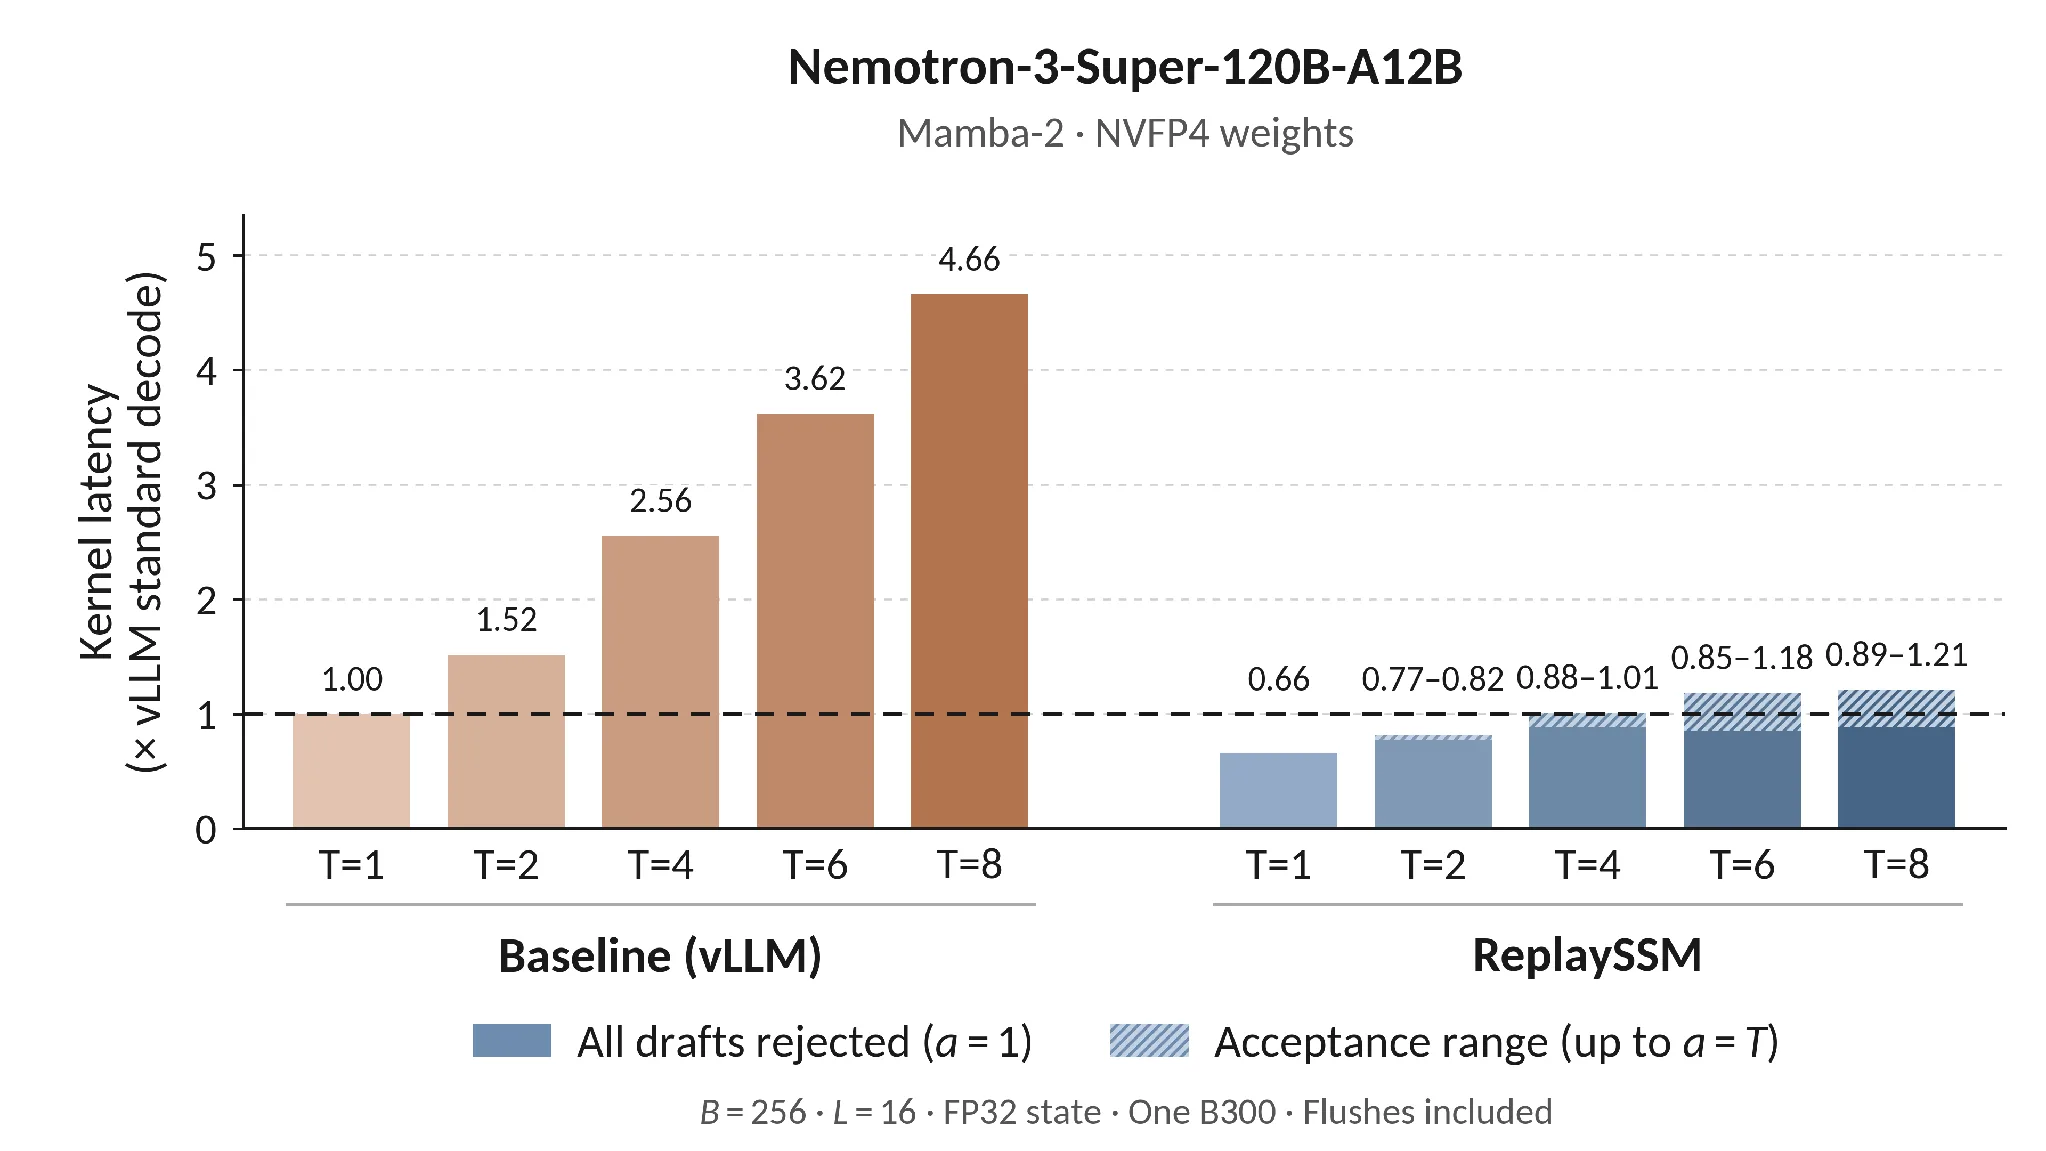
图 4 展示了在两个 120B 级模型上、T = 4 时,GSM8K 提示上的投机服务吞吐量。在 batch size 512 下,ReplaySSM 在接受长度相同的情况下,吞吐量分别是 vLLM 投机解码的 1.85 倍和 2.10 倍。
这一性能提升源于两个方面。
- 验证速度更快:vLLM 的内核为每个 token 存储一个状态快照,因此其延迟随 T 增加而增长;当 T = 8 时,其延迟几乎是 vLLM 标准解码步骤的五倍。ReplaySSM 在大多数步骤中不写入状态,因此验证 8 个 token 所需时间大约等于一步标准解码(包含刷写操作,见图 5)。
- 并发度更高:草稿状态快照会占用 GPU 内存,从而限制并发能力。传统推测解码在批量大小超过 128 后收益不再增长;在 Qwen3.5-122B-A10B-NVFP4 模型上,当批量大小达到 512 时,其性能甚至低于标准解码。相比之下,ReplaySSM 能随批量大小增加持续扩展性能。
优势 3:通过分离精度限制误差累积
低精度状态所需的字节数更少,从而在内存带宽限制内核性能的情况下降低延迟。在 Mamba-2 上,读取 NVFP4 状态时,非刷写内核的运行速度比读取 FP32 状态快 3.8 倍。
ReplaySSM 从两个方面改变了量化方式。首先,检查点改为每个窗口写入一次,而非每步写入一次,这意味着低精度检查点每 L 步只会被舍入一次。 Nemotron 3 Ultra 报告 探讨了这种周期性检查点方法。虽然它降低了舍入频率,但舍入误差仍会进入后续的更新中。
其次,非冲刷步骤仅读取状态以计算输出,而冲刷步骤则更新用于后续状态更新的检查点。这两项任务可以使用不同的精度。我们保留一个高精度检查点用于递归计算,并维护一个低精度副本用于非冲刷读取。冲刷操作从高精度检查点开始,合并缓冲区输入,并将结果独立转换为两种格式。由于低精度副本从不被读回递归过程,其舍入误差仅影响当前窗口的输出,不会沿递归传播。在冲刷时额外写入低精度副本,减少了非冲刷步骤中需要读取的数据量。接受、回滚和缓冲区管理保持不变(图 2 右侧)。
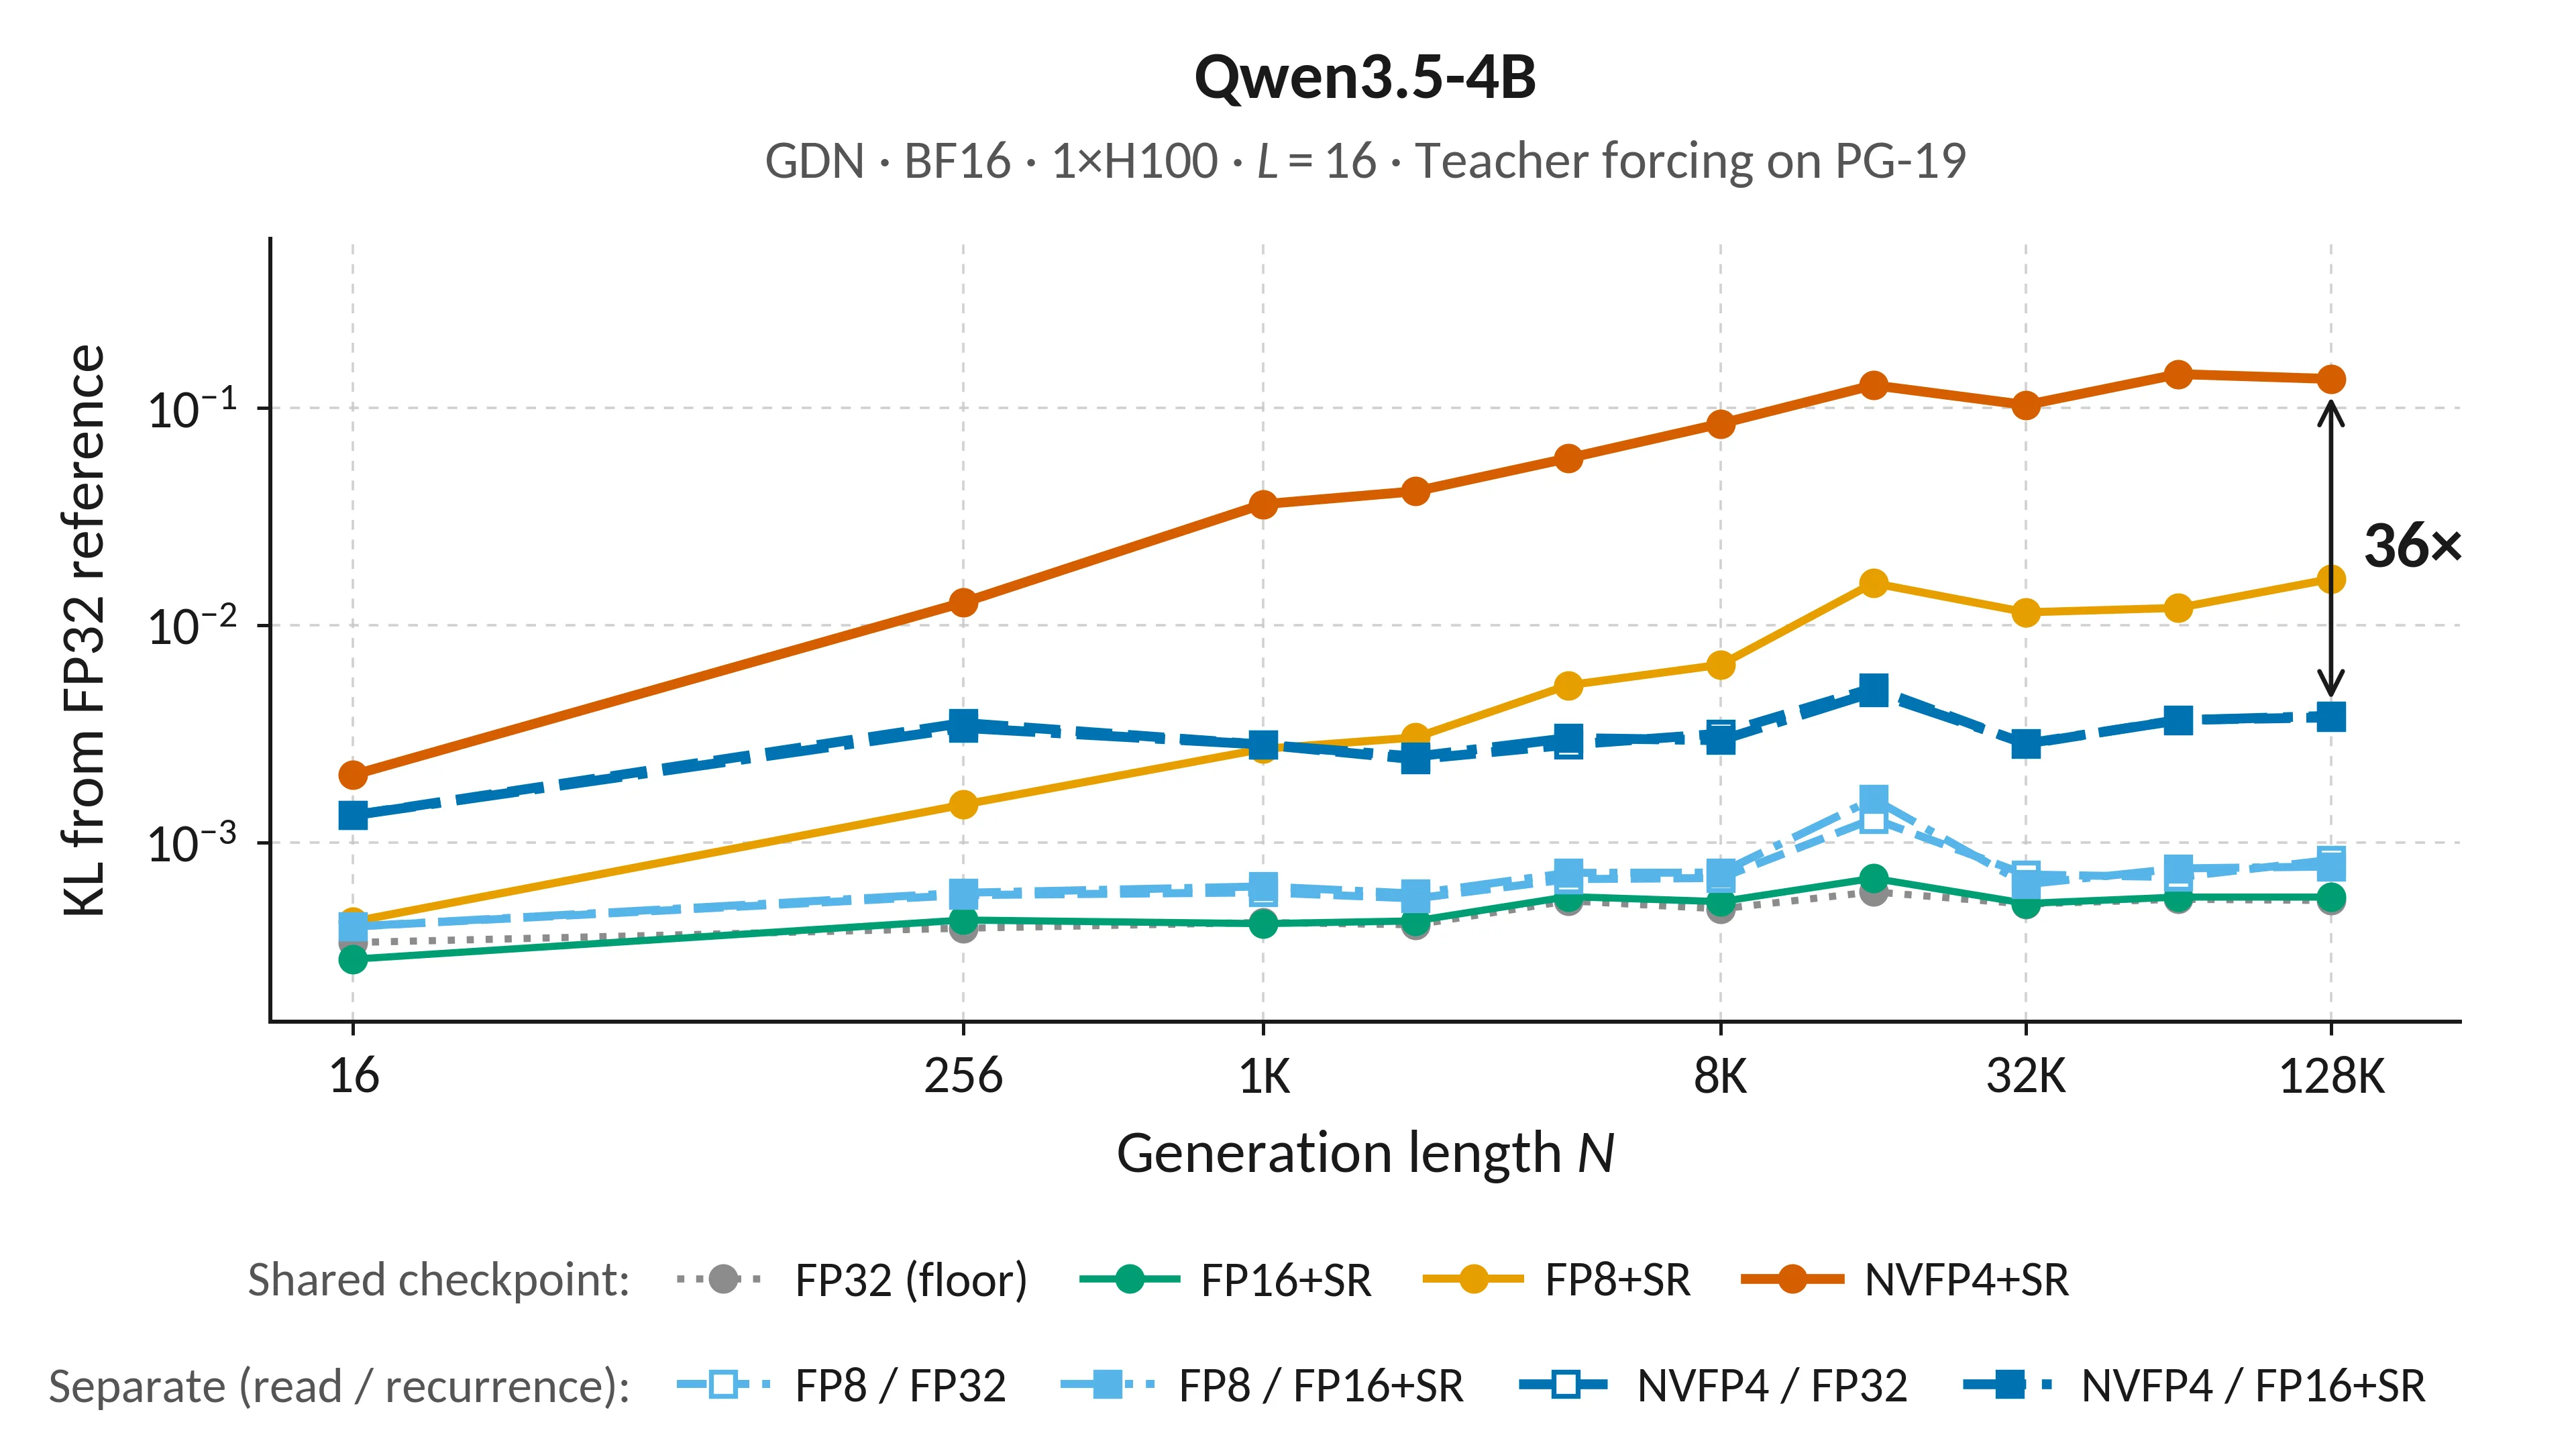
图 6 测量了输出误差,即生成长度达 128K 个 token 时,与 PG-19 文本上强制教师输入(teacher forcing)下的 FP32 状态解码相比的 Kullback–Leibler(KL)散度。共享的 FP8 或 NVFP4 检查点会随长度累积误差。保持递归部分为 FP32 可消除大部分误差增长:在 Qwen3.5-4B 模型生成 128K 个 token 时,NVFP4 读取配合 FP32 递归计算将 KL 散度从 0.136 降低至 0.0038。剩余的误差是读取误差,它不会随长度增长。
带有随机舍入(SR)的 FP16 递归计算能紧密跟踪 FP32,因此半精度递归检查点就足够了。对读取副本进行更好的量化,例如沿状态和通道维度使用独立的缩放因子,可以进一步削减剩余的读取误差。
我们还验证了 KL 差距是否会体现在下游准确率上。表 2 展示了 GPQA-Diamond 的结果,这是三项评测中生成序列最长的一个。共享 NVFP4 checkpoint 在四个模型上会损失 3 到 31 个百分点的准确率;改用 NVFP4 读取搭配 FP16 或 FP8 递归则能挽回大部分损失,让四个模型中的三个保持在 FP32 约 2 个百分点以内。
| GPQA-Diamond,相对 FP32 的变化(百分点) | FP32 准确率 | 共享 NVFP4 checkpoint | NVFP4 读取 + FP16+SR 递归 | NVFP4 读取 + FP8+SR 递归 |
|---|---|---|---|---|
| Nemotron-3-Nano-4B | 56.7 | −31.3 | −6.7 | −5.6 |
| Nemotron-3-Super-NVFP4 | 79.3 | −12.5 | −1.4 | −1.4 |
| Qwen3.5-4B | 76.3 | −3.2 | +0.7 | +1.5 |
| Qwen3.5-122B-A10B-NVFP4 | 82.7 | −5.2 | −2.0 | −1.7 |
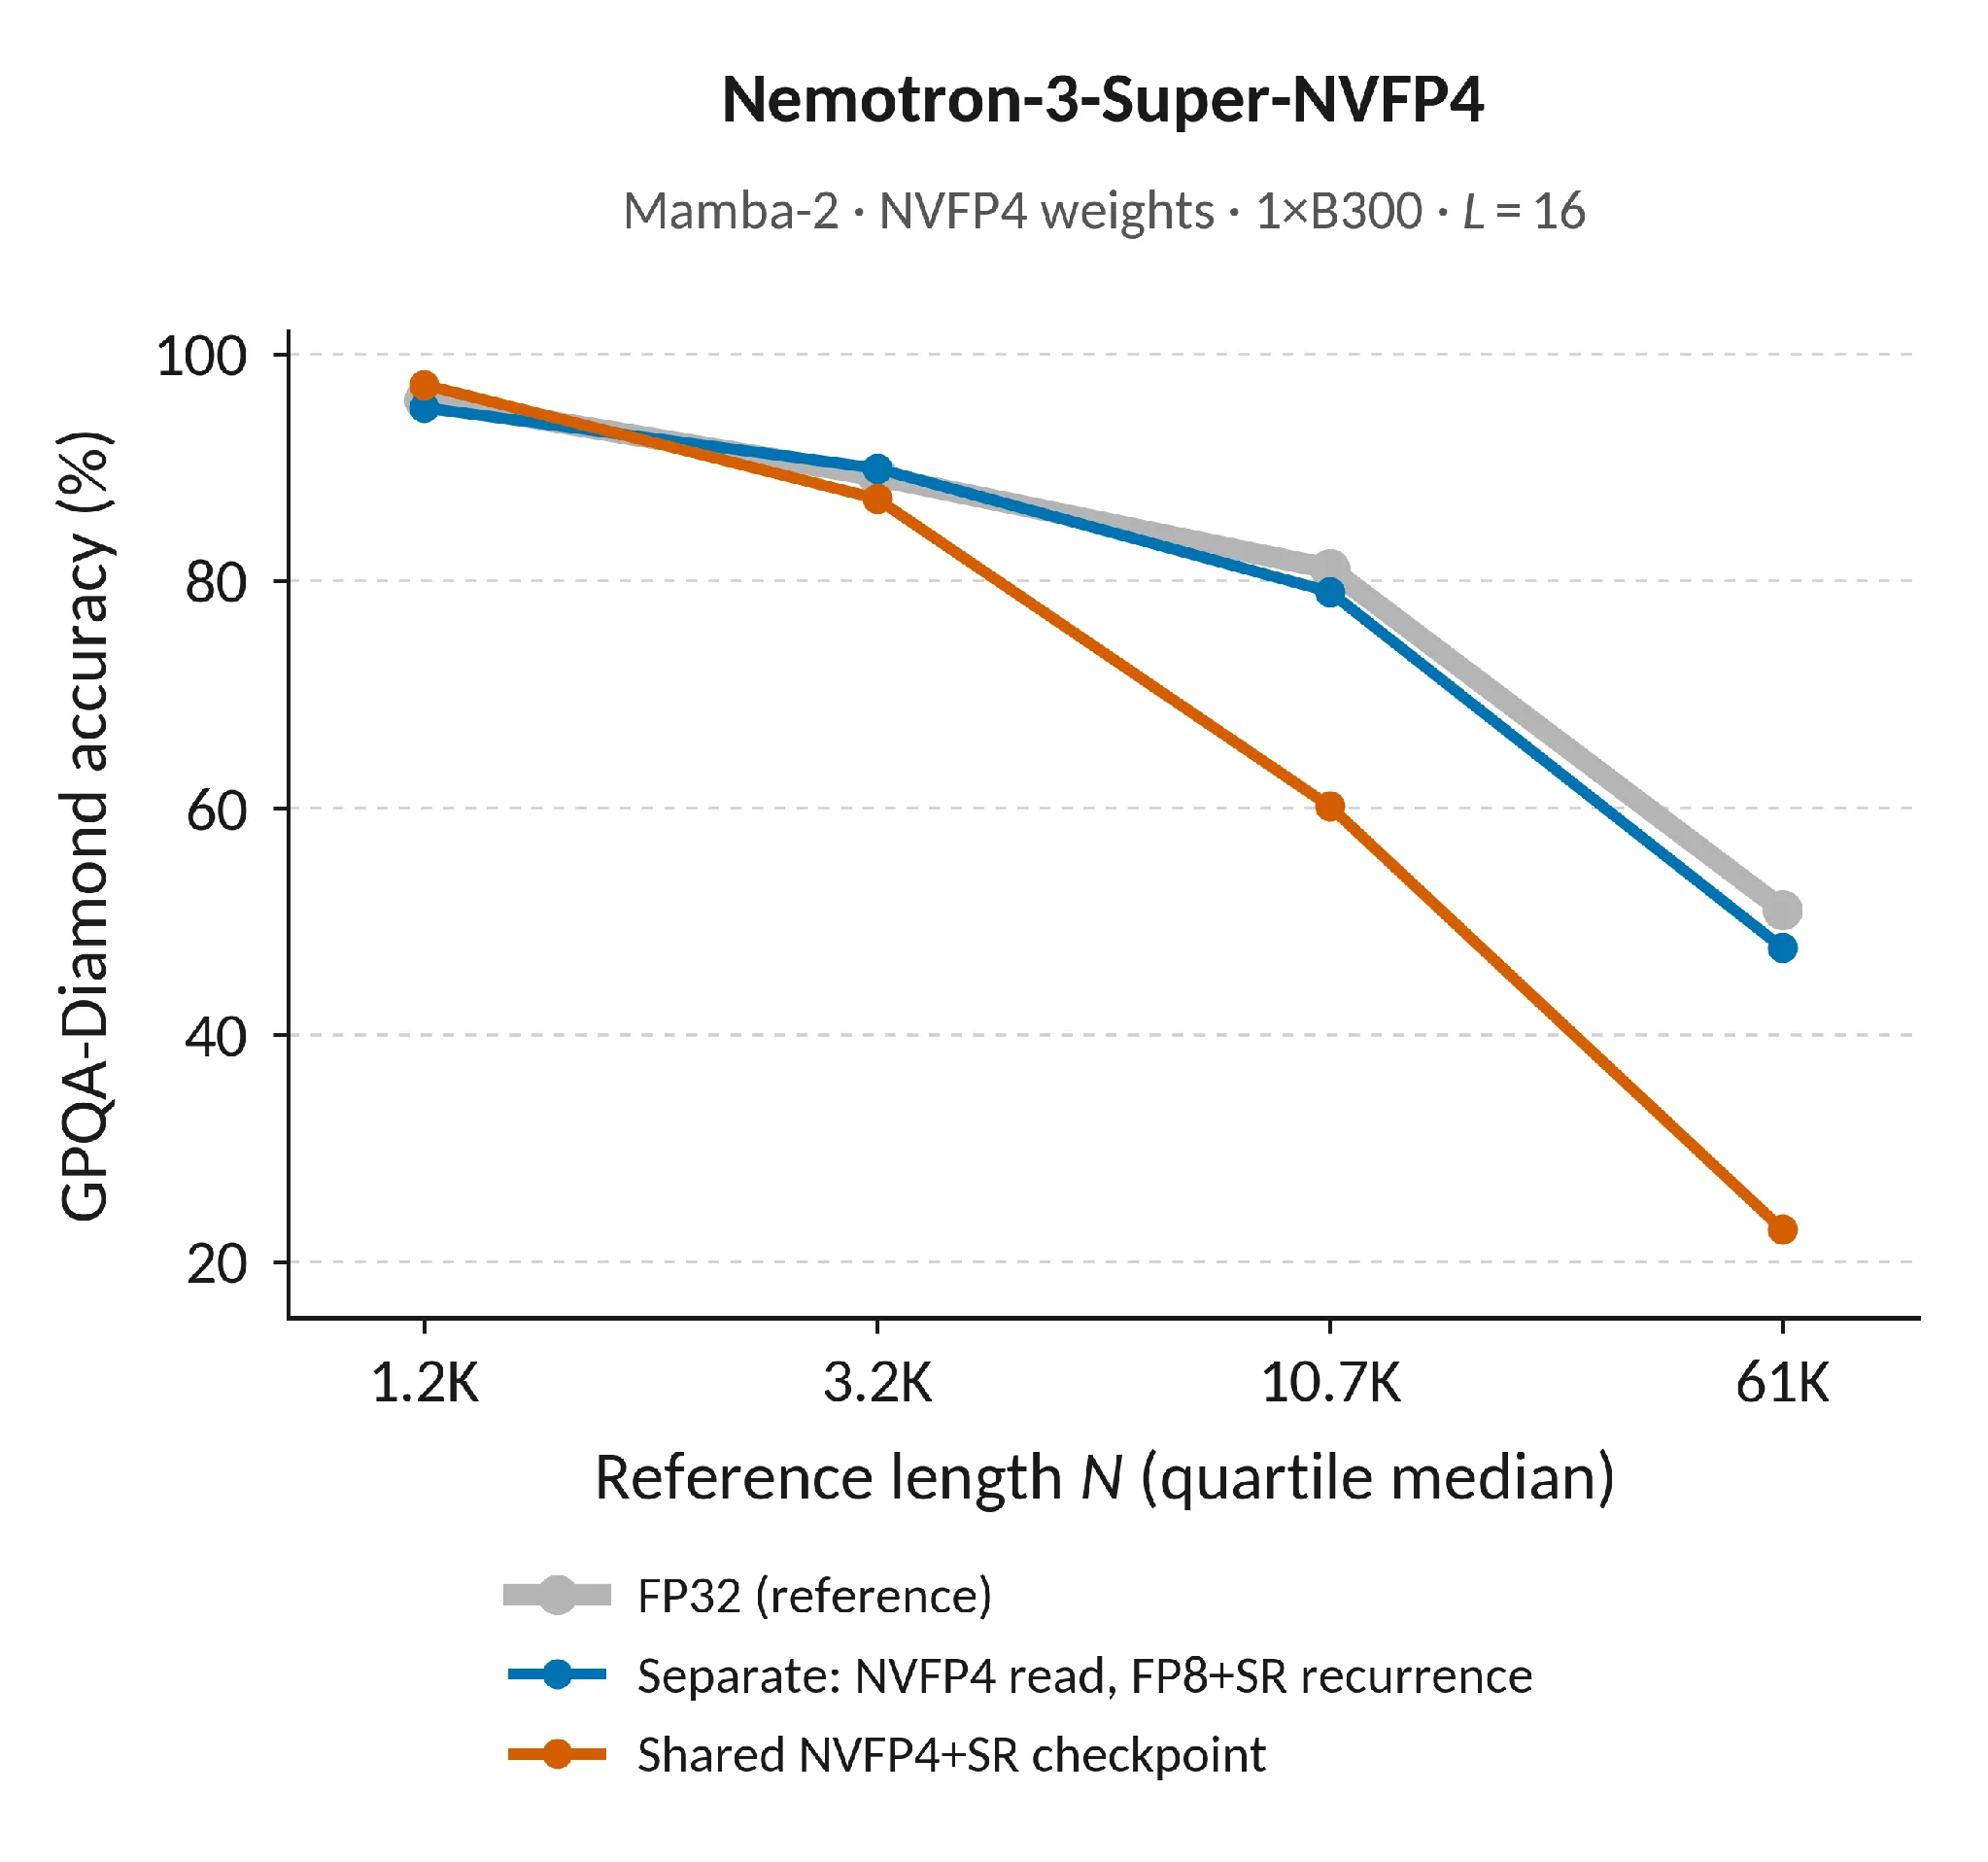
图 7 展示了 GPQA-Diamond 上准确率损失随生成长度的变化情况。在三项评测中:
- GPQA-Diamond:在 Nemotron-3-Super-NVFP4 上,共享检查点(shared checkpoint)在短生成任务中与 FP32 精度保持一致,但随着生成长度的增加,两者逐渐偏离。而独立精度(separate-precision)配置在整个过程中都保持在 FP32 附近。
- MMLU-Pro 和 Math-L5:这两个基准的生成内容通常比 GPQA-Diamond 更短。四个模型中有三个在使用共享 NVFP4 检查点时,精度损失不超过 3 个百分点;而独立检查点配置的平均表现与 FP32 的差距在 0.5 个百分点以内。
论文提供了上述三项基准测试及长输入 RULER 测试的结果。
开始使用 ReplaySSM
ReplaySSM 已正式投入生产环境。GLM-5.3-Flash 已启用 ReplaySSM 提供服务,Z.ai 的基础设施报告详细描述了将其集成至 KDA 解码内核的过程。Kimi-K3 在其 KDA 层中缓存草稿令牌的 SSM 输入用于验证,并引用了作为并行方案的 ReplaySSM。此外,ReplaySSM 还集成了 TensorRT-LLM、vLLM、SGLang 和 FlashInfer 等开源推理框架。
欲了解更多信息,请查阅以下资源:
- 阅读论文:ReplaySSM: Cache SSM Inputs, Not State
- 尝试代码:github.com/Johnny-Liou/ReplaySSM
- 在 TensorRT-LLM 中使用 ReplaySSM 部署混合模型:PR 14203、PR 16464
- 在 vLLM 中使用 ReplaySSM 部署混合模型:PR 48018、PR 52506、PR 52928
- 在 FlashInfer 中使用 ReplaySSM 内核:PR 3975、PR 4081
- 阅读Dao AI Lab 的早期博客文章,获取关于标准解码和投机解码的详细解读