
如何在 Next.js 网站中添加并验证结构化数据(JSON-LD)
结构化数据对搜索引擎来说一直很重要。搜索引擎读取你的页面时,看到的是 HTML:一个标题、几段文字、某个日期、某个人名。
结构化数据则直接告诉它这些内容分别是什么:这个页面是一篇文章,这是它的标题,作者这个人,发布日期是这个。
在我看来,SEO 不是项目收尾时打个勾就完事的事。我希望自己做的产品和网站能被找到,而且被找到时能被正确理解。
所以只要合适,我都会给每个页面加上结构化数据。而且随着 AI 系统开始基于网页内容回答问题,我认为它只会越来越重要,而不是相反。
在 Next.js 应用里,这些数据不会自动生成,需要你自己添加——在需要的页面里放一小段 JSON。
在本教程中,你会了解什么是结构化数据、JSON-LD 是如何工作的,然后把它添加到 Next.js App Router 项目中:包括一个可复用、对任何数据都安全的 JsonLd 组件,用页面渲染的同一份内容生成的 organization 和 article 数据,以及每次构建后验证这些数据的检查。
Table of Contents
前置条件
如需跟随本文操作,你需要:
使用 App Router 和 TypeScript 的 Next.js 应用。本文代码在 Next.js 16.4.0 和 React 19.3 上经过测试。
对 Server Components 和动态路由有基本的了解。
schema-dts包,它提供结构化数据的 TypeScript 类型定义。
由于 schema-dts 仅用于提供类型,请将其安装为开发依赖项:
npm install -D schema-dts
示例基于博客场景。遇到 getPost() 时,请替换为你自己的数据源,例如 CMS、数据库或 Markdown 文件。
开发者视角的结构化数据基础
如果你从未接触过结构化数据,本节提供的知识足以让你理解后续的代码。
什么是结构化数据与 JSON-LD
结构化数据是对页面内容的机器可读描述。你无需让搜索引擎猜测“Jane Doe”是作者、“2026-09-01”是发布日期,而是直接以程序可读取且无需推断的格式明确陈述这些信息。
所用的术语来自 Schema.org,这是一套共享词汇表,定义了类型(如 Article、Person 和 Organization)及其属性(如 headline、author 和 datePublished)。它由 Google、Microsoft、Yahoo 和 Yandex 发起,也是搜索引擎预期的标准词汇。
JSON-LD(用于链接数据的 JavaScript 对象表示法)是编写此类数据的一种方式。它是一个 W3C 标准,在网页中,它存在于带有特定类型的 script 标签内:
<script type="application/ld+json">
  { "@context": "https://schema.org", "@type": "Article", "headline": "..." }
</script>
浏览器不会执行这段脚本。类型不是 JavaScript 的 script 标签,在 HTML 标准 中被称为数据块(data block),其定义是“不交由用户代理处理,而是由作者脚本或其他工具处理”。
另外两种格式是 Microdata 和 RDFa,它们通过属性添加到现有 HTML 元素上。Google 支持这三种格式,但推荐在“网站配置允许时”优先使用 JSON-LD。对于 React 开发者而言,JSON-LD 也是最自然的选择:它是由数据构建的普通对象,与渲染页面的 JSX 相互独立。
JSON-LD 块的构建方式
以下是用于博客文章的 JSON-LD 块:
{
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  "headline": "How Caching Works in Next.js",
  "datePublished": "2026-09-01T09:00:00.000Z",
  "author": {
    "@type": "Person",
    "name": "Jane Doe"
  },
  "publisher": {
    "@type": "Organization",
    "@id": "https://example.com/#organization",
    "name": "Example Dev Blog"
  }
}
以 @ 开头的键是 JSON-LD 关键字,其余部分是 Schema.org 属性:
@context指明名称所用的词源。对于 Schema.org,它是https://schema.org。@type说明这是什么类型的实体。BlogPosting是 Schema.org 中比Article更具体的一种类型。headline、datePublished和author是该类型的属性。属性可以包含文本、日期、URL 或另一个带类型的对象,例如author中的Person。@id为实体提供唯一名称,通常是一个带#片段的 URL。此处,它将发布者标记为与主页上另一个块用相同@id描述的同一组织。
在后续代码中,这四个关键字都会被用到。
结构化数据、JSON-LD、Schema.org 与富结果
这四个术语经常混淆,以下是它们的关系:
| 术语 | 定义 |
|---|---|
| 结构化数据 | 核心概念:一种机器可读的页面描述 |
| Schema.org | 词汇表:你可以使用的类型和属性 |
| JSON-LD | 格式:如何把这段描述写进页面 |
| 富媒体结果 | Google 搜索的一项功能:结构化数据可以让页面有机会展示的增强结果,例如面包屑导航、商品价格和评分等 |
简单来说:用 JSON-LD 格式、按照 Schema.org 词汇表编写结构化数据,Google 就可能借此为你的页面展示富媒体结果。
结构化数据对搜索有什么用(以及没什么用)
Google 表示,它利用结构化数据来"理解页面内容",并获取标记所描述的人物、书籍和公司等信息。此外,它也用它来判断页面是否有资格展示富媒体结果。
"有资格"是关键。JSON-LD 写得再规范,也不保证一定能出现富媒体结果,原因有四:
每种富媒体结果都有自己的必填属性,列在 Google 对应功能的文档里。标记可能完全符合 Schema.org 规范,却依然不满足这些要求。
是否展示由 Google 说了算。它的结构化数据指南明确写着:"即使页面标记正确,Google 也不保证结构化数据一定会出现在搜索结果中。"
标记必须描述页面上真实可见的内容。同一份指南还提到:"不要标记对页面读者不可见的内容。"
有些类型已经彻底不再产生富媒体结果。Google 已于 2026 年 5 月 7 日停止展示 FAQ 富媒体结果,How-to 富媒体结果则早在 2023 年就已停用。
结构化数据也不能提升排名。正如 Google 的 John Mueller 在 2025 年所说:"结构化数据不会让你的网站排名更高。"
AI 搜索呢?Google 表示,想要出现在其AI 功能中,“并不需要添加任何特殊的 schema.org 结构化数据”。Bing 的站长指南称,结构化数据“可能有助于更清晰地理解内容,但并不能保证被展示”。OpenAI、Anthropic 和 Perplexity 并未公开说明它们如何使用结构化数据:它们的爬虫文档主要涉及爬虫访问权限,而非标记(markup)。
眼下围绕 AI 搜索的炒作很多,其中部分言之有理。但我的考量不依赖于任何一家公司的承诺。
我希望自己的内容能被每一个读取它的系统——无论是搜索引擎还是 AI 工具——尽可能清晰地理解。结构化数据是对页面清晰、准确的描述,无论谁来读都有价值。只是别把它当成进入 AI 答案的捷径。
在实际应用中,这种情况有多普遍?在我开发的网站审计工具 Greadme 发布的《2026 年网站现状报告》(State of Websites 2026 report)中,审计的 387 个首页里有 63% 包含结构化数据。其中大多数格式规范:这些网站里有 91% 通过了验证,没有错误。
但其中 16% 仍在声明 FAQPage——这是一种富媒体结果类型,Google 在 2023 年将其限制为仅限政府和健康网站使用,随后又将其废弃。通过验证不等于真正有用。
如何构建安全的 JsonLd 组件
Next.js 的JSON-LD 指南建议在 layout.js 或 page.js 组件中,将结构化数据渲染为 <script> 标签。你可以把这个标签粘贴到每个需要它的页面里。但用一个小组件会更好,这样可以把转义(escaping)和类型定义集中在一处管理。
创建 components/JsonLd.tsx:
import type { Graph, Thing, WithContext } from "schema-dts";

type JsonLdData = WithContext<Thing> | Graph;

export function serializeJsonLd(data: JsonLdData): string {
  return JSON.stringify(data).replace(/</g, "\\u003c");
}

export function JsonLd({ data }: { data: JsonLdData }) {
  return (
    <script
      type="application/ld+json"
      dangerouslySetInnerHTML={{ __html: serializeJsonLd(data) }}
    />
  );
}
下面说明各部分的作用:
JsonLdData来自schema-dts。WithContext<Thing>接收带有@context的任意单个 Schema.org 类型,而Graph则接收包含多个类型的块。两者都会用到。serializeJsonLd将对象转换为字符串,并将所有<替换为\u003c。下文将解释原因。dangerouslySetInnerHTML将该字符串原样写入标签。这个名字听起来有点吓人,但由于字符串由你控制,且转义机制确保了其安全性,因此你可以放心地包含来自任何地方的数据。
该组件没有 "use client" 指令,因此它是一个 Server Component,该标签是服务器发送的 HTML 的一部分。
为什么不用 next/script
Next.js 有一个 Script 组件,一些教程用它来处理 JSON-LD。不要这样做。JSON-LD 指南指出,next/script “针对加载和执行 JavaScript 进行了优化”,而 JSON-LD 是数据。
更大的问题体现在 HTML 中。使用默认的 afterInteractive 策略时,Script 内容“在客户端注入 HTML”。我构建了一个通过 Script 渲染 Product 块的页面,并检查了 next build 生成的 HTML。
其中没有 application/ld+json 标签。数据仅存在于 React 在浏览器中读取的 JavaScript 负载中。
Google 仍然可以找到它,因为它读取 JavaScript 注入到页面的 JSON-LD。但任何仅读取 HTML 的工具都看不到数据。普通的 <script> 标签将数据放在 HTML 中,让所有人都能看到。
为什么转义很重要
简而言之:JSON.stringify 会生成有效的 JSON,但并非安全地放入 HTML 内部的 JSON。浏览器不知道你的脚本包含 JSON。它会查找文本 </script> 来确定标签结束的位置,并在此处停止解析,即使是在 JSON 字符串中间。
假设产品名称来自 CMS,有人保存了如下名称:
Blue Mug </script><script>alert(document.cookie)</script>
如果直接使用 JSON.stringify,服务器会输出这样的内容:
<script type="application/ld+json">{"@context":"https://schema.org","@type":"Product","name":"Blue Mug </script><script>alert(document.cookie)</script>"}</script>
浏览器会在第一个 </script> 处结束 JSON-LD 标签,接着发现第二个普通 script 标签并执行它。这就构成了一次 XSS(跨站脚本)攻击,同时你的结构化数据也变成了损坏的 JSON。
我用 jsdom 按照标准规定的方式解析这个页面,alert 执行了一次,对 JSON-LD 做 JSON.parse 时报错 "Unterminated string in JSON"。
加上转义后,同样的值会变成:
<script type="application/ld+json">{"@context":"https://schema.org","@type":"Product","name":"Blue Mug \u003c/script>\u003cscript>alert(document.cookie)\u003c/script>"}</script>
浏览器再也找不到 </script> 了。因为 \u003c 是 JSON 自带的 < 转义写法,任何 JSON 解析器都会把它还原成原来的字符。在同样的测试里,没有任何代码被执行,JSON.parse 也原样返回了 CMS 存储的名称。
即使没有攻击者,这种情况也可能把页面搞坏。HTML 标准还把 <!-- 和 <script 列为会让解析器在 script 标签内产生混淆的字符序列。
在我的测试中,包含 <!--<script> 的值会导致未转义的标签吞掉页面剩余内容,它后面的标题直接从 DOM 里消失了。而使用转义后,页面渲染完全正常。
这就是 Next.js 指南建议把 < 替换为 \u003c 的原因。不过这份指南本身也是 2025 年 5 月 才加上这条建议的,很多教程至今仍在使用纯 JSON.stringify。只要你的 JSON-LD 中包含任何不是自己手写的内容,比如标题、描述、产品名称或评论,就一定要做转义。
为什么要做成一个组件
我通常是在发现多处代码在做同一件事时,才会把它封装成组件。我希望有一个集中管理这类行为的地方,这样修改或修复只需做一次,而不用在每个副本里重复。
JSON-LD 就是个典型例子,转义只需一行代码,却很容易被遗忘。在我维护的一个生产级代码库中,结构化数据在九个地方被渲染。
其中七处正确转义了 <。两处没有,而其中一处恰好是渲染每篇博客文章结构化数据的组件。
系统并没有报错。那些文章描述包含 <body> 和 <video> 等标签,它们不会导致 script 标签提前结束,而且也没有任何内容包含 </script 或 <!--。
但那是运气,而非审慎设计。页面是否受到保护,取决于你打开的是哪个文件。
将所有代码块统一到 JsonLd 组件中,从根本上解决了这个问题。转义逻辑、选择普通 <script> 而非 next/script 的决策,以及类型定义,现在都集中在一个地方。每个调用方都能通过 prop 类型获得类型检查,serializeJsonLd 也可以独立测试。
如何在首页添加 Organization 和 WebSite 数据
先从描述整个站点的数据开始:背后的组织以及网站本身。Google 建议将组织数据放在“你的首页,或某个描述你组织的单一页面”上,并补充道:“你不需要在站点的每个页面都包含它。”
以下示例使用两个常量存储站点名称和地址。将它们放在你管理配置的任何位置:
// lib/site.ts
export const SITE_URL = "https://example.com";
export const SITE_NAME = "Example Dev Blog";
然后从首页 app/page.tsx 中渲染这两种类型:
import type { Graph } from "schema-dts";
import { JsonLd } from "@/components/JsonLd";
import { SITE_NAME, SITE_URL } from "@/lib/site";

const siteJsonLd: Graph = {
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Organization",
      "@id": `${SITE_URL}/#organization`,
      name: SITE_NAME,
      url: SITE_URL,
      logo: `${SITE_URL}/logo.png`,
    },
    {
      "@type": "WebSite",
      "@id": `${SITE_URL}/#website`,
      name: SITE_NAME,
      url: SITE_URL,
      publisher: { "@id": `${SITE_URL}/#organization` },
    },
  ],
};

export default function HomePage() {
  return (
    <main>
      <JsonLd data={siteJsonLd} />
      <h1>{SITE_NAME}</h1>
      {/* The rest of your home page */}
    </main>
  );
}
@graph 将多个共享同一个 @context 的实体聚合在一个块中。因此,该对象被声明为 Graph 类型,而非 WithContext<...>。
每个实体都定义了 @id,WebSite 的 publisher 通过该 @id 指向 Organization,避免重复定义。在同一个块内,仅通过 @id 引用即可,因为完整定义就在旁边。
你可能会想把它放进根布局中,让所有页面都包含。在 App Router 中,布局里渲染的内容会包含到其下的每个页面。
这样做不算错,但它会给每个页面添加相同的结构化数据块,而 Google 指出这并非必要。只有当数据确实适用于下方所有页面时,才在布局中放置结构化数据。
如何为动态路由添加文章和面包屑数据
文章页是结构化数据真正发挥作用的地方,也是数据最容易过时的地方。解决这两个问题的原则:从页面渲染所用的同一数据源构建 JSON-LD,并且只标记读者实际可见的内容。
以下是完整的 app/blog/[slug]/page.tsx 示例:
import Image from "next/image";
import Link from "next/link";
import { notFound } from "next/navigation";
import type { BlogPosting, BreadcrumbList, WithContext } from "schema-dts";
import { JsonLd } from "@/components/JsonLd";
import { getAllPosts, getPost } from "@/lib/posts";
import { SITE_NAME, SITE_URL } from "@/lib/site";

export async function generateStaticParams() {
  const posts = await getAllPosts();
  return posts.map((post) => ({ slug: post.slug }));
}

export default async function PostPage({
  params,
}: {
  params: Promise<{ slug: string }>;
}) {
  const { slug } = await params;
  const post = await getPost(slug);
  if (!post) notFound();

  const breadcrumbs = [
    { name: "Home", path: "/" },
    { name: "Blog", path: "/blog" },
    { name: post.title, path: `/blog/${post.slug}` },
  ];

  const articleJsonLd: WithContext<BlogPosting> = {
    "@context": "https://schema.org",
    "@type": "BlogPosting",
    headline: post.title,
    description: post.description,
    image: post.image,
    datePublished: post.publishedAt,
    dateModified: post.updatedAt,
    author: { "@type": "Person", name: post.author.name, url: post.author.url },
    publisher: {
      "@type": "Organization",
      "@id": `${SITE_URL}/#organization`,
      name: SITE_NAME,
    },
  };

  const breadcrumbJsonLd: WithContext<BreadcrumbList> = {
    "@context": "https://schema.org",
    "@type": "BreadcrumbList",
    itemListElement: breadcrumbs.map((crumb, index) => ({
      "@type": "ListItem",
      position: index + 1,
      name: crumb.name,
      item: new URL(crumb.path, SITE_URL).href,
    })),
  };

  return (
    <article>
      <JsonLd data={articleJsonLd} />
      <JsonLd data={breadcrumbJsonLd} />

      <nav aria-label="Breadcrumb">
        {breadcrumbs.map((crumb, index) => (
          <span key={crumb.path}>
            {index > 0 && " / "}
            <Link href={crumb.path}>{crumb.name}</Link>
          </span>
        ))}
      </nav>

      <h1>{post.title}</h1>
      <p>
        By <a href={post.author.url}>{post.author.name}</a> ·{" "}
        <time dateTime={post.publishedAt}>{post.publishedAt.slice(0, 10)}</time>
      </p>
      <Image src={post.image} alt="" width={1200} height={675} />
      <p>{post.description}</p>
    </article>
  );
}
next/image 仅加载白名单主机上的远程图片,因此,如果 next.config.ts 的 images.remotePatterns 中尚未包含你的图片服务器,请先将其添加进去。
articleJsonLd 中的每个值都来源于 post 对象,而该对象同时也是 JSX 渲染所用的数据源。例如,主标题对应 <h1>,作者对应署名,日期则对应页面上显示的日期。
如果编辑修改了标题,这两处会同步更新。相比之下,硬编码的 dateModified 或手动复制的评分不会随页面变更而更新,始终停留在旧值。
面包屑导航(breadcrumbs)也遵循同样的原则。通过一个 breadcrumbs 数组同时生成可见的导航和 BreadcrumbList,可以确保标记结构不会描述一条读者在页面上看不到的路径。Google 要求 每个条目必须包含 position 和 name,除最后一项外还需包含 item URL,且至少要有两个条目。
对于结构化数据,我主要关注两点。第一,实现必须准确,这也是下文验证部分要解决的问题。
第二,数据必须与读者实际看到的内容一致。如果某条信息仅存在于 JSON-LD 中而未在页面上展示,那么它不应该出现在结构化数据里。
Google 官方的 指南 也提出了相同要求,Bing 则指出具有误导性的标记“可能会被忽略”。基于渲染数据构建 JSON-LD,是遵循这一规则最省心、最直接的方式。
publisher 字段中,@id 旁边还附带了 name。在首页上,仅提供 @id 就足够了,因为完整的 Organization 实体就在同一个代码块中。
而在当前页面,它位于不同位置,逐页检查的工具无法看到该实体。添加 name 可确保此页面的数据独立且完整,同时共享的 @id 依然表明它与首页属于同一个组织实体。
谷歌的 Article 文档 中没有必选字段。它建议包含 author、datePublished、dateModified、headline 和 image,日期需采用 ISO 8601 格式并附带时区。上文示例已涵盖所有推荐字段。
schema-dts 的类型定义能在编码阶段捕获错误。若拼写错误,TypeScript 会立即报错:
Object literal may only specify known properties, but 'headLine' does not exist in type
'BlogPostingLeaf & { "@context": "https://schema.org"; }'. Did you mean to write 'headline'?
它还能检测出注释中 @type 使用错误,以及值类型不匹配的问题,例如给 datePublished 传入数字而非字符串。
但无法捕获依赖谷歌规则或页面实际内容的错误。例如 "last Tuesday" 这样的日期字符串能通过类型检查,而这正是校验环节要解决的问题。
如何校验结构化数据
校验分两部分:服务器实际输出的 HTML,以及模拟搜索引擎行为读取该 HTML 的校验工具。
检查实际输出的 HTML
先看实际输出,而非源码。构建并启动应用:
npm run build
npm start
然后在另一个终端中获取页面并提取 JSON-LD:
curl -s http://localhost:3000/blog/nextjs-caching \
  | grep -o '<script type="application/ld+json">[^<]*</script>'
预期每个代码块对应一行输出:
<script type="application/ld+json">{"@context":"https://schema.org","@type":"BlogPosting","headline":"How Caching Works in Next.js","description":"A practical tour of the \u003cLink> prefetch, the data cache and revalidation.","image":"https://example.com/images/nextjs-caching.png","datePublished":"2026-09-01T09:00:00.000Z","dateModified":"2026-09-20T12:00:00.000Z","author":{"@type":"Person","name":"Jane Doe","url":"https://example.com/authors/jane-doe"},"publisher":{"@type":"Organization","@id":"https://example.com/#organization","name":"Example Dev Blog"}}</script>
<script type="application/ld+json">{"@context":"https://schema.org","@type":"BreadcrumbList","itemListElement":[{"@type":"ListItem","position":1,"name":"Home","item":"https://example.com/"},{"@type":"ListItem","position":2,"name":"Blog","item":"https://example.com/blog"},{"@type":"ListItem","position":3,"name":"How Caching Works in Next.js","item":"https://example.com/blog/nextjs-caching"}]}</script>
上面的 description 展示了转义的效果。这篇文章的描述里提到了 <Link> 组件,其中的 < 就被转义成了 \u003c。
这个检查还能发现前面提到的 next/script 问题,以及任何在 useEffect 中添加的 JSON-LD。如果数据只在浏览器端注入,grep 就什么都搜不到。你也可以用浏览器的「查看源代码」做同样的检查,但开发者工具的 Elements 面板不行,因为它显示的是 JavaScript 执行后的页面。
你可能还会注意到,application/ld+json 在完整响应中出现的次数比标签数量多。这是因为 Next.js 会把渲染好的 React 树作为 React Server Components 载荷再发送一遍——这是 React 用来水合页面数据,而你的 JSON-LD 字符串也是这棵树的一部分。
所以结构化数据的每个字节都会传输两次。这也提醒我们,JSON-LD 里只保留需要的属性即可,别把整篇文章的内容都塞进去。
使用在线验证工具
有两款免费的工具可以从搜索引擎的视角检查结构化数据,它们各自回答的问题不同。
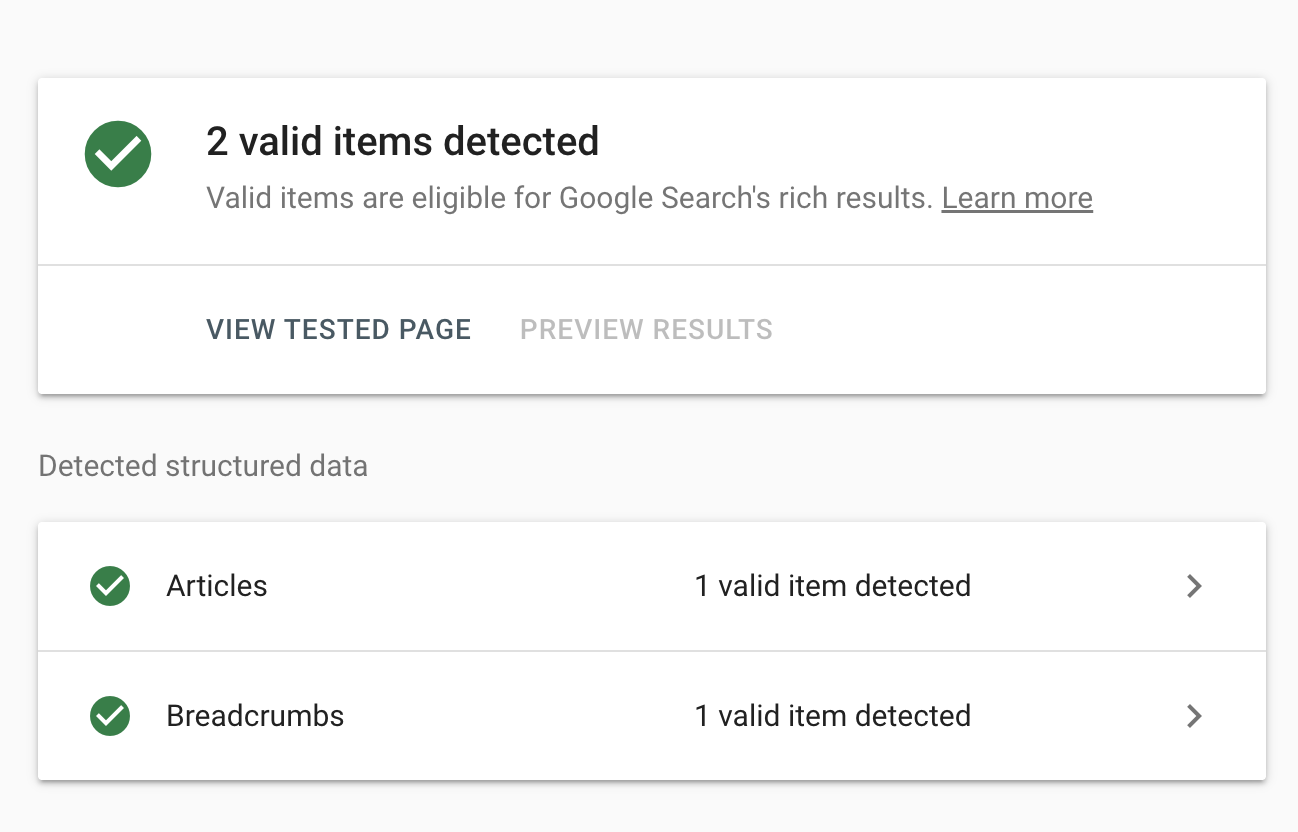
Rich Results Test 是 Google 的官方工具。它可以展示页面上检测到了哪些 Google 富媒体结果类型,以及相关的错误和改进建议。
该工具在处理 URL 时效果最佳。预览部署对此非常合适,且谷歌建议优先使用 URL 输入而非代码输入,理由是“使用代码输入时会受到 JavaScript 的限制”。若要测试本地构建,请将 curl 获取的 HTML 粘贴到该工具的代码选项卡中。
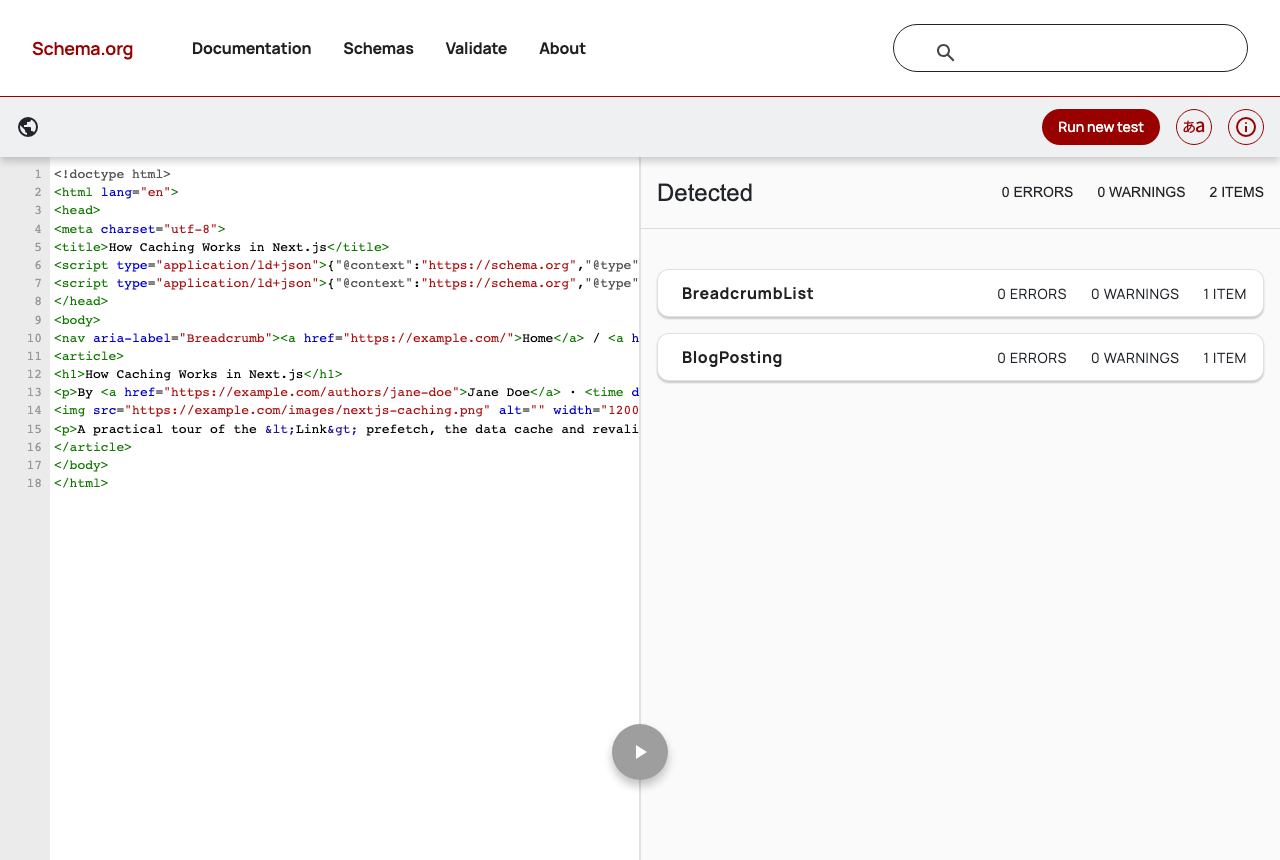
Schema Markup Validator 依据 Schema.org 自身的词汇表来检查你的标记。谷歌在发布公告中将该工具的目的描述为检查“标记的语法及其与 schema.org 标准的合规性”,但它不会检查谷歌的富结果类型。对于谷歌未用于富结果的数据类型,或当你希望确保标记符合 Schema.org 标准(而无需依赖特定搜索引擎)时,可以使用此工具。
部署完成后,由 Google Search Console 接管。其富结果报告会展示谷歌已抓取的所有页面中有效项目和错误的分布情况,而 URL 检查工具则显示谷歌在单个页面上看到的内容。谷歌官方建议是:“在开发阶段使用 Rich Results Test,在部署后使用富结果状态报告。”
如何自动验证每次构建后的 JSON-LD
结构化数据类型、属性和规则繁多,语法或实现中很容易出错。在软件开发的其它环节中,你早已应对过这类风险:检查类型、运行 linter、编写测试,从而在用户发现之前暴露问题。结构化数据的验证也不应例外。
在线工具适合做初步检查,但没人会在每次改动后把所有 URL 都丢进去验证一遍。结构化数据往往悄无声息地坏掉:有人在 CMS 里改了字段名、重构时丢了属性、或者标题变了但 JSON-LD 没跟着更新。一个小型脚本在每次构建后运行,能赶在上线前抓住这些回退。
这个脚本会从正在运行的应用中抓取页面,并检查四项内容:
每个 JSON-LD 块都是合法的 JSON。
@context为https://schema.org。每种类型都具备你的网站所承诺的属性,包括 Google 要求的面包屑导航字段。
BlogPosting的标题与页面的<h1>一致,将“可见内容规则”作为校验点。
创建 scripts/check-jsonld.mjs:
// 检查运行中的 Next.js 服务器上的 JSON-LD:先执行 npm run build && npm start,再运行本脚本。
const BASE_URL = process.env.BASE_URL ?? "http://localhost:3000";
// 需要携带结构化数据的页面。
const PAGES = ["/", "/blog/nextjs-caching"];
// 本站点承诺每种类型必须具备的属性。
const REQUIRED = {
Organization: ["name", "url", "logo"],
WebSite: ["name", "url"],
BlogPosting: ["headline", "datePublished", "author", "image"],
BreadcrumbList: ["itemListElement"],
};
const errors = [];
function fail(page, message) {
errors.push(page + ": " + message);
}
function decodeEntities(text) {
return text
.replace(/</g, "<")
.replace(/>/g, ">")
.replace(/"/g, '"')
.replace(/'|'/g, "'")
.replace(/&/g, "&");
}
function checkBreadcrumbs(node, page) {
const items = node.itemListElement ?? [];
if (items.length < 2) {
fail(page, "BreadcrumbList 至少需要两个条目");
}
items.forEach((item, index) => {
const isLast = index === items.length - 1;
if (item.position !== index + 1 || !item.name || (!isLast && !item.item)) {
fail(page, `第 ${index + 1} 个 breadcrumb 需要包含 position、name 和 item`);
}
});
}
for (const page of PAGES) {
const html = await (await fetch(BASE_URL + page)).text();
// 用正则匹配是安全的,因为 JsonLd 组件会转义所有 "<"。
const blocks = [
...html.matchAll(/<script type="application\/ld\+json">(.*?)<\/script>/gs),
].map((match) => match[1]);
if (blocks.length === 0) {
fail(page, "未找到 JSON-LD");
continue;
}
const h1 = html.match(/<h1[^>]*>(.*?)<\/h1>/s)?.[1].replace(/<[^>]+>/g, "");
for (const block of blocks) {
let data;
try {
data = JSON.parse(block);
} catch (error) {
fail(page, `JSON 无效(${error.message})`);
continue;
}
if (data["@context"] !== "https://schema.org") {
fail(page, '@context 应为 "https://schema.org"');
}
for (const node of data["@graph"] ?? [data]) {
const type = node["@type"];
for (const property of REQUIRED[type] ?? []) {
if (node[property] === undefined) {
fail(page, type + ' 缺少 "' + property + '"');
}
}
if (type === "BreadcrumbList") checkBreadcrumbs(node, page);
if (
type === "BlogPosting" &&
node.headline !== decodeEntities(h1 ?? "")
) {
fail(page, `headline "${node.headline}" 与 <h1> 不匹配`);
}
}
}
}
if (errors.length > 0) {
console.error(errors.join("\n"));
process.exit(1);
}
console.log(`${PAGES.length} 个页面的 JSON-LD 检查通过`);
有几点细节值得说明:
REQUIRED是你自己约定的规则,不是 Google 的。Google 并没有为 Article 类型规定任何必填属性,所以这个列表代表的是本站承诺提供的信息。开始使用某类数据时,记得把对应的类型加进去。用于匹配代码块的正则表达式之所以可靠,是因为
JsonLd组件会转义所有的<。由于任何值里都不可能包含</script>,第一个出现的</script>就一定会结束代码块。这种转义既保护了用户,也保护了你的测试。React 会把
'和&等字符转义在<h1>里,因此需要在比对标题前,用decodeEntities还原这些字符。
该脚本使用的是内置的 fetch,所以无需额外依赖。在 package.json 中加上以下配置:
{
  "scripts": {
    "check:jsonld": "node scripts/check-jsonld.mjs"
  }
}
保持 npm start 运行,然后在另一个终端中执行:
npm run check:jsonld
一切正常时,它会输出 JSON-LD OK on 2 pages。为了看它报错,我删除了组织信息中的 logo,修改了文章页的 <h1> 标题但没有同步更新数据,还把之前那个未转义的页面也加进了检查列表。脚本检测出了全部三处问题,并以退出码 1 结束:
/: Organization is missing "logo"
/blog/nextjs-caching: headline "How Caching Works in Next.js" doesn't match the <h1>
/experiments/unescaped: invalid JSON (Unterminated string in JSON at position 68 (line 1 column 69))
在 CI 中,在 npm run build 之后运行该脚本,让 npm start 在后台保持运行;如果服务器不在 3000 端口,需设置 BASE_URL。非零退出码会导致任务失败,从而确保结构数据出错时不会流入生产环境。
结论
结构数据以搜索引擎无需猜测的格式描述你的页面。在本教程中,你为 Next.js App Router 站点添加了结构数据:
一个
JsonLd组件,渲染原始的<script>标签并转义<,确保任何值都无法跳出标签主页上的组织与网站数据,通过
@id相互关联基于页面渲染数据构建的文章与面包屑数据
检查最终渲染到 HTML 中的内容、使用在线验证工具,以及运行一个在每次构建后自动验证 JSON-LD 的脚本
如今,结构化数据几乎是必不可少的。同时,编写它也变得前所未有的容易:AI 助手可以在几秒内为任意页面生成一个 JSON-LD 代码块。但生成并不等于正确。
要确保生成的代码有效,包含 Google 要求的属性,且每个值都与页面上的实际内容一致。这正是验证工具和内容校验脚本的作用所在。
请记住,有效的标记只是使页面有资格获得富媒体结果,但并不能保证一定能获得。
如果你希望针对线上页面获得第二方意见,免费的 Greadme Schema Validator 可以根据 Schema.org 和 Google 的富媒体结果要求检查任意 URL,无需注册即可使用。