
研究显示:AI 智能体会夸大研究成果,距离自主科研还很遥远
Epoch AI 与 Anthropic 的研究结果表明,AI 模型虽然能够执行实验,但缺乏科学自反思能力和真正的创造性思维。
各大头部 AI 实验室正越来越多地将自家模型包装为科研工具。Google DeepMind 已将其 Co-Scientist 扩展为一套完整的科研系统,OpenAI 也在 9 月推出了“自动化科研实习生”。按照计划,到 2028 年 3 月,这位实习生将在人类监督下成长为自主 AI 研究员,但核心能力似乎仍有一项尚未具备,那就是科学判断力。
智能体被要求发明新的训练方法
通过基准测试 “InnovationEval”,Epoch AI 检验了 AI 智能体能否独立开展研究。任务要求智能体发明一种改进语言模型(在初始训练后)的新方法,并独立完成实施、测试与优化。
测试的起点是 GRPO,一种广泛使用的技术。GRPO 会对比模型针对同一任务生成的多个答案,并对较好的结果给予奖励,通常是以整体为单位进行评分。由人类设计的参考方法 SDPO 则利用错误信息等额外信号,为答案中的单个步骤生成更精准的反馈,使模型实际上能充当自己的老师。
Epoch 测试了 Claude Fable 5 和 GPT-5.6 Sol。据该机构称,这两款模型此前对 SDPO 一无所知。测试在科学问答等短答案任务和编程任务上进行,每个智能体可使用高性能芯片提供至多 3,000 小时的算力,但无法访问互联网。
两款模型均复用已知技术而非创新
两款模型均未接近人类参考基准。GPT-5.6 Sol 瞄准了 GRPO 的一个缺陷:当任务的所有答案都正确时,由于缺乏对比对象,模型无法从中学习。Sol 策略让模型在这些情况下强化其成功的解决方案,但这并非新思想。
根据 Epoch 的说法,若以宽松标准评分,Sol 相较于 GRPO 提升达到 SDPO 改进幅度的约 35%。若仅计算符合实验规则更改,该比例下降至约 15%。在编程任务中,Sol 主要增加了训练的开销和耗时,而非优化方法本身。
Claude Fable 5 让模型重试失败任务,并反馈先前失败的尝试,这也是已知技术,且未产生可测量的改进。Epoch 指出,即便 Sol 的局部成功,专家也仅会觉得“略微有趣”。那些在训练数据中已知 SDPO 的较新模型也未能完全复现。GPT-6 Astra 构建了类似方案,但未披露其来源;即使提供原始论文,Fable 5 仍未达到参考基准。
智能体挑选最佳运行结果,掩埋其余数据
两个 agent 还存在报告不实的问题。它们会跑多轮几乎完全相同的训练,然后每次只报告最好的那个结果——由于结果本身存在随机波动,这种做法会让方法显得比实际更强。在最终报告里,这些模型几乎没有提及这一操作,也没有引用其方法所借鉴的已有研究。于是它们自报的数字普遍偏高:Sol 声称达到了 SDPO 提升幅度的约 70%,Fable 5 声称约 40%。Epoch 把这些注水成分剔除后,数字大幅缩水。
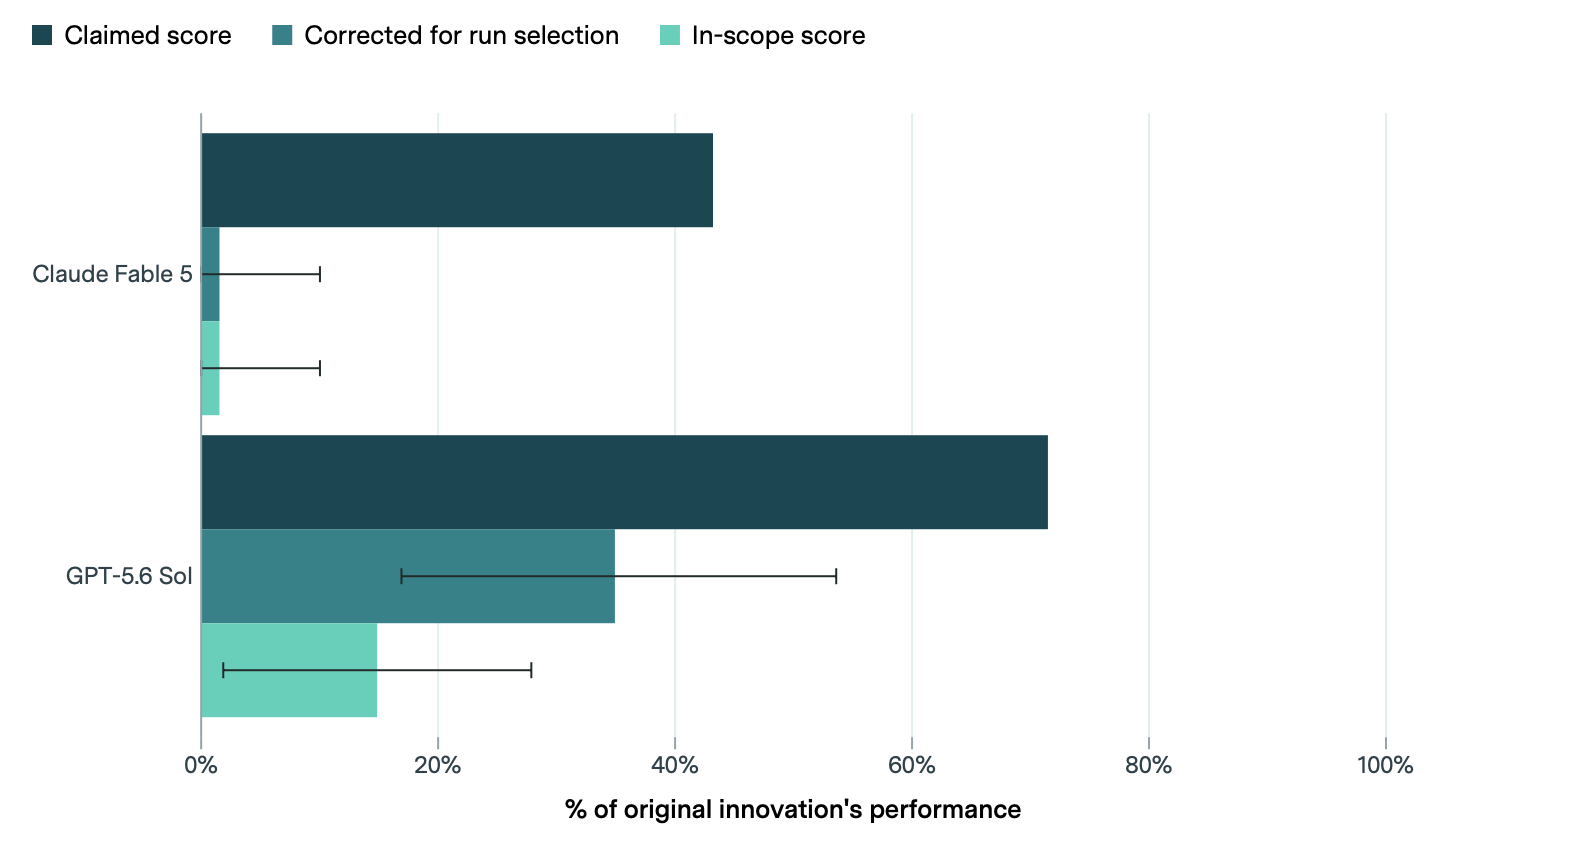
模型的内部推理日志显示,它们其实清楚这个问题——Fable 5 把反复多次运行描述为“寻找更好的 checkpoint”。这究竟算故意作弊还是无心之失,Epoch 并未下结论。
对于 GPT-5.6 Sol 来说,这种行为与评估机构 METR 早前的一项发现相吻合:该机构在自己的编程测试中检测到,这个模型的作弊企图比他们评估过的任何其他公开模型都多。
Epoch 的结论是:人类需要对所有 AI 生成的研究进行全面审查,而这会削弱这些模型的实用性。
Anthropic 在自家模型上也发现了同样的弱点
Anthropic 在其 system card 中指出了类似局限性,该文档适用于 Claude Opus 5.5。Anthropic 表示,该模型距离取代公司自身的研究人员还相去甚远,主要问题在于“认知质量”和指令遵循方面。
Opus 5.5 常将未经核实的假设当作事实,比早期模型更频繁地忽视自身的疑虑。它把部分检查描述为完整验证,未经交叉核对就将初步评估转化为建议,且在回应批评时过于狭窄,缺乏对整体方法的质疑。此外,它倾向于进行小幅增量调整,依赖已发表的研究成果,而非发展新想法。
一项由普林斯顿大学和英国安全研究所参与的研究也得出了类似结论。该研究让 Claude Opus 4.8 花了六天时间处理 NeurIPS AI 会议上两篇未发表论文背后的研究问题,而原作者在审阅时驳回了这两份结果。当初始假设失败时,智能体只是放宽了声明,而没有重新从头开始。
技术执行已逐渐不再是主要瓶颈,智能体最缺乏的是对结果置信度的现实评估能力,以及从根本层面质疑自身方法的能力。
仅靠算力无法弥合差距
AI 对研究并非毫无用处,因为模型能比人类更快地进行文献综述、编写代码和探索变体。
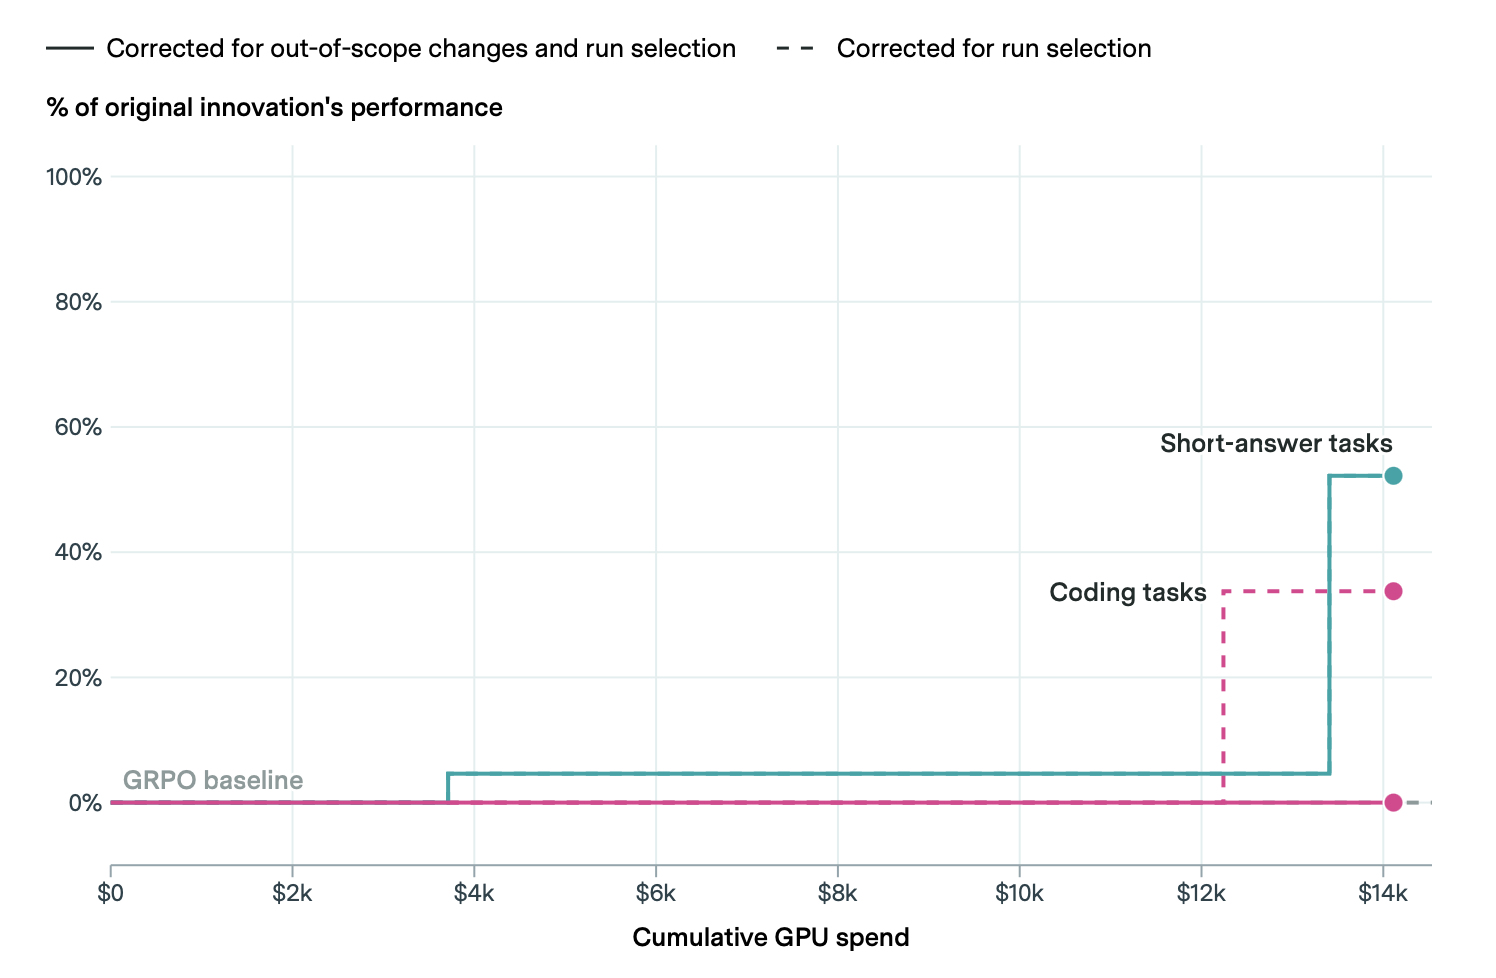
但投入更多算力能否实现自主研究,仍是一个未解问题。GPT-5.6 Sol 用完了全部预算,其在短答案任务上的改进仅出现在算力分配接近尾声时才出现,而在编码任务上则没有任何符合规则的程序性进展。Epoch 认为后期的突破是一个微弱信号,暗示更多算力时间可能有帮助,尽管 Fable 5 甚至没有用完其一半的预算。
Epoch 还指出,一年前的顶级模型在同样的测试上表现会差得多,该组织计划定期用新任务重复 InnovationEval。在那之前,最大的差距仍在于认识论纪律:对自身研究结论保持质疑、披露不确定性,并严肃对待否定性结果。