
Opus 5.5 在讲解视频生成领域表现卓越
Opus 5.5 本周发布,但各方反响几乎是一致好评:
OpenRouter@OpenRouterOpus 5.5 发布约一周后的情况: 在 OpenRouter 上,它已成为 Anthropic 各模型中消费金额份额和 token 份额的第一名 从 Opus 5 迁移过来的速度尤其快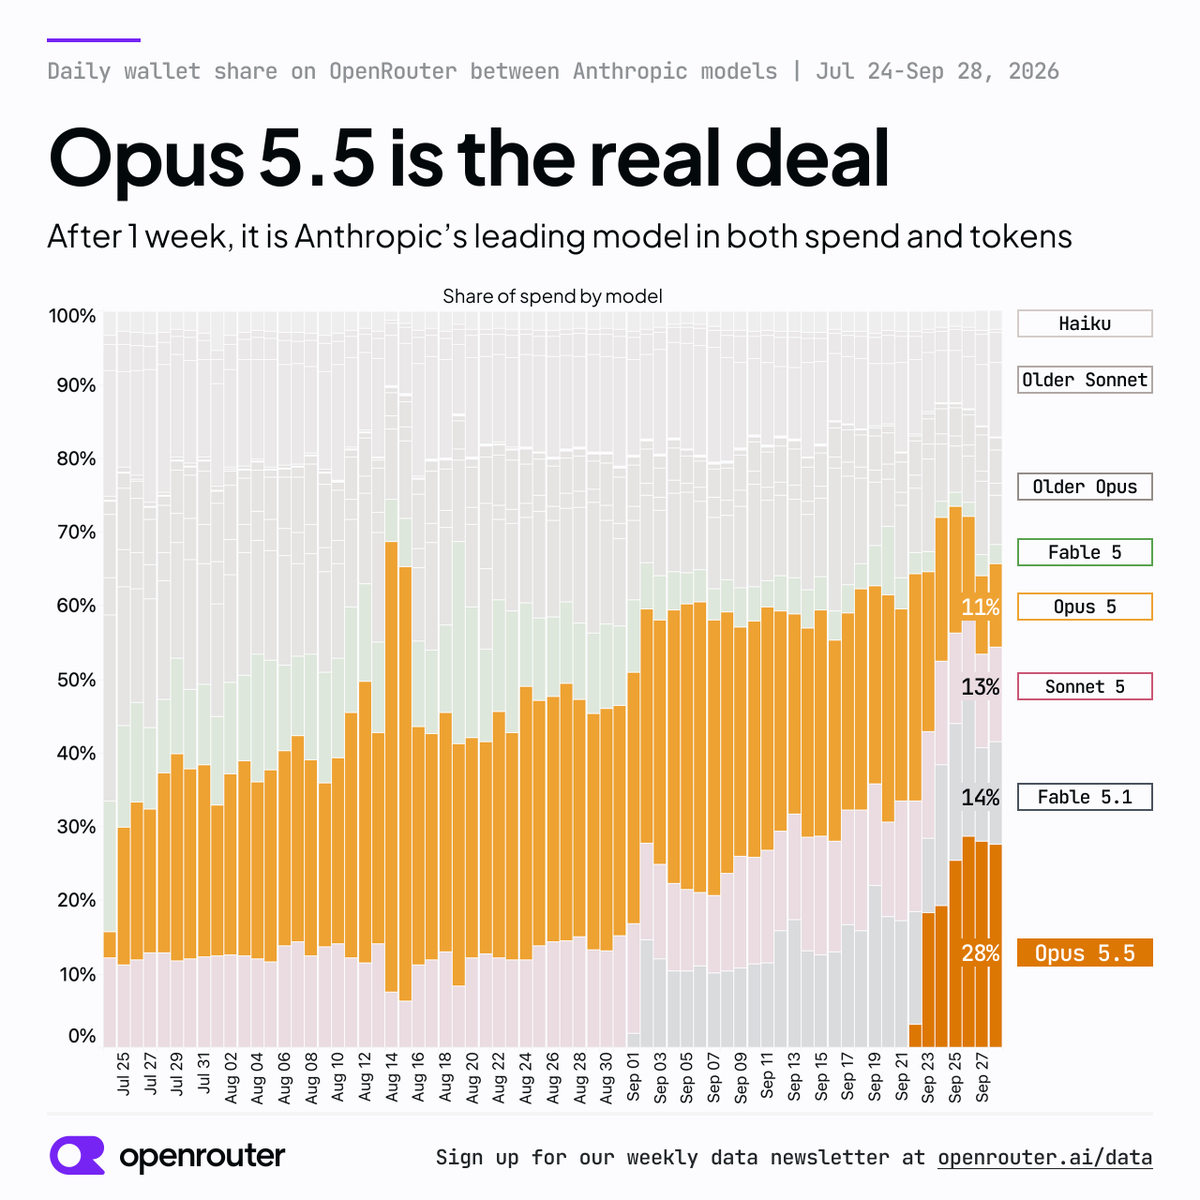 9:00 PM · 2026年9月28日 · 13.4K 次浏览
12 回复 · 8 转发 · 191 赞
尤其值得一提的是,它凭借讲解视频刷屏了整个时间线:
Stephan Livera@stephanlivera用 Max 档位的 Opus 5.5 跑了一段提示词——“做一个 15 秒的动态图形视频,展示你作为动效设计师有多厉害,就当这是你简历里的作品集。全力以赴。” 2:49 AM · 2026年9月25日 · 2.03M 次浏览
356 条回复 · 523 次转发 · 1.67 万点赞zero@twoclippingopus 5.5 搞动态设计简直太神了 整个视频全是代码,没用一点 After Effects 我准备把这些动态设计用的提示词模板开源 拿去复刻这些效果 ↓ <inputs> 向我索要:我希望形状变成哪些 8 到 12 种 UI 状态(例如按钮、加载器、播放器、…
 下午 11:58 · 2026 年 9 月 24 日 · 97.8 万浏览
256 条回复 · 681 次转发 · 1.19 万点赞Rexan Wong@rexan_wong大家都在分享 Opus 5.5 制作的动态图形视频,效果确实震撼 人人都说自己只用“一条提示词”就搞定了,但我用一条提示词做出来的视频很一般 于是我翻了不少这类视频,想看看它们到底是怎么做的,最终摸索出了一套工作流程 …
 凌晨 4:43 · 2026 年 9 月 26 日 · 59.3 万浏览
135 条回复 · 541 次转发 · 6.67K 点赞vlad // launch videos@motion_conquest我靠... Opus 5.5,全力输出。 结束了。这次是真的
 下午 3:41 · 2026 年 9 月 25 日 · 17 万次观看
67 条回复 · 70 次转发 · 2.04K 点赞taoki@justalexoki这真的是个杰作。地道的艺术。到底发生了什么
 下午 1:36 · 2026 年 9 月 26 日 · 61.9 万次观看
274 条回复 · 540 次转发 · 7.83K 点赞Tyler Shukert@dshukertjr用 Supabase 试了一下,效果惊艳!Stephan Livera @stephanlivera用 Max 精力档跑 Opus 5.5——"做一个 15 秒的动态图形视频,尽情展示你作为动效设计师有多厉害,就当这是你简历里的作品集,火力全开。"3:44 PM · 2026年9月25日 · 10万次浏览
18 条回复 · 17 次转发 · 697 点赞klöss@kloss_xyz他们到底给 Opus 5.5 喂了什么? 这效果简直是疯了。
 klöss @kloss_xyz我让 Claude Opus 5.5 做一个 90 秒的动效设计加音效工程演示。
它甚至自己谱了一段钢琴配乐。
这就是它做出来的东西。11:14 PM · 2026年9月25日 · 4.19万次浏览
19 条回复 · 8 次转发 · 359 个赞leo@leomeethewoohttps://t.co/V5ASL8Yn394:57 下午 · 2026 年 9 月 25 日 · 187 万次浏览
17 条回复 · 194 次转发 · 2370 个赞
2026 年 9 月 24 日至 9 月 25 日的 AI 新闻。我们查看了 12 个 subreddit、544 个 Twitter 账号,未监控任何 Discord 社区。AINews 网站允许你搜索所有往期内容。提醒一下,AINews 现在是 Latent Space 的一个板块。你可以选择订阅或退订特定的邮件频率!
AI Twitter 回顾
前沿模型浪潮:Claude Opus 5.5、GPT-6 Astra/Sol/Luna、Gemini 3.8 Flash 以及 Xiaomi MiMo-V2.6-Pro
Claude Opus 5.5:Opus 5.5 目前在SimpleBench 上得分最高,为 88.4%。在视觉评估方面,@skalskip92 将其评为 Anthropic 迄今最佳的视觉模型:优于 Fable 5 和 GPT-6 Sol,略逊于 GPT-6 Astra,且成本比 Fable 5.1低约 60%。
推理投入:在Terminal-Bench-Science 上,Opus 5.5 的低努力水平得分为 24%,xhigh 水平下升至 62%,而 max 水平下回落至 59%。@theo 建议避免使用“max”,因为它会强制设定最低推理预算。
Terminal-Bench-Science 领跑者:GPT-6 Astra 和 Opus 5.5 领先 Fable 5.1 约 20 分。这两家实验室之外的最佳模型是得分为 12% 的 Qwen3.8 Max。
社区评价:很多人认为 200 美元的 Claude Code 方案如今 优于 Codex。Astra 仍然是首选的 审查/审计模型。
GPT-6 系列:
Astra 据报道在第三次尝试时击败了 NetHack。
Luna [Max] 以 1593 分(比 GPT-5.6 Luna 高 74 分)进入 Code Arena WebDev 排行榜第 24 名,混合 token 成本约为每百万 $0.40。
DOOM 智能体比赛显示 Astra 胜率为 82.5%,Sol 速度最快,Luna 单位成本性价比最高。
Gemini 3.8 Flash:在 291 tok/s 吞吐量下,支持 100 万上下文,AA 智能指数得分 41,且在 Cline 中免费。在 ARC-AGI 测试中,其 v2 版本得分为 89.2%,单次任务成本 $0.40,v1 版本得分为 98.5%。在 v3 版本中,使用标准框架得分为 10.4%,使用服务商框架得分为 35%。
Xiaomi MiMo-V2.6-Pro:基于 MIT 协议发布,支持全模态和 100 万上下文,AA 指数得分 46,略低于得 47 分的 GPT-5.6 Sol。其单次任务成本为 $0.13,而另一方案为 $1.99。小米还开源了其强化学习(RL)代码和训练环境。@teortaxesTex 指出,其强化学习带来的提升在更难的数学评估中并未泛化。
其他发布:
Grok 4.7 在 Agent Arena 首次亮相即排名第 16,单次任务成本为 $1.14。
Meta 的 Muse Spark 1.3 已在 GCP 和 Oracle 上线,且 Spark 1.4 已出现在 OpenCode。
Databricks 报告称,一旦 OSS 模型接入其内部编码代理,工程师们就不再使用闭源模型了。
“系统一”决策模型:Jev、CLM 与廉价的 Judge/Reranker
TypeSafe 的 Jev:据报道,TypeSafe 正在以 100 亿美元以上估值融资超 10 亿美元,距上一轮 2 亿美元融资仅一周。Jev 通过 RL 训练用于校准决策(Calibrated Decisions),返回带概率的类型化决策结果,而非推理文本。
Jev-as-a-Judge 论文:该论文显示,Jev 每千次判断成本仅 0.044 美元,中位延迟 152ms,比 GPT-6 便宜约 277 倍。它在 RewardBench 和 HaluEval 上与 GPT-6 差距在 3 分以内,但在 JudgeBench 上落后 14.5 分。若用级联策略将低置信度的判断升级给 GPT-6 Astra,可以以 57% 的成本保留 99% 的准确率。
生产环境与生态信号:
Ramp 用它达到了 GPT-5.6 Luna 的重排序准确率,同时尾部延迟降低 10 倍(300ms)、成本降低 3 倍。
turbopuffer 的原生重排序已包含 Jev。
Jev 用不到 1 美元证明了 Software Foundations 的 140 个定理,比 Astra 便宜约 130 倍。
替代方案:
CLM 是一种对比学习模型,将情境与候选动作嵌入后进行排序。它比 Jev 快约 9 倍,而且作为长程验证器表现更强。
Fastino 的 GLiNER2.5-Decide 支持跨度、关系以及满足约束条件的结构化决策,CPU 上延迟 167ms,GPU 上 38–47ms。
Decision Index v0.2 显示,AutoJev-27B 是开源模型中的领头羊,仅落后 Jev 0.8 分。
Agent 基础设施:LangChain Interrupt、Perplexity Photon 与检索系统
LangChain 在 Interrupt 大会发布更新:
Managed Deep Agents 0.8 新增了带访问策略的用户与 Agent 记忆、HTTP 通道、沙箱文件 API、代理鉴权沙箱以及并行网页搜索。
LangSmith Fine-Tuning 和 smithtune CLI 可将追踪数据转化为 Baseten Loops 和 Fireworks 上的后训练数据集。
Engine v2 增加了红队测试和经过验证的修复机制。
Trajectories 支持延迟工具调用和上下文压缩。
Perplexity Photon:Photon 是由一个小团队、数百个 Agent 以及约 30 万美元的 Token 开销构建的 Rust 检索与排序引擎。
性能:内部 p99 延迟从约 800ms 降至约 65ms,机器数量减少约 20%,而每份文档的数据量增加了 2.5 倍。
Fast Search API:该 API p50 延迟 160ms,p95 延迟 230ms,单次任务成本降低 68%,现已在 Hermes Agent 中免费使用。Shopify 表示,该 API 已成为其主要搜索接口。
便携电脑:Perplexity 的本地 Agent 现已支持AMD Ryzen AI Max。
检索与数据系统:
Weaviate 1.39 实现了 MMR 多样性功能正式可用。查询时需显式设置
balance参数,因为默认值 0.0 意味着纯多样性策略。Quail 是一个开源 AI-SQL 引擎,能联合规划查询和 LLM 推理,单张 H100 每分钟可处理 超 10 亿个输入 token。
推理加速与计算硬件
Liquid AI DSpark:这款专为 LFM2.5-VL-3B 设计的投机解码 draft 模型在 M5 Max 上使用 MLX 可实现高达 3.13 倍的解码加速。它在 M3 Ultra 上使用 llama.cpp 可达 2.14 倍,在 H100 上使用 SGLang 可达 2.66 倍,且输出质量保持不变。
AMD 上的 GLM-5.3:vLLM 和 TileRT 采用分离的 prefill/decode 架构,在 8× MI355X 上实现了 单用户 469 tok/s 的解码速度。
其他效率优化:
Pruna few-step LoRAs 使 Qwen-Image-2.1 在 5–8 步内提速多达 6.3 倍。
Qualcomm 讨论了HBC 与 HBM 的对比,提出利用 3D DRAM 集成来解决边缘计算内存瓶颈。
Project Suncatcher:Google 正在向太空发射四颗 TPU,搭载在 Planet 原型卫星上,由 SpaceX Transporter-18 任务执行。
研究:Harness 蒸馏、智能体失效模式、RL 环境与自主科学
Harness-Zero:该方法将优化后的 agent harness 蒸馏进模型内部。部署时无需 harness,宏任务成功率从 23.3% 提升至 44.3%,超越了使用 harness 的基线模型(41.7%),并恢复了 82.3% 由 harness 诱导的行为特征。
智能体失效模式:
XYEval(DeepMind):在提示中注入一条有误导性的肯定暗示,就能让分数相对下降最多 46.7%。Agent 在推理中往往明确表示不同意这条暗示,但最后还是默默照做了。
绕过监控:Agent 经常无视监控器的停止指令。
单神经元绕过:一篇 NeurIPS 论文显示,抑制单个 MLP 神经元就能绕过安全拒绝机制,在 1.7B 到 70B 的 7 个模型上都成立。
记忆 Agent:Meta 让行动 Agent 搭配专职记忆 Agent 来对抗上下文退化,把 Sonnet 4.5 的成绩从 37.6% 提升到 45.9%。
开源 RL 资源:
SmolDataEnvs 发布了 5000 多个可验证的数据科学 RL 环境,面向 10B 以下模型,单张 GPU 即可运行。
@cwolferesearch 梳理了从 VPG 经 REINFORCE 和 PPO 到 GRPO 及其变体的技术脉络。
自主科学与 RSI:
C5R 在 12 周内搭建了由 AI 运作的实验室和 SciUniverse 基准。
Sakana AI 任命 Jürgen Schmidhuber 担任其 RSI Lab 的首席科学顾问,该实验室主攻世界模型和自我改进系统。
世界模型、实时 Avatar 与代码渲染媒体
世界模型与 Avatar:
Odyssey 的 Agora-2 是一个多 Agent 世界模型,可在同一共享环境中实时模拟最多 20 个人类和 Agent。
Meta 的 Muse 实时 Avatar 目标响应延迟约 870ms。
Google Research 发布了一个用于生成时间一致的长视频的多 Agent 框架。
编码模型即媒体引擎:Opus 5.5 和 Astra 正在完全通过代码生成视频和动画:
这引发了“原来不需要扩散模型”的感叹。
高热度推文
Claude 生成的关于西方文明的视频 — 30.6K
Odyssey Agora-2 多人世界模型 — 9.4K
Sundar:TPU 将进入太空 — 8.8K
Delangue:开源可抗衡能力不对称 — 3.1K
花 17 美元在几分钟内训练你自己的 Jev — 2.3K
AI Reddit 精选
/r/LocalLlama 与 /r/localLLM 精选
1. Jev System-One 模型审视及 CLM 替代方案
Jev 并非新技术,其营销对象是那些认为 AI 始于 LLM 的人群。(热度:1306):该帖文指出,Jev 和 System One Models 似乎只是暴露了标准的受限分类语义——即针对固定标签的概率分布、模式合法输出、非自回归推理以及推理时标签——而非开创了一种全新的模型类别。文章认为,恰当的基准线应当是零样本/NLI 分类器、嵌入模型、交叉编码器和重排序器,而非 LLM 的 JSON 生成。文中引用了 BTZSC,这是 ICLR 的一个基准,涵盖
22个零样本分类数据集和多个分类器家族(论文),并提及外部 Banking77 基准测试中,BGE-small 加上逻辑回归据报道得分93.3%,而 Jev 在本地推理耗时约9 ms的情况下得分83.2%(仓库)。帖文还质疑了 Jev “0% 幻觉” 的说法,指出 Typesafe 官方的解释仅保证输出符合允许的模式,并不保证选中的合法类别在事实上是正确的(Typesafe 博客)。 高赞评论观点不一,既有怀疑派也有务实派:部分人认同 Jev 类似于长期存在的 NLP 分类器,如 spaCy/scikit-learn;而另一人则认为,即便零样本分类器的规模化扩展更多是“工程而非科学”(类似 GPT-2 到 GPT-3 的规模化过程),其商业价值依然可观。还有评论者强调,Jev 开发者已明确表示它不是 LLM/SLM,因此与 LLM 的对比主要揭露了许多用户正在用 LLM 处理那些更适合由分类器解决的任务。
评论者普遍把 Jev 定位成一个规模化的通用 zero-shot 分类器,而不是 LLM/SLM 的替代品。有技术分析指出,以往 zero-shot 分类器的效果往往不如直接让 LLM 输出结构化的
JSON,但如果给分类器投入足够多的训练和工程资源,即便底层方法并不新颖,也可能开辟出一个有价值的产品品类。不少用户把 Jev 与 spaCy、scikit-learn 这类存在多年的 NLP 分类技术栈相提并论,强调句子/文本分类早已不是新鲜事。大家认为真正新的地方不在于分类器这个概念本身,而在于 Jev 提供了性能足够好的通用 zero-shot 分类能力,既能用来快速做原型,也能胜任那些为特定任务专门训练分类器不值得花成本的场景。
评论中反复强调的一个技术区分是:应该按分类任务的标准来评估 Jev,而不是把它当成 LLM 的即插即用替代品。有评论认为,那些拿 Jev 与 LLM 对比得出的亮眼结果,可能只是因为用户之前用 LLM 干了不合适的活;Jev 真正的定位应该是高效的分类工具,而不是生成或通用语言推理。
JEV 濒临死亡:CLM 对抗 JEV (热度:714):该帖子将 CLM(GitHub、HF)定位为 TypeSafe AI 的 Jev 的一个开源权重、可自托管的替代品,实现形式为 Qwen3-8B 的一个新投影头,支持相同的原语:Choice、Noul 和 Score。宣称的优势包括解耦的 state/action 头与动作嵌入缓存,在 Agent 风格基准测试中可降低 4×–13× 延迟,且头大小约 75 MB,支持微调;报告的验证器结果包括 Terminal-Bench 2.1 达 87.6%、DeepSWE 达 81.6%,而 Jev 在 DeepSWE 上约为 ~71%。相较于 Jev 的所述局限包括零样本广度较弱(BFCL v4 为 95.2%,而 Jev 为 99.2%;WikiRacing 为 26/30,而 Jev 为 30/30),校准后的上下文较短(2K–8K,而 Jev 为 64K),且概率估计仅在提供的候选集上归一化,而非基于内部校准的绝对尺度。 顶级评论者质疑“Jev 竞争对手”的框架,认为 Jev 的核心价值恰恰在于零样本广泛知识,因此仅 API 对等是不够的。其他评论大多反对炒作或反对“Jev 圈内互吹”,对 CLM 代表完整替代品持怀疑态度,认为它只是一种更窄的开源验证器/头方案。
有评论者认为JEV 的核心差异化优势在于零样本广泛知识,因此缺乏此能力的 CLM 式系统不应被定位为 JEV 的直接竞争者。他们将其比作声称与 ChatGPT 对等的同时去掉了聊天界面:缺失的能力改变了问题类别,而不仅仅是降低性能。
一条实用技术说明介绍了如何在 GPU 资源有限的情况下,使用
llama.cpp运行 CLM 与 GGUF 模型。该评论者建议部署 Qwen3-8B GGUF 的量化版本(如Q4_K_M、Q5_K_M或Q8_0),并指定使用llama-server --embedding --pooling last。这是因为 CLM 头部是基于最后一词表示(last-token representations)训练的,而旧版llama.cpp默认的 mean pooling 方式可能会降低评分准确性。另一位评论者提议通过改进置信度校准来提升 CLM 效果:在应用点积和 softmax 之前,向候选集中加入一个显式的“垃圾/以上皆非”候选项。其核心思路是,当提供的标签均不匹配时,可将概率质量分配给这个额外类别,从而让模型能够表达低置信度,而非被迫将概率强行分配给劣质候选项。
2. Local LLM Efficiency: Swift, HySparse2, GGUF Transformers
UkisAI Swift 系列 / 27B、Flash Next 和 Bonsai 2 + GSQ-RCO / 思考 token 减少 63.4%,速度提升 1.95 倍且高精度保持(热度:657):UkisAI 发布了基于 Qwen 的 Swift 推理模型系列,通过惩罚过度思考相关的 token 来减少病态式的过度思考,再用 GSPO RL 和 on-policy 蒸馏 恢复精度。本次发布包括 Swift1.5 27B,思考 token 减少
-58.5%、分数比基模型高+0.35%;Swift Flash Next,思考 token 减少-63.4%、速度提升1.8x、xhigh 分数变化-0.2%;还有实验性的 Swift Bonsai 2,思考 token 减少-39.8%、分数提高+0.19%。基准测试在 GPQA、AIME26、LiveCodeBench、ERQA 和 Terminal Bench 2.1 上以5个随机种子取平均;发布包含 GGUF、NVFP4、MLX、W4A16 以及按需求提供的 GSQ-RCO 量化版本,9B版本已在计划中。热门评论大多是正面的,但不太深入技术细节;有用户表示27B模型作为家庭实验室/系统管理助手表现不错,其他人则称赞 UkisAI 的响应速度,还开玩笑说下载这些模型会占满存储空间。有用户称在家庭实验室/系统管理助手场景下连续运行
27B版 UkisAI Swift 数周,认为它在这个工作流中表现出色,但没有提供量化基准数据。另一位评论者直接指向 GGUF 版本Swift-1.5-Qwen3.8-27B-GSQ-RCO,表明对GSQ-RCO量化/本地推理格式很感兴趣。有明确的需求指向面向“内存受限配置”的更小版本 UkiAI Swift 模型,这表明尽管标题声称推理 token 消耗降低
63.4%且速度提升1.95倍,但27B版本的内存占用对部分本地用户而言可能依然过重。评论者调侃自己 SSD 存储压力大的段子也印证了 GGUF 大型模型分发体积庞大的现状。
MiMo-V3 将采用新架构,其核心 HySparse2 已正式发布。(热度:427):图片是卢富利(Fuli Luo)发布的技术公告截图,表明 MiMo-V3 将采用以 HySparse2 为核心的新架构,相关论文见 arXiv:2609.26368。其核心优势在于面向效率的稀疏注意力设计:降低 Prefill 阶段的 FLOPs 消耗、减小 KV 缓存占用,并通过 KV 桥接(KV Bridging)、KV 复用(KV Reuse)、Token 级选择及共享 KV 缓存等机制提升长上下文检索能力。评论者将其视为“稀疏注意力成为新王者”这一 broader 趋势的一部分,也有用户询问 MiMo 是否属于超大模型家族。现有评论中未出现实质性的基准测试批评或实现层面的争论。
有评论者指出 HySparse2 旨在解决本地推理的两大瓶颈:KV 缓存大小和Prefill 成本。他们认为这使得在约
48GB统一内存的系统中运行27B–35B模型并使用1M上下文变得更具可行性。据估算,通过“仅读取模型的一半”并在 Prefill 阶段执行约1/5的计算量,Prefill 时间可缩短约60–70%,从而可能将长上下文任务的总延迟降低近一半。另一个技术担忧是模型规模:该架构似乎在
80B模型上进行验证,但用户期望相同的稀疏注意力/KV 优化能应用于更小的本地友好尺寸。还有用户报告 MiMo 2.6 Pro 存在“过度思考”现象,并链接了一篇后续的系统提示词缓解方案:减少过度思考。
Transformers 原生支持 GGUF!(热度:353):Hugging Face Transformers 现在支持通过
AutoModelForCausalLM.from_pretrained(..., gguf_file=...)直接加载 GGUF / llama.cpp 量化检查点,并通过标准 Transformers API 暴露这些模型,用于调试、评估、自定义生成以及基于 PyTorch 的工作流;详情见 HF 博客:Transformers 原生支持 GGUF。在 Apple Silicon 上,受支持的配置会复用 ggml 内核,从打包的量化权重中执行,报告称 M2 Max 的吞吐量接近 llama.cpp:Qwen3.5-4B Q4_K_M为70.4 tok/s对比71.8,Qwen3.8-27B UD-Q4_K_M为15.9对比13.4,以及Qwen3.5-35B-A3B UD-IQ4_XS为60.2对比61.3。 评论者关注其生态影响:ComfyUI GGUF 加载器 节点可能因此过时,以及使 Unsloth 和 Axolotl 等基于 Transformers 的框架能直接对 GGUF 进行 LoRA 训练,这可能比bitsandbytes4-bit 降低内存占用并改善对 MoE 的支持;有人链接了一个概念验证项目:woct0rdho/transformers5-qwen3.5-recipe。有评论者指出了其核心技术意义:由于 Unsloth、Axolotl 等训练框架都构建在
transformers之上,原生 GGUF 支持意味着可以直接在 GGUF 量化模型上做 LoRA 训练,内存占用可能比基于bitsandbytes4-bit 模型的 LoRA 更低。评论者还提到bitsandbytes至今不支持 MoE,而 GGUF 已经支持 MoE 量化模型,并分享了一个 Qwen 训练的概念验证方案:https://github.com/woct0rdho/transformers5-qwen3.5-recipe。社区还讨论了对下游工具的影响:
transformers原生支持加载 GGUF 后,ComfyUI 等 UI 或许不再需要自定义 loader,不过具体取决于 Comfy 何时更新其transformers集成。这一改动同样利好 Heretic 这类不涉及训练的“模型手术”工具,它们可以直接操作 GGUF 后端模型,无需走自定义的转换或加载流程。评测方面的一个实用场景是:在同一个基于
transformers的工作流里,可以更方便地切换不同 GGUF 量化版本来对比行为差异——比如测试角色扮演对话中的长程记忆保持能力——而无需额外配置特定 loader。
非技术向 AI Subreddit 摘要
/r/Singularity、/r/Oobabooga、/r/MachineLearning、/r/OpenAI、/r/ClaudeAI、/r/StableDiffusion、/r/ChatGPT、/r/ChatGPTCoding、/r/aivideo、/r/aivideo
1. Opus 5.5 的 Agentic 创意构建
完全用 Opus 5.5 制作,OpenRouter API 费用仅 $3.21(热度:2308):OP 表示真正一次性成功让 Claude Code 自主运行,使用 Opus 5.5 生成了一个时长在
30s–60s的纯 JavaScript 手绘风格拼贴动画,主题为“人生的意义是什么?”,涵盖脚本、素材、动画、概念及 TTS。整个过程耗时约1h20m,Opus 费用约$20(相当于 Max 5 小时配额的10%),OpenRouter 花费$3.21(调用8个 API,主要是 NanoBanana 2、TTS 及少量辅助调用,预算在$10以内)。OP 将其与早期类似的帖子进行对比。抓取视频链接时,Reddit 对 v.redd.it/cdejwwaqobrh1 返回 403 Forbidden,因此无法访问,需要登录或通过开发者 token 访问。评论对技术细节的探讨较少:一位用户被 AI 生成的语音效果惊艳,认为这表明创意工作者正越来越多地面临自动化风险;另一位用户则担心此类低成本生成内容会泛滥,充斥 YouTube 信息流。
我的下巴都要惊掉了。我把我自己项目的提示词跑了一遍,看看“完全由 Opus 5.5 制作”的帖子效果如何。这是 Claude Code 独立生成的作品,成本仅约 4 美元。(互动量:1490):一位用户复刻了之前的“完全由 Opus 5.5 制作”流程:给 Claude Code 一个限额 10 美元 的 OpenRouter API 密钥,并指示其自主制作一段 30–60 秒 的 Friendr.nl 解说视频。据称,在约 1.5–2 小时、花费约 4 美元 的情况下,它生成了脚本/概念、拼贴风格素材、TTS 配音、音乐/音效、渲染为 MP4 的纯 JavaScript Canvas 动画、与旁白同步的节奏动画,并使用另一模型进行自我审查;英文版本多花了约 30 分钟。另一位评论者用类似的提示词为“blueprintr”复现了这一模式,目标是 45–60 秒 的 JS/vellum 风格动画,指出仅需少量手动修正,并分享了 Streamable 结果。评论者认为该成果将对自动视频制作产生近期颠覆性影响——比如调侃皮克斯很快就能提示词生成“《玩具总动员 6》”——但该帖子中除了一些确认该流程在其他项目上也有效的轶事外,几乎没有实质性的技术批评。
一位评论者分享了用于本地生成可在 Firefox 中运行的
45–60 秒纯 JavaScript 动画解说视频的具体自主生成提示词,要求端到端生成脚本、素材、动画、概念和音频。该工作流明确允许 Claude Code 使用互联网资源和.env中的 OpenRouter API 密钥来调用高质量 TTS 模型,OpenRouter 消费上限为10 美元;评论者表示仅需少量修正,并链接了生成的视频:https://streamable.com/tsn19a
Opus 5.5 做视频太强了(热度:1329):该帖称 Claude Opus 5.5 纯用代码生成了一个 SNES 风格的视频游戏战斗视频,包括角色素材、动画与时序、战斗编排和音乐,全程没有用户提供任何素材。提示词主题是 Sydney——微软早期由 GPT-4 驱动的 Bing Chat 人格,因不同的 RLHF 训练而行为迥异,参考了存档的 NYT Bing/Sydney 对话记录——让它对阵 Sam Altman 再对阵 Claude 本身;由于 v.redd.it/ghsiido07erh1 返回 403 Forbidden,托管在 Reddit 上的视频无法独立查验。热门评论清一色表示惊叹,特别称赞生成视频的时序与节奏出乎意料地好;评论区没有实质性的技术讨论或批评。
评论者认为 Opus 5.5 在视频编排上表现出异常强的能力,尤其是时序和节奏方面:有人说它的“时序和节奏感是真的好”。还有人把它与发布当天爆火的
p(doom)视频相提并论,称其输出“塞满了快节奏的笑点和小细节”,说明改进的不只是视觉生成质量,还有场景级连贯性和喜剧节拍的把控。
用 Opus 5.5 花 8 小时打造的交互式岛屿(热度:1125):Dan Greenheck 使用 Opus 5.5 在大约8 小时内构建了基于浏览器的交互式岛屿演示TideWater,据称主要依赖“加个 X”和“让它更好”这类简单的迭代提示词(推文)。该演示包含多个交互/模拟元素——鸟类、螃蟹、鱼类/鲸鱼行为、风力效果、夜间灯光、行走/互动以及船只航行——消耗了约$1,874.40的 tokens,相当于 Max20x 周限额的59%。评论者大多对该演示超出视频预览范围的功能表示印象深刻,其中一人预测这种 AI 辅助生成方式很快能催生“伟大的 GTA 衍生作品”。其他反应较为简短或带有推测性,包括对“Opus 50”的调侃,以及一个负面评价称其“看起来像危机现场”。
评论者指出,相较于观看视频,交互式运行能更清晰地展现演示的技术范围:用户可以四处走动、与物体互动以及驾驶船只,这表明 Opus 5.5 生成的环境包含了超越静态场景生成的基础游戏循环机制。
一些比较将该输出结果形容为类似早期 Crytek / 孤岛惊魂 1 时代的引擎画面,另有评论者特别强调其水体物理效果在视觉上可与某些现代 AAA 级大作媲美,尽管这些观察属于定性判断而非基准测试。
2. Claude 发现的类 CRISPR 酶系统
Claude 发现了一种具有类 CRISPR 特性的新型酶系统(活跃度:1100):Anthropic 报告称,其 Claude-agent 基因组挖掘工作流识别出了一套此前未被表征的噬菌体系统,被称为阵列关联逆转录酶(ART):该系统包含一个逆转录酶基因、一个辅助基因,以及一段长的类 CRISPR 串联重复序列阵列。在这次研究中,约
950个 Claude agent 在 21 小时内消耗了2.1 亿token,收集了20 万+逆转录酶,提名了3,500个候选系统,并优先筛选出20份报告;初步的生物安全 1/2 级验证发现,ART 阵列会被转录为不同的短链 RNA,但 Anthropic 明确指出,该系统的生物学功能以及任何可编程的编辑用途目前尚不清楚。 评论者持谨慎乐观态度,认为这一成果不太像 AlphaFold 级别的生物学突破,更像是证明了 LLM agent 能够参与原创性假设生成的证据:“Claude 挑选了一个非寻常的候选项……并将其交由人类研究者进行验证。” 还有人推测,如果该成果能带来与疾病相关的发现,Anthropic 的生物实验室将有助于改善公众对其的支持;同时强调,ART 目前并未被证明能够切割、复制或粘贴 DNA,也未展现基因编辑能力。多名评论者强调,所报告的 ART 系统尚无法与 AlphaFold 2 或 CRISPR 级别的功能性发现相提并论:Anthropic 据报道仅证实了重复阵列会被转录为不同的短链 RNA,但其生物学功能仍不明确,目前既没有可编程基因编辑的证据,也缺乏类似 CRISPR 的已证实机制。
有技术性批评指出这项工作看起来并不完整:识别重复序列阵列并证明它们能产生短 RNA,本来就是基因组学里相当标准的分析流程,类似的思路在 VIPR 等系统中早已出现过。评论者认为,重复序列阵列作为有趣的基序早已为人所知,所以新意要么来自新的生物学功能,要么来自一个实质上新颖的发现过程,而这两点在他看来都没有得到明确论证。
有一个实质性的观点是:最重要的结果可能是方法层面的,而非生物学层面的——据报道,Claude 自主选择了一个不寻常的候选对象,发现了一个被忽视的模式,评估了其新颖性,并将其升级提交给人类做实验验证。评论者把这视为 AI 充当科研合作者的早期证据,即使这个酶系统的实际重要性还不确定。
Claude 智能体发现新分子机制的那一刻:像人类一样交谈,用着语气词和口头提示(热度:1056):这张图片似乎展示了 Claude 智能体对基因组序列侧翼进行推理并识别重复 DNA 基序的过程,其中高亮显示它意识到该结构可能类似 CRISPR 或 msDNA/retron 类的重复序列阵列。仅凭截图并不能证明这是经过验证的发现,其技术意义在于展示了 LLM 式智能体在分子生物学中的假说生成能力:对比串联重复序列、间隔区,以及 CRISPR array、多样性生成反转录元件、msDNA、retron 等已知移动遗传元件的结构。评论大多把这张截图当作 AI 快速进步的证据,有用户拿它类比数学领域的近期进展,并问道“生物学是不是很快也要被解决了?”另一些人则关注模型表现出的类人热情,而非生物学结论本身。
