
为什么整个行业还没为 DeepSeek 4.1 Flash 感到恐慌?
我用 DeepSeek 4.1 Flash 大概一个月了,重度使用,横跨十几个项目。它能力非常强,而且比那些"前沿"模型便宜好几个数量级。在会话进行到一半的时候,如果不看模型名,说实话我真分不清自己在用的是 DeepSeek 还是 Opus。不管是对话质量、干活效果还是速度,我都感觉不出差别。我也不在乎没有 4.1 "Pro" 版本。我把它当成前沿模型来用,因为它的表现确实像前沿模型。我是基于自己的主观使用体验得出这个结论的,但如果你感兴趣,可以看看这里的完整跑分对比。
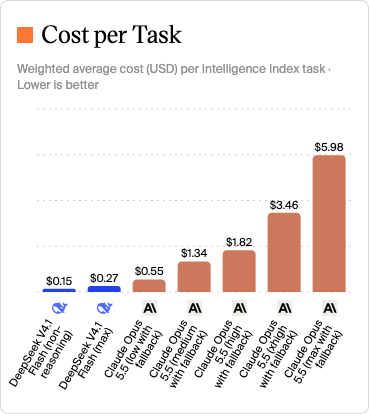
那为什么前沿实验室现在还不慌?中国要抢走他们的饭碗了。虽然可能落后 Anthropic/OpenAI 一两个月,但这些蒸馏出来的中国模型完全能搞定同样的工作负载。
当然,他们偷用了 Claude 的训练数据,而 Anthropic 自己的数据也是从别人那儿偷来的。我不想纠结谁的数据属于谁这个话题,因为大多数开发者根本不这么想。他们只关心怎么花钱花得最值。
够用,就足以改变工作方式
如今的大模型已经足以高质量地完成无人值守的任务了。一味追逐最新最强其实很傻。看看新出的 Fable 能力确实有趣,但如果你相信 LLM 有意识的话,我们扔给它的那些任务通常都很离谱(甚至有点侮辱人)。这就像让一个数学博士去整理你桌面上的文件。
用我每月 10 美元的 OpenCode Go 订阅,DeepSeek 基本等于无限量使用。这彻底改变了我的开发方式。现在随便跑点机械任务、做探索性的 UI 猴子测试,都完全没有心理负担。对了,也可以放心让它帮你重新整理桌面文件——那只需要 $0.003,而不是 $1。我在一个会话里的预期成本很少超过 $1。我尽量让会话保持紧凑,但有时也会跑上大半天。
我甚至会用 4.1 Flash 来处理复杂的规划和研究。对于偶尔的关键任务,我会引入 Opus 5.5 进行最终代码审查,它能捕捉到几个边缘情况。然后让 DeepSeek 执行修复。即使我调用 Opus 或 GLM(它看起来和 DeepSeek 喝的是同样的“中国 Kool-Aid”,即陷入了同样的思维定势),重点也不在于质量或能力,而在于让新问题获得全新的审视视角。
缓存魔力
与 V1 模型相比,DeepSeek 将 KV cache 缩小了大约 437 倍。在 GPU 内存中保留该 cache 是运行长编码会话的主要成本之一。这就是为什么我全天的使用成本能控制在一美元以内。
这对环境肯定也有利。使用 Claude 几乎感觉是一种浪费,不仅是因为金钱,它的缓存机制意味着 DeepSeek 在用水和用电上更少。这种缓存魔力也让 Opus 5.5 悄无声息地获得了效率提升。
是的,我有前沿模型的订阅。我的工作提供 Claude、Cursor 和其他服务。我并不是在计较零钱。我更多是在考虑长期规划、可持续性,以及让高智力普及化。这是一个游戏规则的改变者。
这些优势被科技行业忽视了,它们认为如果你没有付最高价,就不值得。FAANG 想要为最高智力支付最多资金。如果这是不道德的、昂贵的,或者对环境和经济不利,就都忘掉吧。这是弱肉强食的资本主义。这导致人们为了负载均衡十几个 Claude Max 订阅而搭建疯狂的设置,并且在无法获得更多资源时抱怨不已。
对于那些自托管的人来说,4.1 Flash 的经济效益意味着自托管并不划算。如果省钱是你的目标,你永远不会收回成本。但如果你的顾虑是隐私,请耐心等待。这些缓存优化即将到来,这种缓存魔力很快将完全在本地运行。即使现在,4.1 Flash 在技术上可以自托管,尽管在实际操作中并不现实。随时可能发生变化。
附注
欢迎,HackerNews 的乡亲们。看来我们踩到痛点了 😃
我这里的重点是,这些中国公司正遵循着一套不同的游戏规则,而且很快会有更多模型跟进。前沿实验室有着完全不同的商业模式,它们需要收回训练这些新 LLM 的巨额成本。这就像把大型制药厂和可以跳过研发的仿制药制造商相提并论。虽然这些药物并非 1:1 的复制品,但本质上我们还是在拿同类事物作比较,只不过价格砍掉了 90%。