
数据不出药企,AI却学会了更多:蛋白质模型迎来一次重要升级
编辑丨&
在发展进程中,AI 蛋白质结构模型最令人印象深刻的突破,几乎都是朝一个方向努力——让机器理解蛋白质的三维结构。
但对于理解蛋白质结构来说,公用数据库的数据量还是有些少了,并且真正有价值的数据其实不在这些公共数据之中,反而在制药公司的未公开的药物结构里。
2026 年 9 月 14 日,《Nature》上发表了一项由多家制药公司参与的合作。研究人员利用 5 家药企超过 20,000 份专有蛋白质—小分子结构数据,通过联邦训练的方式共同改进 OpenFold3。加入这些此前无法公开的数据后,模型在蛋白质—药物相互作用预测上的表现明显超过只使用公开数据训练的模型,也超过只利用单个药企数据训练的模型。
相关链接:https://www.apheris.com/networks/aisb
蛋白质 AI 的瓶颈
2024 年诺贝尔化学奖让 AlphaFold 再次成为整个生命科学领域的焦点。
该模型之所以能够取得突破,一个重要基础就是 Protein Data Bank(PDB)这样的开放数据库。数十年来,科学家通过X射线晶体学、冷冻电镜等实验手段积累了大量蛋白质三维结构,为 AI 学习蛋白质折叠规律提供了训练材料。
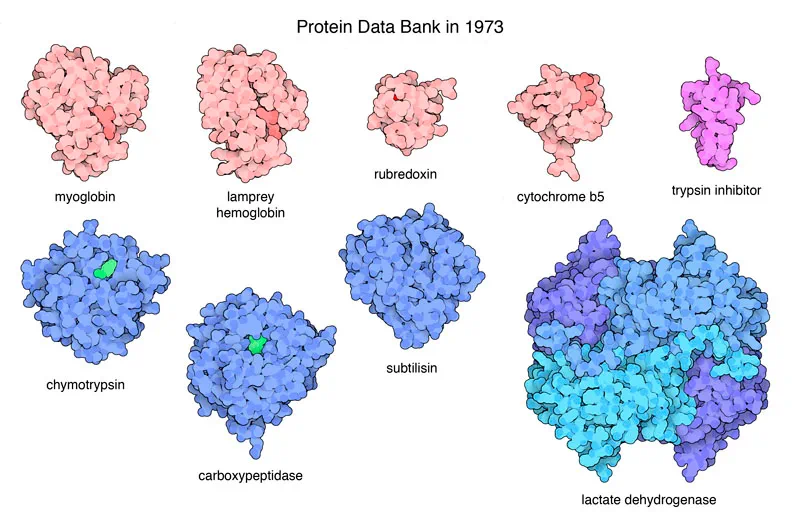
图示:1973 年 PDB 最早收录的一批蛋白质结构。
但到了 AlphaFold 3 以及 OpenFold3 这样的下一代模型,目标已经不只是预测单个蛋白质的形状。它们还需要预测蛋白质与其他分子之间如何形成复杂结构,但受限于 PDB 中通过实验确定的结构与类药物分子相互作用的案例较少(约 1 万个),在面对与训练样本高度不同的分子间相互作用时,其预测准确率会急剧下降。
而药企手中恰好掌握着他们需要的分子结构。这些数据来自于部分采用了 X 射线晶体学和冷冻电镜等技术的药物研发项目。其中一些结构可能来自正在开发的药物、失败的候选分子,或者仍然具有商业价值的靶点,因此没有被放入公开数据库。
这些「隐藏库存」的规模并不明确,但据估可能已经超过了 PDB 的总量。
数据预测提升
参与 AI Structural Biology(AISB)Network 首个项目的 5 家公司分别是 AbbVie、Astex Pharmaceuticals、Bristol Myers Squibb、Johnson & Johnso n和 Takeda。他们共同提供了 20,167 份蛋白质-小分子实验结构,并对先前仅使用 PDB 数据训练过的 OpenFold3 进行了「微调」。
相关链接:https://www.apheris.com/resources/aisb-network-expands-federated-openfold3-initiative-with-three-new-pharma-contributors
以数据保密手段进行数据训练并多方汇总后,AISB 研究发现,这些额外的数据提升了预测准确率。当对 1056 个从训练数据中单独保留的蛋白质-配体结构进行测试时,AISB 模型以高精度预测了其中超过一半的结构。
相比之下,公开可用的 OpenFold3 模型仅在三分之一的结构上达到相同水平,而另一个名为 Boltz-2 的竞争性开源模型则实现了约 40% 的准确率。
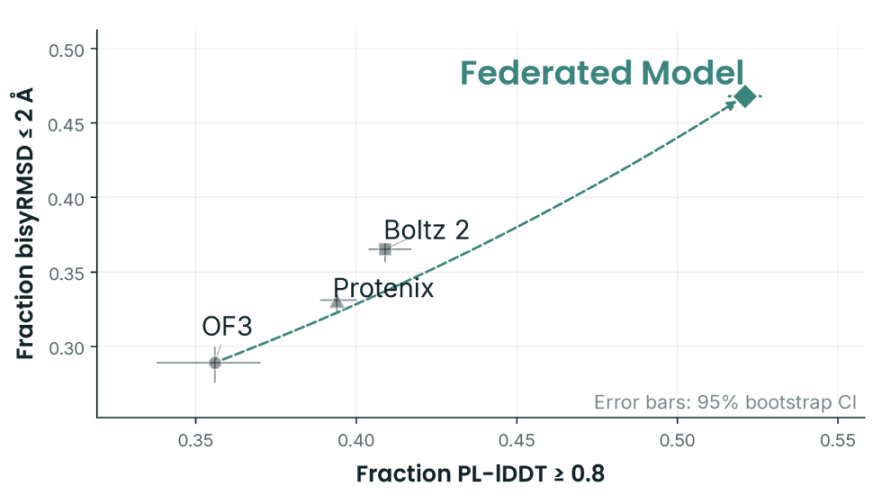
图示:两个准确度指标上都领先于测试中最强的公开模型。
AISB Network 的结果进一步显示,联邦训练模型在两个关键指标上分别取得约 +10% 和 +11% 的提升,并超过公开模型以及仅在单个药企数据上微调的模型。
即使是在仅使用各公司个别数据进行训练的联合折叠工具的环境下,AISB 模型的表现仍然更好,这进一步凸显了信息整合的优势。
更多措施
与 AISB 把企业内部数据用于私有联邦训练不同,英国主导的 OpenBind 则试图直接解决公开数据不足的问题——自己去生产更多高质量的蛋白质—配体实验数据。这个项目获得了英国政府最高 800 万英镑支持,目标是在 5 年内建立大规模开放的蛋白质—配体相互作用数据库。
相关链接:https://openbind.uk/
今年 5 月,OpenBind 公布了第一批数据,包括针对 EV-A71 病毒蛋白的 699 种化合物的 X 射线结构数据,其中 601 种还配有结合强度测量。8 月,项目又进一步发布了 OpenBind-0,一个基于 OpenFold3、专门用于蛋白质—小分子复合物结构预测的开放模型。
另一项名为 LIGAND-AI 的研究合作计划生成并共享实验数据,以测量数千种蛋白质与潜在药物结合的强弱。此研究希望为每一种与人类疾病相关的蛋白质找到至少一种对应药物。而这一目标在没有改进的 AI 工具的情况下将无法实现。
下一阶段的 AI 制药
计算机可以生成数以百万计的候选分子,但最终决定一个药物有没有价值的,仍然是现实世界里的实验。一个分子是否真的能结合目标蛋白、结合在哪里、结合得有多强,这些都是需要实验事实来约束的问题。
眼下,研究者的解答仍是开发出可泛化的 AI 模型,以此来预测药物与蛋白质之间的相互作用,对此高质量的实验数据同样不可或缺。如果另一边的 OpenBind 等项目能够持续扩大开放实验数据,那么未来的蛋白质 AI 模型可能同时获得两种过去很难兼得的东西——企业世界里真实、丰富的药物研发数据,以及公共科研体系里的开放数据。
原文链接:https://www.nature.com/articles/d41586-026-02882-x