
VoltaAI 4小时前 · 2026-10-09 11:07:51 · 7 阅读
VoltaAI电解液大模型ElectrolyteFM:以选择性共享提升多性质预测能力
 电解液是影响电池性能、寿命与安全性的关键组成。面对庞大的配方空间,基于深度学习的性质预测能够帮助研究者更快地筛选候选材料,加速电解液研发。现有研究主要关注电导率等少量性质,而一份配方的选择,需要综合考虑传输、稳定性等多方面表现。驱动一个统一模型协同预测多种性质,有望更充分地利用已有数据,为研发提供更全面的判断依据。
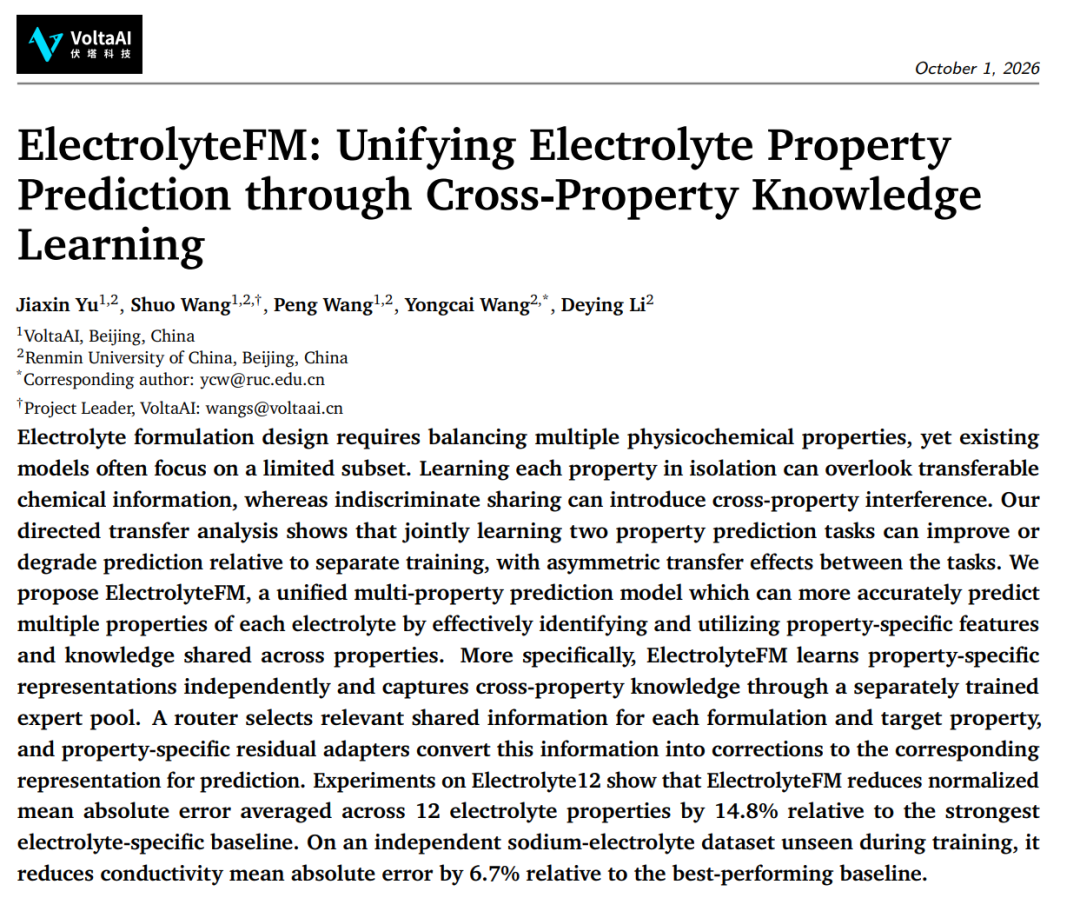 围绕这一目标,VoltaAI 构建了电解液多性质预测基础模型 ElectrolyteFM,将电导率、黏度、扩散、配位及热力学等 12 项性质纳入统一框架。
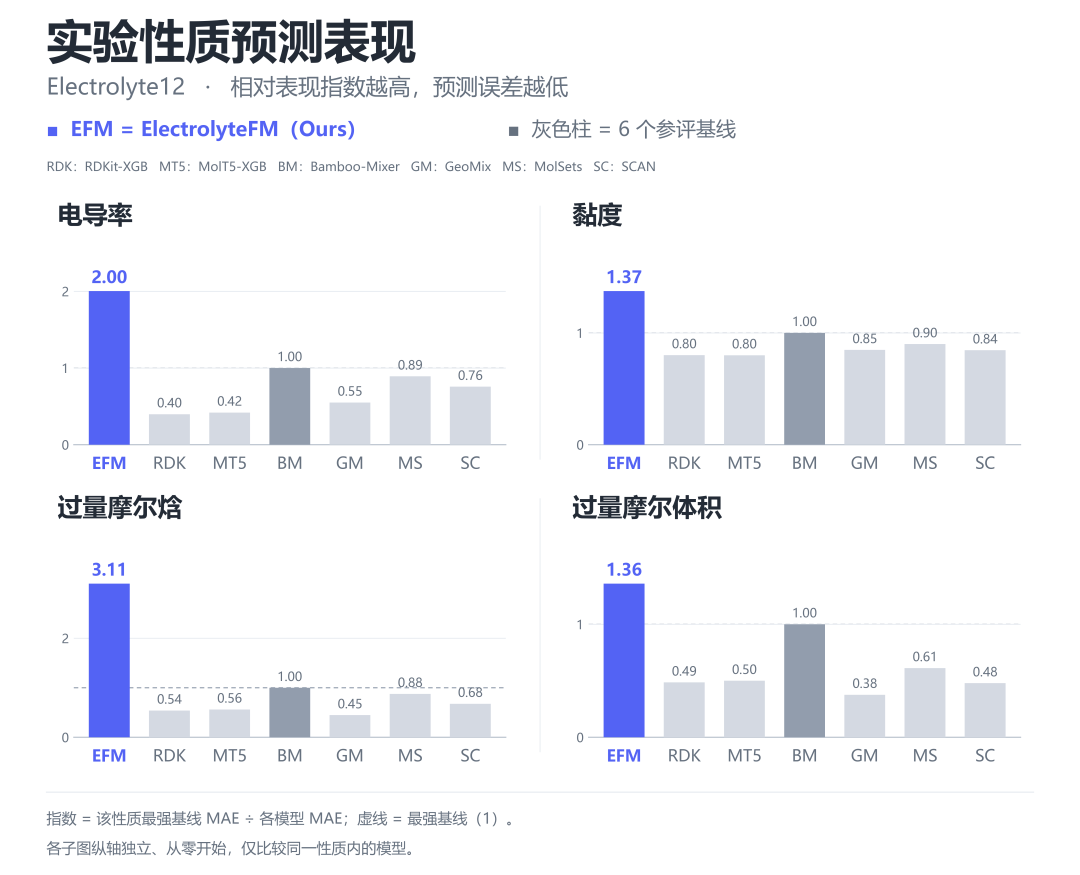
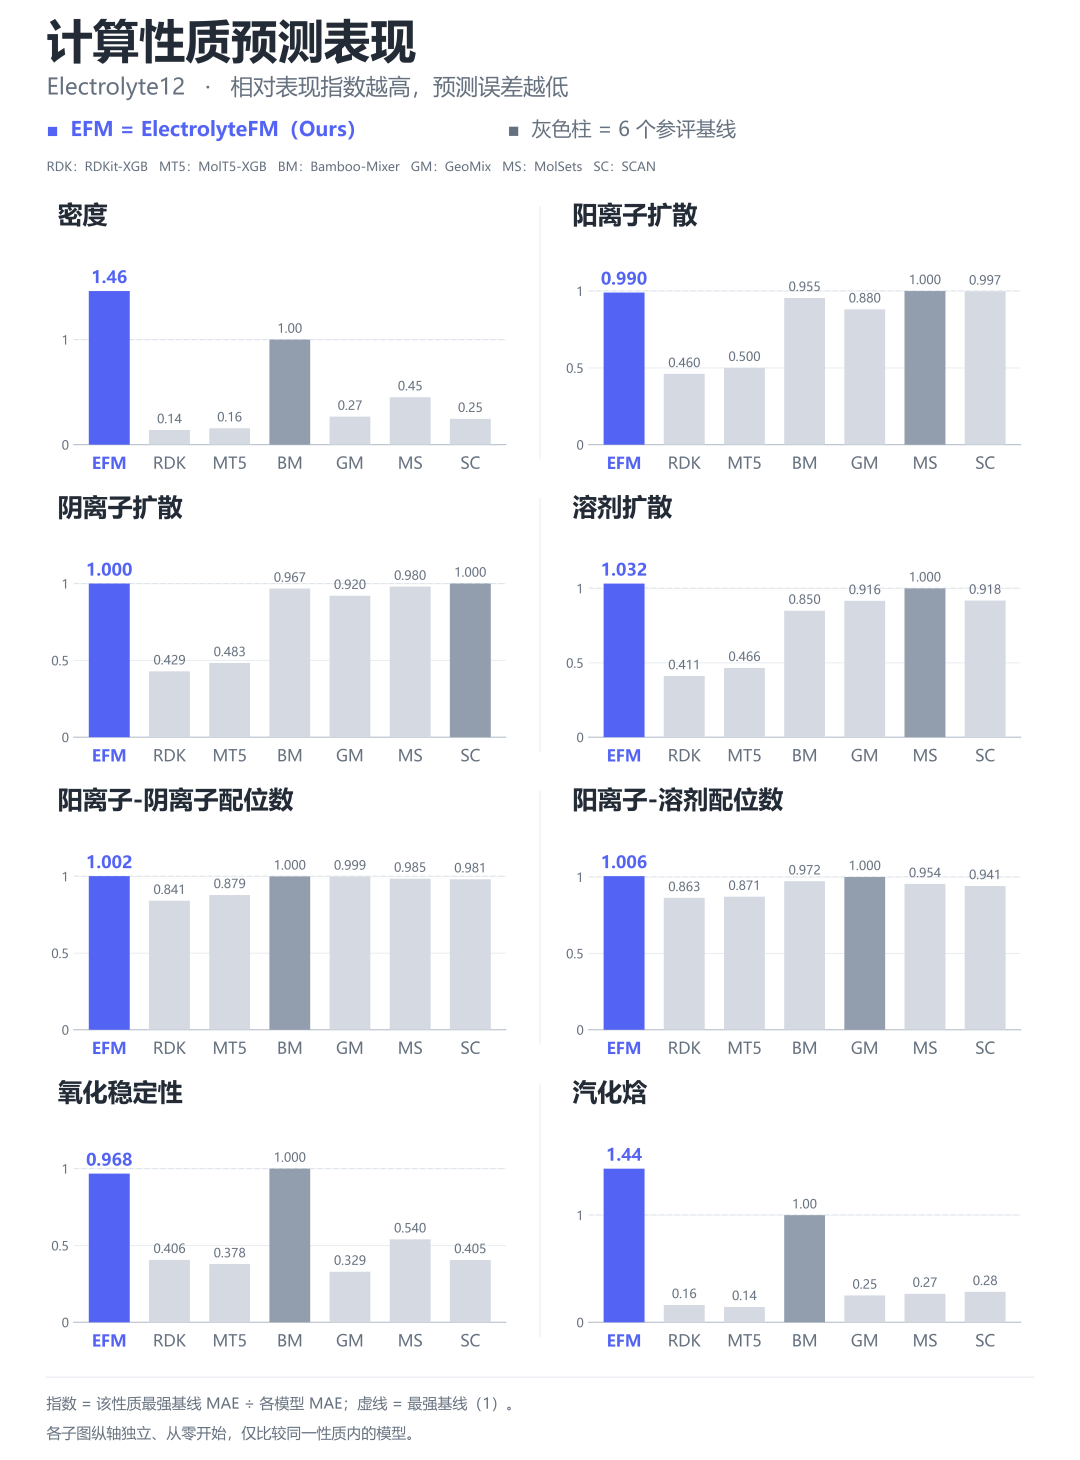 在与六类基线方法的统一评估中,ElectrolyteFM 在12 项性质中的 10 项取得最低平均绝对误差(MAE),其中电导率的 MAE 相较该性质表现最好的参评基线降低50.1%。
保留专属规律,按需共享知识
实现多性质协同预测,需要解决一个关键问题:直接把多个性质预测任务放在一起学习,并不一定让所有性质受益。单性质与双性质训练的对照显示,性质之间既有相互帮助,也有相互干扰,同一对性质在两个方向上的收益还可能不同。这提示我们,不同目标需要的特征各有侧重,统一共享表示可能难以同时满足这些需求。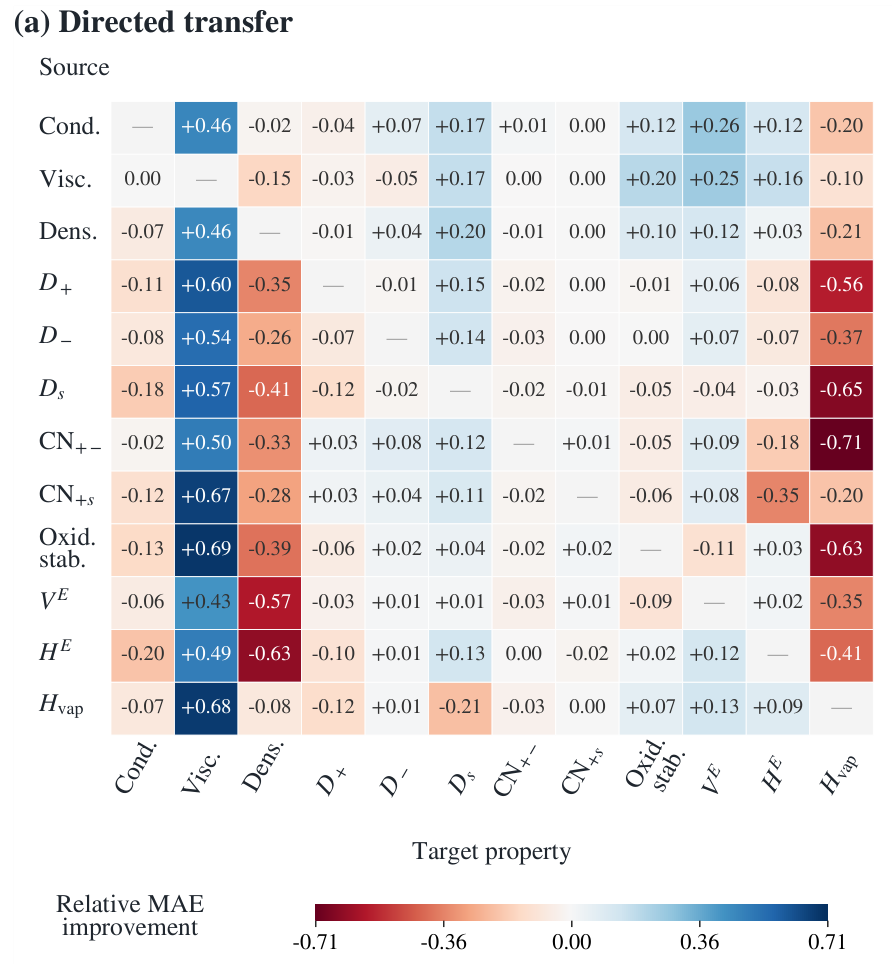 ElectrolyteFM 将专属知识与共享知识分别学习,再根据具体的配方与预测目标进行融合,让每项性质拥有独立的预测基础,也能利用其他性质中可复用的信息。
三阶段学习,让共享信息服务于具体性质
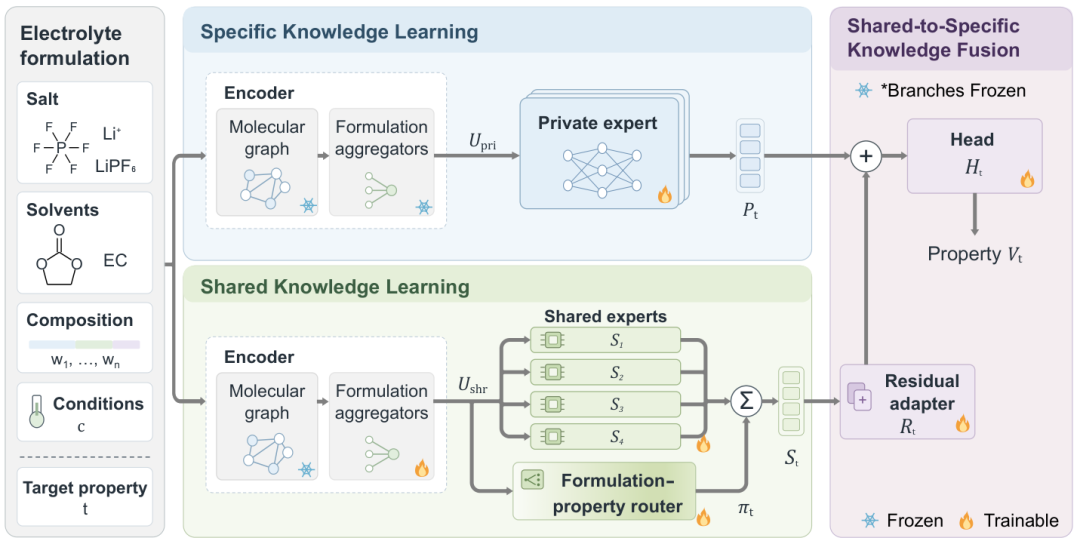 模型将各组分的分子结构转化为特征,结合组成比例,以及温度、浓度等条件,形成配方表示。在此基础上,ElectrolyteFM 通过专属与共享两条分支学习性质规律,再完成面向具体目标的融合。专属与共享分别学习,为多性质预测建立两类知识。在专属学习阶段,每项性质都有自己的专家网络和预测层,只利用该性质的标签进行训练。例如,电导率分支依据电导率数据学习预测所需的特征,黏度分支则依据黏度数据建立自己的表示。这样,每项性质都能先形成独立的预测基础,其专属表示的学习由自身任务驱动。共享学习阶段则设置四个参数独立的共享专家,共同接受多种性质的监督。每个专家从配方表示中提取特征,路由器将这些特征组合后,用于当前性质的预测。各性质的数据由此参与同一组专家的训练,为模型学习可跨任务复用的信息提供机会。这两个阶段分别训练两条分支:专属分支保留各性质独立学到的规律,共享分支探索不同性质之间的信息联系。第三阶段再学习如何将二者结合,使共享信息能够在已有预测基础上发挥作用。条件路由与残差适配,决定共享信息如何参与预测。共享专家的贡献由配方和目标性质共同决定。路由器一方面学习每项性质对不同专家的偏好,另一方面根据当前配方动态调整权重,再对所有专家输出的特征进行加权组合。因此,同一配方预测电导率和黏度时,可以采用不同的专家权重;即使预测同一性质,更换配方后,各专家的贡献也可以随之变化。得到共享特征后,每项性质专属的残差适配器会先将其压缩、转换,再映射到该性质的专属特征空间,形成一份补充信息。这份补充与原有专属表示相加,最终预测层再据此输出性质数值。路由器负责组合共享信息,适配器则进一步学习这些信息应当怎样用于当前目标。这一设计将“学习各自的规律”和“学习如何组合这些规律”分开,为不同性质提供各自的融合方式。
从实验测量到计算性质,检验多维预测能力
为了检验模型表现,我们构建了覆盖 12 项性质的 Electrolyte12 数据集,训练集包含约 36.7 万条记录。所有参评方法采用相同的数据划分与预处理规则。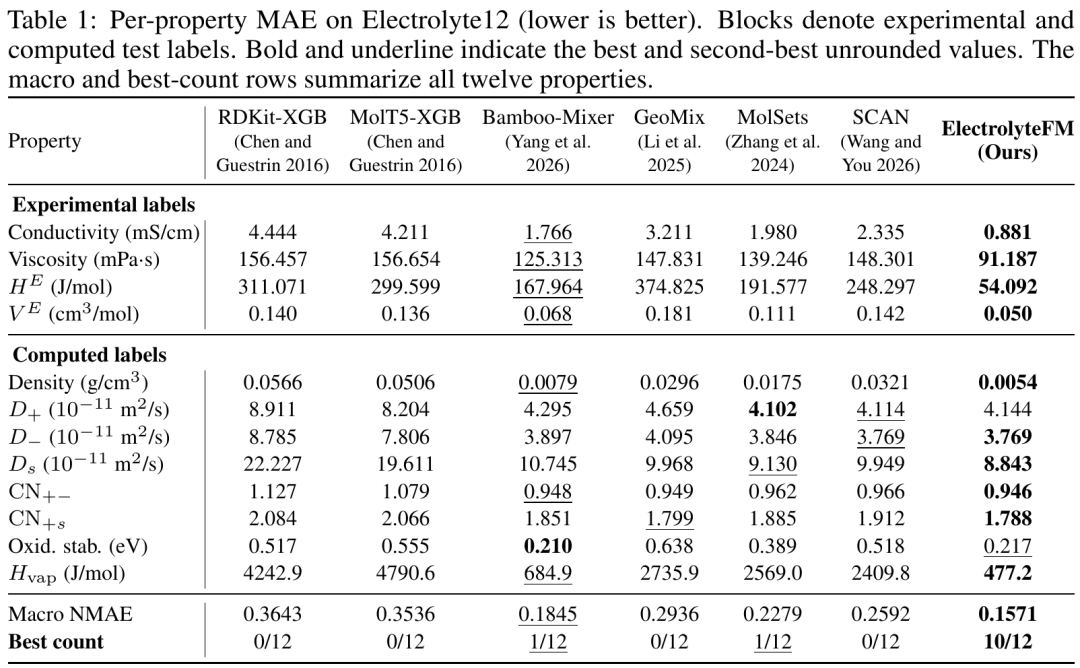 在实验测量性质上,四项预测均取得最低误差。相较各性质表现最好的参评基线,电导率与黏度的 MAE 分别降低 50.1% 和 27.2%,过量摩尔焓与过量摩尔体积分别降低 67.8% 和 26.7%。这些指标从传输、流动与混合热力学等角度,为配方评价提供互补信息。在计算性质上,优势覆盖六项预测任务。其中,密度与汽化焓的 MAE 分别降低 31.3% 和 30.3%。氧化稳定性与阳离子扩散系数分别排名第二、第三;阴离子扩散与最强基线的误差非常接近,领先幅度小于 0.001%。综合 12 项性质,ElectrolyteFM 的宏平均归一化 MAE 相较主表表现最好的基线降低14.8%。
面对新配方,保持预测与适配能力
我们进一步使用独立的106 条钠电解液配方检验模型对新体系的适用性。这组数据未参与基础模型训练,评估目标为电导率。在直接预测、不进行目标体系适配的条件下,ElectrolyteFM 的 MAE 为 2.592 mS/cm,相较该测试中表现最好的基线降低6.7%,相关性与 R² 指标也在参评方法中最高。说明ElectrolyteFM 并非只是在记忆训练集中已有的材料,而是在学习可以迁移到陌生电解液材料上的物理规律。在实际应用过程中,研发团队还会持续积累新的测量结果。我们进一步考察了少量目标体系数据对预测的改善作用。通过few-shot的方式将少量未见过的数据微调ElectrolyteFM 。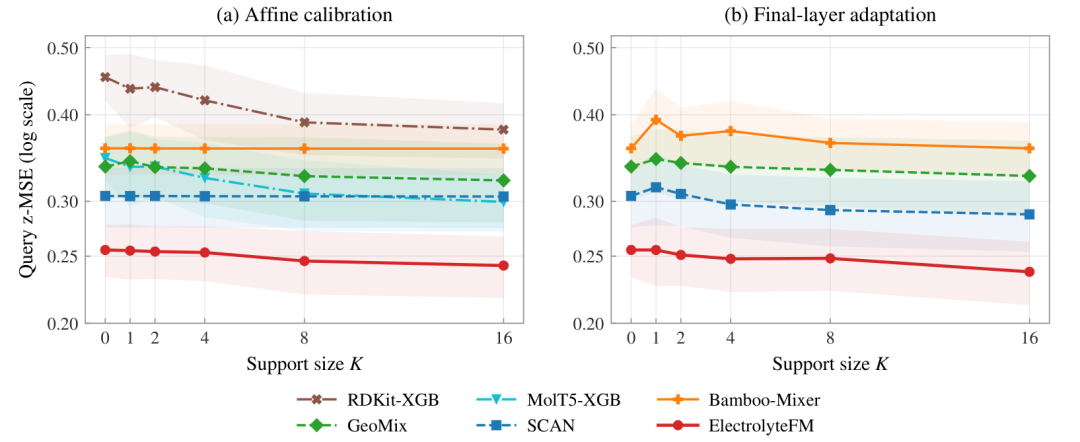 在所评估的两种适配方式及各个样本量下,ElectrolyteFM 均保持最低的平均查询误差。其中,利用16 条已知配方调整最终预测层后,标准化均方误差进一步降低约7.0%。这表明,模型已经学到的信息能够继续服务于目标体系,并从新增实验数据中获得改进。
让AI预测与实验共同推进配方研发
对于研发团队,ElectrolyteFM 提供了一条可探索的工作路径:围绕可用组分与目标条件,先比较候选配方的多项性质,确定优先验证的方向;再将实验结果用于检验和调整模型,为下一轮筛选提供依据。VoltaAI 希望让已有数据更充分地服务于配方研发,并在持续的实验反馈中,提高模型对具体体系的适用性。ElectrolyteFM目前已接入VoltaHarness新能源行业智能体平台中,对于ElectrolyteFM 电解液通用性质预测以及其他电芯AI能力感兴趣的,可联系 wangs@voltaai.cn 获取内测资格。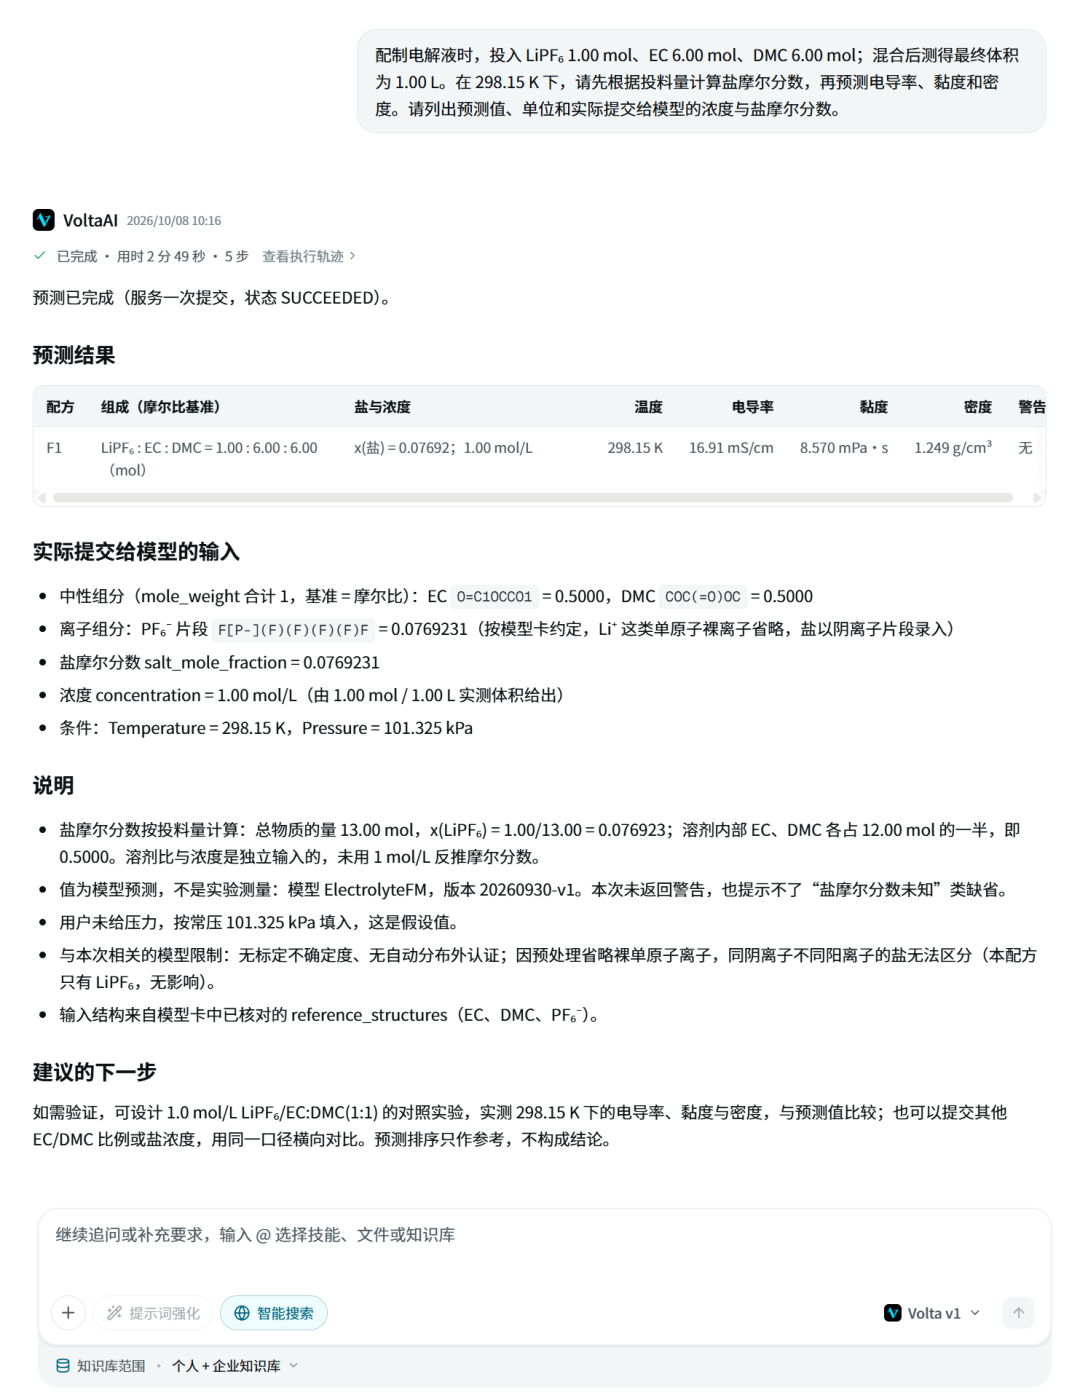 其他信息详见技术报告:https://arxiv.org/abs/2609.39340关于VoltaAI
伏塔(北京)人工智能科技有限公司(VoltaAI)成立于2026年6月,由核心创始团队与北京卫蓝新能源科技股份有限公司联合发起成立。
公司聚焦新能源电池行业,致力于打造面向物理世界的科学世界模型,让AI理解科学知识的同时,进入真实研发过程,理解设备运行、工艺变化、实验反馈与产业现场,成为连接研发与产业全流程的大脑。
持续驱动新能源电池领域新材料、新工艺的发现与终端应用产品升级,目标是成为电池行业AI基础设施构建者。
原始来源: VoltaAI