
AIAgent专题01:现代智能体的基本结构
理解 AI Agent,可以从一个普通任务开始:
让 AI 帮五个人选一家周末聚餐的餐厅:预算 500 元,要照顾忌口,还要把菜单和总价整理成清单。
普通聊天模型离这个目标还有多远?我们从最简单的一层开始,每增加一种能力,就认识一个 Agent 的核心概念。
01 先让 AI 听懂任务:LLM 是 Agent 的大脑
用户发来一句话:
“周六五个人聚餐,预算 500 元,其中一人不吃辣。帮我选家餐厅,把推荐菜和总价整理好。”
系统首先需要一个能够读懂自然语言、分析条件并组织答案的核心。这个核心就是 LLM(Large Language Model,大语言模型)。
模型读文字时,会先把句子切成许多小单位,再一个接一个生成后面的内容。这些小单位叫作 Token。现在不必计算一个汉字等于几个 Token,只要知道:模型一次能读多少材料,是用 Token 衡量的。
在这个任务里,LLM 可以完成三件事:
- 理解目标:选一家适合聚餐的餐厅。
- 找出条件:五个人、预算 500 元、一人不吃辣。
- 组织答案:列出餐厅、推荐菜和选择理由。
一次普通问答的流程很短:
用户问题 → LLM 生成内容 → 返回文字答案
但 LLM 此时只有“会理解、会回答”的能力。它没看过餐厅今天的菜单,不知道哪些菜已经涨价,也不能真的把聚餐清单保存到手机或电脑。
有了 LLM,系统已经能够理解目标并组织答案。可它手边没有任务资料,也不能实际操作电脑。
LLM 是 Agent 的决策核心,但 LLM 本身不等于 Agent。[2]
要让它依据真实资料做判断,下一步要解决的是:模型究竟能看到哪些信息。
02 再把材料交给它:Context 决定本轮能用什么
现在把三家餐厅的菜单、价格、营业时间和忌口说明一起发给模型。LLM 不需要重新学习,就能照着这些材料挑选。
这批随本次请求一起交给模型的信息,叫作 Context(上下文)。
上下文通常包括:
- 系统规则:价格要有来源,不确定就直说。
- 用户目标:五个人聚餐,总预算不超过 500 元。
- 个人要求:一人不吃辣,周六晚上到店。
- 任务资料:菜单、菜价、营业时间和餐厅位置。
- 刚查到的结果:哪些网页已经看过,哪些价格还没找到。
可以把上下文理解为模型桌面上摊开的材料。菜单存在某个网页里,不代表模型已经看过;只有程序把内容取回来并放到桌面上,它才能照着菜单做选择。
材料还要写完整。只告诉模型“套餐 168 元”,却不说这是双人餐,它就可能把双人套餐当成五个人都够吃。
上下文也不是永久记忆。这次给过菜单,不代表下次打开新对话它还记得。想继续使用,程序要重新读取,或者从保存菜单的地方再取一次。
上下文窗口就是这张“桌面”能放多少材料,用 Token 计量。桌面更大,可以同时摊开更多菜单;但把几十家无关餐厅全塞进去,也会让真正重要的信息更难找。
Context:LLM 在本轮推理中实际收到的全部信息。
少量资料可以直接放进上下文。资料多到放不下时,系统就要先找出与问题有关的部分,再把这些内容交给模型。
材料已经摆到模型面前。下一步,是让它不再依赖人工粘贴,而是自己读取文件、搜索网页并保存结果。
03 让 AI 真正动手:Tool 把决定变成操作
我们给系统增加三个操作:
search_menu:查找餐厅菜单。calculate_total:计算五个人的总价。save_plan:保存聚餐清单。
这些能被模型选择和调用的操作接口,叫作 Tool(工具)。
工具不是一句“我去查查”,而是一个程序真的能执行的操作。模型想查乙餐厅的菜单时,会提出类似这样的请求:
search_menu( 餐厅="乙餐厅", 内容="周六菜单和价格" ) 接下来不是模型亲自打开文件,而是程序执行四步:
- 看清模型想调用哪个工具、要查哪家餐厅。
- 检查参数是否完整,也就是餐厅名称、查询内容有没有填对,并确认模型有访问权限。
- 真正打开网页或菜单页面。
- 把菜单内容或“页面打不开”等结果交还给模型。
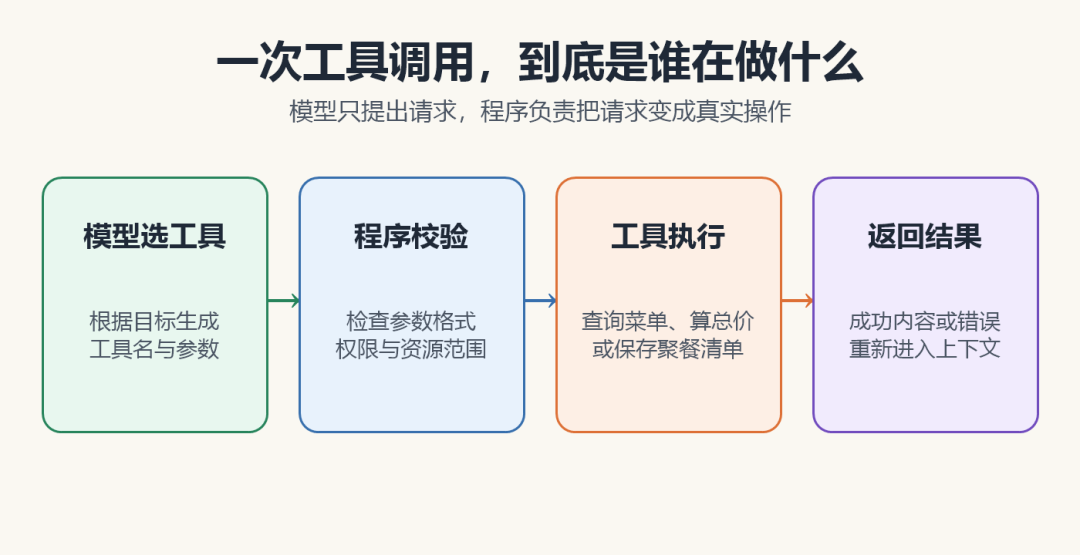
所以,模型负责选择行动,程序负责校验,工具负责执行行动。模型生成了调用请求,不等于工具已经执行成功。
工具大致分成两类:
| 类型 | 常见操作 | 主要风险 |
|---|---|---|
| 读取信息 | 查菜单、看地图、读取文件 | 读错页面、拿到旧价格、看到无权访问的内容 |
| 改变状态 | 保存清单、发送消息、预订座位 | 写错、发错、产生真实费用 |
选餐厅的 Agent 可以查菜单、算价格、保存清单,但不该在用户没有确认时直接订座或付款。动作越接近真实花钱,权限就越要收紧。
Tool:程序提供给 LLM 调用的受控操作接口。
工具把想法变成了动作。查完以后,Agent 还要知道菜单有没有打开、清单有没有保存,这就要看外部世界返回了什么。
04 让 AI 看见操作结果:Environment 是它面对的外部世界
save_plan 被调用后,清单可能真的保存了,也可能因为路径错误而失败。模型说“已经保存”,不能证明文件真的存在。
文件系统、网页、数据库、浏览器和操作系统,共同构成 Agent 的 Environment(环境)。
工具与环境的关系可以这样看:
- 菜单网页属于环境,浏览器工具负责打开它。
- 地图上的营业状态属于环境,地图工具负责查询。
- 保存后的聚餐清单也属于环境,
save_plan负责创建它。
一次完整操作不是“模型说完就结束”,而是:
LLM 选择工具 → 程序执行工具 → 工具操作环境 → 环境返回结果
环境返回的内容叫作 Observation(观察结果)。它可能是一张最新菜单,也可能是“餐厅已歇业”“网页打不开”或“文件保存失败”。
观察结果会被放回上下文,LLM 才能知道刚才的行动是否成功。
Environment:Agent 能读取或改变的外部状态。Observation:环境在操作后返回的真实结果。
观察结果能说明这一步是否成功。复杂任务还要继续往前走,所以下一步必须根据刚得到的结果重新决定。
05 让结果决定下一步:执行循环让 Agent 持续工作
查完三家餐厅后,系统拿到这样的结果:
- 甲餐厅:五人套餐 468 元,其中三道辣菜不能更换,剩下的菜不够五个人吃。
- 乙餐厅:四人套餐 398 元,可以再加一道 68 元的不辣菜。
- 丙餐厅:页面只写“人均 58 元起”,没有完整菜单。
如果程序只写了“查三家餐厅,然后选最便宜的”,它会在这里卡住:甲餐厅不符合忌口,乙餐厅要重新计算,丙餐厅信息不全。Agent 要根据结果重新选择,而不是硬着头皮往下算。
这需要一个不断重复的 执行循环(Agent Loop):
- 读取状态:LLM 查看目标、已有资料和上一步结果。
- 选择行动:决定调用哪个工具,或者直接结束。
- 执行工具:程序校验参数与权限后执行。
- 观察结果:环境返回成功结果或错误。
- 更新上下文:把新结果加入当前任务状态,再进入下一轮。
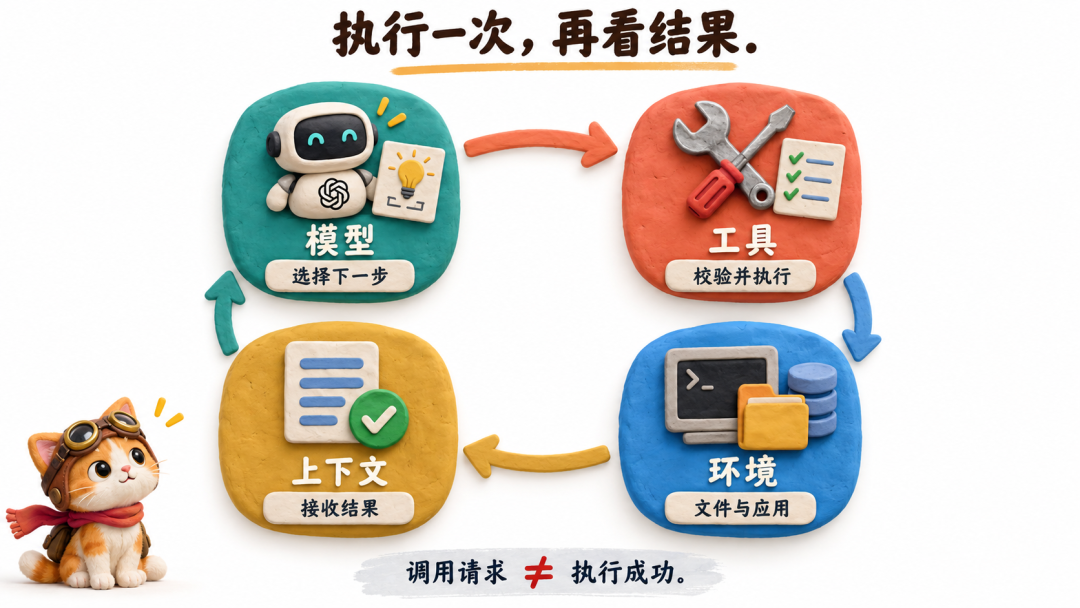
常见的 ReAct 方法把核心过程概括为 Reason → Act → Observe,也就是推理、行动、观察。重点不是英文缩写,而是下一步会随着观察结果改变。
放回聚餐任务里,这个循环会这样往前走:
- 甲餐厅无法更换辣菜,排除。
- Agent 查询乙餐厅的加菜价格,找到一道 68 元的不辣菜。
- 计算得到
398 + 68 = 466元,没有超过预算。 - Agent 换了一个网站继续查丙餐厅,仍然找不到完整菜单,于是标注“价格待确认”。
- 乙餐厅条件完整,Agent 选择乙餐厅,并生成聚餐清单。
Agent Loop:LLM 根据当前状态选择行动,工具执行,环境返回结果,结果再影响下一次选择。
执行循环解决了怎样连续推进任务。随之而来的新问题是:模型可能重复搜索、调用越权工具,甚至一直运行下去。
06 给执行循环加上护栏:Harness 负责管理与验收
如果丙餐厅的菜单一直查不到,Agent 应该换个网站、询问用户,还是继续搜索?如果它准备直接订座,谁来确认用户真的同意?这些事不能只靠 LLM 自己说“没问题”。
在工程实现中,管理这套循环的外层程序常被称为 Harness(执行框架)。不同产品可能使用不同名称,它不是每个 Agent 框架里都必须出现的固定模块。[2]
它像一名现场管理员:不替模型选餐厅,但会盯住它能查什么、查了几次、什么时候该停,以及交出来的清单是否合格。
Harness 主要负责六件事:
- 状态:保存任务目标、步骤、工具结果和当前进度。
- 权限:限制模型能调用哪些工具、访问哪些资源。
- 预算:限制运行时间、Token、工具次数和费用。
- 重试:区分临时失败、参数错误和不可恢复错误。
- 停止:达到上限或缺少必要条件时及时结束。
- 验收:检查最终产物是否真的符合要求。
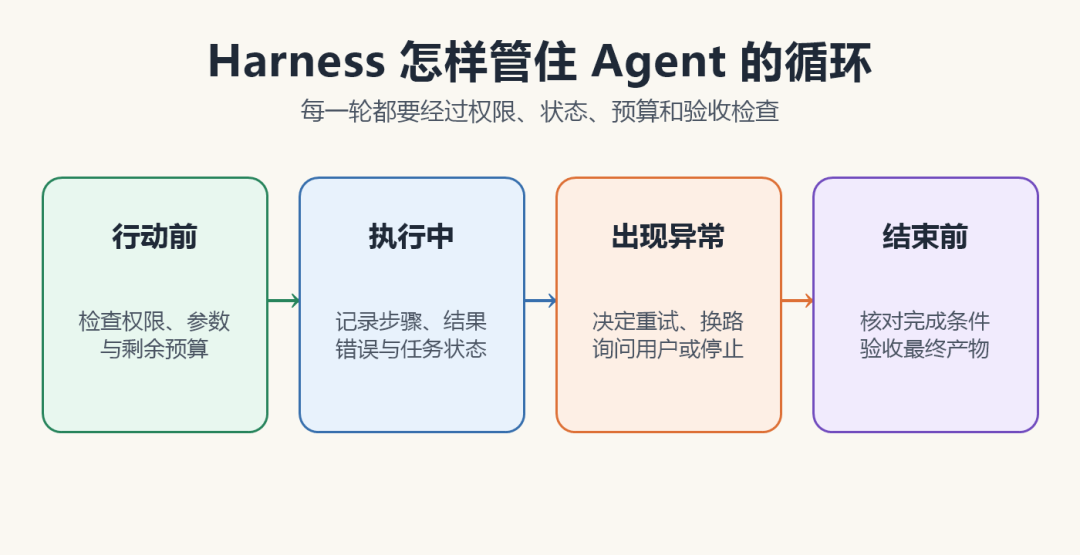
对这份聚餐清单来说,验收条件可以直接写成表格:
| 检查项 | 合格标准 |
|---|---|
| 人数 | 推荐菜量适合五个人 |
| 预算 | 总价不超过 500 元,并保留算式 |
| 忌口 | 不把辣菜算进那位用户的可选菜品 |
| 证据 | 菜价能找到对应菜单或网页来源 |
| 最终产物 | 清单确实保存,重新打开后内容完整 |
完成条件定义什么叫做成功,停止条件规定什么时候必须结束。继续调用模型,不能把未知事实变成已知事实。
这次任务最后通过了验收:乙餐厅总价 466 元,有不辣菜,价格能找到来源;聚餐清单保存成功,重新打开后内容完整。丙餐厅因为菜单不全,被保留为“待确认”,没有用猜出来的价格参加比较。
Harness:包在 LLM 与工具循环外面的工程层,负责状态、权限、预算、停止和验收。
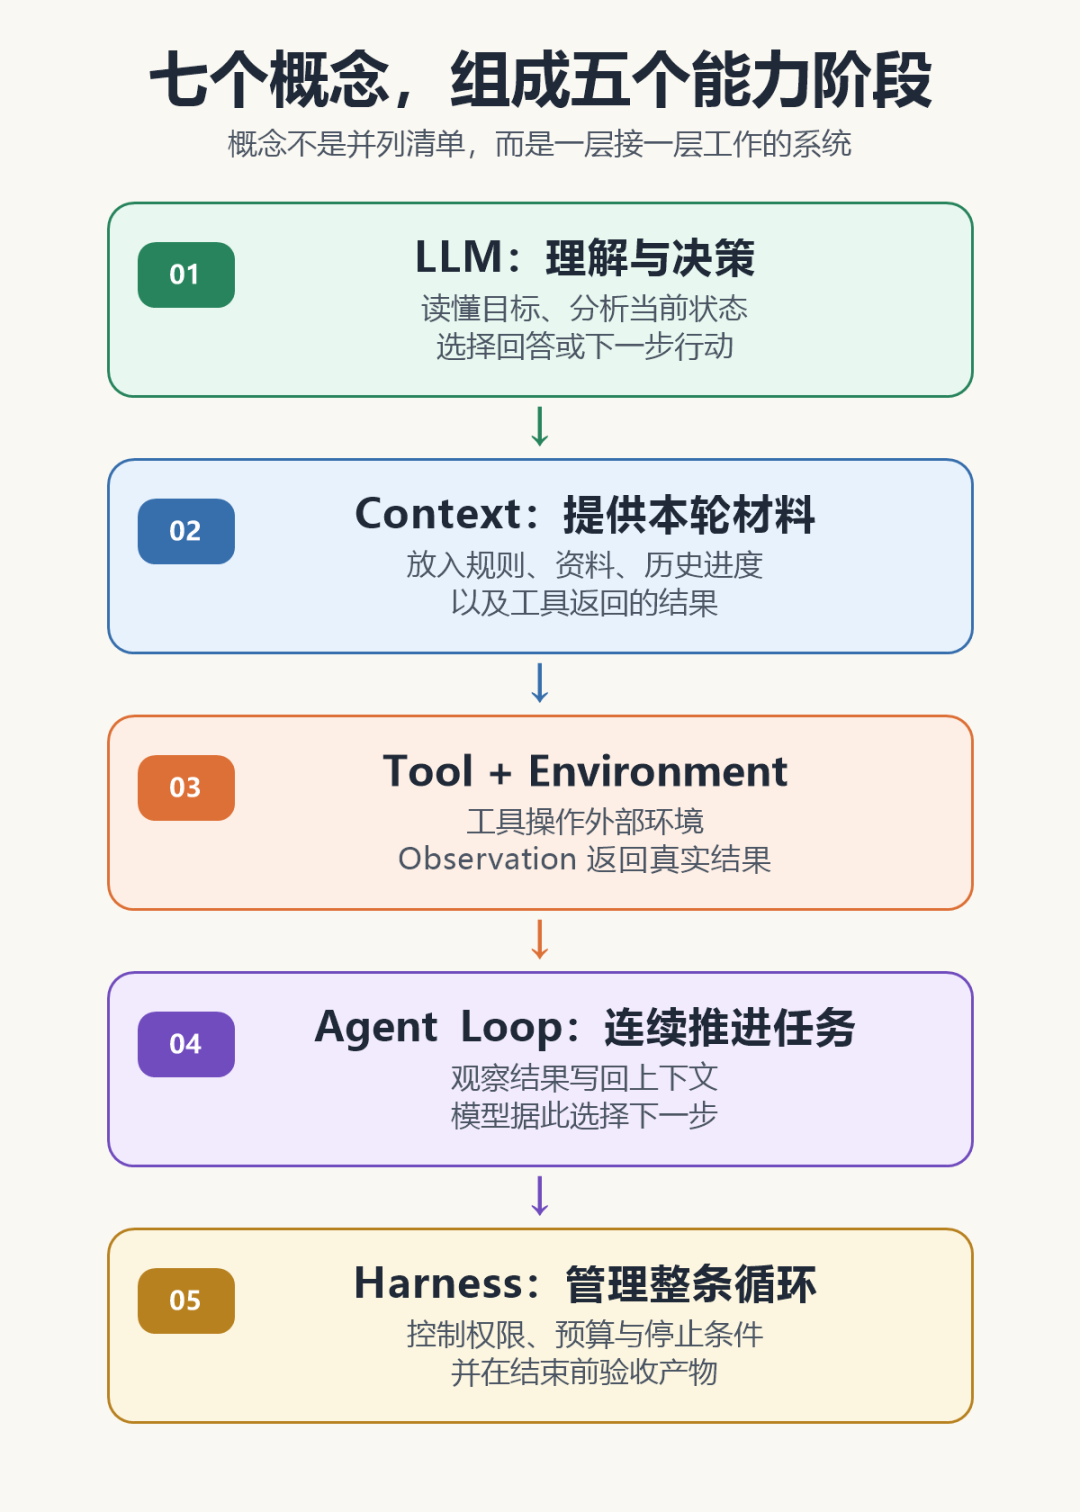
Harness 补上了可控运行与结果验收。到这里,一个最小 Agent 才完整:LLM 负责判断,上下文提供材料,工具执行动作,环境返回结果,执行循环持续推进,Harness 管住边界。
07 工作流和 Agent 有什么不同:关键看谁决定下一步
按固定顺序查询三家餐厅、计算价格、生成清单,也能完成任务。但这种系统更接近 Workflow(工作流),不一定是 Agent。
两者都可以调用 LLM 和工具,区别在于路径由谁决定:
| 方式 | 下一步由谁决定 | 适合什么任务 |
|---|---|---|
| 普通问答 | 用户 | 一次提问、一次回答 |
| Workflow | 程序预先写好 | 步骤稳定、异常容易枚举 |
| Agent | LLM 根据结果动态选择 | 路径不固定、需要临时判断 |
工作流执行预设路径;Agent 根据环境反馈动态选择路径。[1]
如果菜单格式相同,步骤永远是“查价格、相加、排序”,固定工作流通常更便宜、更快,也更容易检查。只有当菜单可能缺失、忌口和预算经常变化,下一步必须临时决定时,Agent 的自主性才真正有价值。
判断一个系统需不需要 Agent,可以问三个问题:
- 任务步骤能否提前完整写出来?
- 工具返回不同结果时,下一步是否必须改变?
- 把决定交给模型,带来的收益是否高于成本和风险?
能用工作流稳定解决,就不必为了“更智能”强行加入 Agent。自主性越高,需要验证的地方也越多。
把七个概念接成一条链
现在再看 Agent 的基本结构,就不会只剩一堆缩写:
| 概念 | 在系统里负责什么 |
|---|---|
| LLM | 理解目标、分析状态、选择下一步行动 |
| Context | 保存本轮可用的规则、资料、历史和工具结果 |
| Tool | 把模型的选择变成可执行操作 |
| Environment | 保存文件、网页、数据库等真实状态 |
| Observation | 把操作后的真实结果交回系统 |
| Agent Loop | 让结果进入下一轮判断,持续推进任务 |
| Harness | 管理状态、权限、预算、停止条件与验收 |
读到这里,可以用三道题检查自己是否真的理解:
- 菜单明明在网页上,模型却不知道价格,缺的是哪一部分?
- 搜索工具返回“餐厅已歇业”,这条返回信息叫什么?
- 一套程序永远按固定步骤执行,另一套会根据查询结果改变下一步,哪一套更接近 Agent?
答案分别是:Context(上下文)、Observation(观察结果),以及会根据结果改变路径的第二套系统。
这就是现代 Agent 最基本的工作方式。模型和框架会更新,但“读取信息、采取行动、观察结果、继续判断”的链路不会轻易过时。
关注一霁月,轻松学懂 AI Agent。
参考资料:
[1] Anthropic,Building effective agents,2024-12-19,重点参考“What are agents?”“When (and when not) to use agents”“Agents”小节,2026-09-23核验:https://www.anthropic.com/engineering/building-effective-agents 。文中关于工作流与自主 Agent 的划分采用该文的工程视角。
[2] 李博杰,《深入理解 AI Agent:设计原理与工程实践》,v2.0,2026-08-22,第1章,重点参考1.1节“现代 Agent = LLM + 上下文 + 工具”及1.2节的工程框架。本篇案例为独立设计,工具请求为示意,未作为真实产品实测结果。