
使用 NVIDIA Megatron Core 扩展逐位确定性预训练
逐位确定性(bitwise determinism)让大规模预训练的调试、验证和可复现断点恢复变得更加轻松。当训练模型达到数万亿参数、横跨数千块 GPU 时,多种并行维度、低精度计算和分布式 checkpoint 会让故障复现与修复验证变得非常复杂,这些优势也就尤为宝贵。
生产级和 hero 级训练运行成本高昂,必须有强有力的成功保障。逐位确定性支持可靠的故障重放、loss 尖峰调试、系统变更验证,以及中断训练的恢复。在万亿参数规模下,哪怕轻微的减速也可能浪费数千个 GPU 日,因此确定性训练必须保持高效。一个万亿参数 Nemotron 案例研究展示了 NVIDIA 如何在 Megatron Core 中降低逐位确定性预训练的开销。
什么是逐位确定性?
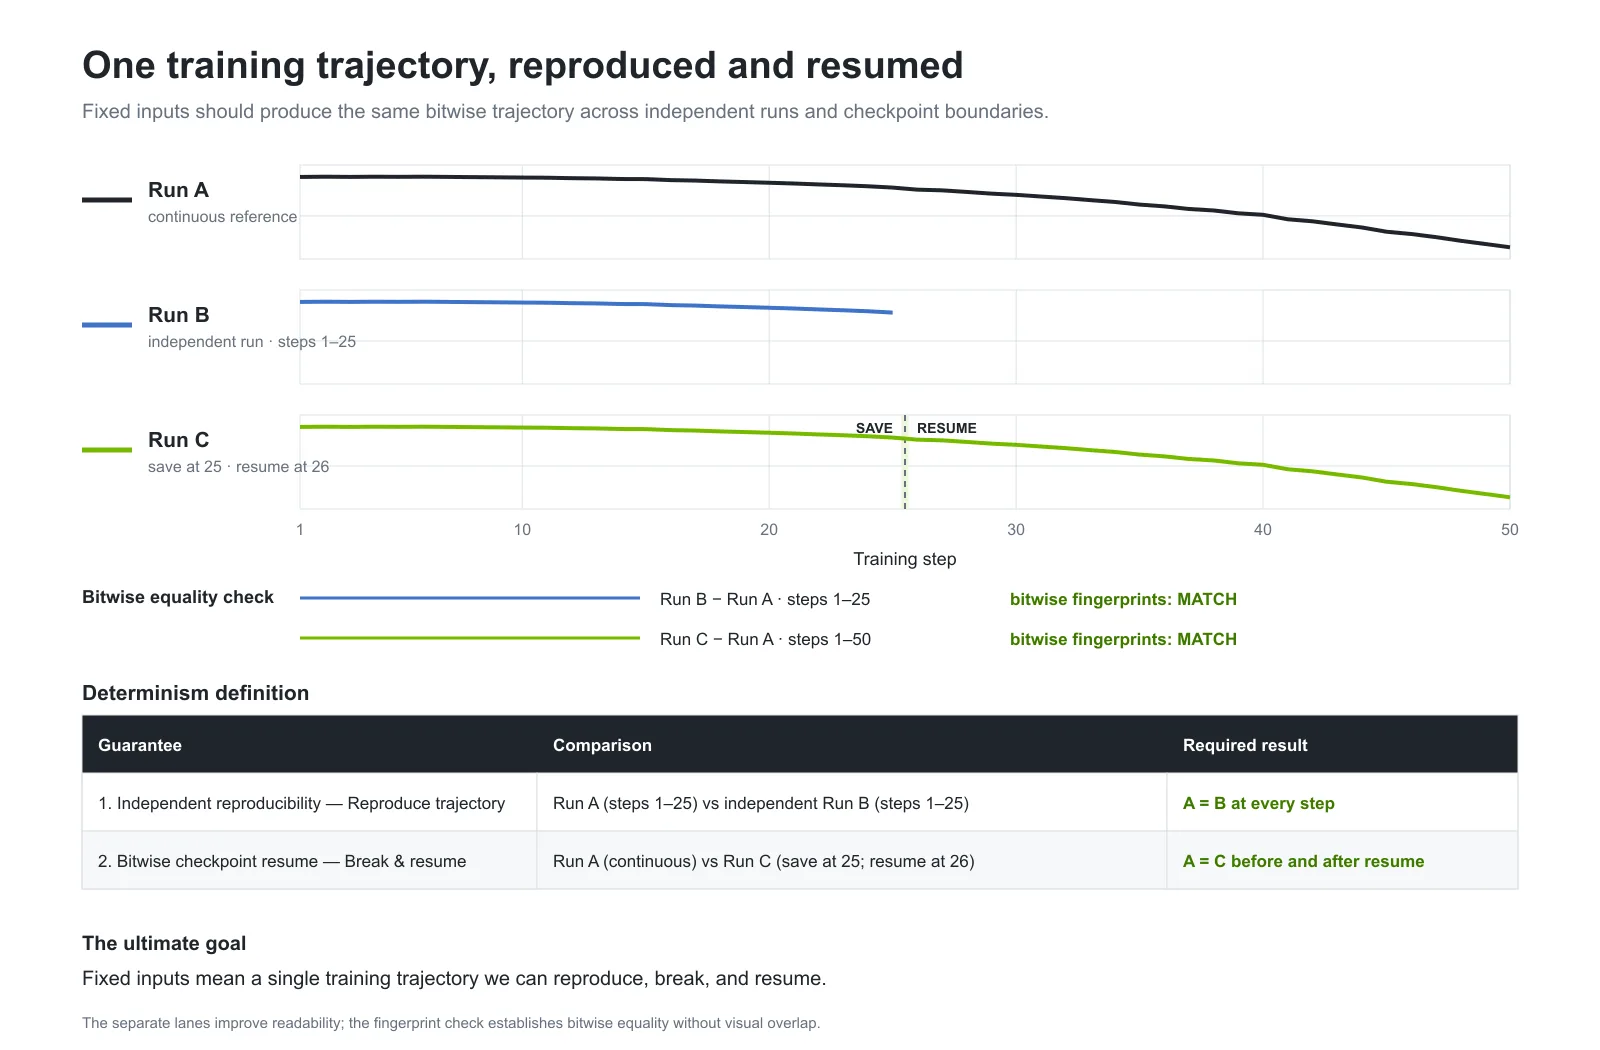
逐位确定性要求:在数据顺序、模型架构、训练配方、并行策略、软件、运行时配置和硬件都固定的情况下,独立运行和从 checkpoint 恢复的运行都遵循相同的数值轨迹。Megatron Core 以实现两个保证为目标。
独立可复现性:从同一初始状态启动的两次运行,在每个训练步都必须逐位完全一致。
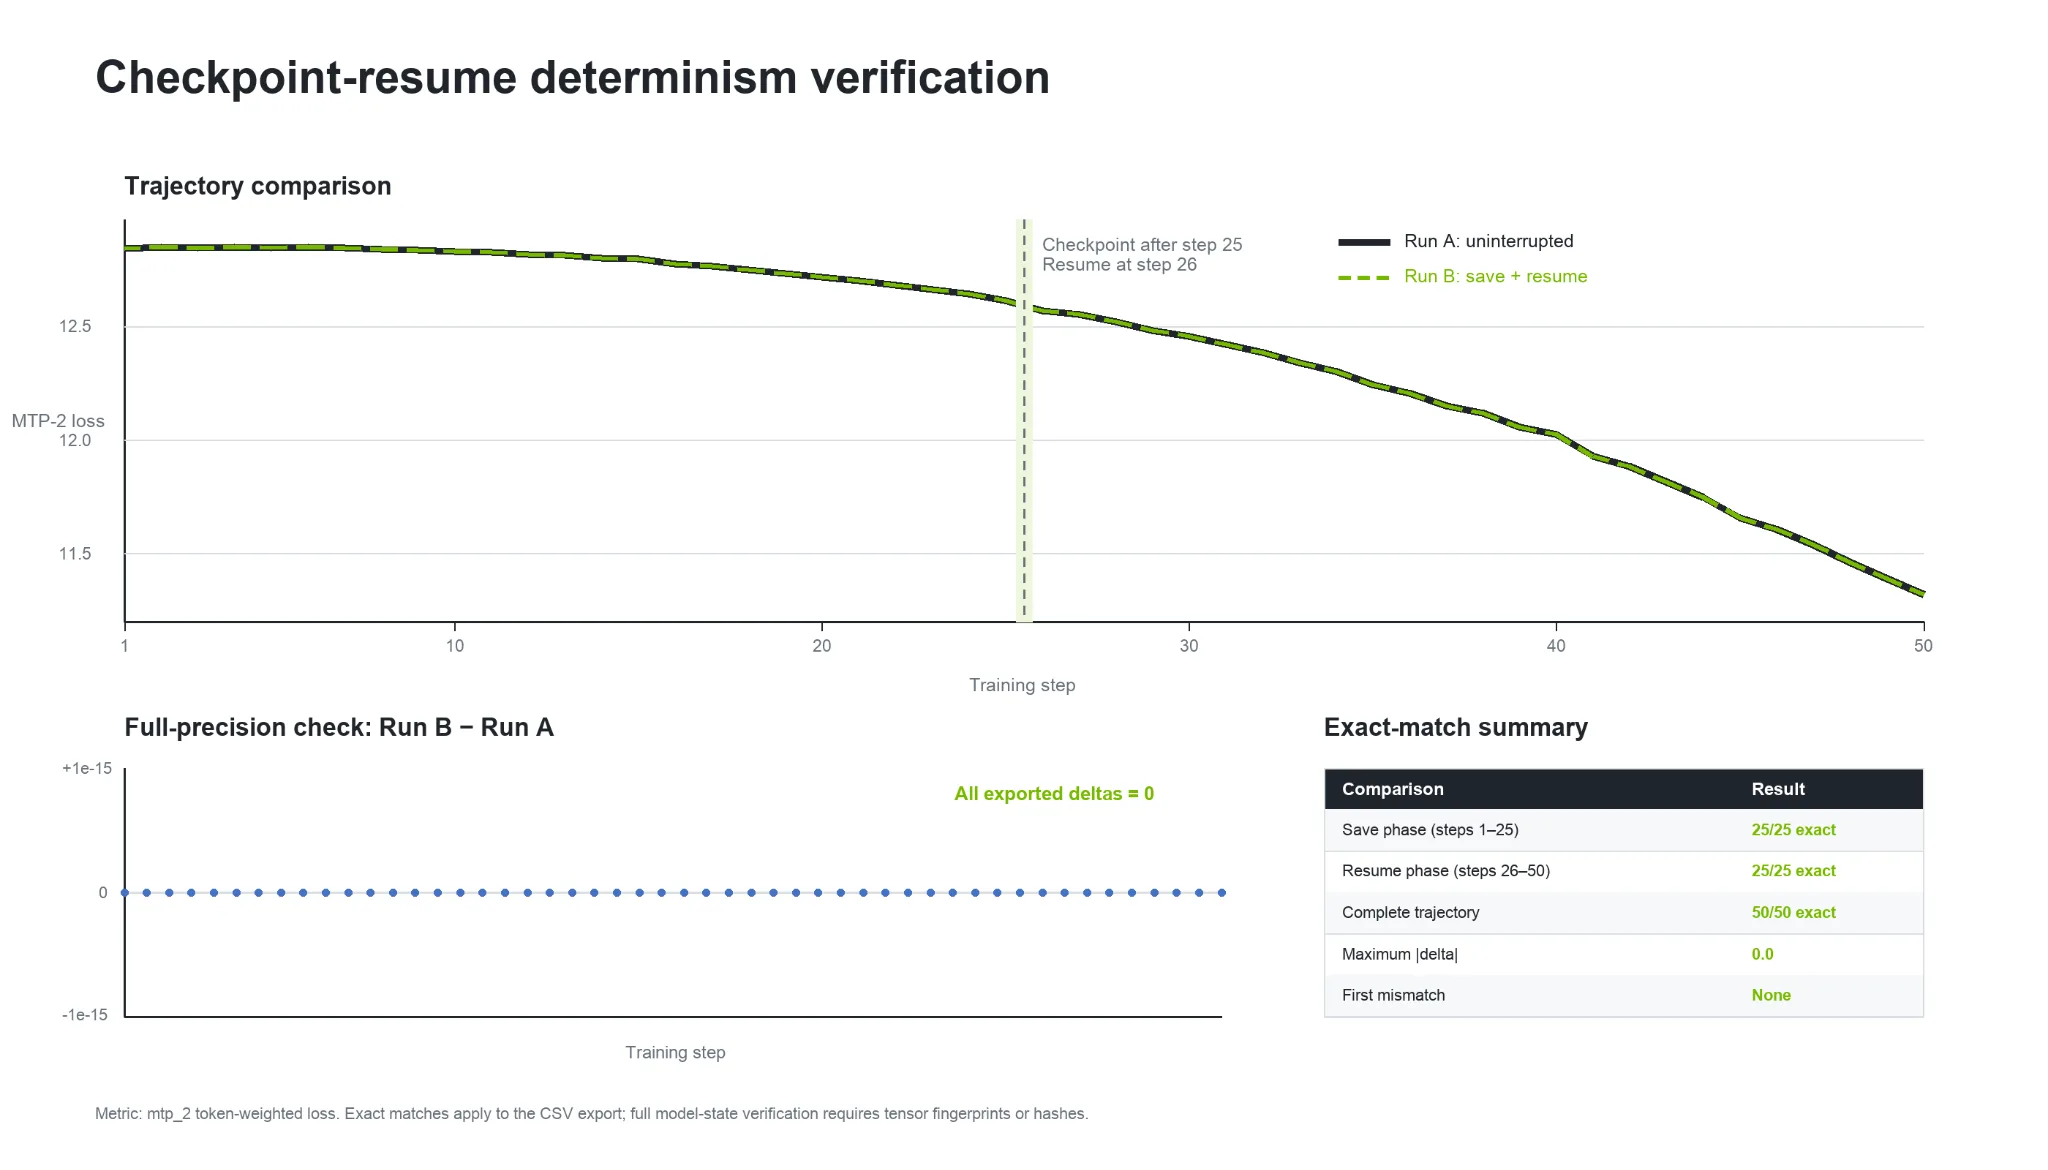
逐位 checkpoint 恢复:保存并恢复一个或多个 checkpoint 的运行,必须与不间断的运行完全一致。
为什么预训练需要确定性?
逐位确定性为大规模预训练带来四大好处。
- 排查回放失败: 复现特定步骤的损失激增,然后每次只更改一个组件,以定位问题根源。
- 保持检查点连续性: 从中断处恢复训练,且不改变数值轨迹。
- 检测异常差异: 利用本应一致的运行结果之间的不匹配,排查检查点损坏或软硬件问题。
- 对比变更影响: 将预期变更带来的数值效应与运行间的固有波动区分开来。
如何验证确定性
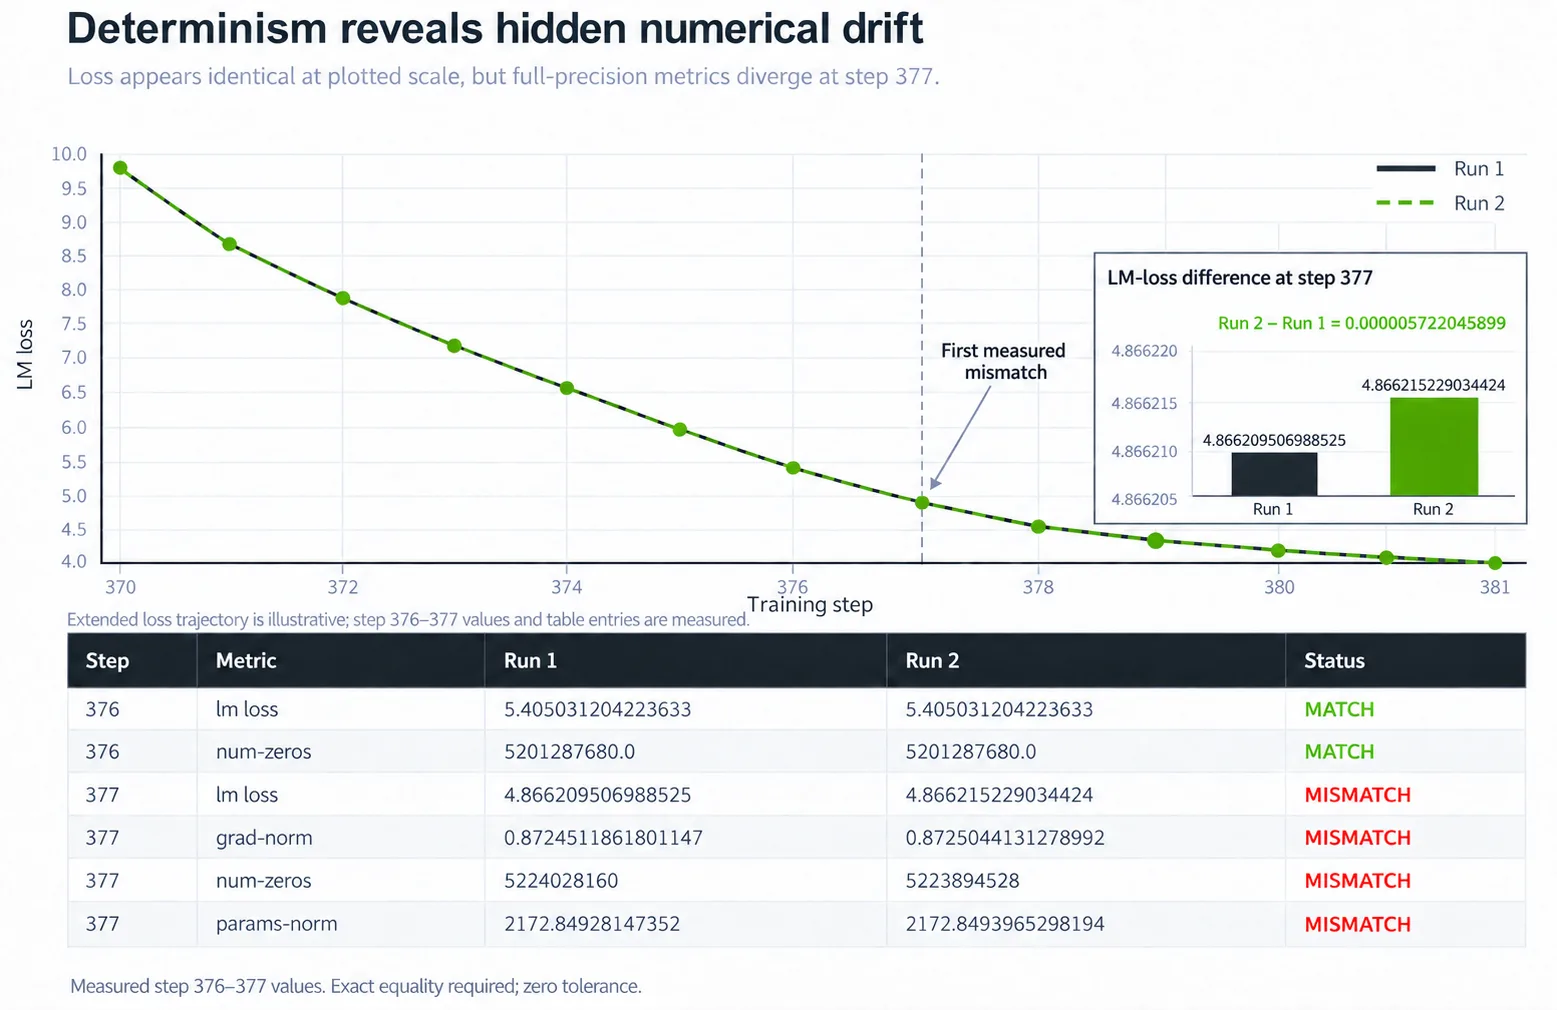
打印出的损失值精度不足以确立位级一致的数值。两次运行可能打印出相同的四舍五入损失值,但其梯度或参数的低位比特存在差异。
更强的验证流程是在每一步为选定的数值指标生成指纹。这些指标可包括训练损失、语言建模损失、负载均衡损失、多 token 预测(MTP)损失和梯度范数。使用相同配置运行两次,逐步比较这些指纹。首个不匹配的步骤有助于缩小排查范围。
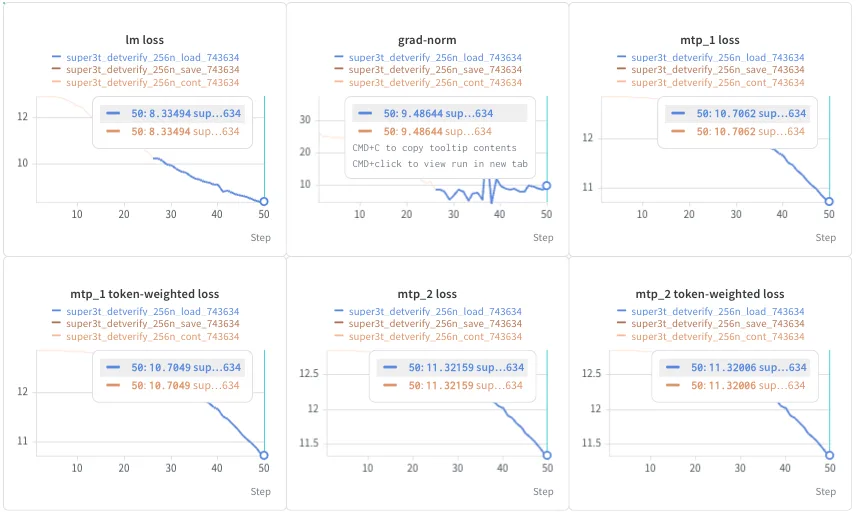
为了验证位级检查点恢复,需将不间断的基准运行与从检查点恢复的运行进行对比。每次恢复后,验证参数、优化器状态、随机数生成器状态、数据位置及后续输出是否与基准运行在位级上完全一致。
万亿参数的 Nemotron 模型检查点路径保留了全精度的权威数据源,并通过训练阶段使用的相同转换路径重建运行时表示。
确定性被破坏时的修复方法
在大规模场景中,不确定性可能是间歇性的或依赖于拓扑结构,且明显的损失发散可能发生在首个比特差异之后很长一段时间。《Megatron-LM PR #7262》中提出的工作流记录有序且每 rank 的张量指纹,以便离线对比。首先,确保种子、数据顺序、批量大小、并行策略、容器和软件栈完全一致。
使用细粒度追踪定位发散点
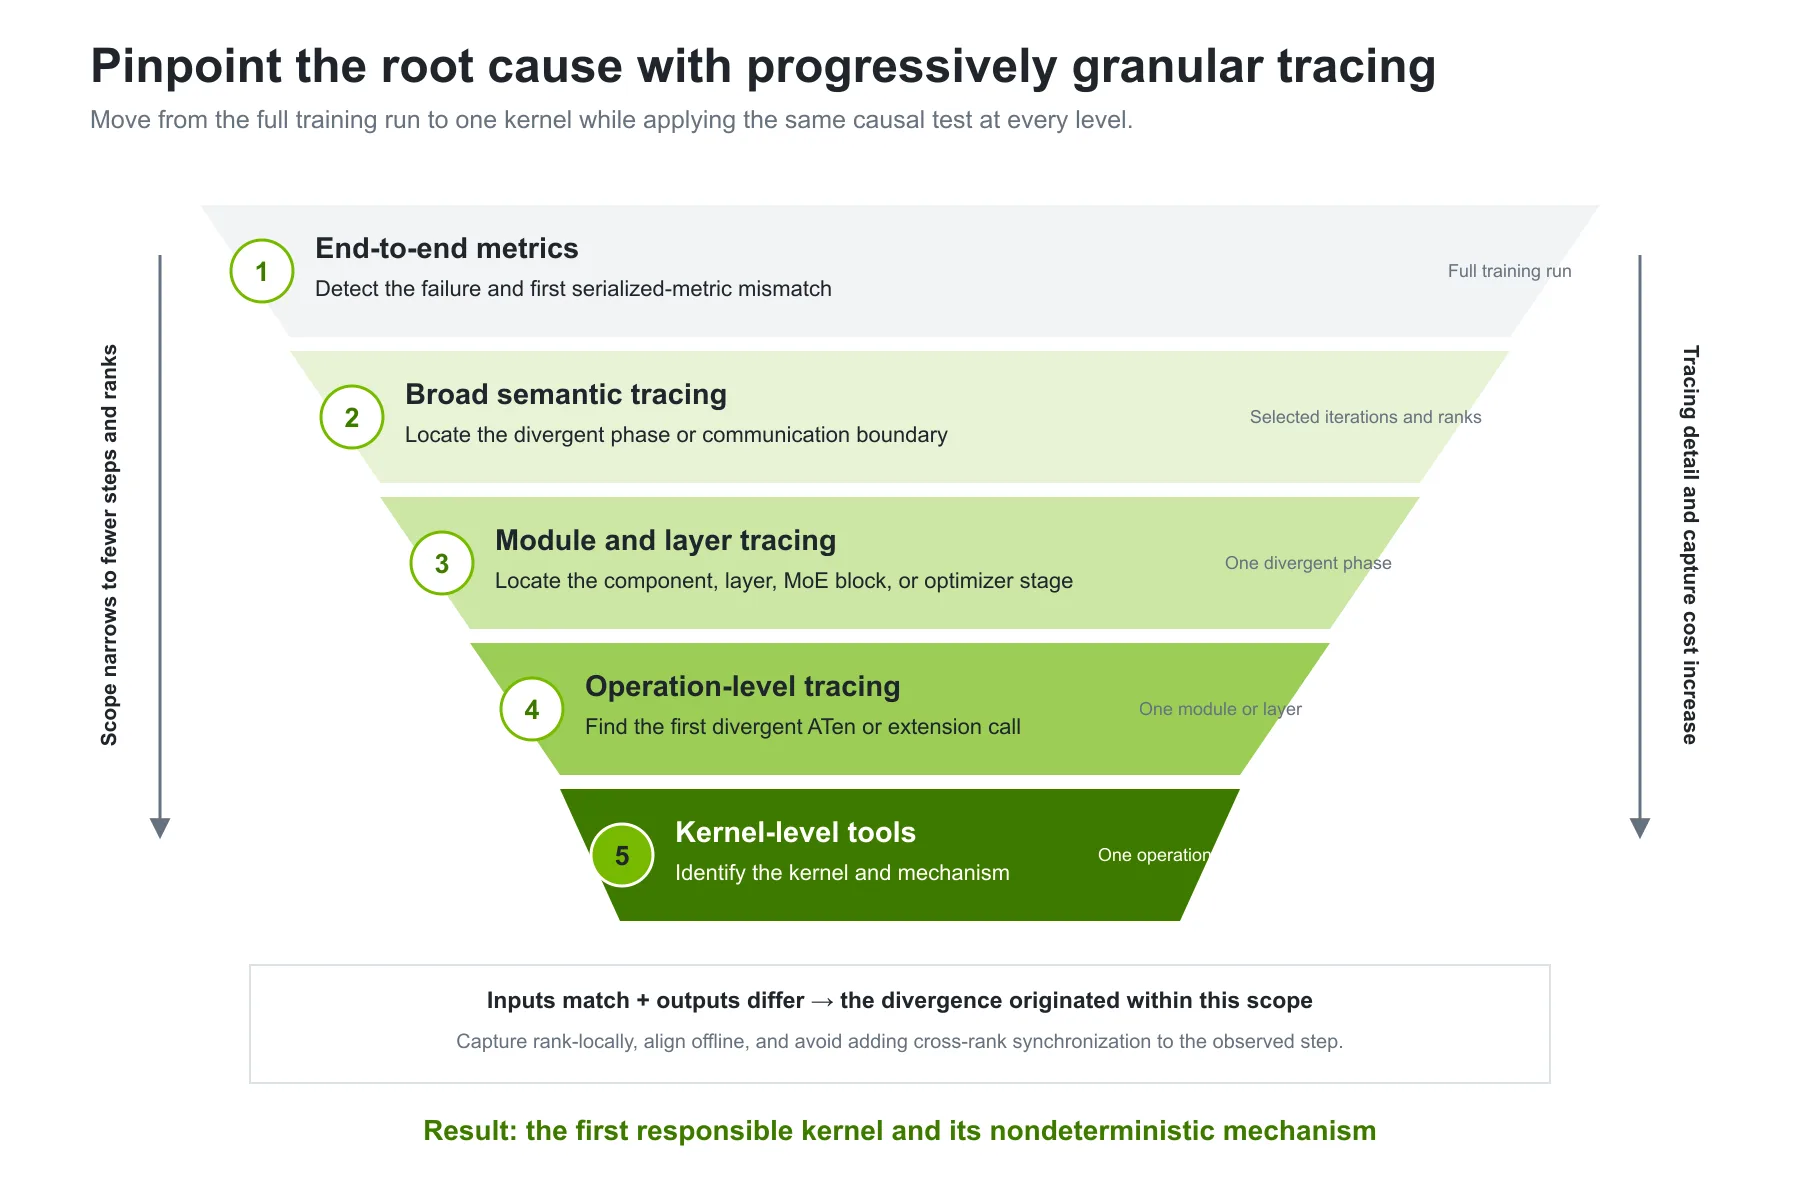
先做端到端对比,再逐步缩小捕获范围:从整个训练迭代,到训练阶段、模块、算子,最后到 kernel。如果两次运行进入某个范围时输入完全相同(逐位一致),离开时输出却不同,那么差异就产生在这个范围内。
- 端到端指标用于发现故障,并定位序列化指标首次出现差异的迭代。
- 粗粒度语义追踪覆盖 collectives、流水线通信、重计算、优化器操作和梯度归约,用于定位出现差异的训练阶段。
- 模块和层追踪把差异范围缩小到具体的模型组件,比如某个 transformer 层、mixture of experts (MoE) 块或优化器阶段。
- 算子级追踪对 ATen 算子和指定的扩展调用做指纹记录,找出第一个输入相同但输出不同的算子。
- kernel 级工具则定位出问题的 kernel、算法配置以及导致不确定性的具体机制。
不要只追踪 loss 明显分叉的那次迭代——第一个出现差异的比特可能更早就已产生。应该先用粗粒度追踪定位最早的差异迭代和相关 rank,然后只在缩小后的范围内开启细粒度的算子和 kernel 追踪。
离线对比追踪结果
每个选定的 rank 将自己的追踪结果写入文件,不引入 collectives 或跨 rank 的顺序约束,以降低掩盖所调查竞态问题的风险。对齐事件时使用与运行无关的标识,比如算子名称、出现次数和模块范围。
查找输入指纹相同但输出指纹不同的情况。
hash(input_run_A) == hash(input_run_B)
hash(output_run_A) != hash(output_run_B)
“首个不匹配点”是针对单个 rank 而言的,序列号无法跨 rank 建立顺序。需根据因果角色对每个 rank 的首个不匹配点进行分类。
| 某个 rank 上的首个不匹配点 | 解读 | 后续操作 |
|---|---|---|
| 输入匹配;输出不同 | 疑似根源 | 检查该操作或其上游生产者 |
| 输入和输出均不同 | 下游接收者 | 继续向上游追溯 |
| 被追踪的 rank 上未找到根源 | 根源位于捕获范围之外 | 扩大迭代窗口或 rank 集合 |
若许多 rank 指向同一个起源操作,则该操作本身很可能是不确定的(nondeterministic)。若只有部分 rank 如此,则需排查拓扑结构、rank 布局、输入分布及归约顺序。
在 GPU 上对张量进行指纹标记
拟议的工作流使用 torch.hash_tensor 生成驻留 GPU 的指纹。在记录其摘要值的同时,需一并记录每个张量的 shape、dtype 及元素数量。对于 MXFP8 或 NVFP4 张量,需对编码值和其 scale 缓冲区都进行指纹标记。
针对整个张量的 XOR 指纹无法检测排列变化。对于顺序敏感的数据(如路由映射图和 MoE dispatch 输出),应利用 dim 参数按行或分块对这些张量进行指纹标记。指纹是一种高效的检查手段,但匹配并不保证张量在位(bit)层面完全一致。需使用字节级比较来确认位级相等性。
排除误报
在定位根本原因前,先检查追踪盲区及无效读取。
- Dispatcher 盲区。
TorchDispatchMode监控经由 PyTorch dispatcher 路由的ATen操作。自定义 kernel 可能逃过该追踪范围。若首个不匹配点出现在简单的 view、slice 或加法操作上,应探查产生其输入的自定义 kernel。 - 探测伪影。未初始化的张量、未完成的异步集体通信操作以及非阻塞拷贝,都可能在内容尚未就绪时被读取。在判定生产者导致不确定性之前,必须先排除这些情况。
- 原始的成对运行应当复现发散现象。
- 应用补丁后的成对运行应当保持比特级一致。
- 确定该修复是纠正了不确定性的实现,还是绕过了问题执行路径。
- 测量新的性能开销。
- 吞吐量和单步时间
- 峰值内存和 GPU 利用率
- 暴露的通信时间
- 主要内核组所占用的时间
- 配方验证:
--deterministic-mode应用规范环境设置,启用 PyTorch 确定性算法,并拒绝没有确定性路径的特性。 - 内核测试:使用相同的输入和 RNG 状态重复执行内核操作,然后逐字节比较输出和梯度。
- 模块验证:在恢复 RNG 状态的前提下,跨并行配置重复执行模型和 Transformer 块,包括 FP8 和 FP4。独立的端到端运行随后验证全精度训练指标保持比特级一致。
验证修复
通过成对运行检查来验证补丁。
注意,比特级确定性在同一硬件和软件环境中验证。跨 GPU 代际、网络配置或库版本的比较超出此验证范围,可能会产生不同的结果。
优化万亿参数 Nemotron 模型的确定性训练
虽然开销较大的确定性方案可以用于调试,但对于生产环境训练来说成本过高。应从一开始就协同优化确定性和非确定性执行。本工作使用一个万亿参数 Nemotron 模型,该模型结合了 Mamba 风格的状态空间模型(SSM)层和 Transformer 注意力层。确定性训练必须涵盖 SSM 和注意力内核、低精度计算、分布式通信以及不同层类型之间的转换。
建立受控基线
在相同模型、硬件、批量大小、并行策略、精度格式、软件环境和测量窗口下,将确定性执行与支持的最快非确定性方案进行对比。
测量以下指标:
计算确定性税:
$\text{Determinism tax} = (\text{deterministic step time} / \text{baseline step time} – 1) \times 100\%$仅在训练性能稳定后收集数据。
优化历程
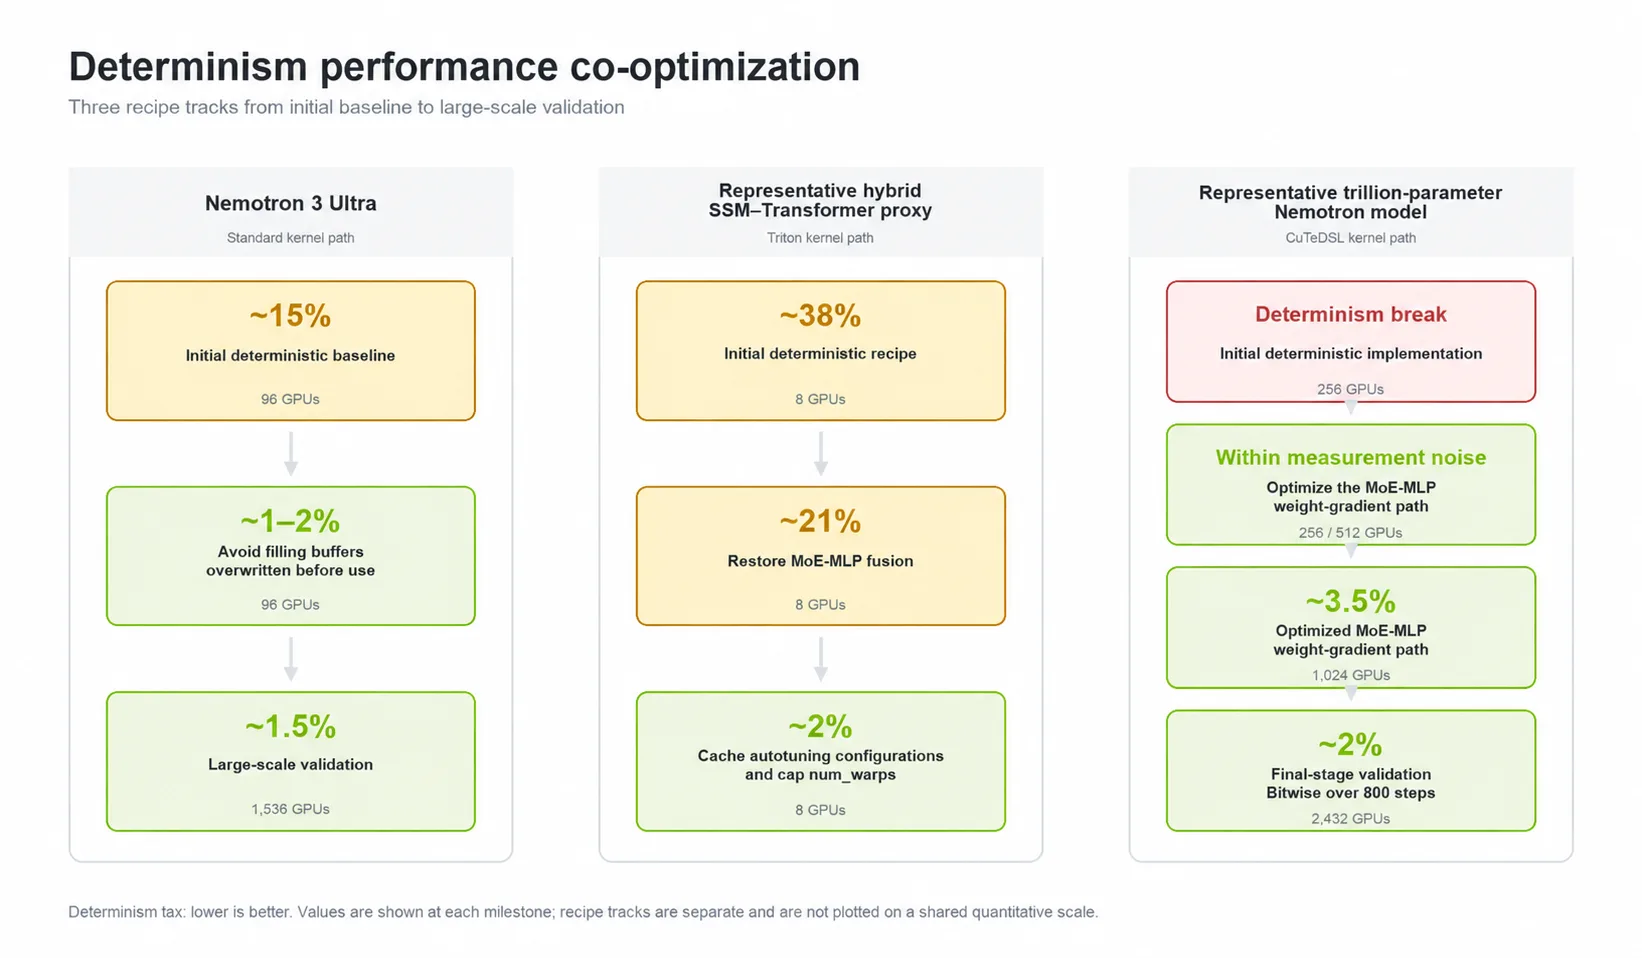
通过对三个工作负载的优化,确定性开销从两位数的基线降到了个位数低位。在 2,432 GPU 规模下,大规模 Nemotron 配方测得的稳态确定性税负约为 2%,并在 800 步内保持了位级确定性。
Kernel 级优化示例
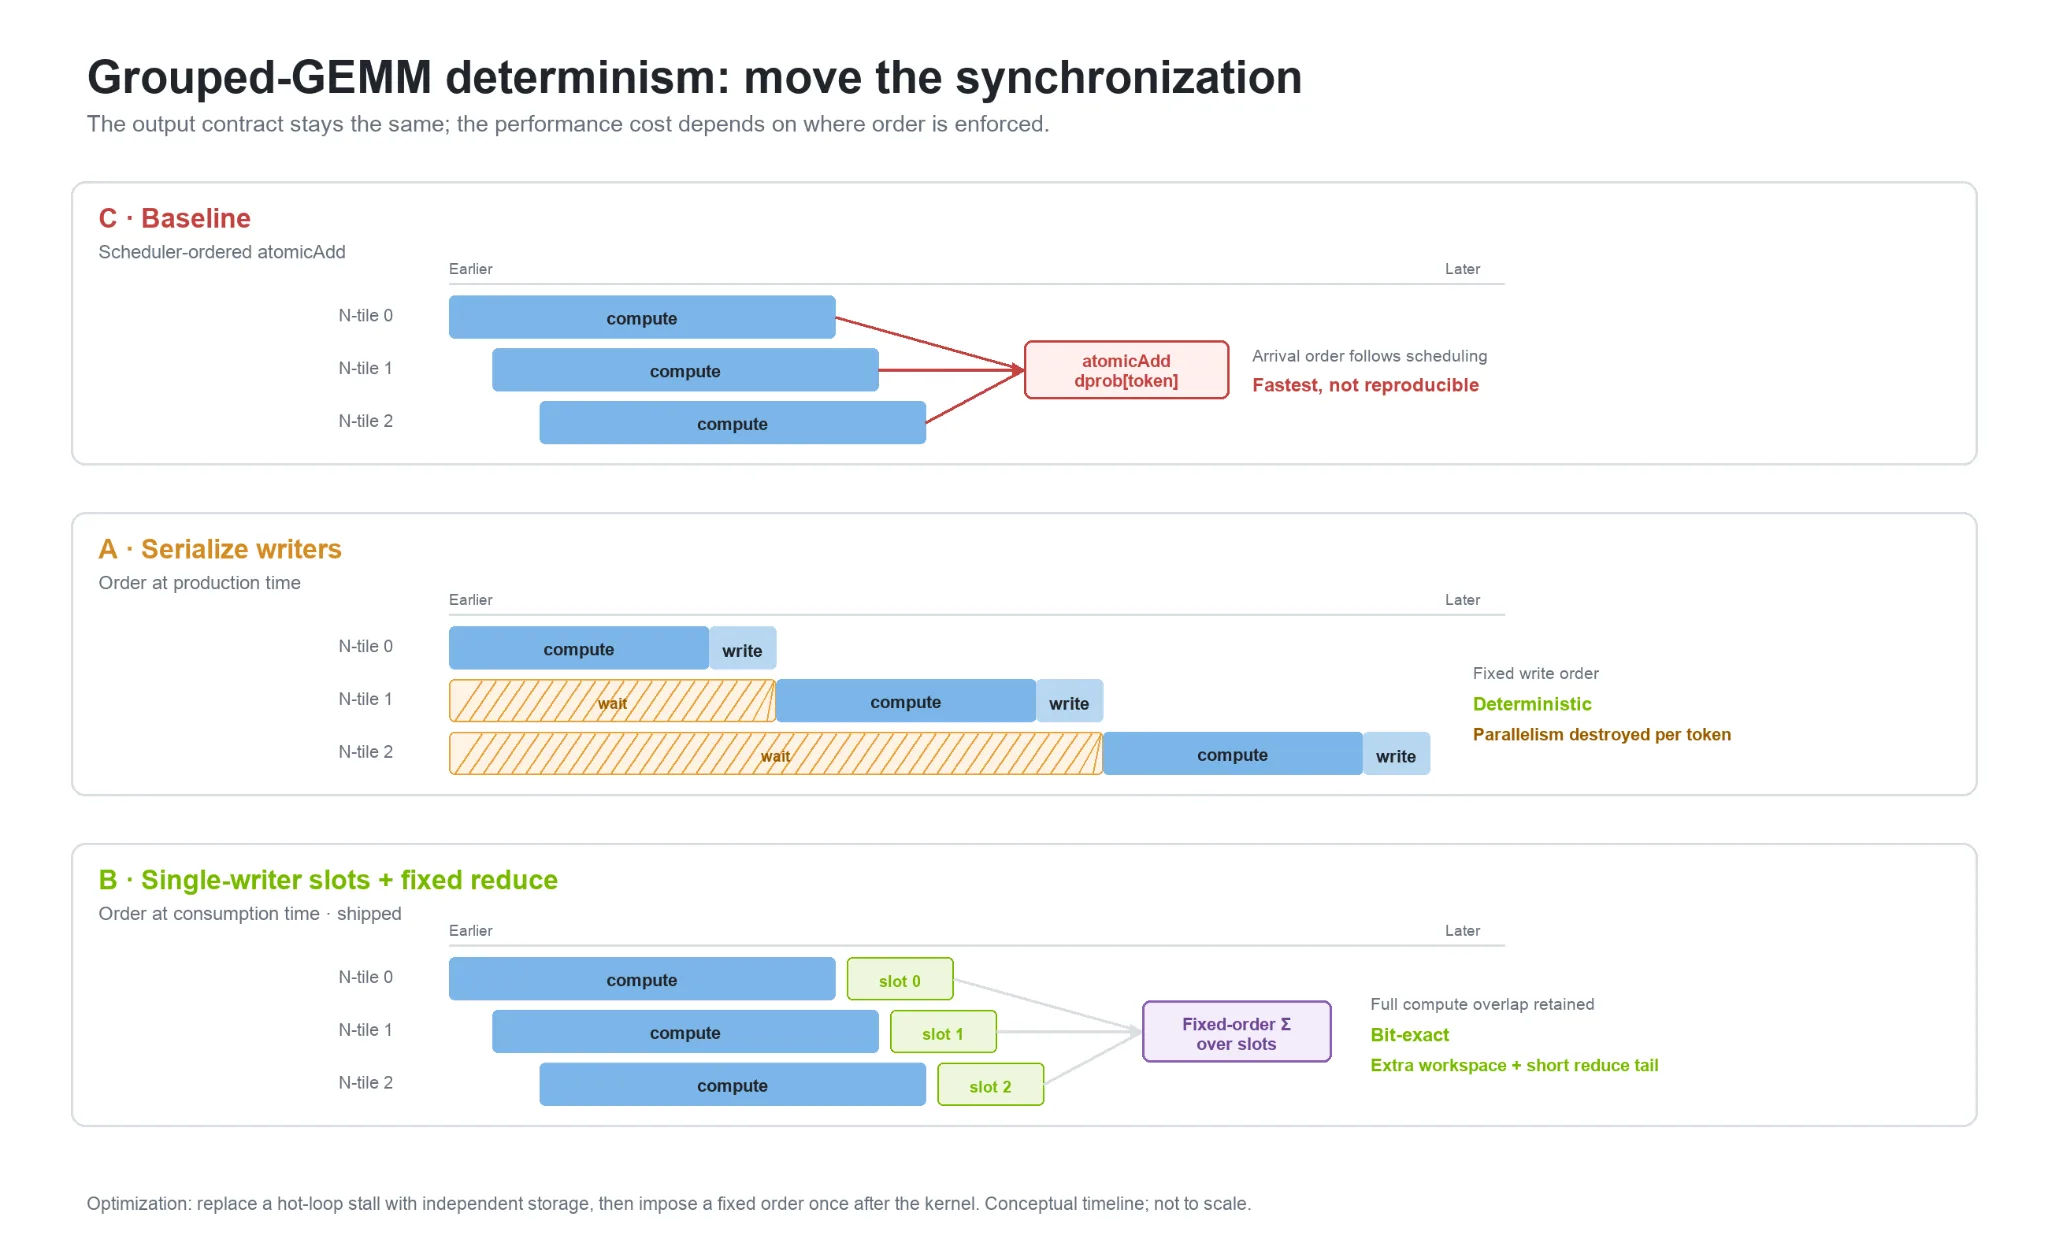
在 grouped-GEMM 的 epilogue 中,多个 N-tile 最初会累加到同一个 dprob[token] 地址上,导致结果取决于它们的到达顺序。将这些写入操作串行化虽然恢复了确定性,却牺牲了并行度。
更好的做法是给每个 N-tile 分配独立的输出槽位,保留 kernel 内部的并行执行,等所有写入完成后,再按固定顺序合并这些槽位。
在大规模场景验证优化效果
在少量 GPU 上确定性开销较低,并不意味着生产规模下也能获得相同结果。通信、同步、流水线气泡、专家路由以及负载均衡均会改变相对开销。假设一次运行中,在 10,000 块 GPU 上使用 100 天的非确定性基线,将开销从 15% 降至 5% 即可节省 10 天,相当于 100,000 个 GPU 天。
随模型、内核和配方演进而维持确定性
新的内核、融合、精度格式或并行配置可能引入非确定性。Megatron-LM 通过以下检查防止回归。
关于当前覆盖范围及已知缺口,请参阅确定性状态、操作目录和内核测试指南。
非确定性的常见来源
利用表 2 确定非确定性的可能原因,并选择下一步诊断措施。
| 观察到的症状 | 可能原因 | 诊断方法 | 解决方案 |
|---|---|---|---|
| 运行结果从第一步开始发散,但不一致 | 运行时自动调优选择了不同的内核配置 | 对比所选配置,追溯最早受影响的输出 | 锁定或缓存经过验证的配置 |
| MoE 运行仅在启用融合辅助损失时发散 | 归约顺序未固定 | 禁用单个融合操作,追溯损失计算过程 | 使用确定性归约或禁用融合 |
| 恢复运行逐渐偏离连续运行 | RNG 状态恢复不完整 | 对比恢复前后立即的 RNG 状态 | 按位保存并恢复所有 RNG 流 |
| 软件或容器更新后出现发散 | 底层库内核发生变化 | 对技术栈进行二分查找,构建最小内核复现案例 | 在修复前选择确定性内核路径 |
| 加载检查点后立即出现参数差异 | 低精度权重或缩放因子重建方式不同 | 对比保存/加载过程中的数值和缩放元数据 | 保留全精度数据源和精确的重建路径 |
| 配方在小规模下通过,但在大规模下失败 | 与规模相关的通信或专家并行路径问题 | 系统性扩大规模并追溯选定的 ranks | 隔离并修正首个与规模相关的操作 |
快速入门
Bitwise determinism 让大规模预训练的调试和断点恢复变得更简单。Nemotron 的案例展示了如何通过 kernel 和训练配方(recipe)的优化来降低其性能开销。建议在你实际使用的软硬件环境中验证可复现性和开销。
入门时,可以先查阅 Megatron Core 用户指南 中推荐的训练配方,然后对比独立运行与从 checkpoint 恢复运行的结果,验证可复现性。