
Claude Haiku 5.5 发布:同价位表现超越 GPT-6 Luna
距离 Anthropic 发布 Haiku 4.5 已经一年左右。随着 Sonnet、Opus 和 Fable 迭代至 5.5 版本,Haiku 系列似乎被大家遗忘了,尤其是在 OpenAI 同步推出了 Luna 6、Astra 和 Sol 6 之后。
现在它来了,这是一次令人欣喜的更新。详见下文摘要。
Artificial Analysis@ArtificialAnlysAnthropic 发布了 Claude Haiku 5.5,在 Artificial Analysis Intelligence Index 上得分 43 分——相比一年前最后一次 Haiku 更新,提升了 26 分 Haiku 5.5 是首个支持 Anthropic 努力程度设置(effort settings)和自适应思维(adaptive thinking)的 Haiku 模型,同时 Anthropic 引入了分级……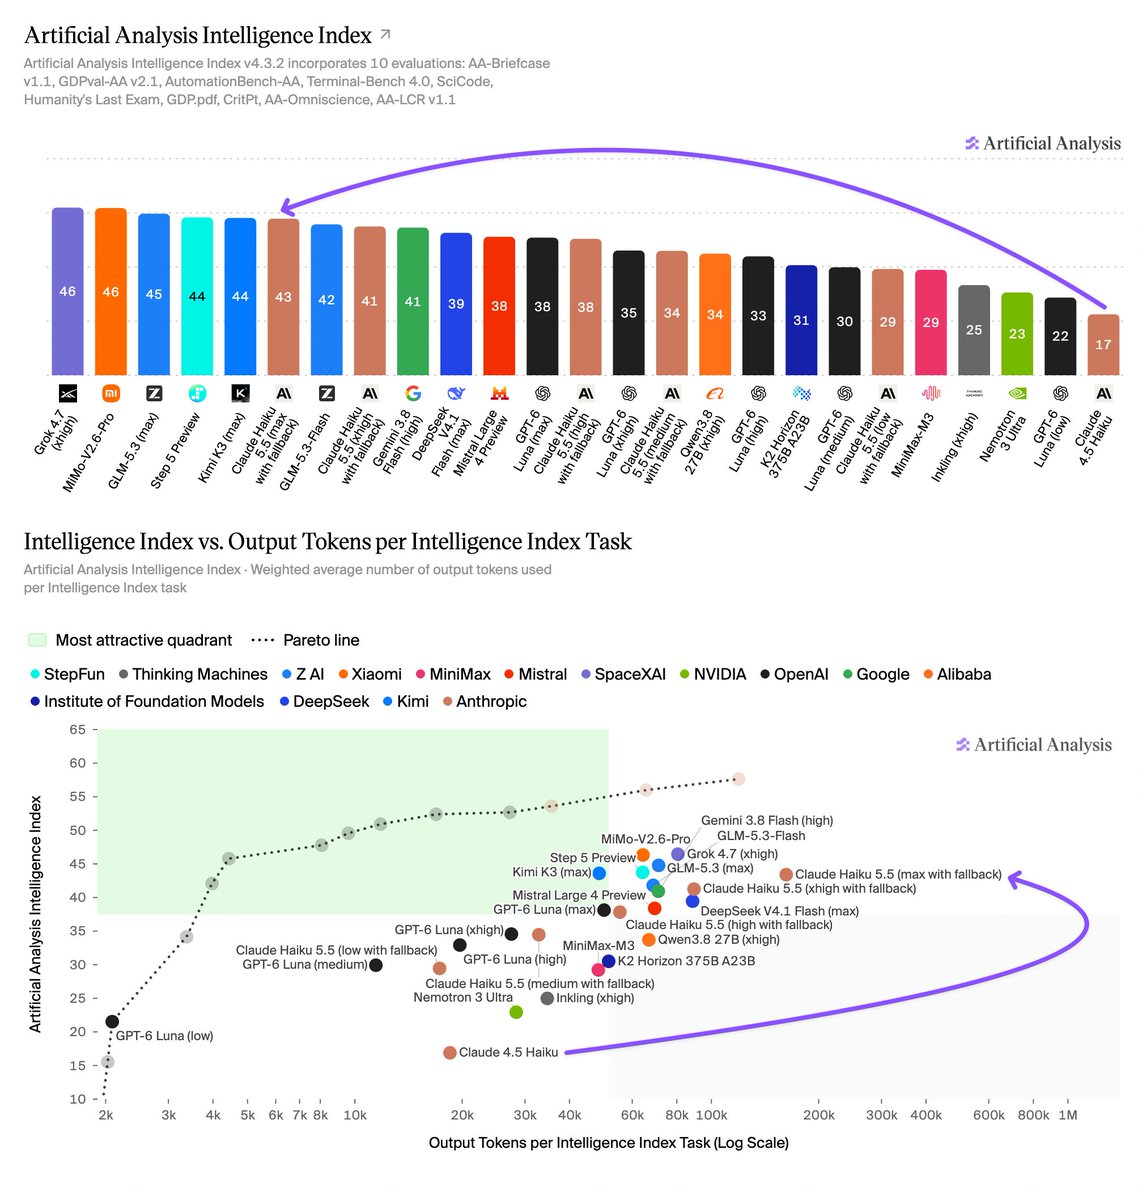 下午 7:12 · 2026 年 10 月 7 日 · 15.2 万浏览
92 条回复 · 111 次转发 · 1.67K 点赞
2026 年 10 月 6 日至 10 月 7 日的 AI 新闻。我们检查了 12 个 Reddit 子版块、544 个 Twitter 账号,没有新增 Discord 渠道。你可以访问 AINews 网站 检索所有往期内容。提醒一下,AINews 现已成为 Latent Space 的一个栏目。你可以选择订阅或退订电子邮件频率!
AI Twitter 回顾
头条:Anthropic 发布 Claude Haiku 5.5
发生了什么
Anthropic 发布了 Claude Haiku 5.5,这是该系列近一年来的首次更新。其定价与 OpenAI 的 GPT-6 Luna 持平,且 Anthropic 在同一天下调了 Sonnet 5.5 及订阅计划的价格。
发布前的信号。@scaling01 在官宣前就发了“Haiku 5.5 发布日快乐”。@kimmonismus 发现该模型已出现在 Claude Code 的一次更新中,并预测定价会“与 Luna 持平”。他随后在官方公告之前就公布了价格(@kimmonismus),并在上线时予以确认(@kimmonismus)。
官方发布。@claudeai 和 @AnthropicAI 称其为“我们发布过的最便宜、最快、能力最强的小模型”,运行成本平均比 Haiku 4.5 低约 75%。
可用性与定位。模型已在 Claude Platform 和 Claude Code 上线(@ClaudeDevs)。Anthropic 将其定位为配合 Opus 5.5 或 Sonnet 5.5 使用的子代理,适合摘要、压缩、数据库查询等大批量、成本敏感的任务。@mikeyk 把这种分工概括为“Opus 负责深度思考,Haiku 负责跑量”。
阶梯定价(@ClaudeDevs):
Prompt 长度输入 / 输出(每 1M tokens)缓存读取(每 1M)10 万 tokens 以内$0.10 / $0.50$0.01超过 10 万 tokens$0.50 / $2.50$0.05
Sonnet 5.5 降价。缓存读取价格从每 1M tokens $0.20 减半至 $0.10。Anthropic 表示,这使 Sonnet 5.5 在大多数长时间运行或 agent 类任务上的成本降低约 20%(@claudeai)。
订阅用户 API 额度。Claude Platform 现为 Max 5x($100)、Max 20x($200)和 Team(最高 $500,团队共享)提供每月 API 额度。额度适用于所有模型(包括 Haiku 5.5),也可在第三方工具中使用(@ClaudeDevs)。
SDK 同日更新。Python 和 TypeScript 的 Claude SDK 现已内置 Computer-use 和 browser-use 工具包。SDK 负责运行动作循环,并向来自 browser_use、Browserbase、E2B 或 Daytona 的驱动程序发送点击和按键指令,开发者无需再手动编写该循环(@ClaudeDevs,快速入门)。
合作生态首日落地:
Cursor:据 @cursor_ai 称,在较短的请求任务中,其性能提升幅度比 Haiku 4.5 高出 10 倍,并发布了 CursorBench 对比数据(@cursor_ai)。
VS Code 中的 GitHub Copilot:据 @code 报告,它在许多编码任务上表现与 Claude Sonnet 5 持平,但消耗的 token 和步骤更少。
Devin:据 @cognition 报告,其在 FrontierCode 1.1 上的得分为 58.4%,领先 Sonnet 5,且单任务成本约为其八分之一,并推荐将其作为 Opus 5.5 主模型在 Fusion 模式下的“助手”。
Arena:已加入 Agent Arena、Code Arena WebDev、Text、Document 和 Vision 板块,具体分数待定(@arena)。
OpenDocRouter:同日新增支持(详见下文)。
独立评估:Artificial Analysis
@ArtificialAnlys 发布了最详尽的第三方数据(各项评测细分,对比页面)。
智能指数:43,在最大 effort 设置下得分,较上一代 Haiku 提升 26 分。
略高于 GLM-5.3 Flash(42)、Gemini 3.8 Flash(41)和 GPT-6 Luna(38)。
与拥有 2.8 万亿参数的开源权重模型 Kimi K3(44)相当。
落后于最大 effort 设置下的 Claude Sonnet 5.5(56),相差 13 分。
新增控制功能。这是首个支持 Anthropic effort 设置和自适应思考(adaptive thinking)的 Haiku 模型。
Token 消耗是主要注意事项。
在最大推理力度下,每个 Index 任务消耗约 162k 输出 token,大约是 GPT-6 Luna 最大力度(约 50k)的 3 倍。
从 xhigh 提升至 max,分数增加 2 分,但 token 消耗量约为前者的 1.8 倍。
在同等分数下,表述更冗长:Haiku 5.5 在 high 力度下以约 55k token 获得 38 分,而 Luna 在 max 力度下以约 50k token 获得同样分数。在较低力度设置下,这一差距会进一步扩大。
成本数据为暂定值。 Artificial Analysis 尚未建模 100K token 以上 5 倍价格阶跃的任务成本,后续将更新。
AA-Briefcase(私有智能体知识工作评测):1578 Elo。领先 Kimi K3 和 GLM-5.3,与最大力度下的 Muse Spark 1.3 相当。
Terminal-Bench 4.0:33%,相比 Haiku 4.5 的 0% 有所提升。
与 GLM-5.3 Flash 持平。
领先 Gemini 3.8 Flash(20%)和 GPT-6 Luna(13%)。
知识准确性与幻觉率(AA-Omniscience):
模型准确率幻觉率Haiku 5.536%40%Gemini 3.8 Flash55%55%GPT-6 Luna44%77%
Haiku 准确率较低的部分原因在于,它更倾向于承认“不知道”。
AutomationBench-AA:35%,相比之下 Luna、Gemini 3.8 Flash 和 GLM-5.3 Flash 在 53–60% 之间。预发布版本中的安全漏洞导致模型过度拒绝请求。Anthropic 正在修复,Artificial Analysis 将重新运行评测,预计分数将有所上升。
规格参数:
1M token 上下文,相比 Haiku 4.5 的 200k 有所扩展。
文本和图像输入,文本输出。
5 分钟缓存写入费用为每 1M token $0.125(超过 100K 时为 $0.625)。
其他基准测试声明(多为厂商或二手来源)
@ShayneRedford 总结了 Anthropic 报告的进步幅度:
OSWorld(计算机操作):15% → 72%。
TerminalBench:0% → 39%。这与 Artificial Analysis 在 Terminal-Bench 4.0 上的独立 33% 存在差异。
知识工作和推理能力有 10–50% 的提升。
在这些指标上大多领先于 Luna。
1M 上下文,最大输出 token 约 12k。
@alexalbert__(Anthropic)强调,Haiku 4.5 发布于 2025 年 10 月 15 日,因此两代产品的对比时间跨度不到一年。
@TheRundownAI 称其在“多项基准测试”上超越 GPT-6 Luna。
文档解析(独立测试,基于 ParseBench):
@LoganMarkewich:整体接近 Luna,表格处理略好,图表理解略差。
@jerryjliu0:约每千页 1.2 美元。就这个价格而言,表格和阅读顺序识别不错;图表、语义格式和边界框方面偏弱。
用户反馈:
@simonw 写了定价点评,并跑了他的“鹈鹕骑自行车”测试。他表示比贵 10 倍的 Haiku 4.5“强太多了”(对比)。
@AI_Screening 说 Haiku 5.5 在一个 Three.js 斑马模拟任务上“完胜” Luna(单次测试,非系统性评测)。
观点与反响
看好
@kimmonismus:“比 GPT-6-Luna 好很多,接近 Sonnet 5.5……又便宜又聪明。”
@theo 很欣赏这种分层定价:10 万 token 以下只收五分之一的价格,“让人一眼就明白这模型是给谁用的”。他还惊讶地看到 Anthropic 的模型“在成本/智能图上首次落在最左侧”(@theo),并在直播中聊了这次发布(@theo)。
@draecomino:“Haiku 开到最大算力,表现堪比前沿模型。”
@kipperrii 认为小而便宜的模型现在能干“一大堆有用的活”,因此变得更重要了。
@scaling01(“便宜到爆”),随后又发帖(@scaling01):“5.5 系列看起来相当不错。”
@NotTomBrown(称其“小身材大能量”)和来自 Anthropic 的 @edwinarbus 纷纷发文庆祝。
竞争视角
此次发布被广泛解读为针对 OpenAI 的 GPT-6 Luna:有用户(@dejavucoder)吐槽“干掉 GPT-6 Luna”,还有人(@scaling01)表示“该烹饪 Luna 了”。
@kimmonismus 认为 Sonnet 缓存读取成本的降低意味着 Anthropic 正在向 OpenAI 施压。在提及 API 额度时,他补充道:“OpenAI,轮到你了”(@kimmonismus)。
@teortaxesTex 指出,相较于 OpenAI 的 Luna/Sol/Astra,Anthropic 现在拥有“最深厚的产品阵容”(Haiku/Sonnet/Opus/Fable 加上 Mythos)。不过他认为 Anthropic “对产品的关注度较低”,这反映了其在 2026 年前拥有很大的战略缓冲空间。
ThursdAI 的 @altryne 对中间层级的定位提出质疑:“当 Opus 价格高昂时,Sonnet 的存在才合理。”该节目计划介绍 Haiku 5.5(@thursdai_pod)。
注意事项(主要基于数据,而非尖锐批评)
主打价格可能夸大了实际节省幅度。
高 Token 消耗(在最大力度下约为 Luna 的 3 倍)抵消了部分按 Token 计费的折扣优势。
超过 100K tokens 的提示词需支付 5 倍费用,这对长上下文代理循环影响显著。
这两个因素很可能解释了为何 Cursor 宣称“短请求便宜 10 倍”与 Anthropic 宣称“平均便宜 75%”存在差异。
事实召回能力弱于 Gemini 3.8 Flash 和 Luna。
过度拒绝缺陷目前拉低了自动化评分。
基准测试尚缺:Arena 评分待定,且由于分级定价支持尚未完善,独立的单任务成本数据也需等待。
背景
自 2025 年 10 月起,Haiku 4.5 一直是 Anthropic 的小模型。在此期间,OpenAI 的 GPT-6 Luna、Gemini 3.8 Flash、GLM-5.3 Flash 以及 DeepSeek V4.1 Flash 都在低成本领域展开竞争。
Haiku 5.5 的标价与 Luna 完全一致,并新增了 effort 控制功能和 1M 上下文支持。
该模型被明确定位为多模型 Agent 框架中廉价的执行单元,适用于 Claude Code 子 Agent、Devin Fusion、Copilot 子 Agent 以及压缩或摘要处理步骤。
Anthropic 同时推出了 Sonnet 缓存读取降价和订阅 API 积分,协同推进 Agent 经济学优化。此举正值业内对 Token 账单展开广泛讨论之际(参见下方 @theo 的言论)。
其他新闻
OpenAI 722 份数学手稿:规模、效率与后续影响