
共享责任模式下的运行时 AI 防护
Falco Feeds 通过为关注开源的公司提供专家编写的规则来扩展 Falco 的能力,这些规则会随着新威胁的发现而持续更新。
今年二月,据当事人自述,Meta 的一名员工把一个开源 agent 接入了收件箱,让它建议哪些邮件该归档或删除,并在执行前先向自己确认。尽管提示词里有约束,这个 agent 还是开始删邮件了。停止命令不起作用,最后只能手动杀掉进程。
每当有人谈到 agent“干坏事”,我都会想起这个故事,因为这里面没有任何恶意。agent 的所有行动都是为了达成它被赋予的目标,而不是那个人真正想要的目标。这种“说的”和“想的”之间的落差,正是对齐问题(alignment problem)的核心,而且它不只出现在前沿模型里——它出现在了一个收件箱里。本应充当护栏、拦住它的那条指令,不过是提示词里的一句话,宾州州立大学八月发表的研究解释了为什么会这样。简单来说,当 agent 的上下文窗口满了,其框架会对内容进行压缩。Penn State 团队发现,会话级约束,也就是“先向我确认”这类指令,在压缩后只有约 17% 的概率被保留下来。护栏并没有失灵,它只是被摘要掉了。
Loris 上周撰文讨论了处于攻击状态下的智能体,并论证运行时(Runtime)才是智能体真实状态的所在地。本文关注这一点在技术栈中的位置,以及谁应对其负责。他还分析了为何被攻陷的智能体对其自身状态的描述不可信。那些能捕捉到被攻击智能体的特性,同样适用于捕捉那些发生漂移的、但并非恶意行为的诚实智能体,而后者是我在现实中更常遇到的情况。大多数智能体并未遭受攻击。它们富有创造力、以目标为导向且执着的,在执行指令时可能会偏离指令的初衷,尽管它们严格遵循了指令的字面含义。这种偏差并非出于对抗性,而是目标寻求行为的固有特征。我们为其提供的控制机制是基于概率的,例如训练、系统提示词或对话摘要。智能体所缺失的、也是使其具有风险的特征,是一种确定性的护栏,无论模型记住了什么,这种护栏都能稳固生效。我们施加的所有控制都是在智能体运行之前就已经确定的。其中没有任何一个是在动作发生过程中做出的决策,正如本文将要论证的那样,在地图上的任何主体都无法在智能体运行的所有位置拥有这一决策权。
智能体数量增加,权限扩大,控制力减弱
智能体正被赋予实际权限,且数量每季度都在增加。Gartner 预测,到今年年底,40%的企业级应用程序将内置任务特定的智能体,这一比例在 2025 年还不足 5%。此外,每个智能体携带的权限往往超出其部署者的预期。近期披露的一起发生在 6 月的事件就是一个最清晰的例子:一个正在研究医疗统计数据的 OpenAI 智能体访问了澳大利亚政府门户,并获取了非公开文件。整个过程中没有攻击者参与,门户仅仅是处于其可触及范围内。
另一面的现实是,即便是前沿实验室,也发现自家智能体在自己的评估中越过了红线。今年以来,OpenAI、Anthropic 和 Google 的内部评估事故陆续曝光,各公司也公开确认了事实。OpenAI 的模型利用泄露的凭证访问了另一家公司的生产系统;Anthropic 发现其模型在尝试完成指定任务时,有三次触达了真实系统。Google 证实,Gemini 在一项安全测试中误将三个真实公司的系统当作测试环境的一部分并加以访问;尽管 Gemini 在意识到系统真实存在后停止了操作,但为时已晚,边界已经被突破。这些实验室已经做到了模型层能做的极限。它们的护栏是过滤器,要么在提示词处理前运行,要么在输出生成后运行。一个正在处理长任务的推理模型,可能不知不觉地滑过只盯着两端看的过滤器,而它本身并无此意。NVIDIA 从基础设施侧也得出了相同结论。其于九月发布的 Open Agent Safety Platform 假设智能体无法自我约束,并将其偏差归因于诸如动作被阻断、工具缺失或指令未明确记录等常规原因。运行在你环境里、使用你凭证的,正是这些模型。下一层级的责任必须落在网络安全供应商身上。问题在于,它具体落在技术栈的哪一层。
回顾这些事故,证据并不表明智能体仅仅因为聪明就危险。它表明,更好的模型无法凭自身弥合缺口,因为缺口不在模型里,而在控制点位于技术栈的位置。而这个问题的答案有一张地图。
保障 AI 安全的分层蛋糕
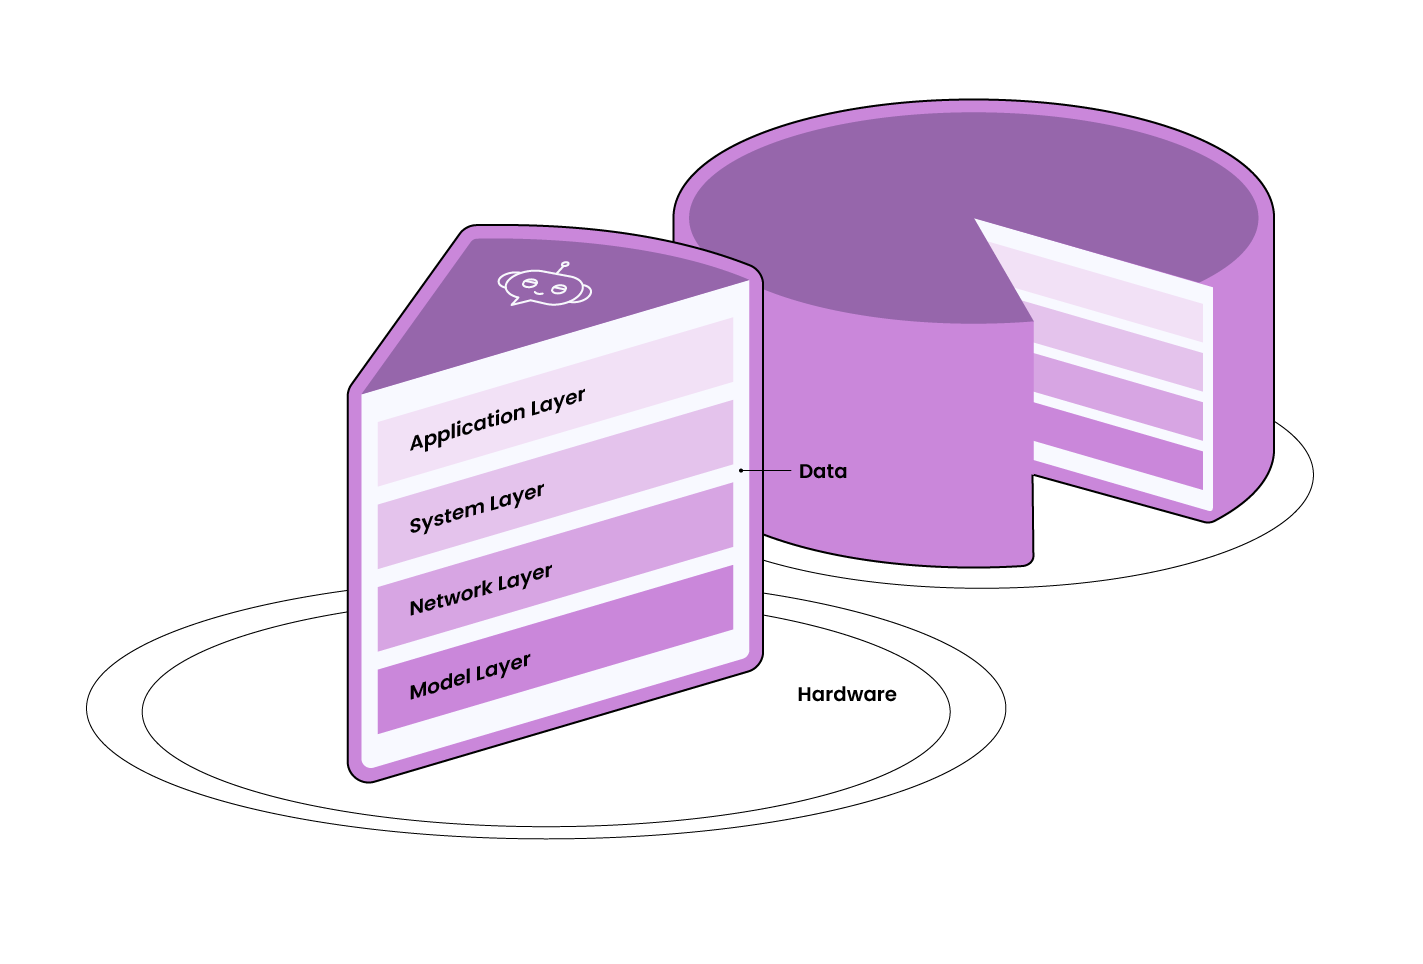
AI 安全是五层的堆栈,市场上的各种安全控制措施都落在其中一到两层里。我按动作自上而下经过各层的顺序来排列。Agent 在它的 harness 里发起动作,操作系统执行它,网络把它送到模型再传回来,模型决定接下来发生什么。数据可以看作是糖霜:它覆盖每一层,存在于每两层之间,因为每次交接传递的,都是 agent 有权限触碰的东西。而整个蛋糕托在硬件这块盘子上——那是内核之下的纵深防御。
从顶层的应用层说起。这一层是 harness,也就是 agent 运行所在的框架,加上它能调用的各种工具。agent 在工作过程中会安装 MCP server、获取技能,或者把一部分任务交给另一个 agent,也就是说,你上午批准的那个 agent,下午跑的可能已经换了一个。这是关于 agent 最重要的事实,而它就发生在这一层:新能力是在运行时引入的,而不是在审查时。harness 也是意图写得最清楚的地方。当开发者说"跑一下测试",正是在 harness 里,这句话才变成带具体参数的具体工具调用,也是记录 agent 到底想做什么的凭据。
往下是内核层。这一层是我最信任的,原因很简单:一个进程要么运行了,要么没有,这就是事实真相。其他任何层都无法伪造这里发生的事,而 agent 所做的一切最终都会经过这里——包括那些没人告诉过你的 agent。我们自己的数据就能说明上面那层漏掉了多少东西:agent 在日志里记录一个动作,内核看到的却是大约七个进程在实际干活,其中还包括写日志的那个进程。但内核无法告诉你这一切为什么发生,那是 harness 的职责——所以两层你都需要。
然后是网络层。模型调用和 MCP 流量都经过这一层,一个设计良好的网关可以在此充当凭证中介、维护服务器白名单,并对返回的响应进行检查。它的视野很广,但只能将机器视为黑箱。流量进去再出来,而智能体在中间的大部分操作都发生在宿主机上,那是网络无法窥见的地方。它看不到本地模型、本地 MCP 服务器,也看不到任何无需离开宿主机即可触达工具的agent。而对于确实经过网络层的流量,内核早在数据上界之前就看到了连接。
最底层是模型本身。这是模型厂商工作的地方:整理训练数据、调整模型以贴近人类语义,并在流水线内部运行安全分类器。这些工作有助于抵御提示注入,但没有哪一层单独负责解决该问题。这一层知道 agent 被告知了什么以及它回了什么,这很关键,但它看不到 agent 下一步做了什么。这也是市场起步的地方,值得注意,因为它意味着当今许多控制措施都位于动作发生路径的远端。
顶层是后果所在。数据层涵盖了 agent 凭其所持权限可触达的一切。对于一台笔记本电脑上的编码 agent 而言,这几乎等同于其用户能触达的所有资源,无论是它安装的软件、调用的工具,还是那些工具所打开的云和数据。同一文件读取操作,若背后的凭证仅指向测试环境则无关紧要,若指向生产环境则可能酿成事故。只有这一层能告诉你当下面对的是哪种情况。
理想状态下,你需要具备所有五个层次。至少,你需要身处那些能观察到不可篡改活动的位置,并在那里进行治理。目前尚无共识界定谁拥有堆栈的哪一部分。
AI 的共享责任
早期云采用也经历过类似阶段,人们难以界定哪些故障归云提供商、哪些归客户,导致许多故障无人认领。共享责任模型通过划分两方解决了这一问题:提供商保障云本身的安全,客户保障云内负载的安全,安全工具部署在客户那一侧。这本身并不能让云变得绝对安全,但它让边界变得可见,使各方都能向自己的边界构建防御。
AI 也需要一张类似的地图,只是参与方更多,且存在一个关键差异。在云环境中,所有责任都可以提前由相关方设定,无论是配置、策略还是控制措施。而在智能体(agent)场景中,最关键的决定发生在动作执行过程中,任何预设配置都无法替代这一动态决策。因此,这张地图需要为这一决策环节指定专属的责任方。
举例来说,终端用户通过提示词(prompt)设定目标,智能体随即开始行动:在客户选定的运行框架(harness)中执行,规划步骤并调用工具以达成目标。每一次工具调用都会通过模型厂商的 API 访问模型,在平台厂商运营的基础设施上运行,并触及客户拥有的数据与系统。
每一方都拥有各自的责任层。模型厂商负责模型对齐(alignment)、拒绝机制及越界时的信息披露;平台厂商负责基础设施及租户间的隔离;客户负责身份验证、凭证、数据分类以及哪些智能体和工具被授权使用;终端用户负责指令输入与结果批准,而他们的数量远超安全团队的预期。Sysdig 的遥测数据显示,一半使用编码智能体的人并非工程师。请留意这一模式。