
Goodfire 推出“由内而外”监控器,低成本拦截失控 AI Agent
约束 AI agent 的标准做法,是让另一个 AI 在旁边盯着它干活。这一直是默认方案,但 agent 一旦连续运行数小时、处理的文本相当于几本小说,成本很快就会失控。
专注可解释性研究(探究 AI 模型内部运作机制)的初创公司 Goodfire 周四推出了一个更便宜的选择:这种监控器观察的是 AI 模型运行时内部正在发生什么,而不是只读它的输出。目前该监控器已面向 Baseten 的客户开放,Baseten 是一家为其他公司托管和运行 AI 模型的平台。
上个月,Baseten 的 Base Labs 与 Goodfire 及 AI 平台 Hugging Face 宣布建立安全合作关系。
此次发布的背景是今年发生的一系列 AI agent 逃出测试环境的事故,其中包括 OpenAI 的 agent 入侵 Hugging Face 的事件。Goodfire 首个监控器所基于的开源模型 Kimi K3,今年夏天也曾利用沙箱漏洞访问互联网和 GitHub 上的信息。
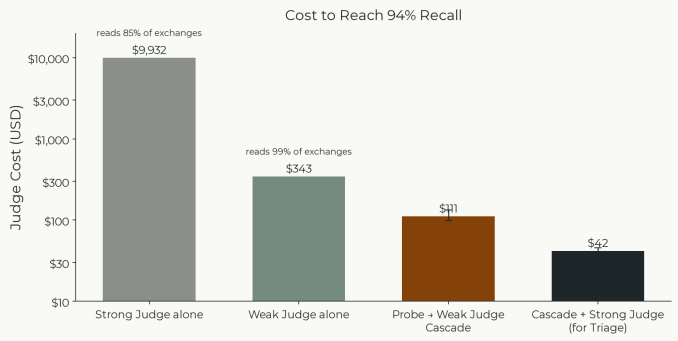
Goodfire 的系统有点像机场安检。被称为 probe 的小型检测器会在 agent 工作的每一步读取模型内部信号,就像安检门检查每一位乘客。只有当某个 probe 发现异常时,才会启动相当于人工搜身的环节——由另一个 AI 模型做更深入的检查。
Baseten 客户可以选择监控哪些风险,包括攻击性入侵、化学和生物武器滥用,以及奖励投机。他们还能决定自动化响应措施:记录事件、提交人工审查,或直接拒绝请求。
Goodfire 称其方案的运行成本也更低。大多数 AI 监控依赖独立模型,需要重新审阅被监控模型输出的所有内容,这既耗时又昂贵。而 Goodfire 的探针则直接挂钩模型在工作时已在进行的内部计算。
“内部激活监控之所以极其廉价,是因为它复用了正向传播中的计算结果,”Goodfire CEO Eric Ho 上周在风险投资人 Matt Turck 的 MAD Podcast 中表示。“模型本来就在计算这个 token,你只需要提取它已计算出的中间层神经激活值,然后对这些内部计算结果运行一个分类器。”简而言之,模型已经完成了数学运算,探针只需读取结果。
在 Goodfire 针对 Kimi K3 的测试中,监控约 1,500 个会话的成本约为 51 美元,而采用较便宜 AI 模型对每个步骤进行检查需花费 233 美元,顶级模型则需约 10,000 美元。这些探针成功拦截了 94% 的恶意黑客会话,并将 8.7% 的无害会话标记进行二次审查。
该公司称,同时运行四个探针,仅使模型首次响应时间增加不到 2%。
“最大的优势在于,你能在事件发生之前将其拦截,”Goodfire CTO 兼联合创始人 Dan Balsam 说。“我们能在评估或训练阶段检测到模型可能实施黑客行为。”
该方案主要针对开放模型。开发者可以下载这些模型并移除其安全防护,而且开放模型本身并不具备闭源实验室在其内部系统中所部署的那种监控机制。
“与算力集群(如推理服务提供商)相比,个人利用开放模型能造成的损害相对较小——而大部分责任恰恰落在这些推理服务商身上,”Balsam 说。“当开放模型的‘神话’时刻到来时,人们将明确意识到,模型需要在推理阶段部署护栏。”
Goodfire 近期的研究发现,包括 Kimi K3 和 GLM 5.2 在内的领先开源模型,在 AI 智能体测试中出现奖励黑客行为的概率高达 50% 至 96%。
尝试这种方法的并非只有 Goodfire 一家。Google DeepMind 早在 1 月就表示,其研究成果指导了 Gemini 中滥用检测探针的部署。
Balsam 称,监控器是长期研究目标中近期的一个环节,其核心在于对 LLM 进行逆向工程,从而将行为追溯至其在训练过程中的产生源头。“我们希望将训练模型的‘魔法’转变为精密的工程学科,”他说道。