
机器人领域的 AI 突破,短期内不会改变你的生活
本文由 MIT Technology Review 与 Aventine 合作撰写。Aventine 是一家非营利研究基金会,致力于创作和支持探讨科技与科学如何改变我们生活方式的内容。
一个类人机器人在视频片段中频频亮相——它通体白色,头部和躯干为黑色。你也许见过它跳舞、分发爆米花、扔垃圾、吸尘,或按微波炉按钮。你或许也见过它在发水瓶时向后摔倒,或在熨衬衫时步履蹒跚。
这正是 特斯拉 Optimus。这是一款由 AI 驱动的类人机器人,其首席执行官埃隆·马斯克坚信它将“不仅是特斯拉有史以来最大的产品,更可能是史上最大的产品”,未来将进入工厂车间,最终走进家庭。他在七月向股东表示,这类机器人最终将拥有“与人类相当,甚至超越人类的灵巧度”。马斯克认为,Optimus 机器人能以低至 2 万美元的成本,自动化几乎所有人类劳动——从搬运金属板材到叠衣服。1 月,他在瑞士达沃斯举行的世界经济论坛年会上预测,这类机器人有望在 2027 年底前面向公众发售。
马斯克并非唯一的热忱倡导者。硅谷风险投资公司 Andreessen Horowitz 的联合创始人兼普通合伙人马克·安德森曾表示,机器人产业可能成为“这颗星球历史上最大的产业”。1 月,英伟达 CEO 黄仁勋也表示,类人机器人将在今年达到人类水平。据摩根士丹利预测,到 2050 年,“外观和行为类似人类”的机器人数量可能接近10 亿台,催生一个价值超过 5 万亿美元的市场。
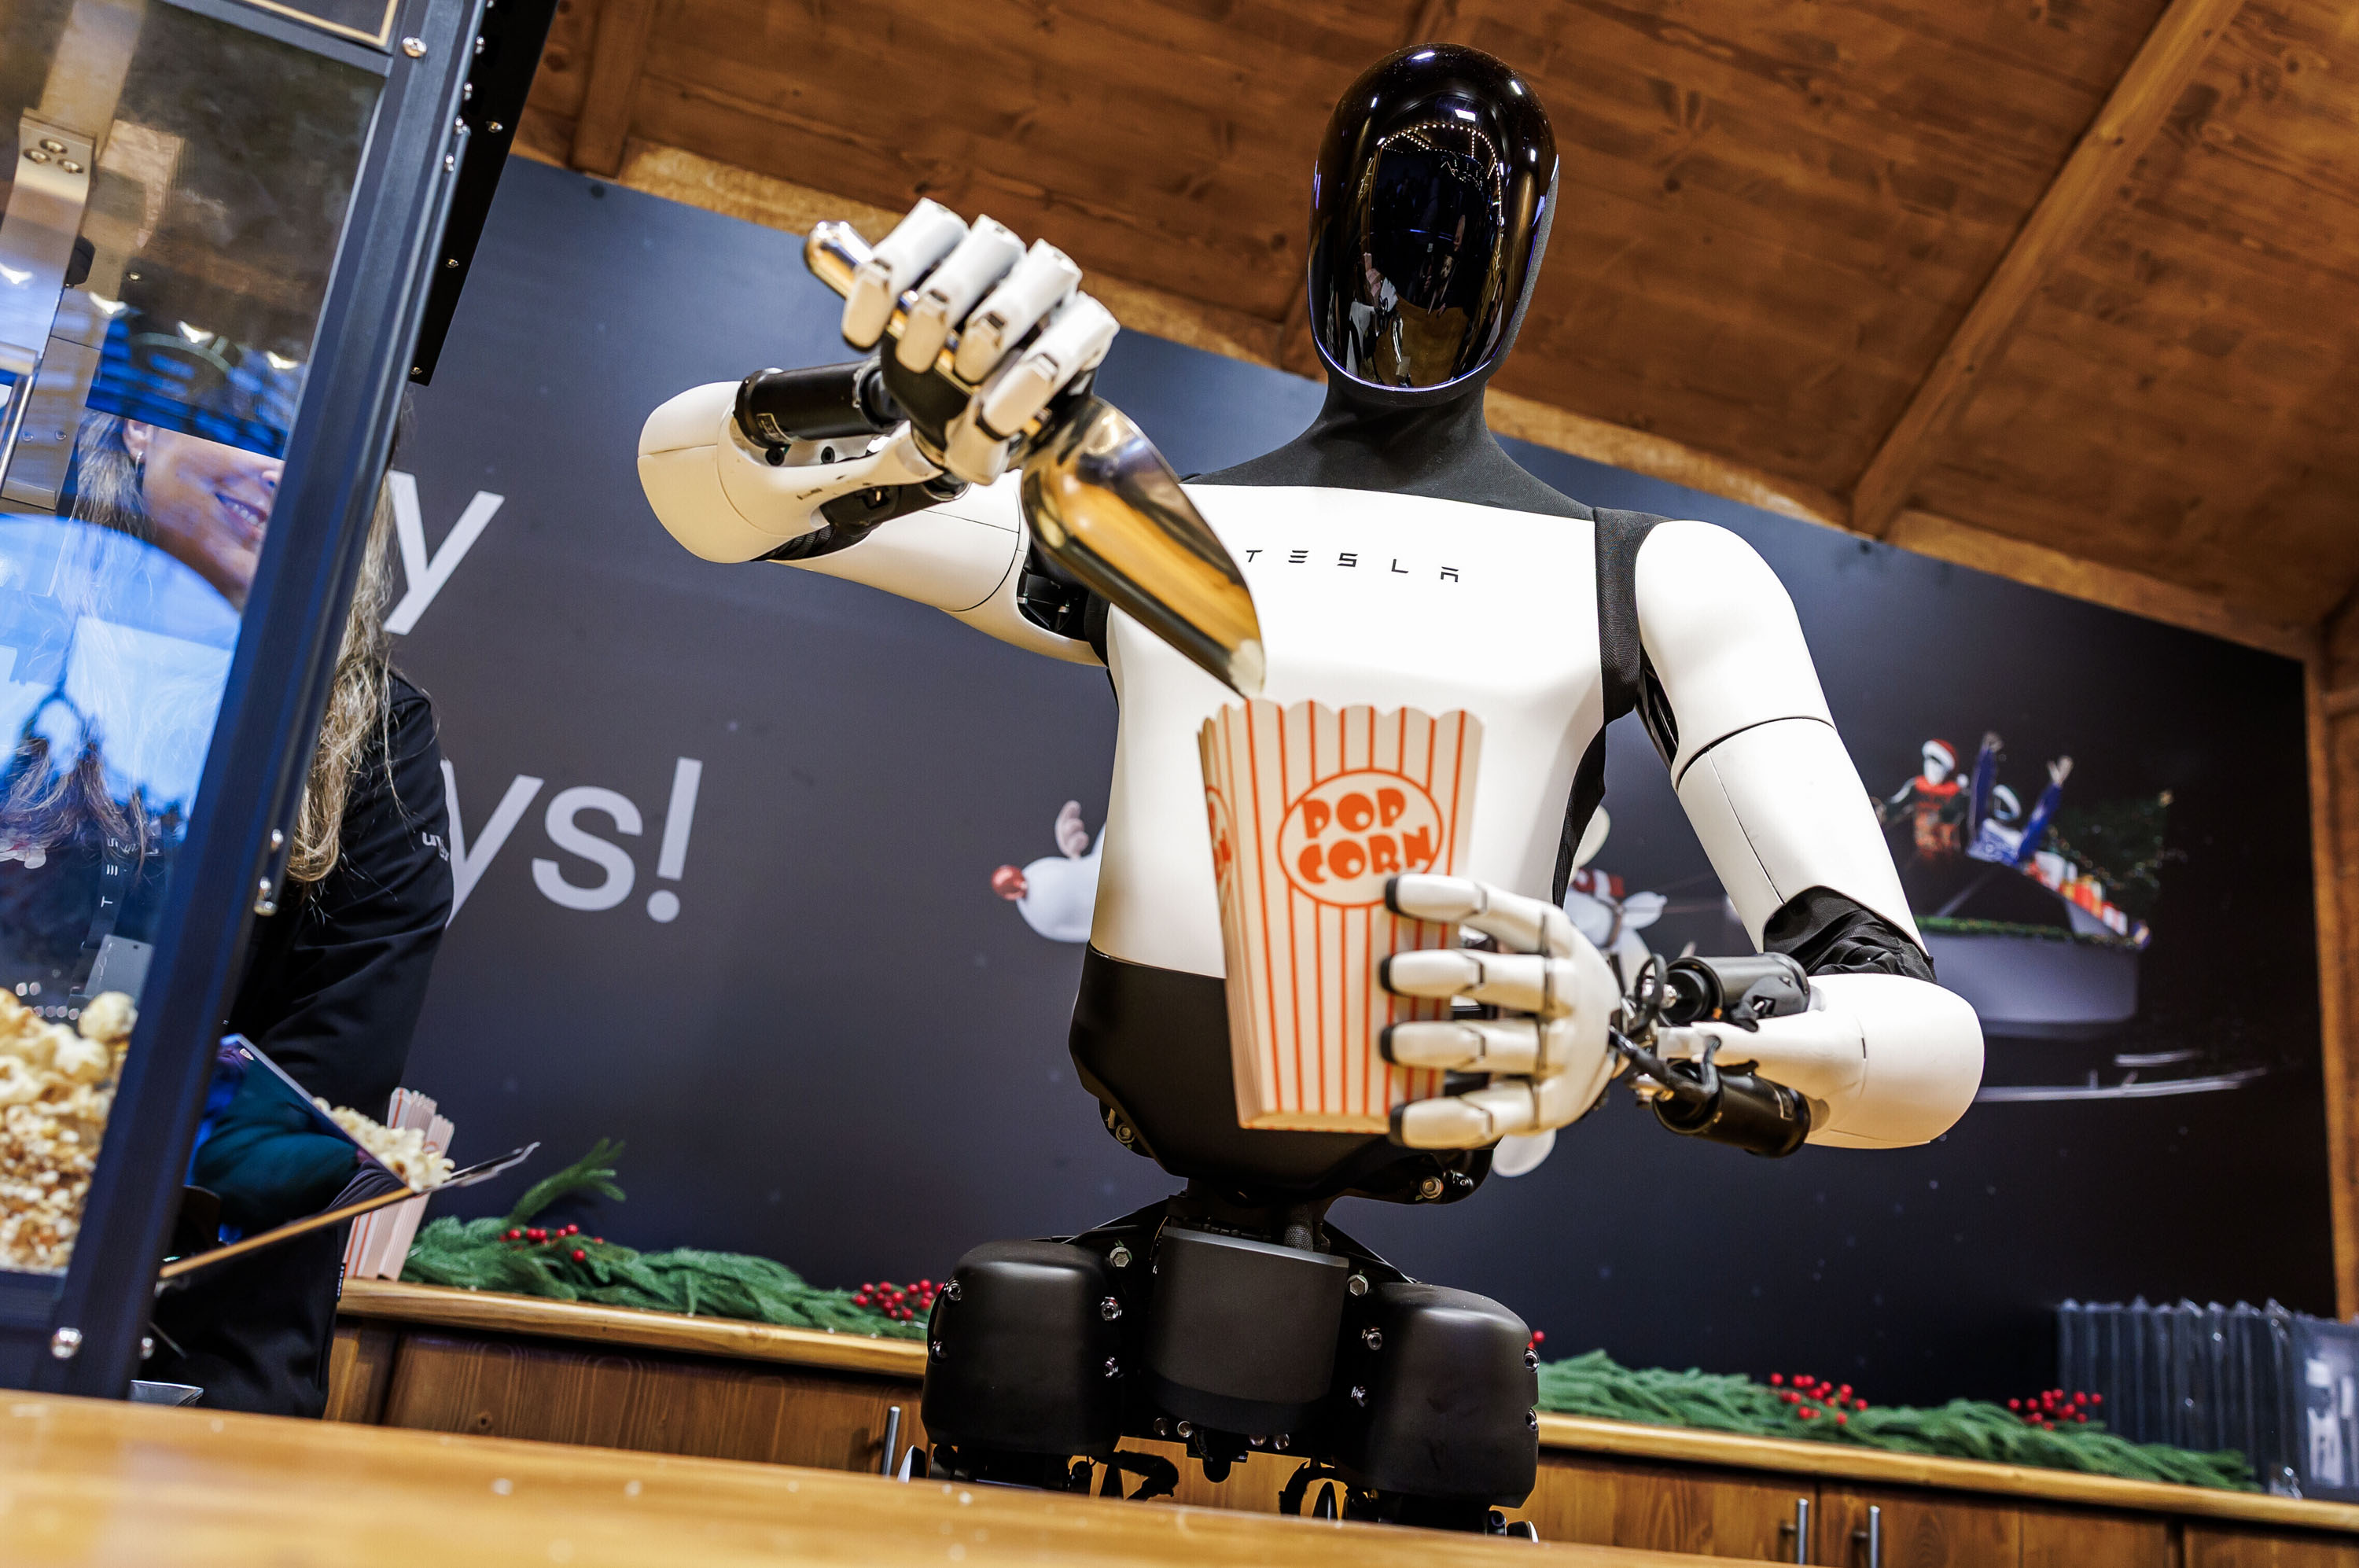
这类宣言在很大程度上源于一种想法:驱动 OpenAI 的 ChatGPT 和 Anthropic 的 Claude 等工具的同款 AI 进步,也将赋予新一代机器人模仿人类动作的能力,正如聊天机器人模仿人类语言一样。但许多机器人研究者对此持怀疑态度,他们指出,这种假设低估了依赖语言和图像构建的智能在掌握物理世界无限变化时所面临的挑战。“建造人形机器人的那些公司——绝对没有一家——知道如何让这些机器人聪明到足以派上用场,”Yann LeCun(常被称为 AI 教父之一)在一月份的达沃斯会议另一场活动中表示。
研究人员还指出,将拟人化机器人与能够学习并执行多项任务的通用机器混为一谈是误导性的。Agility Robotics 联合创始人兼首席机器人官、俄勒冈州立大学机器人学教授 Jonathan Hurst 解释称:“制造一个外观像人的机器人非常容易。但要造出一台在移动、动态行为或物理特性上真正像人的机器,难度要大得多。”
围绕“全能人形机器人是否近在咫尺还是遥不可及”以及“现有的 AI 形态是否足以完善它们”的争论,正在全国各地的机器人实验室上演。时间表上的炒作掩盖了那些艰苦但富有意义的进步。
大约十年前,一系列突破引发了生成式 AI 革命,让长久以来设想的“人工智能”变为现实。机器人学家们虽然对具体时间存在分歧,但相信机器人领域也有可能迎来一场同等变革性的革命,这将赋予机器长久以来难以企及的物理直觉和流畅性。随着机器人领域的进展步履蹒跚,问题在于:驱动 AI 进步的同款方法和技术是否足以达成目标,还是说需要一条全新的路径?
机器人遇上先进 AI
想看看当今最聪明的机器人大脑之一能做什么,不妨关注 Google DeepMind 用一台名为 ALOHA 2 的设备取得的成果。ALOHA 2 是"A Low-cost Open-source Hardware System for Bimanual Teleoperation"(低成本开源双手遥操作硬件系统)的缩写。
通用机器人是否必须具备类人的形态?机器人学界对此争论已久:支持者认为人形有助于机器人融入现有的世界,反对者则认为不值得费这个劲。ALOHA 2 代表的是后一种思路。它其貌不扬,就是两条机械臂、几个夹爪加几个摄像头。但别看它简单,它却是 Google DeepMind 研究人员的主力设备,各家实验室都用它来测试最先进的机器人 AI 系统 Gemini Robotics。
由 Gemini Robotics 控制时,ALOHA 2 就更像一个通用机器人了——它可以基于训练样本完成各种任务。比如让它打包午餐,从相关演示视频可以看到,它能用两个夹爪把一片白面包小心地放进 Ziploc 密封袋并封好口,再把一串葡萄放进保鲜盒、盖上盖子,然后小心地把这些东西移进饭盒,最后拉上拉链。
这顿午餐算不上丰盛,但机器人能把这一切组装起来,相比哪怕三年前的水平,已是实打实的进步。
这在很大程度上要归功于 AI 对所谓机器人策略的影响。机器人策略决定了通用机器人如何感知和理解周围环境、规划如何在环境中移动,进而正确执行任务。
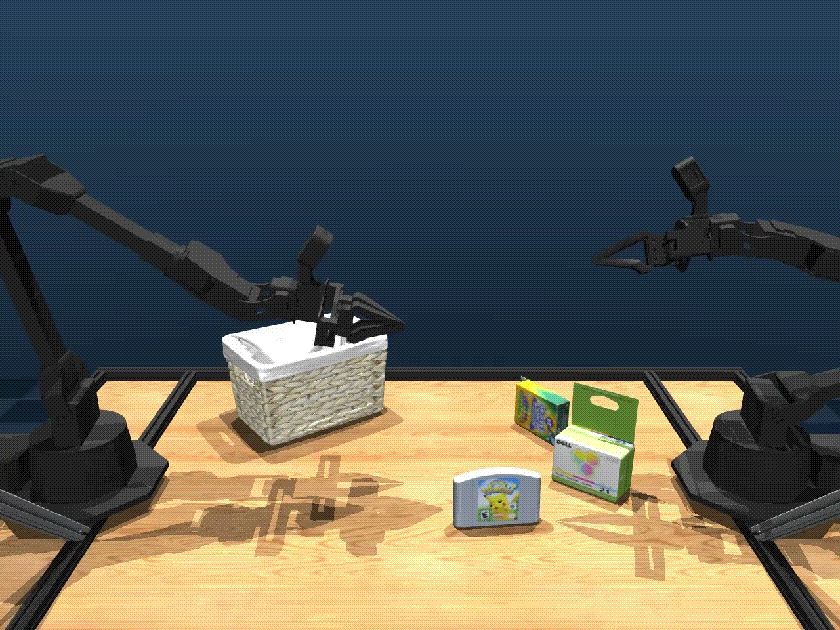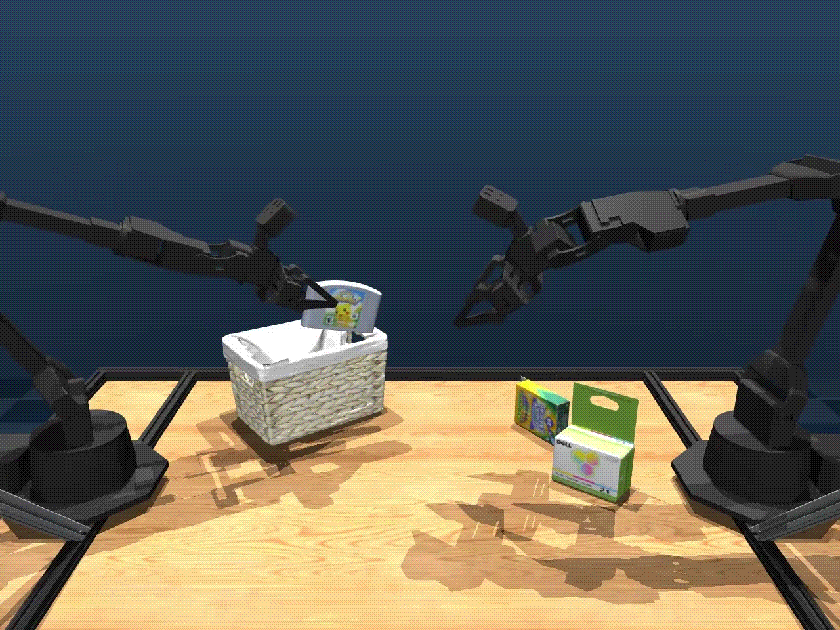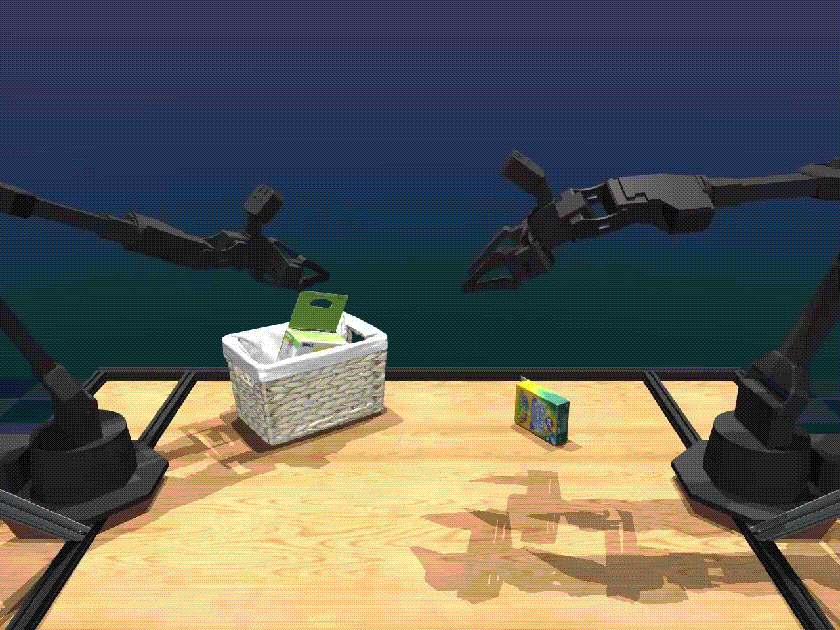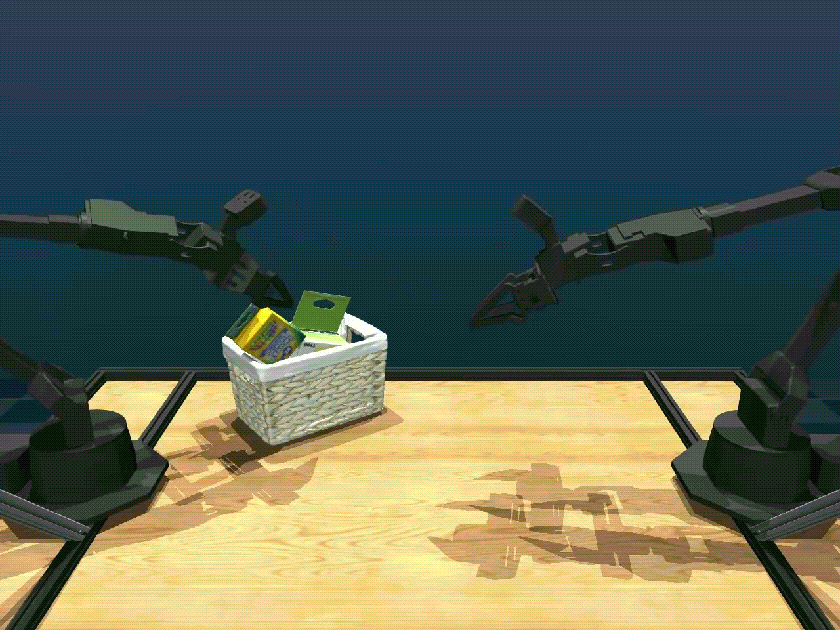
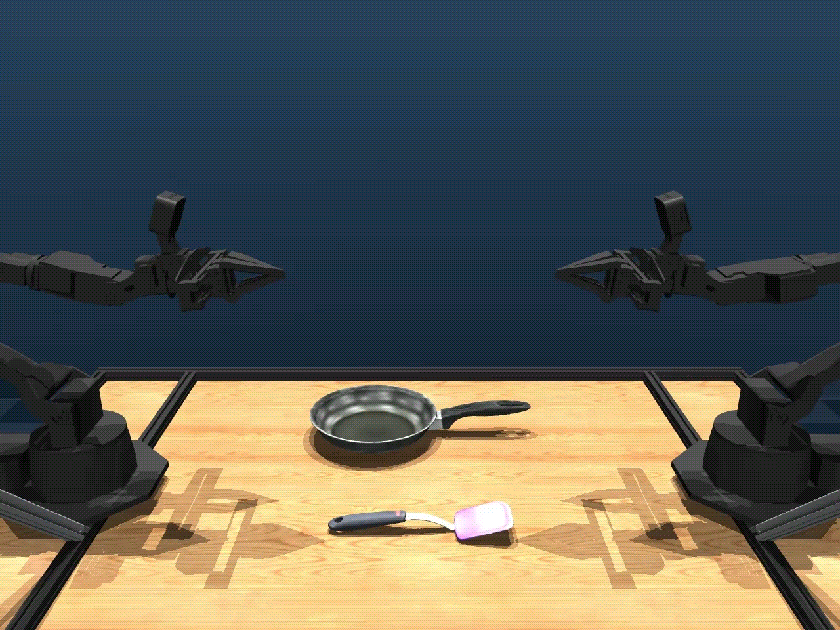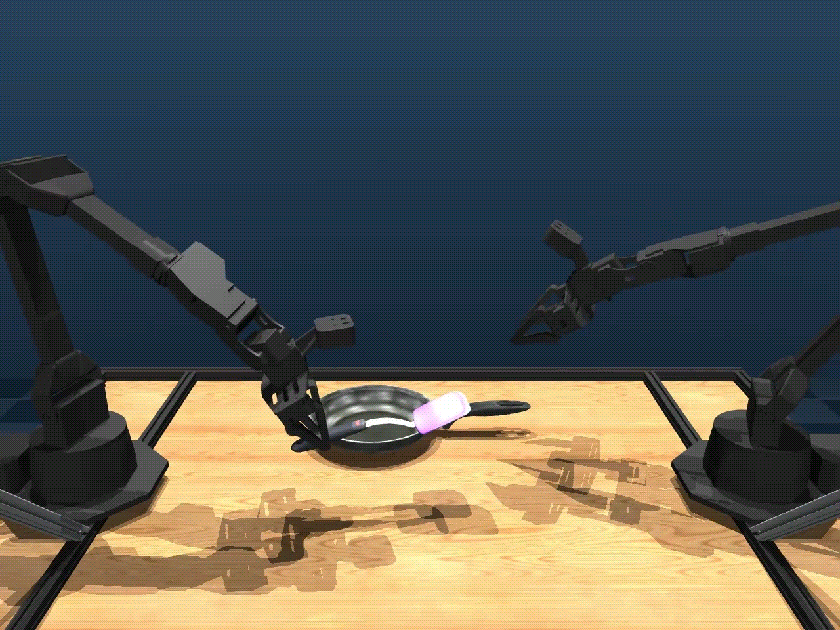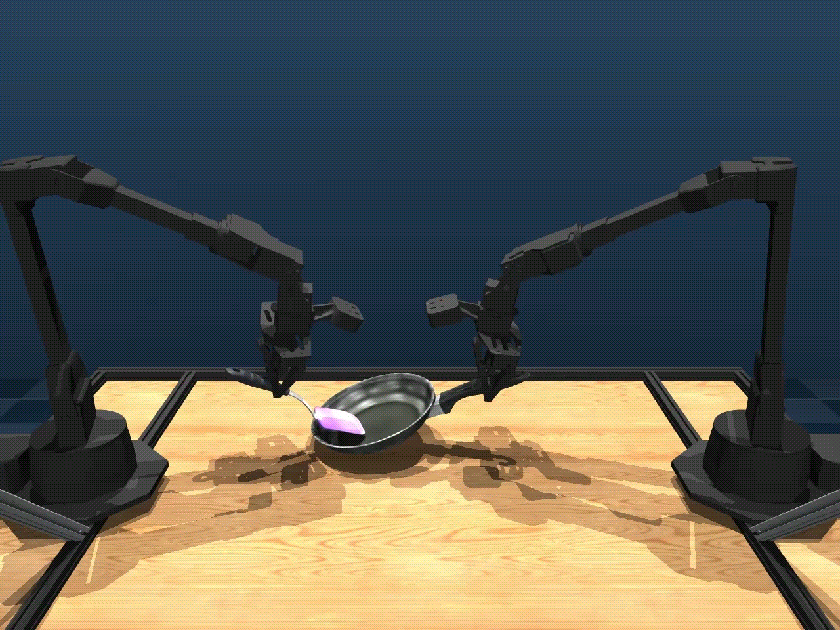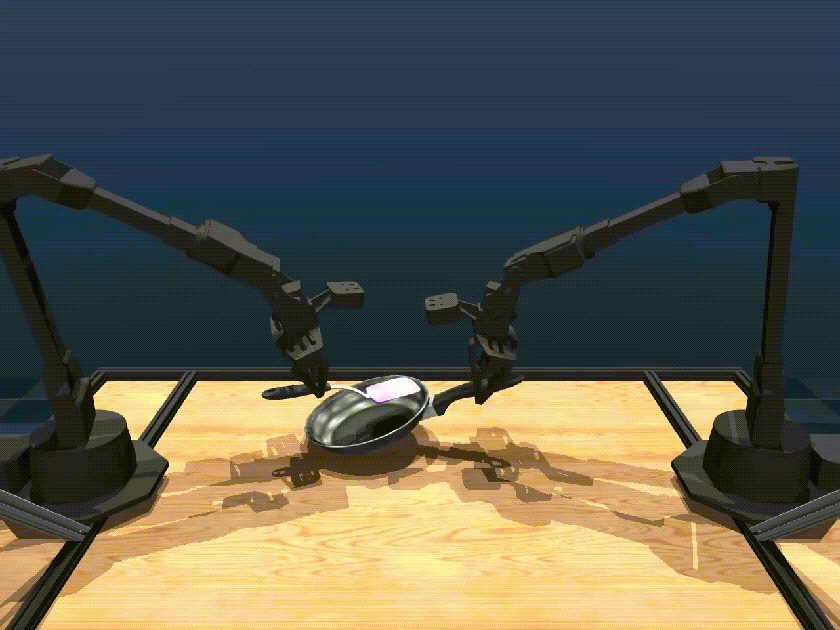
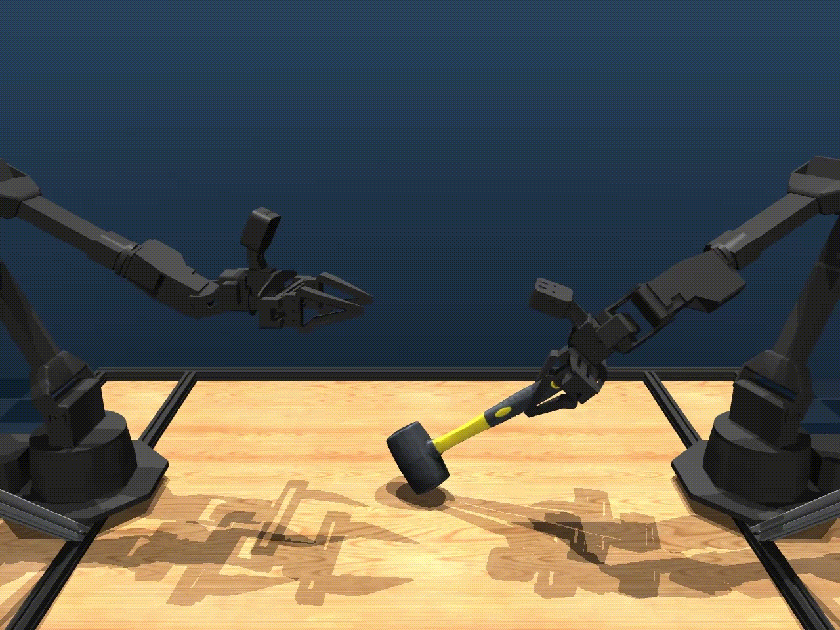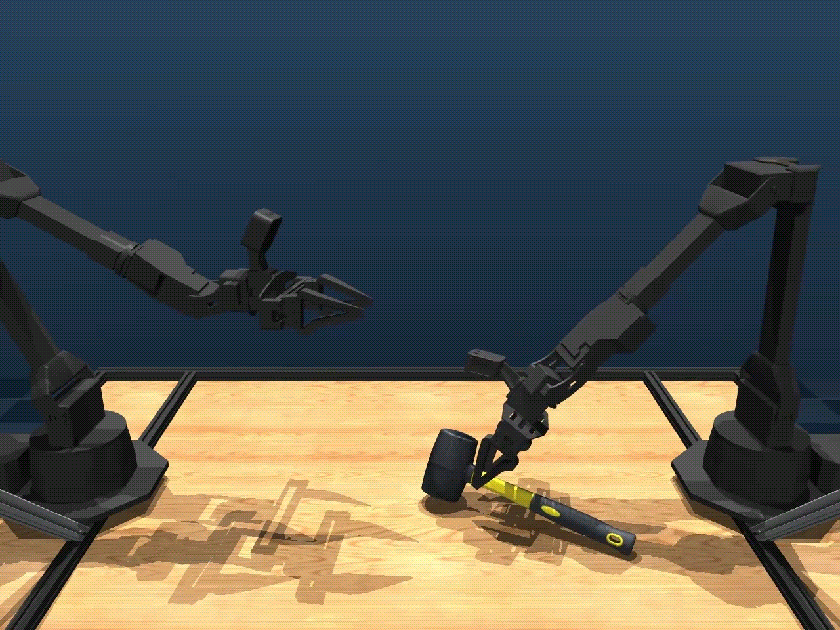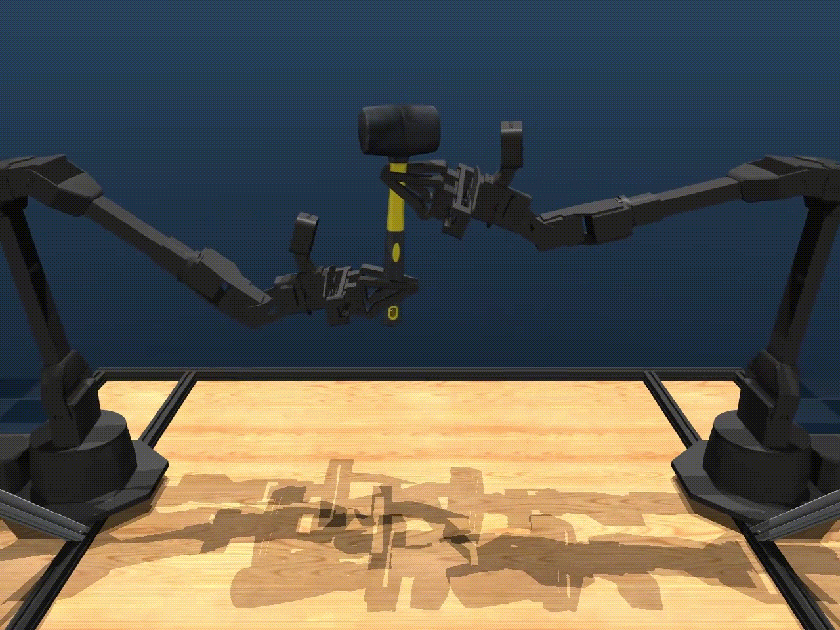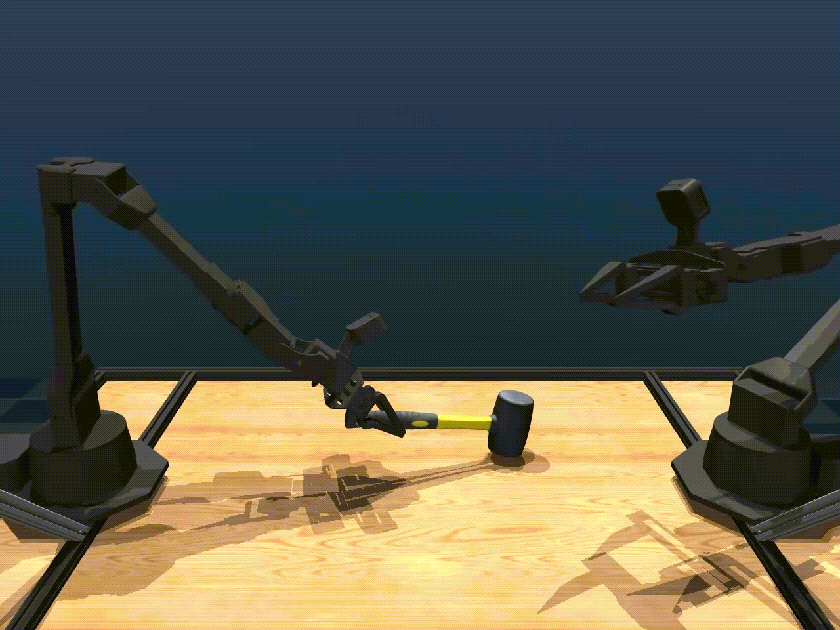
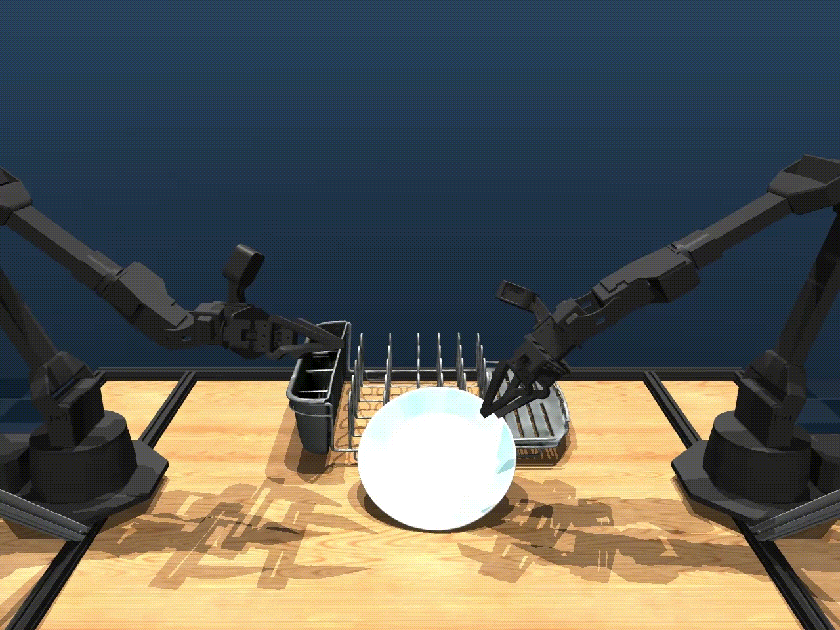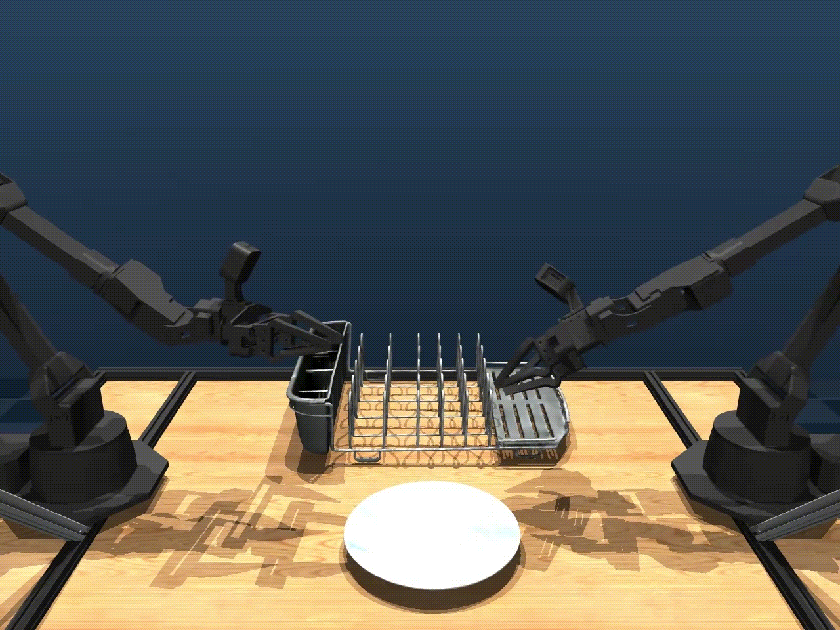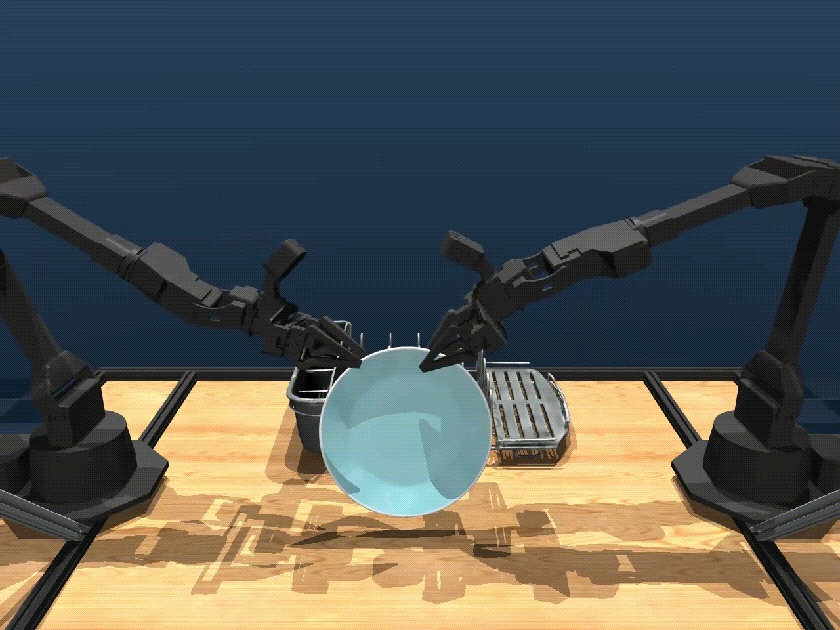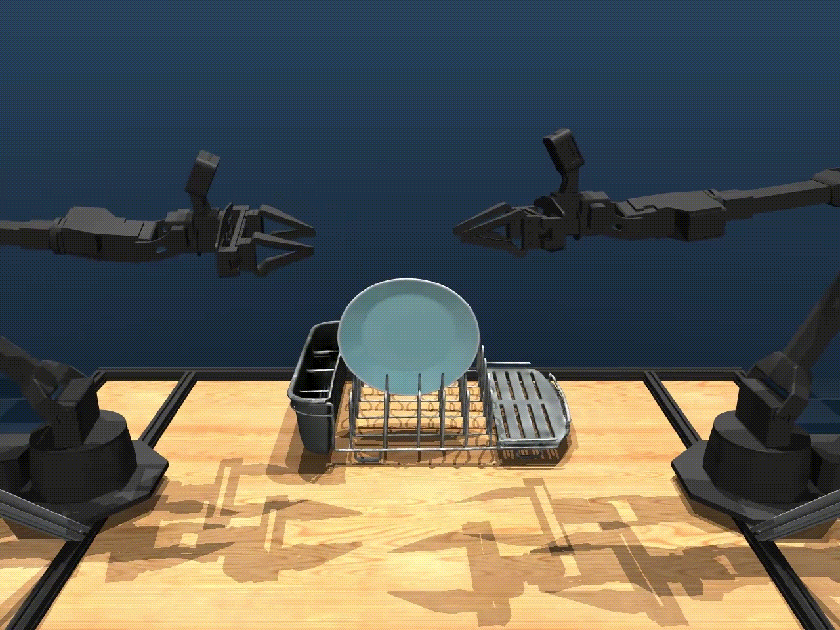
ALOHA 2 机器人看起来不过是台面上的两条机械臂,但它却是测试前沿 AI 机器人模型的平台。这些演示动画基于人类远程操控机器人的数据,这些数据被用来训练 Google DeepMind 的模型。(视频:Google DeepMind / Stanford University / Hoku Labs)
过去,机器人策略依赖工程师手动编写的规则,硬编码在软件中——数千行代码决定机器人在数百种任务中每一毫米的精确动作。但过去几年,机器人策略逐渐交给高级 AI 系统处理,而不再写死在软件里,这正是业界对通用型机器人感到乐观的主要原因。这一转变首先由 VLM(视觉语言模型)推动。这类模型类似 LLM,但额外训练了图像数据。给 VLM 看一张咖啡洒了的图片,让它找工具清理,它能立刻识别出附近的抹布。这种即时理解上下文的能力,在几年前策略还是硬编码的时代是不可想象的。
紧随其后的是视觉-语言-行动模型,它让机器人能够评估所处环境并采取行动。这类模型在原有架构基础上增加了运动指令组件。VLA 的训练数据由一系列与执行特定任务相关的图像或视频,以及机器人手臂如何移动以完成该动作的关联数据组成。这些运动数据通常通过遥操作采集,即由人类使用遥控器引导机器人完成动作。这种训练方式使 AI 学会如何在特定任务中指挥机器人移动和操作。例如,将一台搭载 VLA 的机器人放在书桌前,告诉它“合上笔记本电脑”或“整理耳机线”,它便会观察现场、识别相关物体、规划执行路径,然后挥动机械臂付诸行动——前提是它此前见过类似任务的成功案例。
Gemini Robotics 模型就是一款 VLA,它基于数小时的人类演示视频进行训练,涵盖了极其多样的动作。因此,它也能执行相对复杂的任务,如用厨房夹子夹取豌豆、折纸,或制作一份简易午餐。虽然令人印象深刻,但它存在一个明显的局限:目前,如果要求由 VLA 控制的机器人执行超出其训练集范围的任务,它极有可能失败。
伦敦帝国理工学院的机器人学教授 Edward Johns 表示:“纵观所有任务空间,真正通用的策略应当能够覆盖整个频谱上的任意任务。”然而,如今的 Gemini Robotics 模型只能做到“这里会一点,那里会一点”。
追求真正的通用性
那么,如何让机器人学会做更多事情?通常的答案可能不出所料:用更多数据进行训练。
按照这种思路,数据越多,示例就越多;示例越多,泛化能力就越强。例如,Google DeepMind 希望汇集“尽可能多的数据”,该公司前机器人技术负责人 Pannag Sanketi 如此说道,他目前正致力于自己的 AI 机器人项目。但数据从哪儿来?大语言模型的优势在于拥有海量的现成文本可供训练,而机器人却没有对应的高质量物理操作示范数据池。研究人员有几种弥补办法,但各都有缺陷:一是雇佣大量人工来创建和收集远程操控数据(成本高、耗时长);二是用人类活动的视频来训练 VLA(数据质量较差);三是把机器人部署到真实环境中,再用收集到的数据继续打磨 AI 模型(机器人出了实验室既不安全也不可靠)。Sanketi 认为,最可行的路径是“多管齐下”,综合利用来自所有这些渠道的数据。 但“光靠训练数据就能解决问题”这一信念远非共识。Agility 的 Hurst 称之为“一个从根本上就有缺陷的前提”。 问题在于,现实世界中的任务复杂度会迅速爆炸式增长。比如你想让机器人煮咖啡,变量多不胜数:没有两个厨房是一模一样的;咖啡机的工作方式各不相同;不同的杯子需要不同的握法;咖啡粉、热水和牛奶的处理方式也各有讲究。就连这么简单的任务,也需要理解一张不断变化的可能性清单。Hurst 认为,要靠 VLA 实现泛化,就必须“对其可能做的所有事情实现完整的数据覆盖”——换句话说,需要近乎无限的训练数据。 LeCun 则对整套路线不屑一顾。他在达沃斯表示:“在语言上成功的那些 AI 方法,无法处理高维、连续、含噪声的数据”——而这恰恰是机器人领域最常见的数据类型。“你必须另辟蹊径。”目前最具潜力的“其他路径”是所谓的“世界模型”(world model)。这类 AI 不再主要依赖文本训练,而是基于视频、三维扫描和传感器数据的组合,旨在预测真实世界中行动的后果。其目标是构建具备高保真内部现实表征的模型,能够捕捉物理世界的实际运行规律,包括物体的运动、碰撞、坠落和形变。如果机器人科学家能在忠实还原真实物理法则的模拟环境中训练机器,研发过程将变得更快速、更低成本且更安全,从而减少对真实世界测试的依赖。更具变革意义的是,配备世界模型的机器人能够对其周围环境进行推理,而不仅仅是做出反应,这有助于它们在采取行动前预判后果。
Nvidia 和 Google 等公司正在推进相关技术,投资者资金也源源不断地涌入知名初创企业。由斯坦福 AI 研究员李飞飞共同创立的 World Labs 在二月融资 10 亿美元,并于九月底以 82 亿美元的价格被 AMD 收购。由 LeCun(前 Meta 首席 AI 科学家)共同创立的 AMI Labs 也在三月融资 10 亿美元。但正如业内人士所言,目前仍处于早期阶段。去年年底,李飞飞将这一领域形容为“萌芽状态”,并补充说“基础方法论仍在建立之中”。她在六月的 Substack 文章中描述了令人望而生畏的挑战。眼下,世界模型更像是一个充满希望的研究领域,而非通往通用机器人的即时捷径,但我们已开始看到其潜力的初步曙光。
其中一次颇具启示意义的突破发生在上个月旧金山的一间机器人实验室,虽然规模不大,但可能意义深远。
是突破吗?
在旧金山使命区(Mission District)的中心地带,初创公司 Physical Intelligence(简称 PI,源自数学符号 π)正专注于开发一个通用大脑,从理论上说,这能让任何机器人变成多面手。该公司采用一种“大杂烩”式的训练策略,为机器人 AI 模型构建涵盖几乎所有领域的数据基础,最近他们捕捉到了一些迹象,展示了配备世界模型(world model)的机器人大脑所能达到的能力。 2024 年,PI 公开了详情,介绍了其首个通用机器人系统,命名为 π0。这是一种 VLA(视觉-语言-动作)模型,公司宣称它是“迄今能力最强、操作最灵活的通用机器人策略”。该模型最初基于一个包含 1 万小时自有数据的集合进行训练,这些数据是通过遥操作采集的人类演示,同时也混合了多个开源机器人数据集。2025 年春季发布的版本 π0.5,则训练于更广泛的数据集,包括来自网络的标注图像,使其通用性更强。2025 年秋季更新的 π0.6,则为该模型增加了强化学习机制。 每次更新都带来了模型性能的重要提升,其能力清单从缓慢地折叠衣物,扩展到在陌生环境中整理物品,以及以更高的成功率完成折叠纸箱等任务。随后,在 2026 年 4 月,π0.7 的出现似乎将 PI 推向了新领域。这个版本利用了一个算力需求更低的世界模型,用于生成执行任务所需的步骤图像。当机器人执行任务时,这个“轻量级”模型会实时向它提供下一步动作的快照。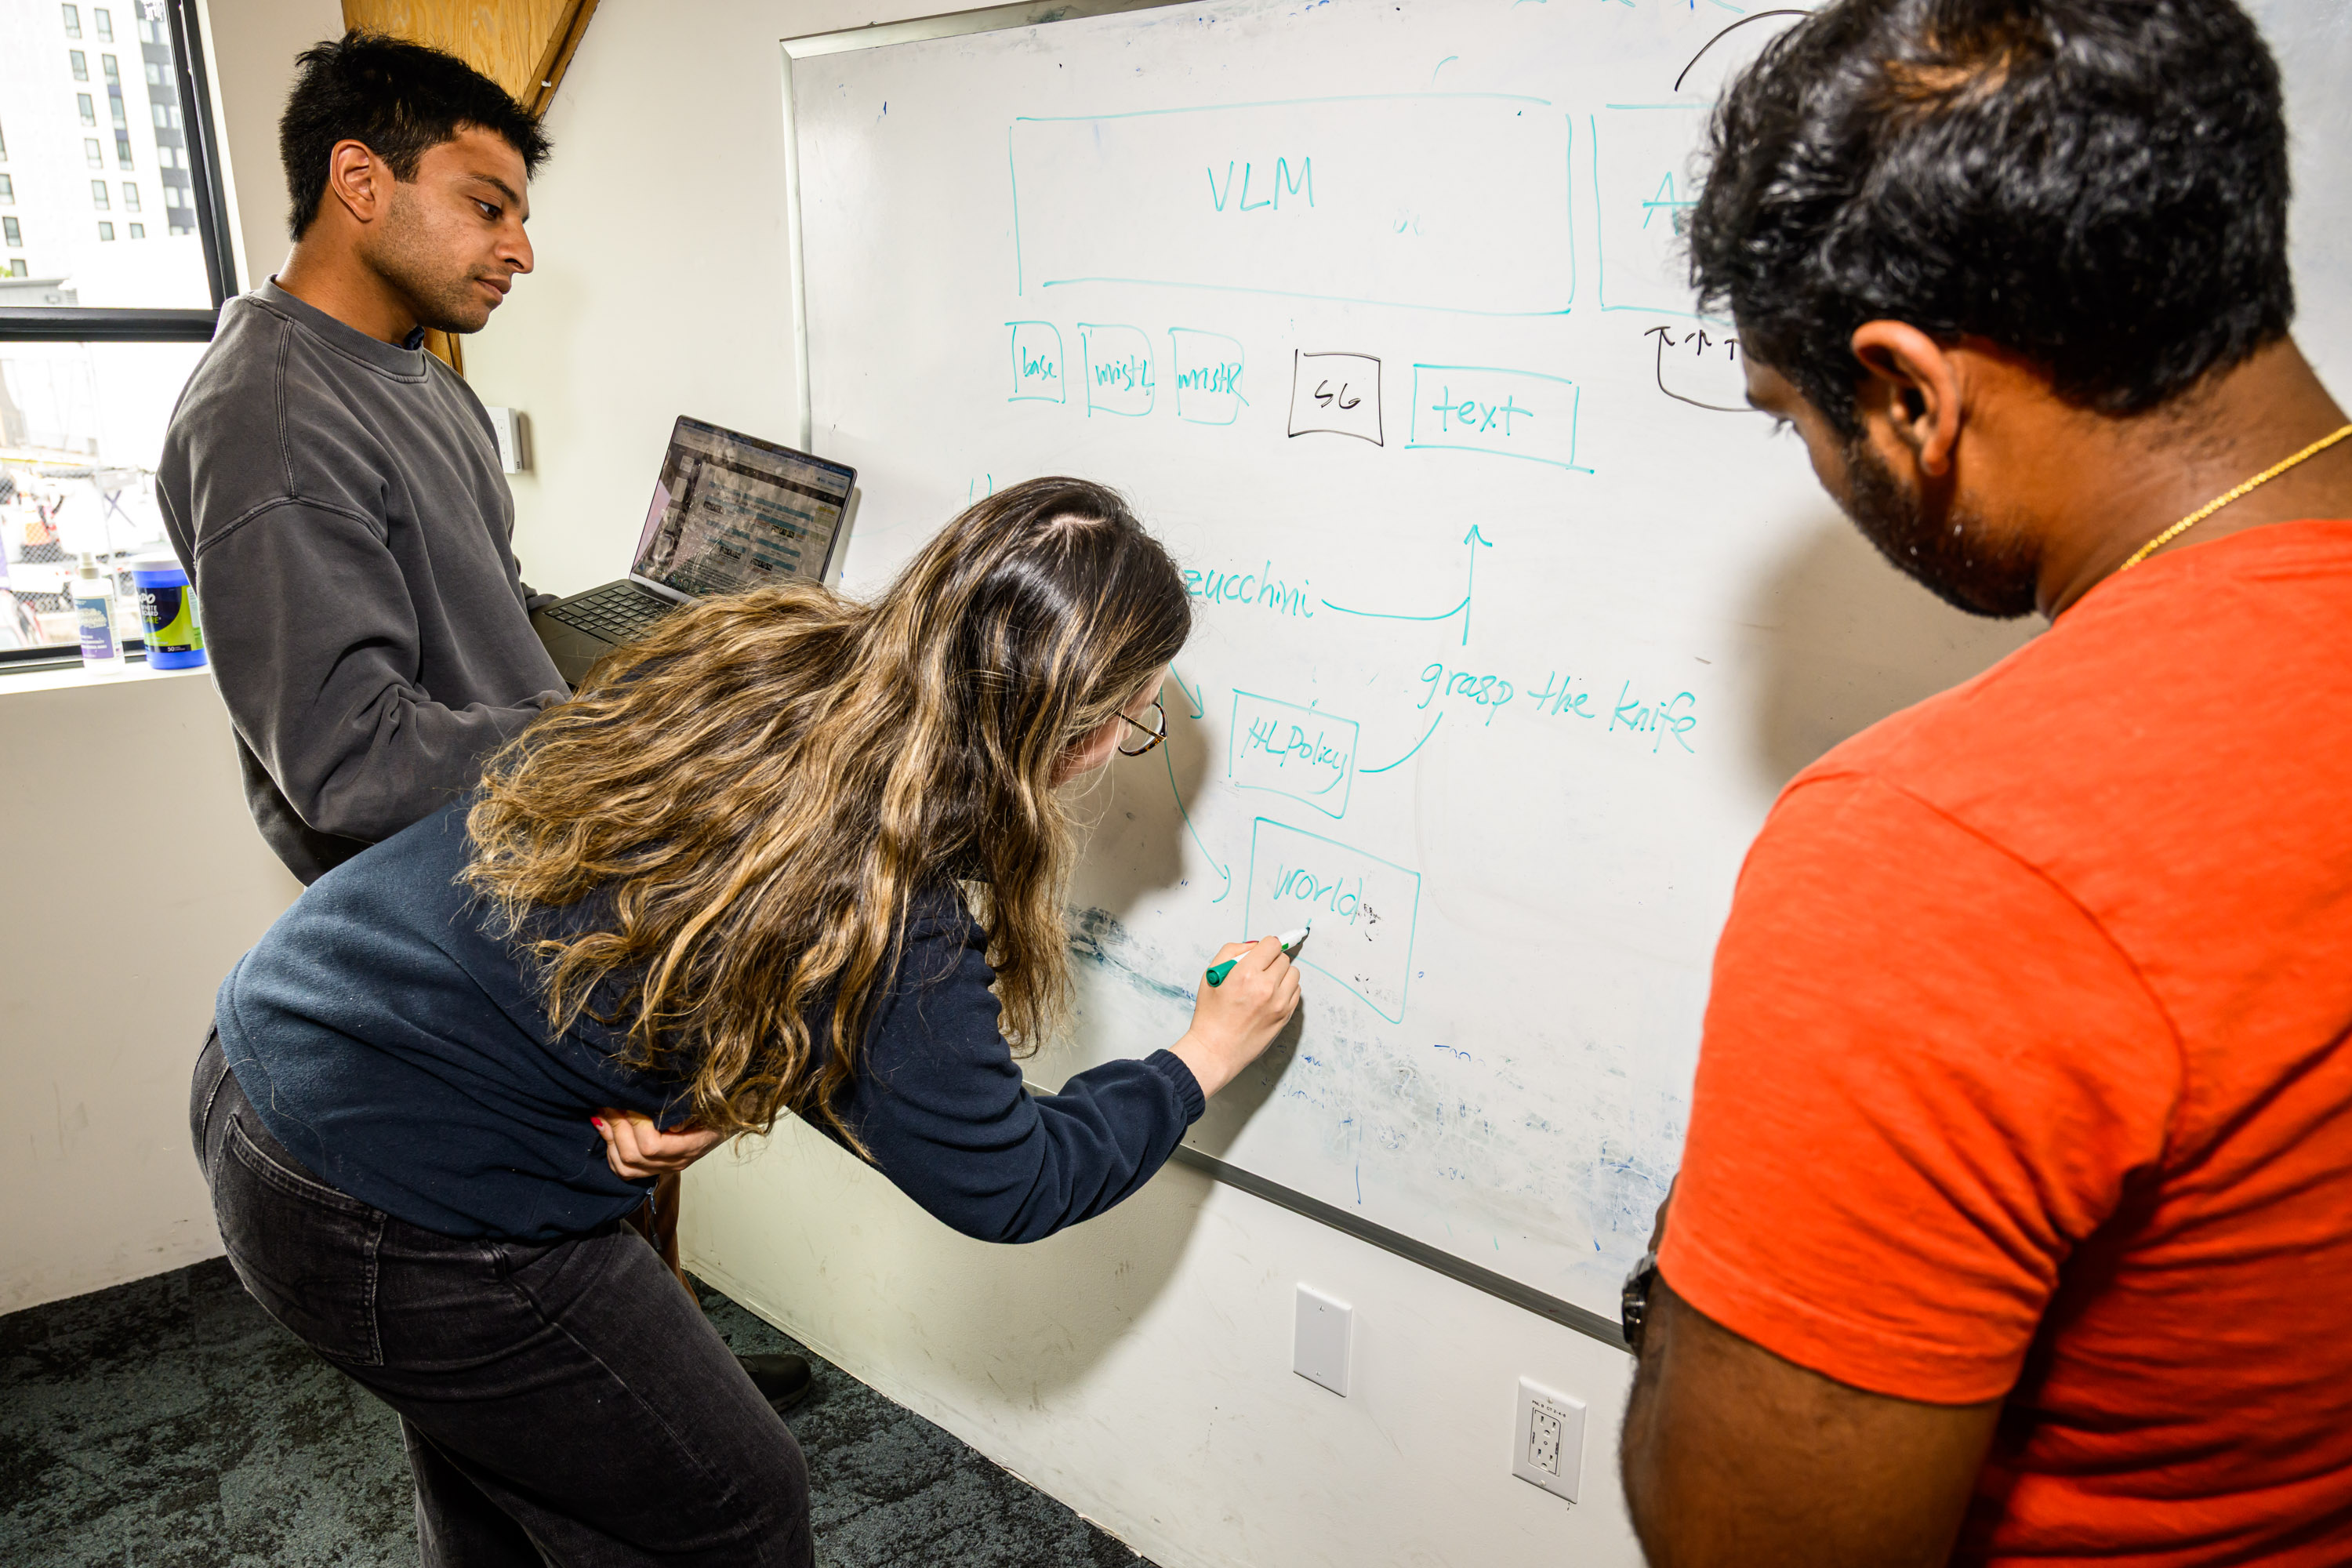
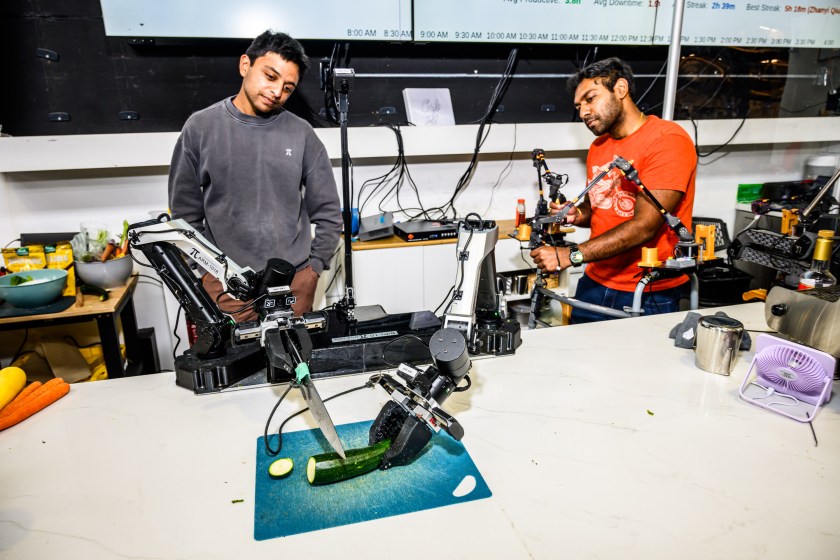
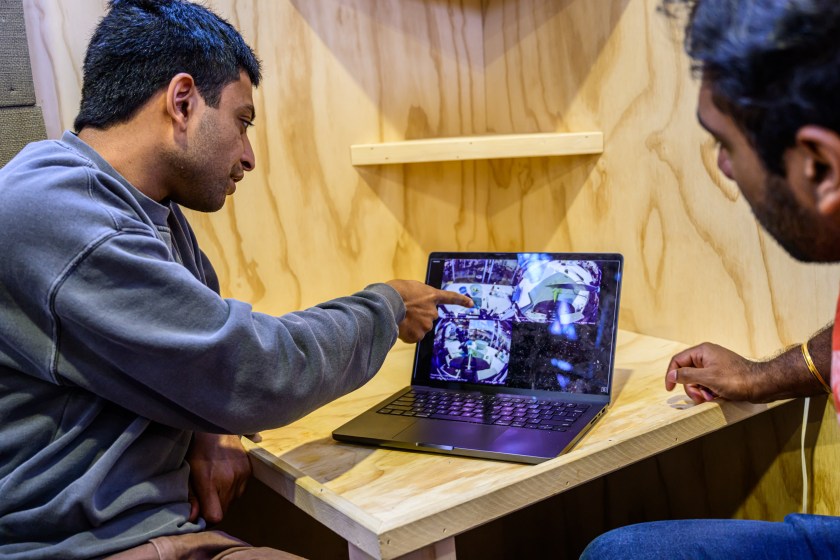
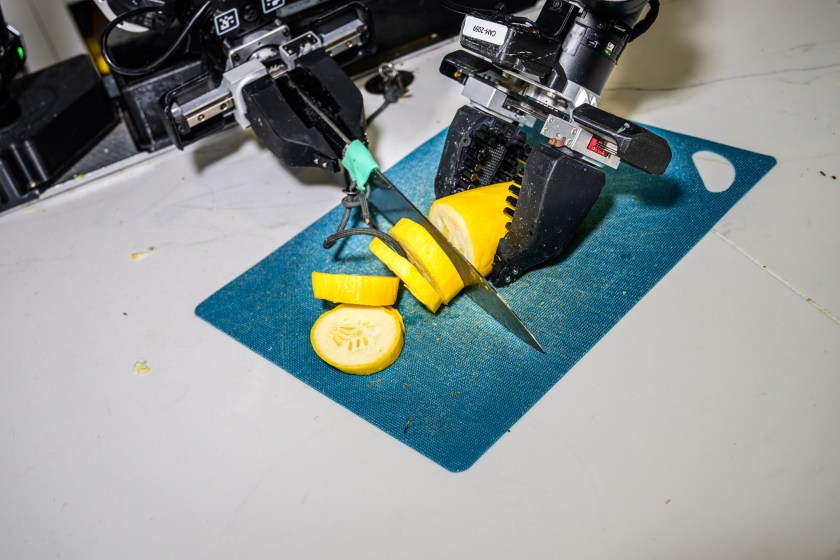
该公司称,这个模型已展现出组合泛化的初步迹象——所谓组合泛化,指的是 AI 系统能够把训练数据中学到的技能重新组合,从而完成从未接触过的任务。其中一项测试是让模型“把红薯放进空气炸锅”,这是它此前从未见过的任务。在演示视频里,机器人先是摸索了一阵,几次起步失败,最后总算做出了像样的尝试,尽管没能彻底完成任务。
加州大学伯克利分校教授、PI 联合创始人 Sergey Levine 对这一潜力感到兴奋:“这是我们第一次令人信服地看到组合泛化能力——我们可以让模型完成那些我们既没有专门收集数据、也没有针对性训练的任务,而它竟然能做出还过得去的尝试。”
这一成功促使团队好奇模型是如何做到这一点的。经过深入挖掘,他们发现训练材料中隐藏了一些相关的标注遥操作数据片段,包括两个示例:人类操作员使用机器人将空气炸锅炸篮推入炸锅。这些零碎的数据可能就足以让 π0.7 几乎完成炸红薯的任务。
目前,π0.7 的泛化能力究竟有多令人印象深刻仍不确定。不过,鉴于模型接触空气炸锅的经历非常短暂,这依然让我们得以窥见前沿研究当前能将机器人带向多远的未来。
“70% 的成功率就像没成一样”
你可能已经察觉到,机器人在实验室里迈出的蹒跚起步——“看!它把红薯放进空气炸锅了!”——与许多演示和视频中所展示的惊人、逼真的灵巧动作之间存在着脱节。在这些演示中,机器人被看到能跳从舞台上跳舞到礼貌地提供酒水等任何事情。此类演示往往没有清晰揭示一个关键事实:在许多情况下,是人类在控制机器人,或者已经仔细编排了其动作。(例如,2025 年 3 月与 Nvidia CEO Jensen Huang 同台亮相的那个机器人,看似在回应他的指令并跟随他移动,实际上是由其制造商所称的“幕后提线木偶师”通过遥控驱动的。)
目前,让机器人实现完全自主的运动规划——特别是在建筑工地或陌生家庭等全新且混乱的环境中——仍是一个 largely 未解决的难题。一个更大且往往与之相关的挑战在于,让机器人胜任规模更大、任务更模糊的工作,这类任务涉及多个子步骤,并要求机器人决策执行方式和顺序。这就是一个能把盘子放进微波炉的机器人,和一个能真正理解“做晚饭”指令、通过查看冰箱、切配食材、开火烹饪来完成的机器人之间的区别。Google DeepMind 此前在这方面的尝试——比如让机器人查看厨房并将蘑菇烩饭所需的所有食材装进篮子——迄今为止以失败告终。
这给实用型机器人提出了更严苛的要求:它基本上必须每次都能做对。Boston Dynamics 创始人 Marc Raibert 说:“在使用 VLA 时,人们看到成功率从 50% 提升到 70% 都会非常兴奋,‘但 70% 的成功率实际上意味着它根本不可靠,对吧?’”
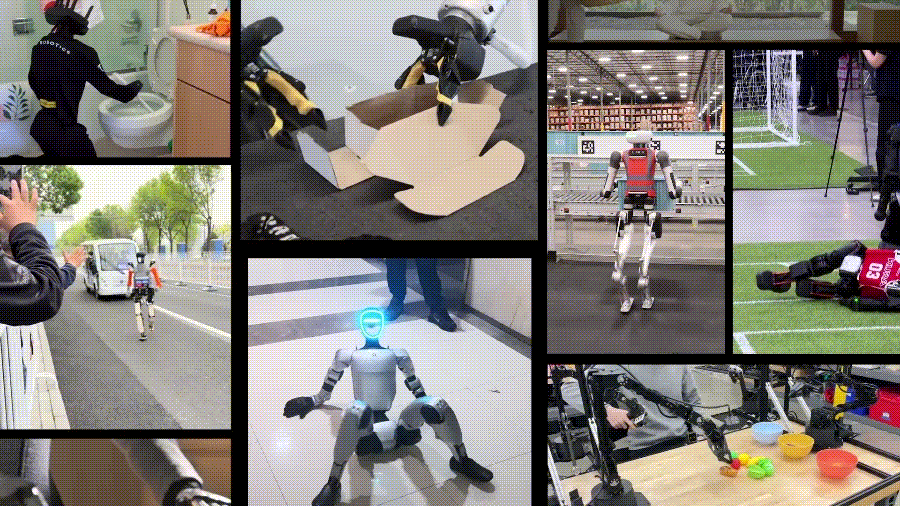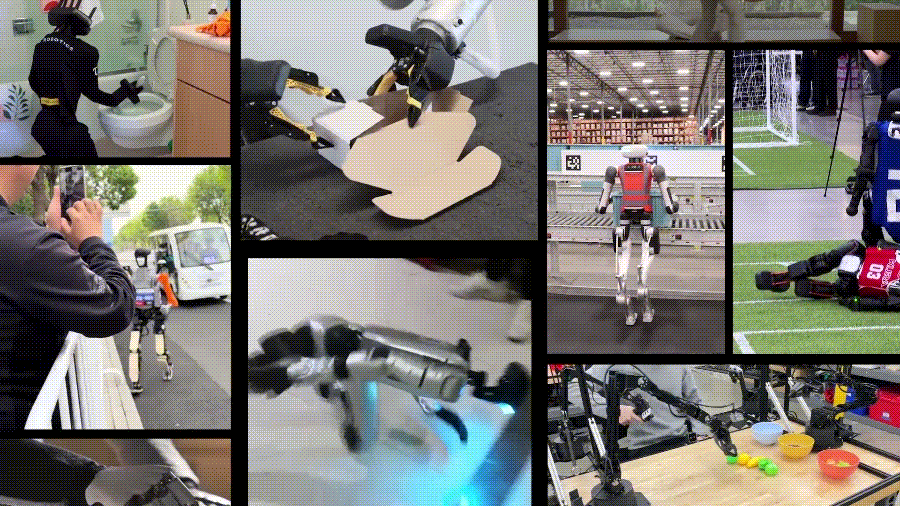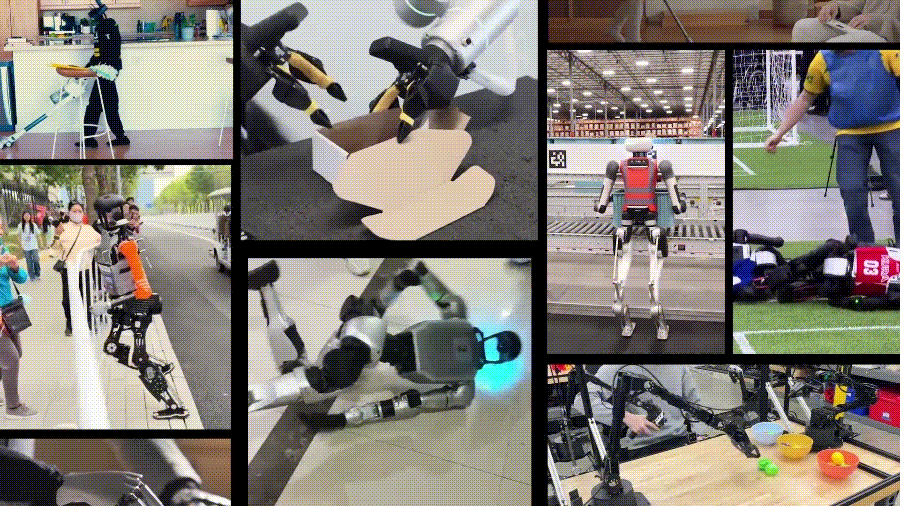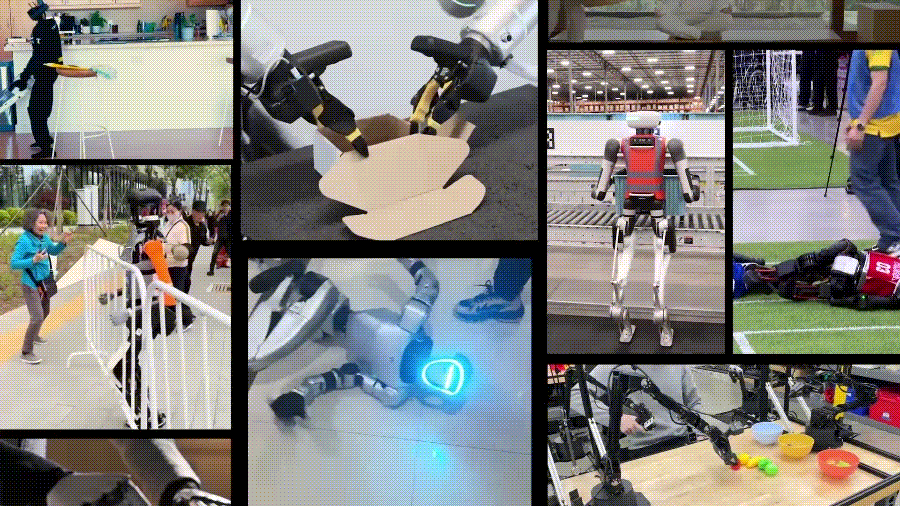
目前在真实环境中测试的人形机器人屈指可数,而且都是在严格受控的环境里执行极其有限的任务,离通用机器人还很远。据 Agility 公司介绍,他们已有数百台机器人在 GXO Logistics、亚马逊和舍弗勒的设施中开展试点。但 Hurst 表示,这些机器人目前只能承担搬运箱子和周转箱之类的简单任务。他补充说,即便是做到这一点,也花了好几年时间才让机器人达到物流公司愿意考虑使用的安全标准。Elon Musk 曾在 2025 年 5 月声称,到年底将有“数千台”Optimus 机器人在特斯拉工厂工作,但今年 1 月他又改口说,公司只有“一些 Tesla Optimus 机器人在工厂里做些简单任务”。
人形机器人虽然开始走进工厂车间,但要进入家庭,难度只会更大。眼下如果你愿意,可以预订 1X Neo 家用机器人,预计今年晚些时候交付。这台售价 2 万美元的机器人承诺帮你搞定“家里那些无聊又琐碎的活儿”——收纳餐具、应门、整理客厅——“让你专注于真正重要的事”。设计目标是让这台身高五英尺六英寸的机器人有朝一日能自主完成所有这些任务,但目前它在做大多数事情时仍需要远程的人类操作员来操控。(没错,操作员窥探你家时需要经过你的许可。)被问到完全自主的机器人还要多久才能胜任家务时,Hurst 说:“如果非 要给个数字,我认为还需要 10 年,机器人才能在人们的家里……真正派上用场。”
一旦这一天到来,这些机器人很可能产自中国,因为中国在产能上已大幅领先西方。市场情报公司 Omdia 和中国人形机器人公司 Unitree 的数据显示,2025 年出货的人形机器人中,约 90% 均由中国企业制造,总数约为 1.5 万台。Unitree 是去年出货量最大的人形机器人制造商,其一款机型 售价不足 6,000 美元。如此亲民的价格有望极大提升消费者对机器人的兴趣,不过该公司 预计 这些机器会先应用于工业领域。(顺便一提,如果你好奇这些中国机器人买主是谁,美联社最近报道称,订单主要来自企业、学术实验室及国有企业。)
这一幕似曾相识
打造人形机器人的梦想由来已久:早在 1495 年,列奥纳多·达·芬奇就绘制了机械骑士的设计图,通过绳索和滑轮进行操控。整个 20 世纪,那些充满科幻狂想色彩的机器时隐时现。
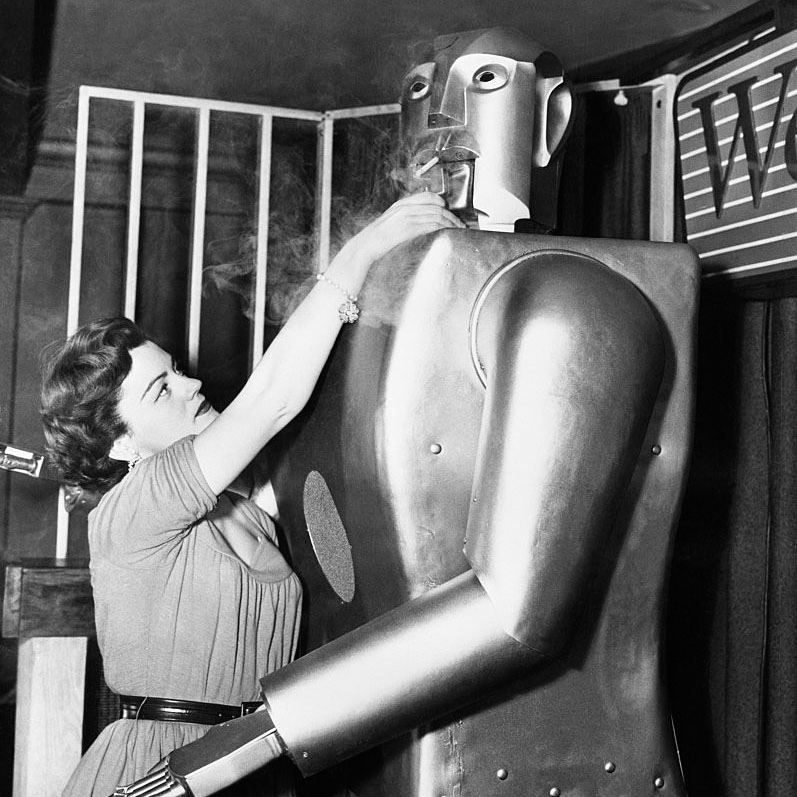
西屋电气公司那台身高七英尺、长着腿的盒子机器人 Elektro,现身于 1939 年纽约世界博览会,还会上香烟。日本早稻田大学于 1973 年制造的 WABOT-1 是世界上首台全尺寸、可编程的人形机器人。本田公司在 2000 年发布的 ASIMO 可能是首个证明自身具备实用能力的此类机器——它至少在一定程度上能够爬楼梯、识别人脸,并自主在空间中移动。但 ASIMO 于 2018 年停产,因为它无法在演示功能之外取得足够进展,从而变得真正有用。
当时,这些成就都令人印象深刻,甚至堪称惊世骇俗的工程壮举。但没有任何一款机器人准备好应对真实世界。如今,即便拥有先进人工智能的变革性力量,当前机器人仍面临同样的生存挑战。