
谷歌发布 Flash TTS 模型:用文字描述从零设计 AI 语音
核心要点
- 谷歌发布了 Gemini 3.8 Flash TTS 和 Flash-Lite TTS 两款新型语音合成模型,支持超过 100 种语言。Flash TTS 可通过文本描述创建全新语音,其语音克隆功能则能基于 30 秒音频样本构建语音档案。
- Flash TTS 主要面向播客、有声书和游戏角色等创意应用场景;Flash-Lite TTS 则专为大规模低成本语音生成设计,适用于配音、音频内容及语音智能体。
- 两款模型均支持为每句台词添加舞台指示、双声部对话以及笑声、叹息等非语言声音。它们将通过 Gemini API 和 Google AI Studio 推出,Gemini Enterprise API 的访问权限也将随后开放。
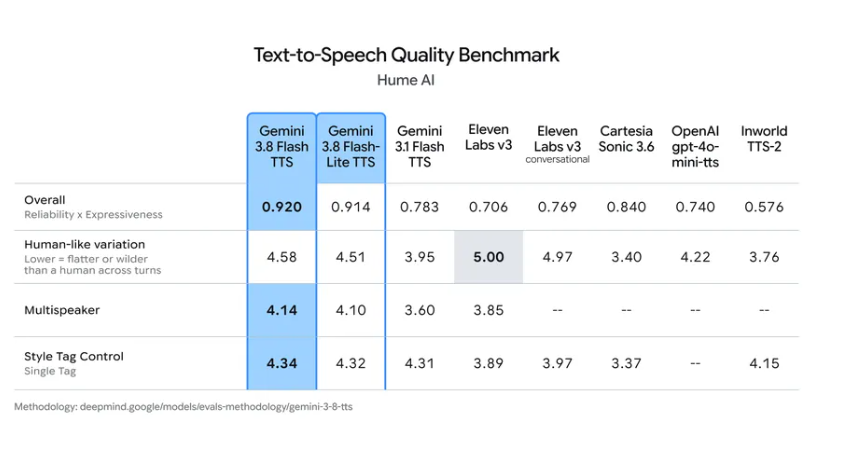
谷歌推出 Gemini 3.8 Flash TTS 和 Flash-Lite TTS 两款新型语音生成模型。Flash TTS 能通过文本描述创建全新语音,两款模型均支持 100 多种语言,并允许用户为单句对话添加舞台指示。
据谷歌介绍,Gemini 3.8 Flash TTS 专为游戏角色、有声书和播客等创意项目设计;Gemini 3.8 Flash-Lite TTS 则聚焦于大规模低成本语音生成,服务于配音、音频内容及语音智能体等场景。
Flash TTS 允许用户通过文本描述创建语音
借助 Gemini 3.8 Flash TTS,用户可以从零开始设计语音。谷歌表示,文本提示可定义特定角色、口音及发声特质,涵盖广泛的语言和方言。对于不想从头开始的用户,谷歌提供包含 2000 多种预设语音的资源库,其中包括墨西哥西班牙语、魁北克法语和苏格兰英语等地区变体。
语音克隆功能可基于 30 秒音频样本构建语音档案。使用此功能时,被克隆者必须录制一段口头的同意声明,且录音中的声音需与样本一致。Gemini 音频模型生成的每一段音频都带有不可听见的 SynthID 水印,以辅助识别 AI 生成的语音,据谷歌介绍。
Google 还宣布了"Voice Remixing"(语音混音)功能,用户可以调整语音库中声音的音色、音高、语速和口音,但目前尚未上线。
脚本指令让用户掌控对话和表达方式
这两款模型都允许用户为每句台词编写指令,也可以让模型自行解读脚本提示。Google 表示,模型可以生成数小时的音频,且几乎不会出现"说话人漂移"(speaker drift),也就是说声音随时间变化极小。
据该公司介绍,双语音模式可以基于单份脚本生成对话,同时保持两个声音各自独立。用户还可以在脚本中标注笑声、叹气以及"嗯哼"之类的语气词,把反应和停顿精确安排在想要的位置。
在我自己的两次测试中,我使用了一个预设声音,并通过风格提示词让它模仿一位说英语时带浓重德国口音、一脸不耐烦的柏林人。风格控制确实生成了颇具说服力的口音和语调,但两次测试都出现过背景中的高频尖啸声。其中一次测试里,声音在片段末尾还发生了变化。
风格提示词:一位来自柏林的德语母语男性,以英语为外语说话,带有浓重、不容错认的德国口音。他显然不是英语母语者:他按德语方式发音英语单词,把德语的节奏和语调套用在英语句子上。"Th"发成"z"或"d"("ze"、"sink"、"dat"),"w"发成"v"("vat"、"vell"),词尾辅音变得更硬("goot"、"bat"表示"bad")。"r"是喉音、含混的,绝不是英语的"r"。元音扁平短促,缺乏美式或英式英语的柔和感。
嗓音带鼻音且略显紧绷,音域居中,带着沙哑的颤音和类似 Kermit 的抖动,但更粗粝、不像木偶。听起来像一个凌晨两点疲惫不堪的柏林人。
表达方式:语速快、简短、断断续续。他在寻找英语单词时会短暂停顿,有时直接生硬地插入德语单词而不翻译。偶尔会出现恼怒的音调上扬。语气干涩、讽刺、无动于衷,还带着点不耐烦——烦的是他竟然不得不解释这些事,更烦的是还得用英语解释。
谷歌开始推出两款模型,企业级 API 访问随后上线
谷歌正通过 Gemini API 和 Google AI Studio 推出这两款模型。Flash TTS 也可在 Gemini Notebook 中使用,而 Flash-Lite TTS 则可在 Google Vids 中获取。谷歌表示,两款模型随后将通过 Gemini Enterprise API 提供访问权限。
Agora、LiveKit、Pipecat 以及 Vercel 等开发者平台已支持通过 Gemini API 进行集成。谷歌尚未列出新模型的地区节点,尽管此前的 TTS 模型提供欧盟数据支持。
根据谷歌的说法,免费层的数据将用于改进其产品,而付费层的数据不会。 付费价格以每百万美元 token 计价,输入计入文本 token 费用,输出计入音频 token 费用。
| 计费项 | Flash TTS(截至 2026 年底) | Flash TTS(2027 年起) | Flash-Lite TTS(截至 2026 年底) | Flash-Lite TTS(2027 年起) |
|---|---|---|---|---|
| 文本输入 | 0.50 美元 | 1.00 美元 | 0.50 美元 | 1.00 美元 |
| 音频输出 | 9.00 美元 | 18.00 美元 | 6.00 美元 | 12.00 美元 |
谷歌指出,1 秒生成音频相当于 25 个音频 token,因此 1 小时音频约对应 90,000 个 token。这意味着,到 2026 年底,1 小时音频输出使用 Flash TTS 需 0.81 美元,使用 Flash-Lite TTS 则需 0.54 美元。自 2027 年 1 月 1 日起,价格将上调至 1.62 美元和 1.08 美元,文本输入费用另计。