
Claude Opus 5.5、GPT-6 Sol 与 GPT-6 Luna 发布,掀起新一轮价格战
Claude Opus 5.5、GPT-6 Sol、GPT-6 Luna 与新一轮价格战
2026 年 9 月 22 日
昨天发布了 Grok 4.7(鹈鹕)和 MiMo v2.6 Flash/Pro(更多鹈鹕)。今天,Anthropic 发布了 Claude Opus 5.5,大约一小时后,OpenAI 也发布了 GPT-6 Sol 和 GPT-6 Luna。要透彻评估这些新模型还需要一些时间,但以下是我目前的初步印象。
GPT-6 Sol 和 Luna 的价格仅为 GPT-5.6 对应版本的一半
GPT-5.6 Luna 本来就是我构建应用程序的首选模型,因为它兼具卓越的性能和极低的成本。不知怎的,GPT-6 Luna 的价格比它还低了一半——而 GPT-6 Sol 相比 GPT-5.6 Sol 也有了类似的价格削减。
以下是目前的定价格局:
| 模型 | 输入 | 缓存输入 | 输出 |
|---|---|---|---|
| GPT-6 Luna | $0.10/M | $0.01/M | $0.50/M |
| GPT-5.6 Luna | $0.20/M | $0.02/M | $1.20/M |
| Grok 4.7 | $2/M | $0.50/M | $6/M |
| GPT-6 Sol | $2/M | $0.20/M | $10/M |
| GPT-5.6 Terra | $2/M | $0.20/M | $12/M |
| Claude Opus 5.5 | $4/M | $0.20/M | $20/M |
| GPT-5.6 Sol | $4/M | $0.40/M | $20/M |
| Claude Fable 5.1 | $10/M | $0.25/M | $50/M |
| GPT-6 Astra | $10/M | $1/M | $50/M |
请注意,GPT-5.6 计划在 11 月提价 25%,因此 GPT-6 的价格甚至仅为这些模型促销期间价格的一半。
(既然 GPT-5.6 Terra 与 GPT-6 Sol 价格相同,继续选择 Terra 的理由便已荡然无存。)
很难低估这一定价的竞争力。Grok 4.7 定价为 $2/$6,当时不到 GPT-5.6 Sol 价格的一半,但如今其输入价格与 GPT-6 Sol 持平,输出价格也更为接近。
GPT-6 Luna 的定价为 $0.10/$0.50,是 OpenAI 历史上最便宜的模型之一,只有两个更弱的模型比它便宜:GPT-4.1 Nano($0.10/$0.40,2025 年 4 月)和 GPT-5 Nano($0.05/$0.40,2025 年 8 月)。
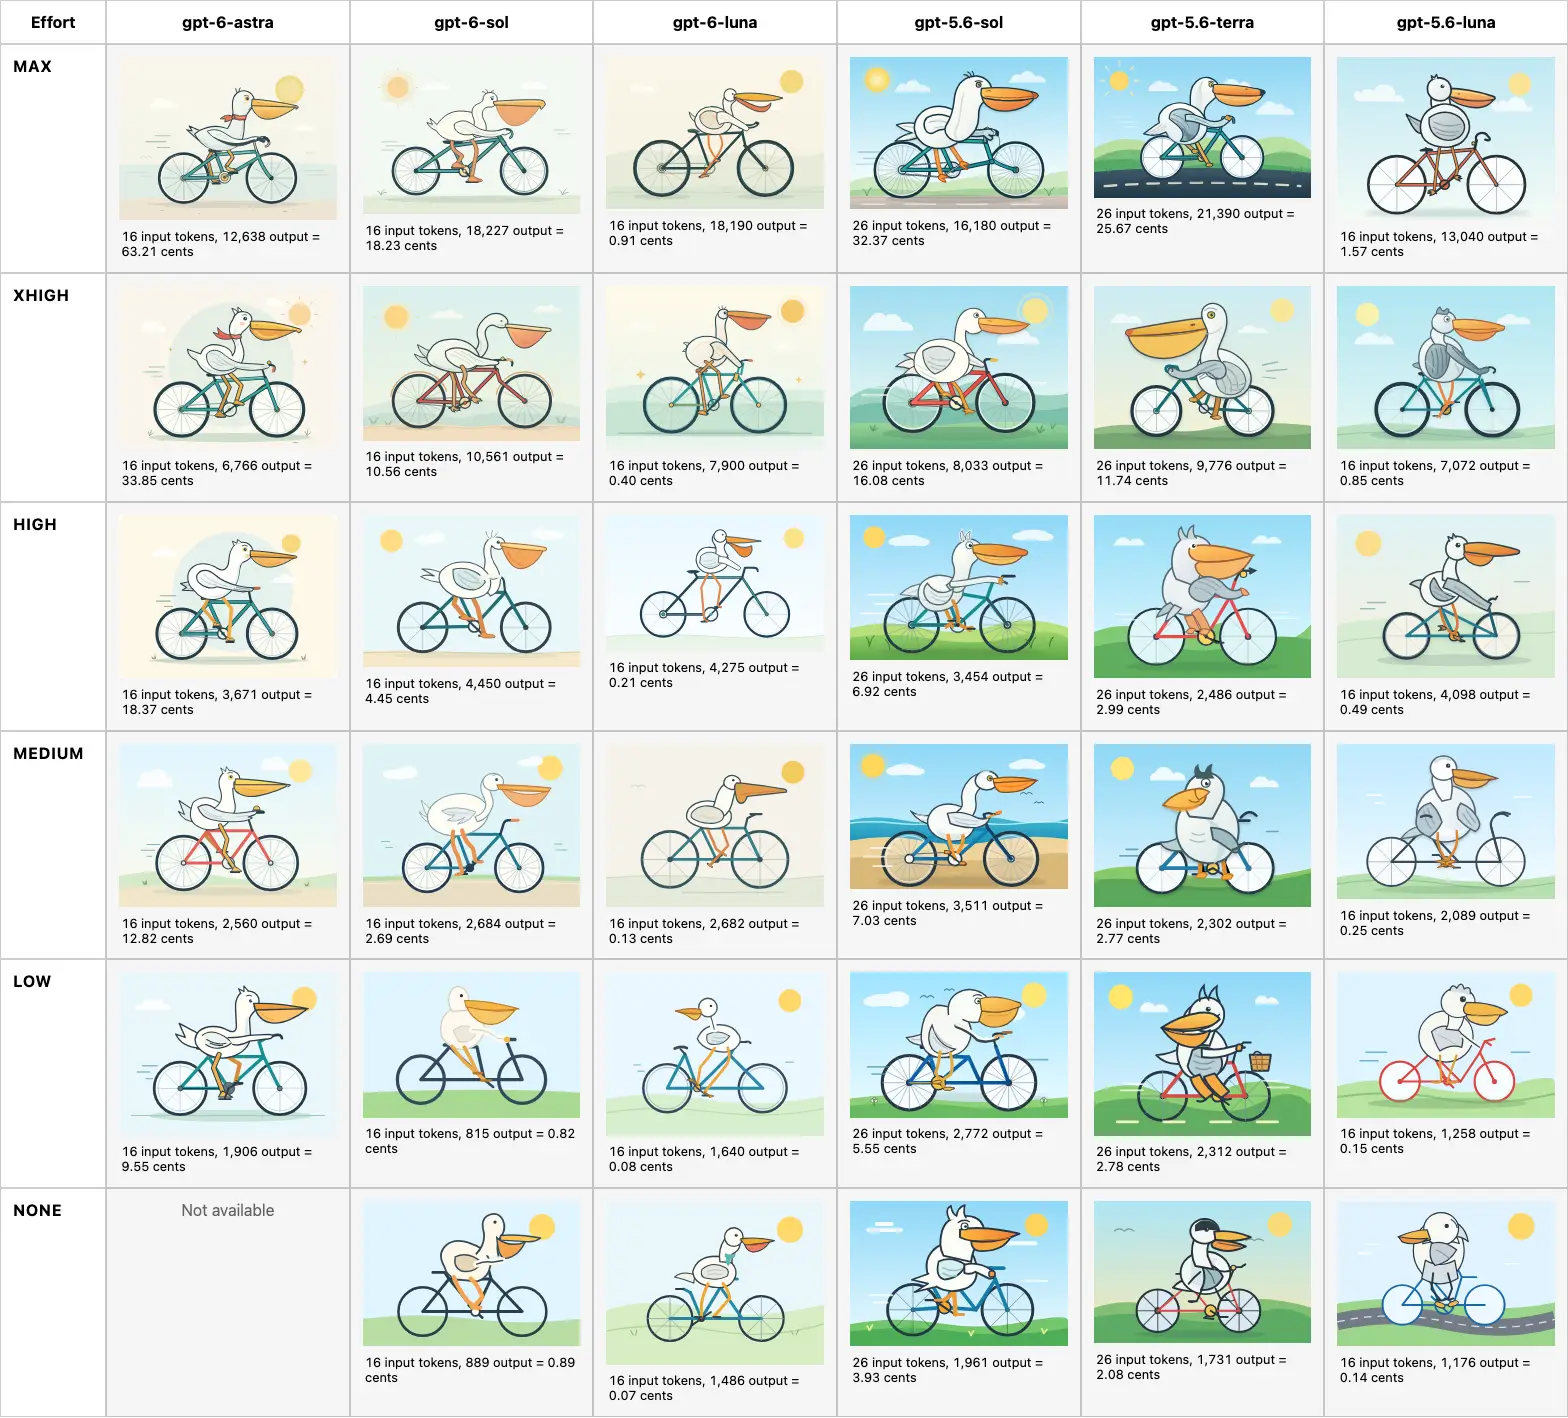
我分别为 GPT-6 Luna 和 GPT-6 Sol 画了鹈鹕图,然后把它们和 GPT-5.6 的鹈鹕图一起汇总到了这个对比网格里。我挺喜欢的一点是,一眼就能看出 5.6 系列选了更大胆鲜艳的颜色,而 6 系列要柔和得多。我仍然认为 GPT-6 Astra 在最高思考档位下画出的鹈鹕最好。
Claude Opus 5.5 也降价了
从沟通风格来看,Opus 5.5 似乎解决了大家对 Opus 最大的抱怨。Thariq Shihipar 说:
Opus 5.5 是根据你们的反馈打造的结果。
它表达清晰,每 token 价格比 Opus 5.0 更低,同时具备 Fable 5.1 的智能水平,token 使用效率高,且在各个思考档位下都表现出色。
据称它在 Blender 方面也更擅长了,我很期待实际测试它的表现。
Opus 4.5、4.6、4.7、4.8 和 5 的价格一直没变:输入每百万 token $5,输出 $25。5.5 降价 20%,变为输入 $4/百万、输出 $20/百万。
缓存读取的价格更是降了 60%。这对较长的 agentic 对话影响很大,因为这类对话中 90% 以上的输入 token 都是按缓存价格计费的。
Opus 5.5 的新价格与 GPT-5.6 Sol 相同,不过那还是在 OpenAI 把 Sol 价格砍半之前。
GPT-6 Astra 和 Claude Fable 5.1 都定价为输入 $10/百万、输出 $50/百万。目前这轮价格战波及的是它们之下的下一档模型。
Anthropic 表示 Sonnet 5.5 和 Haiku 5.5 即将发布。鉴于目前 Haiku 4.5 的价格为 $1/$5,而最新的 GPT-6 Luna 仅为 $0.10/$0.50(前者价格的十分之一),Haiku 能否在下沉市场价格竞争中重新占据优势,值得期待。
Claude Opus 5.5 在最大思考模式下过度思考导致故障
在我标志性的“生成一只骑自行车的鹈鹕的 SVG”测试中,Claude Opus 5.5 在“最大”思考级别下竟然没有返回响应!
它先称这是“一个经典的测试请求”,然后开始非常、非常努力地思考自己的任务:
这是一个经典的测试请求,因此我计划构思一只形态优美的鹈鹕,突出其独特的喙和喉囊,骑着一辆结构完整的自行车,具备合适的车轮、车架和脚踏,背景是简单的天空和地面。 [...]
验证小腿长度约为 95.2,足够接近。现在我要处理近侧腿部的路径,从髋部到膝盖再到脚踝,然后绘制停在踏板上的脚部形状——使用由直线和曲线组成的路径勾勒脚跟、脚尖和鞋底轮廓,使其自然贴合在 y=478-494 区域附近的踏板表面。 [...]
我喜欢篮子里突出的鱼,鹈鹕正注视着它,这是一个值得保留的有趣细节。我还在确认眼睛靠近喙基部的位置是否符合典型的鹈鹕解剖结构,并考虑给它一个稍微快乐点的表情。 [...]
远侧腿部正确地位于车架后方,因此我继续检查链轮齿和图层顺序——远侧曲柄臂应大部分被座管和链轮遮挡。我确定了最终 SVG 的宽度和高度属性,并配合 viewBox 以确保正确的缩放,同时注明由于没有文本,不需要 font-family。 [...]
看到这只有趣的鹈鹕时我兴奋不已……但随后它就停住了。Opus 5.5 的最大输出 token 限制为 128,000(其他 Claude 模型也是如此),而它在还在推理 SVG 时就达到了这个上限!
我试了第二次,结果还是一样。这让我怀疑“max”模式基本是废的——如果在一个愚蠢的 SVG 提示词上都能过度思考到死机,我根本不敢指望它在更有意思的任务上能保持理智。
(这两次失败各花了 $2.56,耗时接近 20 分钟。)
而 Fable 5.1 在“max”模式下没有过度思考,反而给了我 我见过的最像样的鹈鹕——所有 Anthropic 模型里它画得最好。
这是 Opus 5.5 画的鹈鹕(不含 5.5 max 的结果)。
我还做了一个对比网格,把这几个鹈鹕和 Opus 5、Fable 5.1、Sonnet 5 画的放在一起比较:
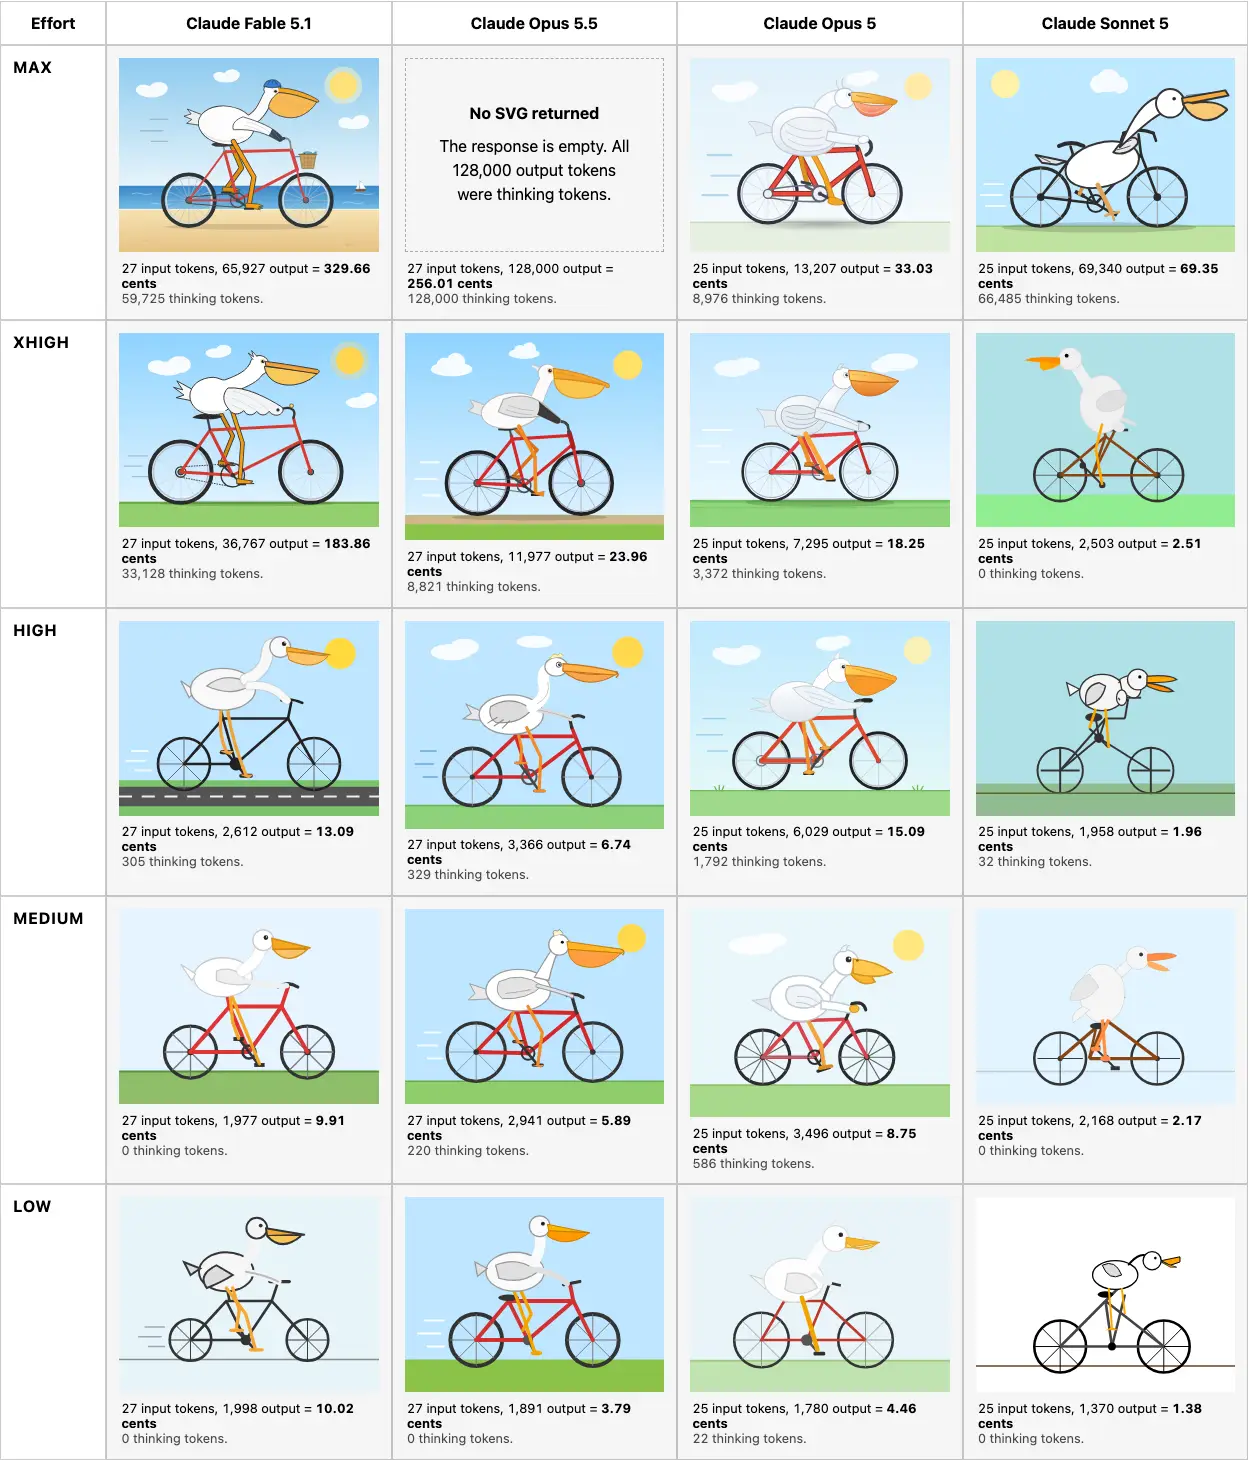
拿“画一只骑自行车的鹈鹕”来对比不同厂商的模型,现在可能没什么意义(如果曾经有意义的话),但我还是发现拿同一模型家族在不同推理强度下的结果来做对比挺有价值的。
现在我默认在 Codex 和 Claude Code 里都用 GPT-6 Sol 和 Claude Opus 5.5。我也把 agent.datasette.io 的 Datasette Agent 演示升级到了 GPT-6 Luna,它既快又靠谱,不管是写 SQL 查询还是给 Datasette Apps 生成 HTML 和 JavaScript 都做得不错。