
Pika Speech 语音克隆实操:5 秒参考音出配音,API 调用全流程与官方跑分解读
五秒参考音,克隆一个声音
配音这件事,过去卡人的从来不是"写不出稿子",而是"声音不是我的"。找配音演员按分钟计价,自己念又念不出那个味儿,剪出来的片子里旁白一开口就露怯。Pika 在 2026 年 8 月 18 日发布的 Speech 模型把门槛压到了很低的一段:给它五秒参考音频,它能用这个声音读你写的任何稿子,单次最长五分钟,输出 48 kHz 工作室级语音。
这篇教程依据 Pika 官方博客《Say Hello to Pika Speech》与开发者文档 Pika Speech 接口规格整理,走通两条路:不传参考音、直接用官方预设音色出一段成品;以及上传参考音频克隆特定音色。两条路都是在 API Club 平台里调用接口完成,没有网页版创作界面——这一点和很多"打开官网点按钮"的工具不一样,先说清。
站内已有一篇讲同门模型 Pika Soundtrack 的配声实操(它管视频配声,Speech 管纯语音),本篇补上语音克隆这一环;Pika 的平台档案见产品页,AI 视频教程总纲在此。
它能做什么,多快,多少钱
先把官方博客给的三组硬数字摆出来,这几个数决定了它值不值得用:
五秒参考音频就能克隆声音,单次请求最长五分钟语音——这是官方发布页开头的第一句话,原文是
Any voice from five seconds of reference audio. Up to five minutes of speech per request.模型本体是一个 3B 参数的 flow-matching transformer,生成 48 kHz 语音,几分钟的稿子按官方本地测试只需约一秒出稿——打字比生成还慢。
价格方面,开发者文档 Pricing 一节只写了一行:$0.01 per minute,即每分钟语音 1 美分,且只有生成成功才计费。官方博客另给了一组对比:比 ElevenLabs v3 便宜 9 倍、比 Cartesia 和 ElevenLabs Turbo 便宜 4.5 倍、比 Fish Audio 便宜 2 倍(价格记录于 2026 年 8 月 14 日)。便宜是有代价的,官方自己的基准表里 Pika Speech 在英文词错率(WER 1.990%)和中文字错率(CER 1.727%)两列都是六款对比模型里最高的——省钱和极致准确不可兼得,这个后面细说。
要用它,得先弄清平台规则:Speech 不在 Pika 网页创作界面里,官方在 Availability 一节写明 "Pika Speech is live now in the Pika API Club"。API Club 是 Pika 的开发者会员平台,会费 10 美元/月,新会员首月送 10 美元额度,一个 Key 通吃平台内 100 多个视频、图像、音频与语言模型。不想写代码的话,这个门槛要提前想清楚。
第一次调用:预设音色路线
最省事的路是不传任何参考音,从官方列好的预设音色里挑一个。接口规格里 voice_preset 参数的合法值共 76 个,从 deep_trailer_bass(电影预告片低音)到 thunderous_revival_preacher 这类风格化角色应有尽有,日常最稳的几个:calm_documentary_narrator(纪录片旁白)、polished_news_anchor(新闻主播)、warm_grounded_friend(温和朋友感)、velvet_radio_alto(丝绒电台女中音)。
三步走。
第一步,注册并拿到 API Key。浏览器打开 dev.pika.art,登录后在账户页生成密钥。密钥放在请求头 X-API-Key 里。提交生成前文档建议先查一眼余额——
curl https://api.dev.pika.art/billing/balance \
  -H "X-API-Key: YOUR_API_KEY"
这个调用免费,返回的 balance_micro_usd 是美元乘以一百万后的数值。余额确认够本次生成再提交,避免任务建了又被拒。
第二步,提交生成任务。接口是 POST /v1/media/pika/pika-audio/pika-speech,必填字段只有 script(稿子)。下面这个请求体来自官方文档示例,可以直接抄走替换:
curl -X POST https://api.dev.pika.art/v1/media/pika/pika-audio/pika-speech \
  -H "X-API-Key: YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "script": "……你的稿子……",
  "voice_preset": "plummy_posh_gentleman",
  "seed": 6002,
  "voice_consent_attested": false
}'
voice_preset 挑一个塞进去,seed 留默认 -1 表示随机。响应不是音频本身,而是一个任务对象,形如 {"id": "media_8f3a2c91-…", "status": "queued"}。把这串 id 存下来。
第三步,轮询拿结果。GET /v1/media/jobs/{request_id},同样带 X-API-Key。状态从 queued 变 running 再变 completed;completed 的响应里,下载地址在 output.audio.url,格式 mp3。响应里还会带 usage.output_seconds(实际生成秒数)和 billing.charge_micro_usd(实扣金额,微美元)。只存了 id 没存结果的,还有个兜底接口 GET /v1/media/jobs/{id}/content,完成前访问会返回 409,完成了直接给 URL。
克隆声音:多一步上传,多一个承诺
想用自己的声音或某个授权声音,把请求体里的 voice_preset 换成 reference_audio,值是一个音频 URL。本地文件不能直接塞请求体,得先走预签名上传:
curl -X POST https://api.dev.pika.art/v1/media/uploads \
  -H "X-API-Key: YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "content_type": "audio/wav",
  "size_bytes": 123456
}'
size_bytes 必须是文件的精确字节数。响应给三样东西:upload_url(临时上传地址,5 分钟内有效)、headers、url(永久地址)。把文件字节 PUT 到 upload_url,headers 要原样带上——Content-Type 和 Content-Length 都参与了签名,少一个或对不上就是裸 403。上传完,把 url 填进生成请求的 reference_audio 字段。
克隆请求还多一个必勾的开关:voice_consent_attested 设为 true,意思是声明你对这个声音有克隆的权利。文档写得很硬:"Set true to attest that you have the rights and permissions needed to clone the voice in reference_audio. Required when reference_audio is supplied."——传了参考音不勾它,请求过不去。拿别人声音做恶搞视频之前,先想想这个字段为什么存在。
节奏快慢,模型里有根锚
同样一句话,两秒讲完和四秒讲完是两种完全不同的表演。多数 TTS 系统控制时长靠修剪或拉伸音频,效果生硬;Pika Speech 在模型内部做这件事,官方管这个机制叫 EOS latent。原理说人话版:在潜空间里预置一个干净的"结束锚",锚摆在哪一帧,句子就落在哪一帧结束——锚提前,语速压缩得急促;锚推后,同一句话松弛下来有了呼吸感。一个旋钮,同时管总时长和语速。
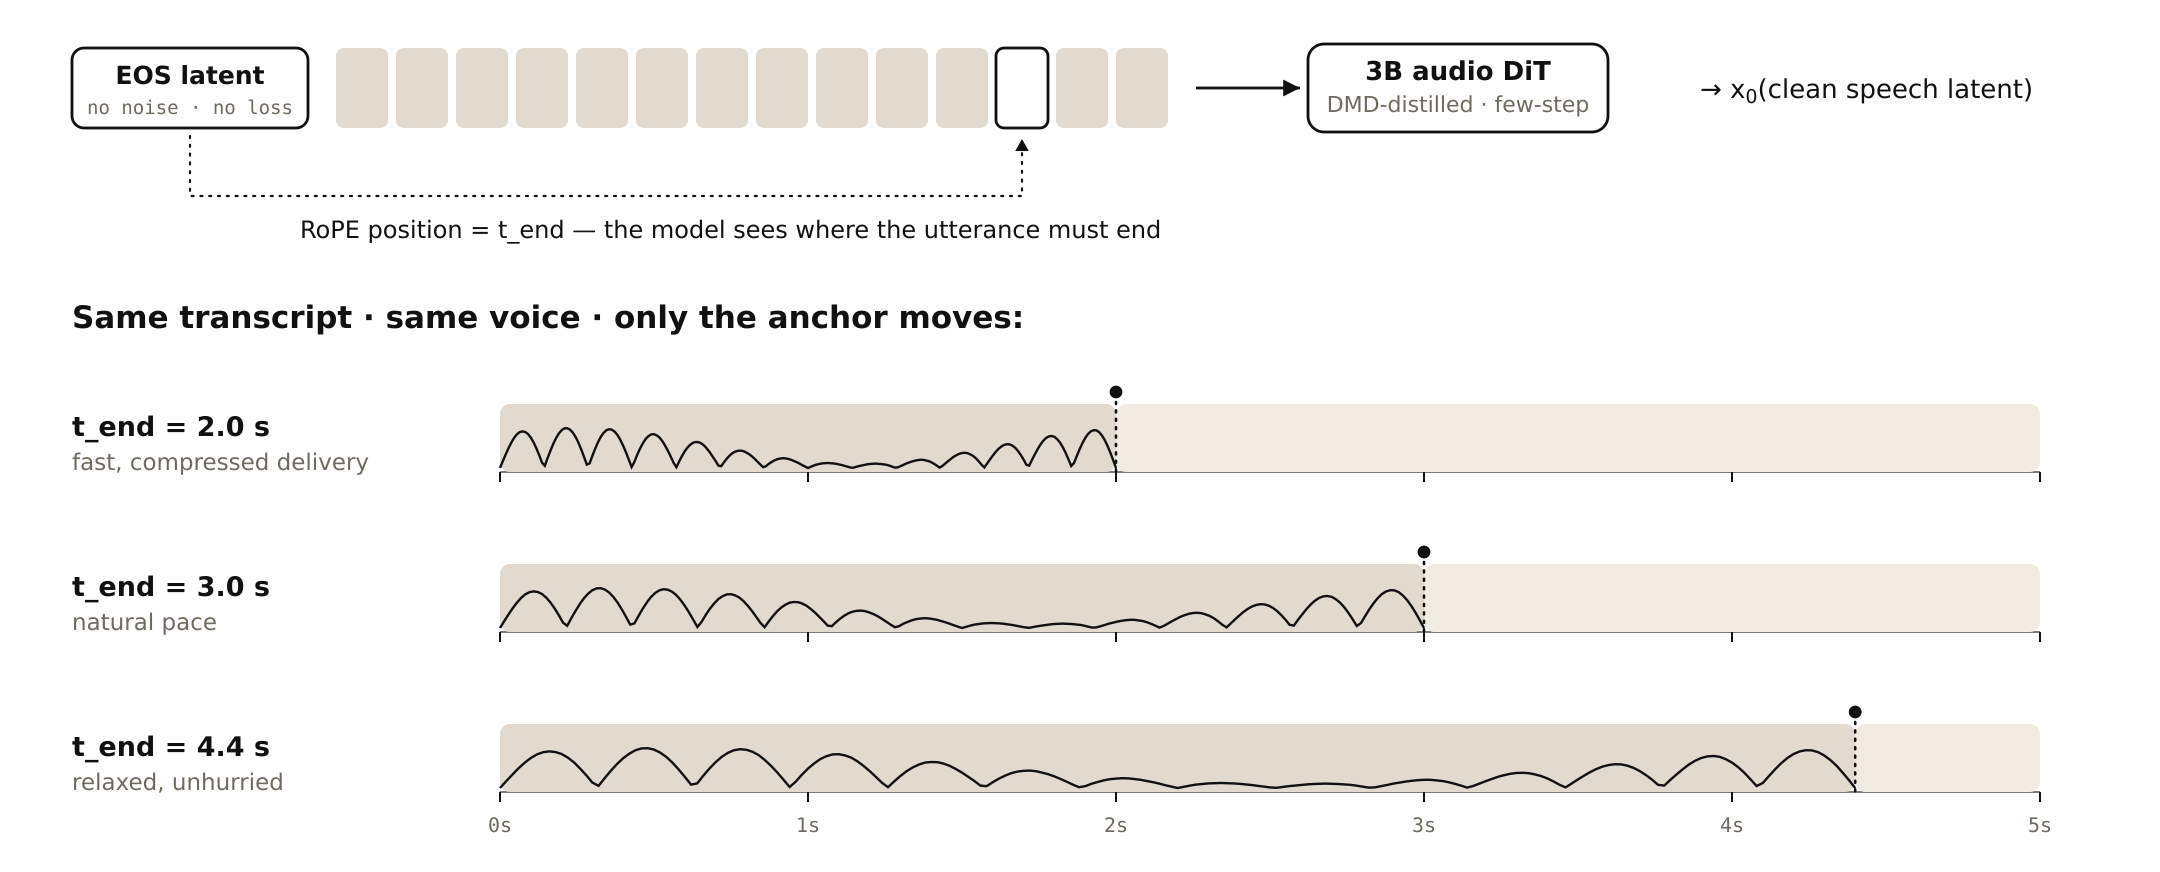
官方图:同一句稿子、同一个声音,只移动结束锚的位置,语速从急促(2.0s)到自然(3.0s)到松弛(4.4s)
为什么快:蒸馏加推理优化
一分钟语音约一秒出稿,速度不是白来的,官方博客给了两张图讲清楚。第一张讲模型怎么从 3B 的 teacher 蒸馏出少步数的 student:不用逐步模仿 teacher 的轨迹,而是让 student 的一次性输出分布直接对齐 teacher 的输出分布(distribution matching distillation)——student 保住 teacher 的音色与风格范围,但八步以内就出结果。
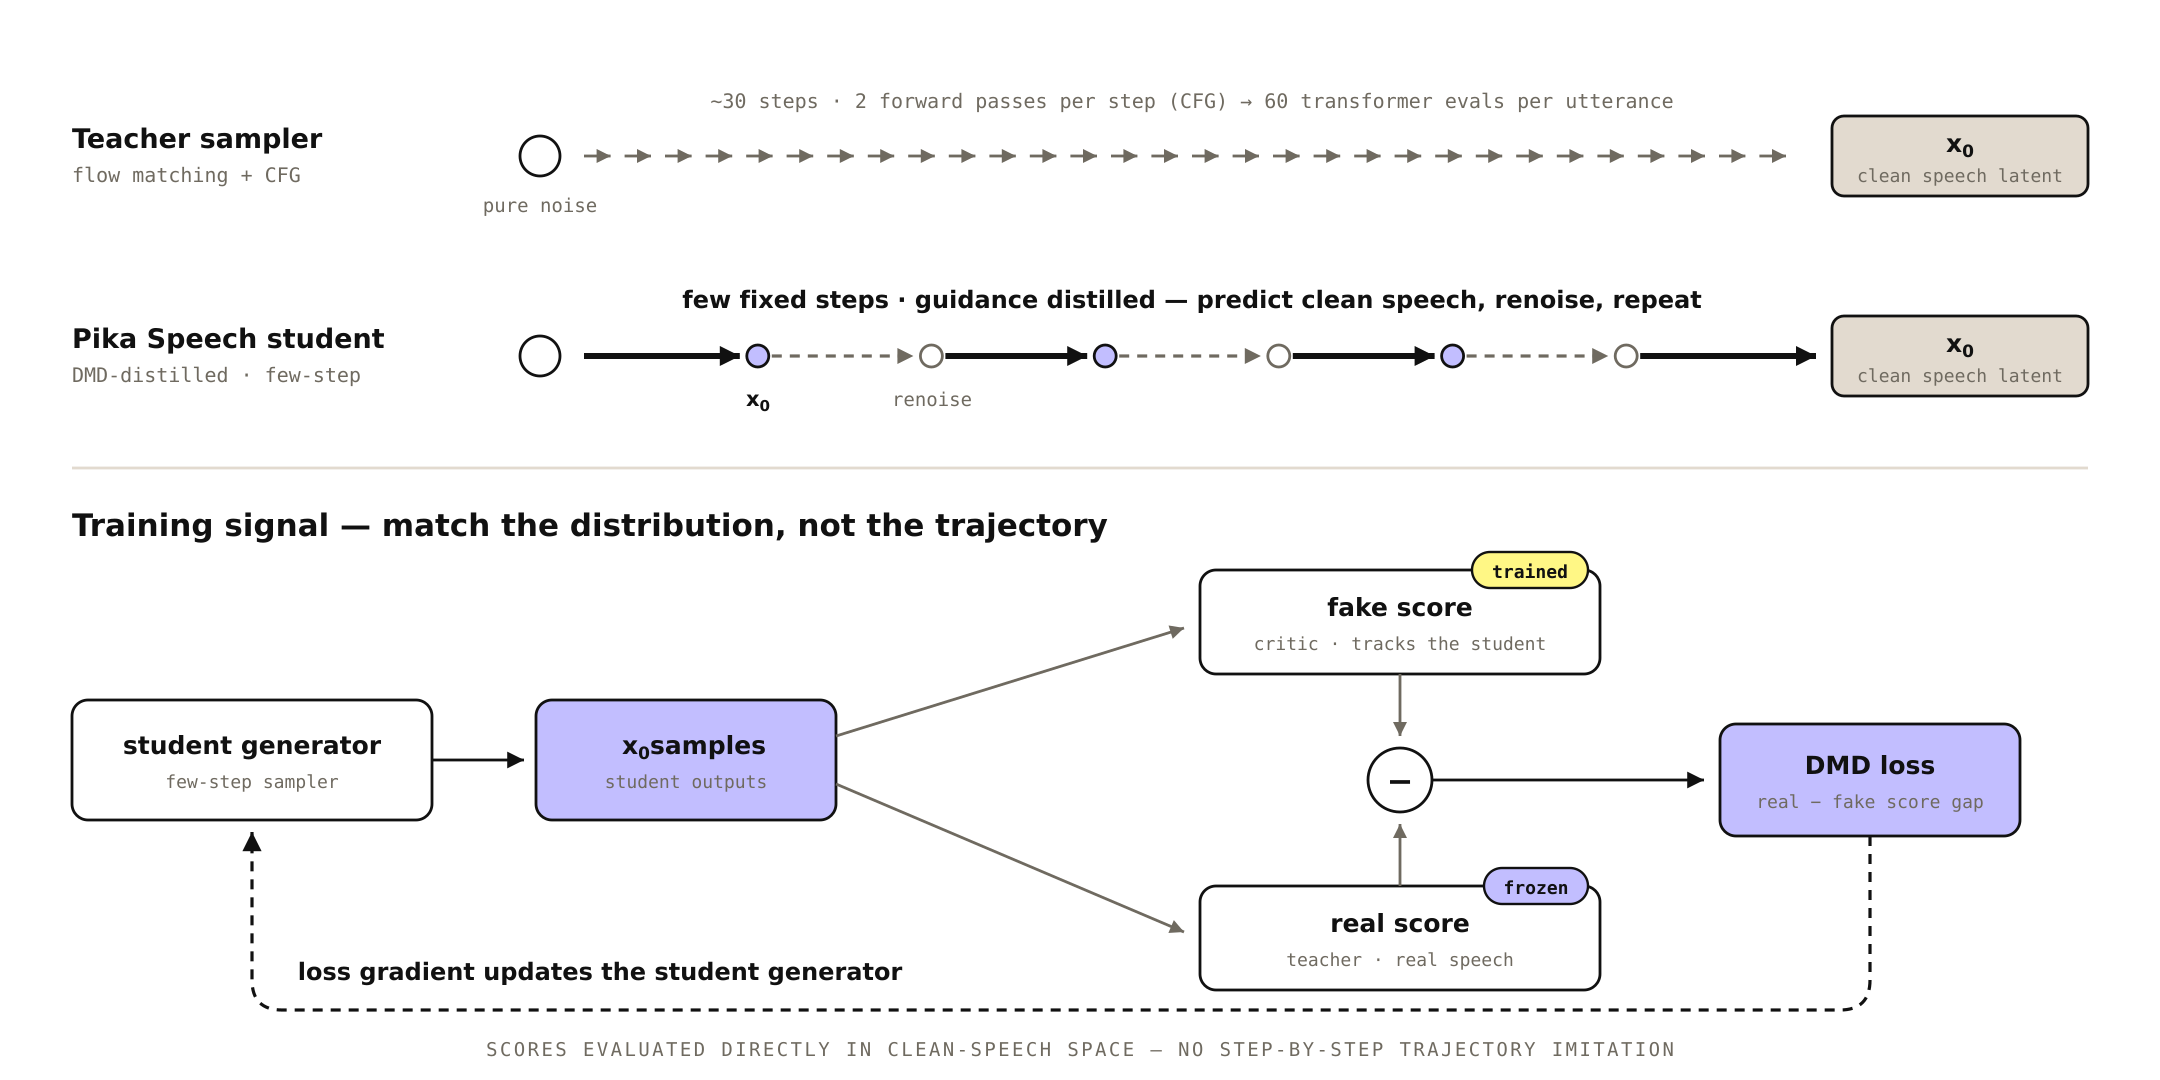
官方图:DMD 蒸馏——训练信号对齐的是输出分布,不是轨迹
第二张图是官方把长请求推理耗时从 1.71 秒一路压到 0.26 秒的优化账本:常驻引擎、文本嵌入缓存、批处理解码、编译版声码器、token 打包、CUDA graphs、融合 RoPE,一层层叠上去。两图合看能明白一件事:这模型便宜且快,靠的是工程,不是玄学。
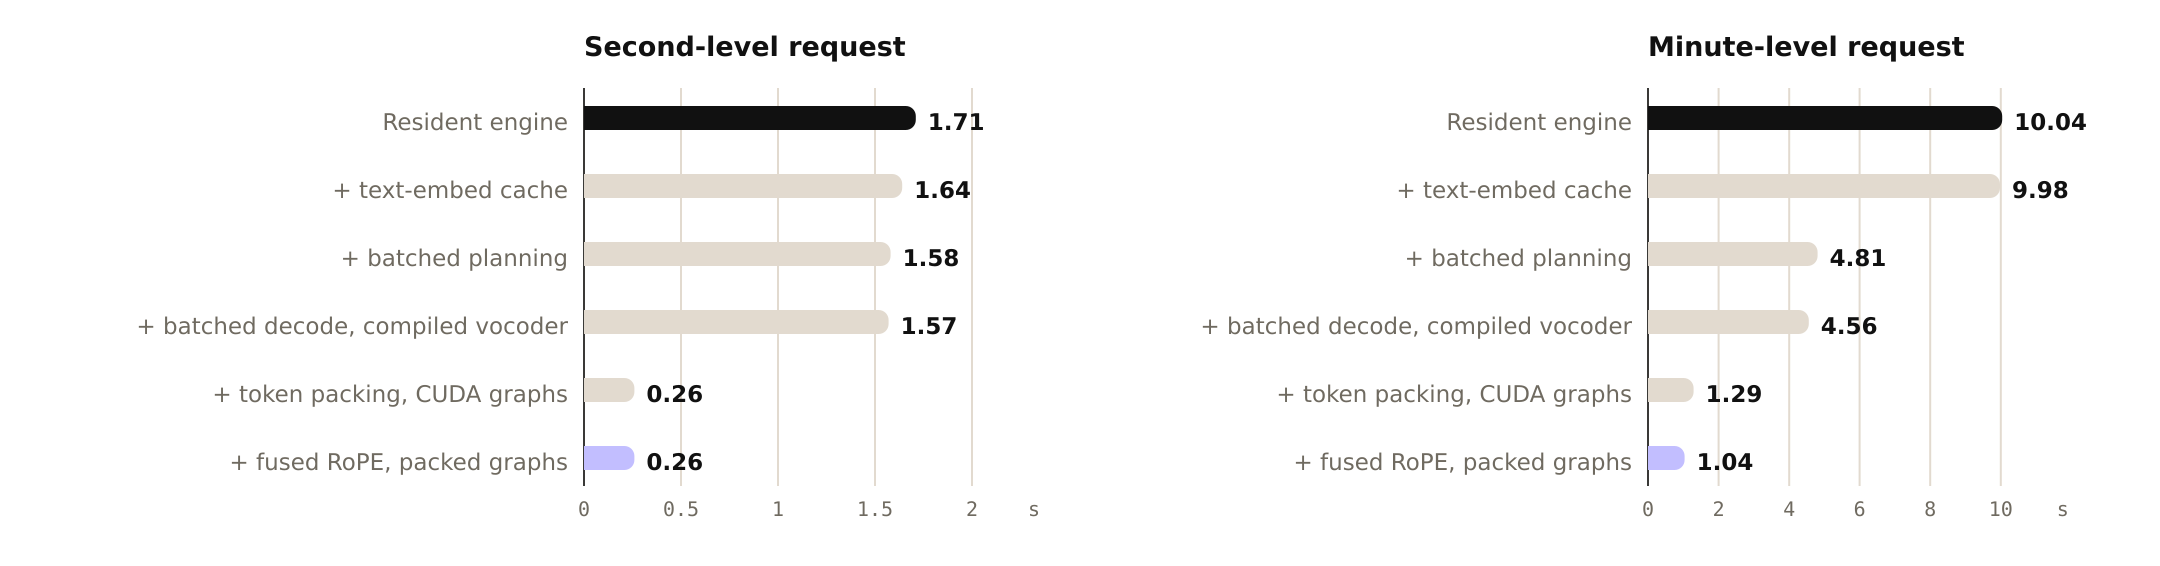
官方图:秒级请求的推理耗时从 1.71s 逐层优化到 0.26s,每一段横条是一项工程优化的贡献
官方跑分:快和便宜是第一,准确度不是
官方基准表值得细读,因为它同时是卖点说明书和劝退清单。评测设定:英中各 2000 条样本,每条给参考录音和新稿子,测可懂度(WER/CER)、说话人相似度(Resem)、感知音质(DNSMOS、AudioBox PQ)。结果分两头看:
价格列 Pika Speech $0.01/min 一骑绝尘,比第二名 Cartesia 的 $0.045 便宜四倍多。中文说话人相似度 75.41 分——六款模型里垫底,ElevenLabs v3 是 78.90、MiniMax Speech 2.8 HD 是 90.93;中文字错率 1.727% 也是六款最高(MiniMax 为 0.846)。英文侧词错率 1.990% 同样排最末,说话人相似度 80.30 反而是英文第一。音质类指标(DNSMOS、PQ)则处在第一梯队。
翻译成人话:英文旁白它又快又便宜又像,中文克隆的"像不像"与字准有折损,稿子越关键越要自己听完校对。官方博客没有回避这些数字,表格原文可查,做选型时以最新官方页为准。
接口行为的几个细节
轮询之外,这套接口有几个文档里白纸黑字、但容易踩的行为,提前知道能省几次返工。
失败任务长什么样:余额不足、触发限流这类"任务行已建、提交被拒"的情况,返回的仍是完整任务对象,status 为 failed、error.code 标明原因——枚举里有 insufficient_balance、rate_limited、content_moderation、provider_error 等十余种,未知值统一归为 provider_error。
幂等键别复用:带 Idempotency-Key 的重放会原样返回既有任务——包括 failed 状态的。重试失败任务要用全新的 Key,拿旧 Key 重试只会把失败原样吐回来。
计费读取时机:任务终态时 billing 才有值。settled 才记账(带 charge_micro_usd);pending 按 1 秒、2 秒、5 秒的间隔重试;unavailable 等 30 秒再读。billing: null 不等于扣了钱。
字段校验错误走 422,返回体直接点名问题字段,比如 {"message":"duration: Input should be less than or equal to 15"}——改字段重提即可,别蒙头重试。
适合谁,不适合谁
预算敏感、英文内容为主、需要量产配音的团队,是这模型最舒服的场景:1 美分一分钟、秒级出稿、76 个预设音色免参考音直接用,量产产品视频英文旁白、英文播客片段、原型 demo 配音都很顺手。
中文克隆刚需、对音色相似度和咬字准确度敏感的项目,先拿官方基准表的数字对一对自己的验收线再上车;追求顶级相似度的商业交付,官方表里 MiniMax Speech 2.8 HD 的 90.93 分和 ElevenLabs v3 在那摆着,多花的那几倍价钱买的就是那几分类似度。不写代码、只想网页点按钮出配音的用户,目前没有直接入口——Speech 只在 API Club 里,这条门槛短时间不会消失。
来源
本文步骤与图片依据 Pika 官方博客《Say Hello to Pika Speech》(2026-08-18)与开发者文档 Pika Speech 接口规格整理,版权归原作者所有。
