
效果差10%,成本低100倍,速度快10000倍:为什么Simulation正在接管AI
以如今 AI 领域的标准来看,今天是个相当平静的周五,正好可以停下来想想:这一切究竟是怎么回事。如果你读过我们的《2025 年阅读清单》,关注过我们对Z.ai GLM的报道,了解Poolside 的转向,一直在追踪我们的AI for Science 专题,还收听了今天的Simile 播客,那么你不仅是 Latent Space 最忠实的读者之一,可能也已经形成了这样的认知框架:
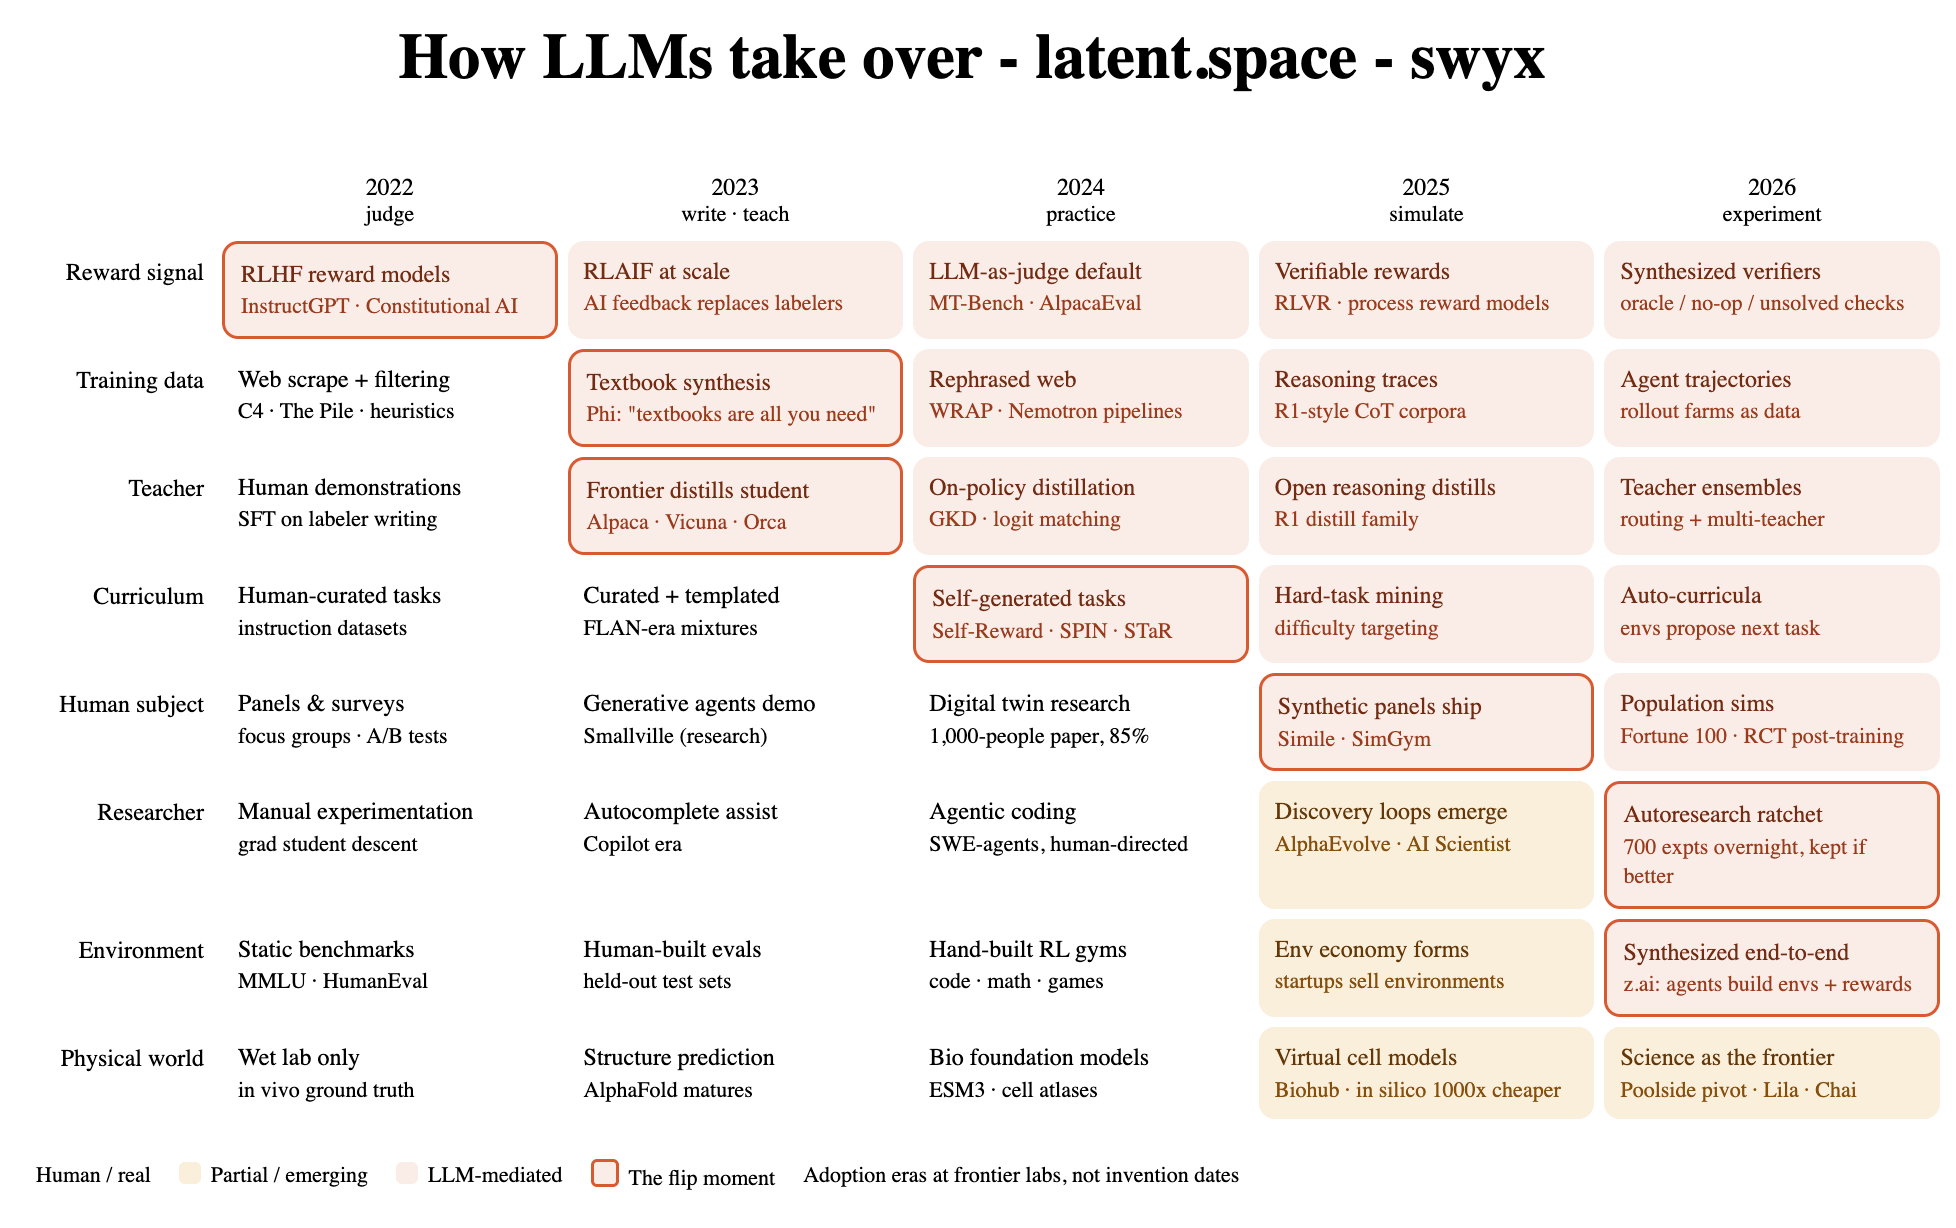
从 2022 年起,每年都会有一部分机器智能生产链从“由人打造”变成“由模型打造”。这种变化既不渐进,也不均衡——每一次转变都有自己的“首个案例”:某篇论文或某款产品,首次让合成版本在前沿实验室中成为不可或缺的支柱。此后,未来就已经到来,只是还没有完成产品化。
仔细想想,我们过去称之为“合成数据”“合成评测标准”“AI 研究员”和“端到端 RL 环境”的东西,本质上都是日益复杂的人类模拟——效果差 10%,但成本低 100 倍,速度快 10,000 倍。
阶段 1:奖励信号(2022)
最先被合成化的,出人意料地是评判者。InstructGPT 奠定了如今的标准做法:只需收集一次人类偏好,训练一个奖励模型,然后让策略针对这个模型进行优化,而不必再依赖人类。从策略的视角看,负责给出认可的本来就是一个 LLM。Constitutional AI 更进一步,让 AI 根据一组原则进行自我批评(RLAIF);之后,Lee 等人证明,AI 反馈的效果可以匹敌人类反馈,但成本只需后者的一小部分。等到 LLM-as-judge 成为默认的评测方法(MT-Bench、AlpacaEval)时,整套认可机制——奖励、批评和评估——都已经变成由模型评判模型。
阶段二:训练数据(2023)
Microsoft 的 Phi 系列直接把论点写进了标题:Textbooks Are All You Need。一个使用 LLM 合成的教材级数据训练的小模型,性能远超其参数规模所能预期的水平;phi-1.5 进一步证明,这并非偶然。Apple 的 WRAP 则将这一思路推广开来:不只是生成数据,而是用 LLM重写整个互联网,让预训练效率提升约 3 倍。此后,这条流程开始工业化——NVIDIA 的 Nemotron-4 340B 将一套采用宽松许可的合成数据生成流程作为核心卖点推出;到 2025 年,推理轨迹语料(由强推理模型生成的思维链)已经成为预训练和中期训练的标准组成部分。原本被认为不可替代、必须来自人类的语料,如今很大一部分已经由模型写成。
阶段三:教师(2023)
ChatGPT 开放 API 几周后,Stanford 的 Alpaca 证明:只需花 600 美元,用 GPT 生成的指令进行微调,就能复现前沿模型的大部分行为。Vicuna 则利用共享对话实现了类似效果;Orca 不再满足于简单答案,而是借助教师模型提供的详细解释来完成训练。这项技术逐渐从模仿发展为一套完整的训练方法:on-policy generalized knowledge distillation 解决了训练与推理之间的不匹配问题。随着 DeepSeek-R1 在发布旗舰模型的同时推出一系列蒸馏模型,这种方法达到了文化影响力的高峰——从此,每次发布小模型,人们默认背后的“教师”就是另一个模型。
阶段 4:课程学习(2024)
阶段 1—3 让输入变成了合成数据;到了阶段 4,循环开始自我闭合:模型开始决定下一步该学什么。相关组件其实很早就已出现——Self-Instruct(模型自行编写指令集)和 STaR(模型自行生成推理轨迹并持续改进)都诞生于 2022 年。但真正的转折点来自 Meta 的 Self-Rewarding Language Models 和 SPIN:它们表明,模型可以自行生成任务、评判输出,并突破人类偏好数据设定的上限。课程设计一直是 ML 中最依赖经验和品位的环节——研究者凭直觉决定模型接下来训练什么;如今,这件事开始由模型自己完成。
阶段 5:研究者(2026)
辅助时代(先是 Copilot,随后是 SWE-agent)仍然由人来决定做哪些实验。发现时代则不再如此。DeepMind 的 AlphaEvolve 在 2025 年进化出了真正全新的算法,Sakana 的 AI Scientist(如今论文已发表于 Nature!)则勾勒出了从研究到论文写作的完整流程。真正的转折点是 Karpathy 在 2026 年 3 月推出的 autoresearch:这是一个刻意保持极简的迭代闭环,由 coding agent 修改真实的 LLM 训练配置,运行一个五分钟实验,只有验证损失下降时才保留改动,然后整夜重复执行。Karpathy 自己的一次长时间运行累计完成了 700 个实验,最终保留了 20 项改进,将训练出 GPT-2 的时间从 2.02 小时缩短到 1.80 小时——他睡觉时,系统找到了真实可用、且能迁移到其他场景的代码改动。
阶段 6:环境(2026)
RL 的扩展瓶颈从模型转移到了环境:我们需要数以千计可执行、可验证、符合专业实际的任务世界,但人类无法以足够快的速度手工构建它们。我们最近在关于 z.ai / GLM-5.3 的文章中介绍过这一点:Z.ai 搭建了一套端到端合成环境的流水线——研究 agent 从真实工作模式中提取信息,将其转化为带有隐藏状态的长时程环境;裁判 agent 会尝试执行每项任务,确认任务确实可解;验证器则在看不到参考答案的情况下自动生成,随后通过 oracle、no-op 和未解决状态检查进行压力测试,直到其二元奖励足够可靠,可以直接用于训练。正如 GLM-5.3 的发布公告所说,从环境、裁判到验证,整套系统自下而上都是合成的。同一周发布的 Ornith-1.5 也宣称实现了端到端自我改进——模型自行提出任务,并生成自己的 RL rollouts。如今,训练场、裁判和计分板全都由模型构成。
阶段 7:人类作为实验对象(2025)
如果模型可以充当裁判、教师和环境,那么人类在这个闭环中剩下的角色就是主体——偏好、行为和需求的来源。Simile正在取代的,正是这一层。其技术脉络可以追溯到 Joon Sung Park 的Generative Agents(Smallville,2023),以及后来的Generative Agent Simulations of 1,000 People:研究人员仅根据两小时的个人经历访谈构建数字孪生体,结果显示,它们在复现原型人物的问卷回答和行为反应方面,准确率达到这些人两周后再次复现自身反应时的 85%。
真正难以跨越的障碍在于:前沿模型的训练目标是成为 agent model,这反而使它们不擅长模拟真实的人类。因此,Simile 会基于访谈、交易数据,以及来自Open Science Framework的已登记随机对照试验(RCT)进行后训练,专门还原人类的偏见、不一致性和因果特征,并公布了有关模拟质量的早期 scaling laws。随着Shopify 的 SimGym开始模拟消费者的购物路径,以及腾讯在光谱另一端采用较为粗糙的billion-persona方法,焦点小组、用户研究和 A/B 测试样本都正在变成推理任务。
阶段 8:物理世界(2026 年,进行中)
整个矩阵的最后一行始终没能完全变红,而这正是关键所在。Poolside 的 reverse-execuhire 信把界线划得很清楚:世界上的问题可以分为两类——一类是智能受限型问题,可以通过扩展认知能力解决,并且很快会因开放权重模型而商品化;另一类是实验受限型问题,在这类问题上,“再多的智能也无法替代真实世界的实验反馈——没有湿实验室,10 万个天才也治不好癌症。”他们押注的是:AI 的长期价值最终会归属于那些掌握实验闭环的人手中——让 AI 成为“世界上最有价值的科学发现引擎”。
生物领域也在从另一个方向采取同样的策略。CZ Biohub正把 Human Cell Atlas 转化为一个虚拟细胞——因为与体内实验相比,in silico 模拟的成本和速度大约都能提升1000倍——并进一步构建虚拟免疫系统。Chai、Xaira以及Lila 那些数据中心形态的实验室,正在共同补齐AI-for-science技术栈。物理世界是唯一无法被完全合成的部分——我们能做的,只有逐个细胞地将它压缩进模型。
AINews:工作日快讯[AINews] Poolside 获 NVIDIA 120亿美元反向挖角:创始人以10亿美元留下,员工获60亿美元,Infraco 将把新型云算力扩展至7GW
8月21日
不到一个月前,我们刚在播客中与 Eiso Kant 一起介绍了 Poolside 的 Model Factory(此前还报道过我们的 Paper Club):
阅读全文指数增长从对角线开始
再看一遍这张表格,你会发现第一种模式之下还隐藏着第二种模式。每次范式转变之前,都会出现同样的质疑——模型坍缩、幻觉叠加、垃圾进垃圾出;但每次转变最终都发生了,而且恰好发生在某种验证机制让合成版本变得可信的时刻:用严格筛选打造 Phi 的教材,用评判模型对比研究验证 LLM 评测,用单元测试和 proof checker 验证 RLVR,用 oracle/no-op 检查 z.ai 的验证器,用预注册的 RCT 验证 Simile 的数字孪生,再通过湿实验室闭环验证虚拟细胞。合成技术的前沿,并不是随着生成能力提升而推进的,而是随着验证能力提升而推进的。
这也指向了它下一步的发展方向。网格左下角剩下的灰色三角区域——实体实验、具身世界中的 ground truth——恰恰是验证最慢、成本最高的部分。模型先学会写作,接着学会评判、练习,最后开始做实验。未来十年的关键问题是:它们究竟需要接触多少现实,又能在多大程度上用模拟来替代现实。
效果差10%,成本低100倍,速度快10000倍……而且这三项指标都在快速改善。
再强调一次,这次请认真感受:
2026年8月20日至21日的 AI 新闻汇总。我们查看了 12 个 subreddit、544 个 Twitter 账号,没有再查阅其他 Discord。你可以在 AINews 网站搜索往期全部内容。提醒一下,AINews 现在已成为 Latent Space 的一个栏目。你还可以选择订阅或取消订阅不同频率的邮件!
AI Twitter 综述
隐身模型、中国前沿竞争压力,以及 DeepSeek 的多模态攻势
Ox Alpha 成了当天最神秘的模型:多位开发者称,它的编程和 Agent 能力异常强,社区普遍猜测它属于 Zhipu/GLM 系列,可能是 GLM-5.3 Vision,或某个 Flash 版本,而非全新的超大 Base Model。相关消息包括:Theo 称它在内部基准测试中“杀疯了”;随后又根据它的审核结果合并了 8 个 PR;Kimmonismus 则表示,它在 10 项 DeepSWE 任务上的成绩超过 80%,高于 Fable 的 65% 和 GPT-5.6 Sol 的 52%。随后,社区通过 Hermes Agent/OpenCode/OpenRouter 以及 Cline 迅速推广了这个模型。
社区最有说服力的技术判断是:“后训练 + 基础设施”比单纯堆规模更重要:多位独立分析者认为,Ox Alpha 的速度表现和输出风格,更像是高效的 GLM 衍生模型,而不是参数量超过 1T 的巨型模型。比如,Tim Dettmers 指出,更快的输出和较弱的 partial prefill 可能意味着实际激活的参数更少;scaling01 猜测,它可能是由更大的 Teacher 模型蒸馏到 5.3 级模型而来;teortaxesTex 则多次将范围进一步收窄到 GLM-5.3/5.4 Vision。这一判断也符合一篇对 GLM-5.3 的详细分析:它沿用了与 GLM-5.2 相同的 743B Base Model,性能提升主要来自更大规模的后训练、更完善的 Sandbox,以及用于长程 Agent 任务、实现更精细 Credit Assignment 的 SAO。ZhihuFrontier 在相关串文中对这些要点进行了总结。
DeepSeek 发布了当天最具实质性的产品:DeepSeek-V4-Flash-Vision-Exp 新增多模态支持,据称同时保留了 V4-Flash 的文本能力。DeepSeek 表示,其多模态智能体性能接近 Opus-4.8。此次更新还包括混合文本+图像 API 支持,图像按 117–384 个 token 计费,价格与 Flash 相同,以及用于重复复用上传文件的新 Files API。这似乎解开了 Ox Alpha 的部分疑团:有观察者指出,这个神秘模型在部分测试中很可能是一个“盲测 VLM”。
更广泛的信号是:中国实验室正在价格性能和多模态智能体两个方向压缩与前沿模型的差距。Kimmonismus 认为,传闻中的 GLM-5.3 Flash 级别 Ox Alpha 将迫使美国实验室做出回应;与此同时,SemiAnalysis 也直接提出了一个问题:开源模型是否正在迎头赶上。
OpenAI、Codex 与定价/使用经济学
OpenAI 将 GPT-5.6 Sol 的价格下调了 20% 以上,持续三个月,适用于 API 和基于额度的产品。相关消息由 @OpenAI 和 @OpenAIDevs 宣布。除此之外,产品层面的促销也进一步降低了实际价格,例如 Code 的五折优惠将持续至 9 月 3 日;Cognition 则表示,在 Devin 中,叠加各项折扣后,Sol 的实际价格截至 10 月 3 日相当于目录价的 24%。这一举措既像是在提升使用率、优化效率,也是在回应中国厂商低廉的推理成本。
Codex 的使用量似乎正在爆发式增长:thsottiaux 称 Codex 已达到 2000 万活跃用户,并为所有 Codex 和 ChatGPT Work 用户提供了一次“预存重置”,这一消息很快被 Theo 和 Kimmonismus 转发扩散。还有用户反馈产品的实际用量超出了预期限制,例如 Theo 称,自己在剩余额度已经显示为 0% 后,一个长期运行的目标仍消耗了约 800 美元的 token。
OpenAI 增强了费用控制功能:团队现在可以按 API key 跟踪用量和支出,并为组织或项目设置严格的月度上限。随着 agent 工作负载变得更难预测、并发度越来越高,这些功能也更加实用。
创业工具市场的情绪重新转向 OpenAI:immad 认为,Anthropic 在创业公司中的份额可能已在第一季度见顶,Sol 和 Codex 正在“扭转局势”。与此同时,一些用户认为 Sol 是目前在编程、数学和 agent 任务上综合能力最强的模型之一,例如 DimitrisPapail 称其为“几乎所有任务中能力最强的现有模型”。
Agents、Harness,以及转向以环境为中心的训练
重心正从 prompt 转向环境:这里最值得关注的讨论,依然是 对 GLM-5.3 沙盒扩展方式的解读:基础模型不变,但通过更丰富的可执行环境和 SAO 风格的反事实信用分配,模型在长时程任务上的表现得到提升。这与当天分享的其他研究方向一致:Google 的 EnvHarness / EnvRigger 通过插件层和由策略诊断驱动的环境重塑,动态调整静态环境,使留出集性能最高提升 9 个百分点,同时减少 9.8% 的执行步骤。
Benchmark 越来越垂直,难度也越来越高:FACET 根据 Agent 技能生成可执行的终端任务,并完成了 6,078 个任务的验证;SWE-bench Science 新增 119 个科学软件任务,即使是 Claude Code + Opus-5,pass@1 也低于 50%;CADBench 发现,顶级模型在真实的 Fusion 360 任务中通过率仅为 24.6%;AI4AI-Bench 则在 10 个研究代码仓库上测试递归式自我改进,最佳模型的平均得分仅为 0.288。
Agent 基础设施正在加速产品化:GitHub 将协作式 Agent 工作流引入了 Slack 和 Teams。Slack 展示了类似 Devin 的工作流:Agent 自动接手任务、创建 PR,并在共享频道中邀请设计人员参与(示例)。Agent 运行时也在持续演进:nac v0.1.3 新增沙箱化 git worktree、会话管理和具备视觉能力的图片读取;Hermes Agent 支持使用 Ox Alpha,并推出“Blank Slate mode”和自动技能清理;OpenHands 则将默认免费模型切换为 Kimi K3。
RL 推理服务的正确性取得了重要系统进展:vLLM 的 IsoExec 解决了浮点运算不满足结合律导致的 rollout 与训练 logprob 不一致问题,并确保不同 TP/EP/SP 布局之间实现逐 bit 一致。在 8 张 H100 上使用 DAPO 运行 Qwen3.5-35B-A3B 时,据报道 logprob 差异从 1.6e-2 降至 6.7e-7,额外开销为 25.3%。
研究亮点:路由、循环利用与机器人技术
推理时架构创新:DeepMind 一篇关于 Recirculation 的论文引发关注。该方法会在推理阶段,将更深层网络生成的上下文化激活反馈到前面的处理流程中,无需重新训练。论文摘要称,实验实现了上下文化错误减少 60%、困惑度降低 23%、GSM8K 得分提升 21%(讨论串)。
模型路由获得了更严谨的理论框架:Google DeepMind 的 Pandora’s Router 将路由视为一个需要付出检查成本的最优搜索问题,而不是默认路由评估可以免费进行。其声称,在包括专业 LLM 和推理时长可变等场景中,只需更少调用昂贵的评估器,就能达到穷举评估的效果。
机器人领域也有两项重要进展:据报道,NVIDIA AVO 已解决 ARC-AGI-3 公开的 25 个环境中的全部 183 个关卡。不过,François Chollet 提醒,这些只是公开演示和教程内容,并非完整基准测试。另一方面,Jim Fan 发布了 T-Rex:这是一套面向灵巧操作的触觉响应系统,由异步视觉专家和触觉专家组成,并配套了目前规模最大的开放触觉数据集:50 小时、约 5,500 个回合、22 自由度硬件。
基础设施、算力与开放模型
开放模型访问和本地推理仍在持续改善:Ollama 宣布 AT&T 加入开放模型生态,并将 Kimi K3 加入 Pro/Max 订阅。Yuchen Jin 介绍了加州大学伯克利分校的 FreeToken:在单张 RTX PRO 6000 上运行 753B 的 GLM-5.2,速度达到 14.9 tok/s;在搭载 8GB RTX 4060 的笔记本上运行 Qwen3.6-35B,速度达到 39.3 tok/s。据称,在消费级 GPU 上,其吞吐量是 Ollama 的 2~4 倍。
算力仍是硬约束:多位从业者表示,推理算力正变得越来越紧张,而不是趋于宽松。比如,saranormous 指出,优秀 AI 公司正因算力不足而受到增长限制;Andrew Carr 则表示,即使自建 GPU 集群,实验需求仍然超过可用算力。因此,提升模型效率、优化调度,以及降低延迟和 token 成本,已经成为战略重点。
开源训练的透明度也在不断提升:Percy Liang 宣布 Marin 535B-A23B 已开始训练,计划在约 3 个月内,使用 11× GB200 NVL72 训练 18.75T tokens,整个训练过程也将像往常一样保持公开。
热门推文(按互动量排序)
DeepSeek 发布 V4-Flash-Vision-Exp——这是当天最明确的一次产品发布,也很可能是多模态 Agent 领域最具实际影响的变化。
OpenAI 将 GPT-5.6 Sol 的价格下调超过 20%——前沿模型市场的价格压力进一步加大。
Codex 活跃用户达到 2000 万,并为用户提供可累积的重置次数——这是一个值得关注的产品增长信号。
NVIDIA AVO 在 ARC-AGI-3 公开环境中达到 100%,但Chollet 也提出了保留意见——成绩确实亮眼,但如何解读这一基准测试同样重要。
David Sacks 表示,Harvey 使用开源 Kimi K3,以更低成本实现了法律领域的 SOTA——这有力说明了:如果限制开源模型,受到最大伤害的很可能是美国的应用层公司。
AI Reddit 速览
/r/LocalLlama + /r/localLLM 速览
1. Qwen3.8 27B 本地 Agent 评测
Qwen3.8-27B 是我见过自主性最高的本地模型(活跃度:1334):帖子称,Qwen3.8-27B 在单张 RTX 3090 上本地运行,使用 Unsloth 的
Q4_K_S量化、q8KV cache 和150k上下文后,展现出了异常出色的自主代理能力:它通过 Playwright 配合现有的 SSO/会话 Cookie,登录学校系统并获取课程表;还完成了另一项社交媒体视频处理任务,包括下载视频、提取帧、使用 Whisper 转录,以及增强图像质量。该图片是模型输出的截图,显示它使用 Outlook/OWA 的 Playwright 配置文件、Microsoft“保持登录”功能和 Duo 浏览器信任 Cookie 访问学校系统。因此,这件事的技术意义不仅在于模型本身的能力,更在于本地 LLM 的工具调用自主性,以及对高风险凭证和会话信息的处理。评论者既印象深刻,也保持谨慎:一位用户明确担心,如果给代理足够的访问权限,它可能执行诸如注销大学学籍之类的破坏性操作;其他人则认为,这说明先进的本地代理系统已经出现,只是能力分布还不均衡。一位评论者询问了 Qwen3.8-27B 展现代理能力背后的实现细节,尤其是所使用的代理框架——例如 Claude Code、Hermes 或其他框架——以及工具是如何通过 MCP servers、浏览器工具、Python、文件系统访问等方式提供给模型的。他还询问了模型使用的推理后端,例如 llama.cpp,以及模型如何自主下载视频、提取帧并安装 Whisper。
有人对帖子中提到的量化版本的可靠性表示担忧:一位评论者惊讶于“这个量化效果居然这么好”,同时也提到过该量化版本出现循环行为的报告。这表明,模型看似出色的自主性可能对量化级别和运行时行为较为敏感,尤其是在需要长时间连续调用工具的任务中。
一条以安全为重点的讨论质疑是否应赋予本地智能体广泛的系统访问权限。有评论者表示,他们不会放心让 Sol 或 Fable 这类智能体拥有不受限制的权限。担忧的重点并不是本地推理本身,而是那些权限足够高、能够执行修改账户或工作流等现实影响操作的自主智能体。
Qwen3.8-27B 的知识能力 相比 3.6 大幅下滑(活跃度:779):帖子称,在离线、无需调用工具的事实回忆测试中,Qwen3.8-27B / Qwen3-8-27B 似乎不如 Qwen3.6-27B / Qwen3-6-27B:作者使用自建的“略微冷门”知识问答基准(面向备灾爱好者),在不同量化级别和采样设置下都发现了答错情况,这与 Artificial Analysis 的Omniscience 知识基准中较低的得分相吻合。这里下降的主要是模型权重中存储的知识,以及在隔离网络环境下进行推理时的幻觉和事实回忆能力,并非编程或工具使用能力;评论者指出,Qwen3.8 在工具调用、网页搜索与抓取工作流、编程以及智能体行为方面更强。评论者普遍认为,这是一种有意的取舍:新版 Qwen 3.x 可能更偏重编程和智能体任务,而不是充当“迷你 Google”式的事实知识库,wit
