
Hot Chips:OpenAI Jalapeño、Cerebras CS-5、Groq 3 LPX 与 Apple M6 芯片解析
在第 37 届 Hot Chips 大会上,最重磅的消息无疑是:OpenAI 自研芯片的进展惊人——距离宣布与 Broadcom 合作还不到一年。而且,这款芯片并不是 ASIC,而是一个足以击败 Blackwell的完整替代方案。
 OpenAI@OpenAI自从公布首款自研推理芯片 Jalapeño 以来,我们一直在对它及其配套系统进行测试。
结果显示,这是一次重大进步:每瓦功耗带来更多智能,同时响应速度更快。通过单一架构兼顾更高吞吐量和更低延迟。美国东部时间 2026 年 8 月 25 日下午 5:19 · 226 万次浏览
584 条回复 · 1.08K 次转发 · 1.36 万次点赞
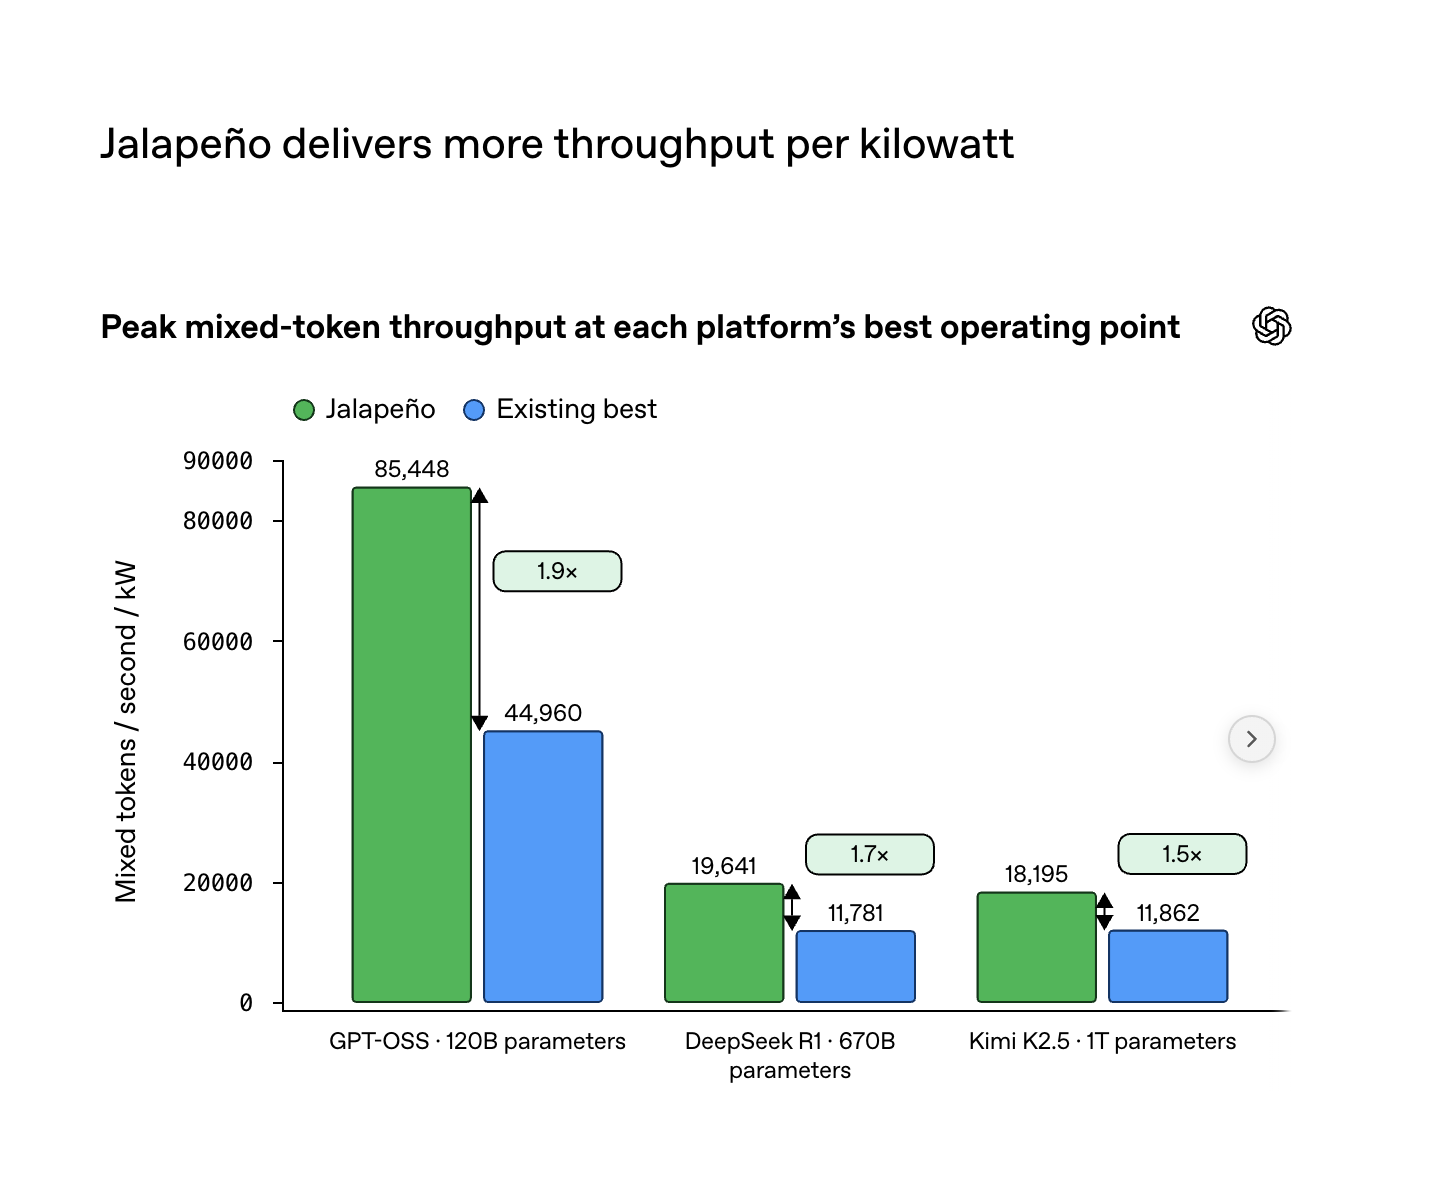
如今,关键指标正转向每瓦性能,而 Jalapeño 的表现如下:
Hot Chips 的完整演讲内容尚未发布,但下面已经有不少解读。想了解更完整的分析,可以和 OpenAI 的其他动态一起关注:
2026 年 8 月 24 日至 25 日 AI 新闻汇总。我们查看了 12 个 subreddit、544 个 Twitter 账号,没有再查阅其他 Discord 服务器。通过 AINews 网站可以搜索往期全部内容。提醒一下,AINews 现在已成为 Latent Space 的一个栏目。你可以选择接收或取消接收不同频率的邮件!
AI Twitter 综述
OpenAI Jalapeño 推理芯片:推理技术栈正在转向
Jalapeño 公布的性能数据是当天最大的技术看点:OpenAI 首次公布了定制推理芯片 Jalapeño 的基准测试结果,称其在真实模型工作负载下,相比 NVIDIA GB200/GB300 系统具备更高的能效和更低的延迟。在 OpenAI 的测试中,Jalapeño 在峰值吞吐下每瓦处理量提升了 1.5–1.9 倍,端到端延迟降低了 1.7–3.6 倍;对于高度交互式工作负载,性能提升达到 2.1–4.1 倍。该芯片额定功耗为 700W,但据称在测试过程中实际功耗始终不超过 550W。OpenAI 表示,Jalapeño 将于年底前开始部署到自有基础设施中;Gen 2 已进入深入开发阶段,Gen 3 也已启动(OpenAI 公告、部署路线图、Sam Altman)。
工程师为何关注:这不仅是单纯的性能提升,更代表一种更加均衡的推理架构,有望缓解吞吐与延迟之间常见的取舍。多位技术人士指出,Jalapeño 的部分对比结果尤其值得注意:在一些测试配置中,它据称并未采用激进的 prefill/decode 解耦或投机解码(speculative decoding)等技巧,却击败了使用这些技术的系统(gdb、kimmonismus 总结、eliebakouch 分析、You Jiacheng)。SemiAnalysis 认为,作为第一代 ASIC,Jalapeño 的表现异常强劲,并将其直接与 Blackwell 和 Rubin 级别的系统进行了比较(SemiAnalysis、dylan522p)。
另一个值得关注的方向,是借助模型优化系统:OpenAI 的帖子还提到,GPT-Astra + Codex 参与编写和优化底层 kernel,让 3 个原本未列入计划的开放权重模型在 Jalapeño 上于约两个月内达到高性能。据报道,在部分 attention 和 MoE 模块中,这些实现比现有的人类专家代码快 1.5–1.8 倍(kimmonismus、eliebakouch)。这释放出一个重要信号:编译器和 kernel 优化正逐渐纳入模型改进闭环,而不再只是应用层编码的辅助工作。
对基础设施的更广泛影响:多篇帖子将 Jalapeño 放在更大的行业转型背景下讨论:即使封装和晶圆厂产能仍是难以绕开的瓶颈,头部实验室在推理经济性方面或许不再完全受制于 NVIDIA(Liam Fedus、teortaxesTex 的评论、LearnOpenCV 关于 TSMC/CoWoS 产能的提醒)。
Agent Harness、记忆系统与评测工程走向核心位置
Harness 的质量正变得与模型选择同等重要:多篇论文和发布内容都指向同一主题——Agent 的表现很大程度上取决于外围系统。Microsoft 主导的一篇新论文介绍了 AutoSaddler,将 Harness 视为代码,并利用失败追踪记录离线修改 prompt、工具配置和控制逻辑。相比基础 Harness,该方法在 GAIA2 上提升 +9.0,在 SWE-Bench Pro 上提升 +9.6,在 Terminal-Bench 2.0 上提升 +10.0(论文摘要)。与此同时,另一篇论文直接量化了 Harness 带来的差异:更换 Harness 对得分的影响可能远大于更换模型,不同 scaffold 下的模型排名甚至会完全反转。论文提出的解决方案,是建立结构化的 Harness Card 披露标准(分析、《不存在中立的 Harness》)。
长期跨度的软件工程任务仍远未解决:SWE Refactor Bench 评估的是完整代码仓库的迁移任务,例如将 C→Rust、Maven→Gradle 和 POSIX→WebAssembly,覆盖 SQLite、zlib、libsodium 等真实项目。在 520 次运行中,只有 28 次完成了全部三个阶段,最终通过率仅为 5.4%;而且有 13/20 个任务没有任何系统成功解决(EinsiaAI)。这提醒我们,相比那些更局部的编程基准,现有模型在修复 bug 方面的亮眼成绩并不能代表其长期软件工程能力。
记忆系统正在被重新设计为可编程状态,而不是压缩后的聊天记录:DAIR 总结的一篇阿里论文提出,为智能体会话配备只追加事件日志和持久化 Python 内核,将工具输出及其派生状态绑定到带类型的变量中,而不是不断将它们序列化后塞进提示词。论文报告的结果包括:在 LongMemEval_S 上达到 94.8%,在 BEAM_10M 上达到 73.1%(比此前公开发表的最佳记忆系统高 5.1 个百分点),以及搭配 Qwen3.8-Max 时在 LOCA_256K 上达到 86.7%(总结)。相关的 Knowledge Triage 研究还表明,简单地压缩上下文会严重破坏对精确规则的记忆:经过五轮压缩后,一种设置只能保留 10% 的安全规则,而采用类型感知的保留策略后,保留量提高了 2–4 倍(总结)。
实用的评测工程正从临时拼凑走向产品化流程:LangChain 及合作伙伴分享了一套具体流程,将追踪记录和人工反馈转化为任务规格、合成环境与评测体系,用于持续衡量 agent 的表现并进行后训练(Vtrivedy10、hwchase17)。LangSmith Engine 的关键内部基准性能也提升了>2×,同时改进了问题检测与聚类,支持 SaaS 和自托管部署,新增 Slack/Linear 集成,以及按成本分级的分析模式(LangChain)。
本地优先的 Agent、端侧推理与全新的个人计算栈
Perplexity Portable Computer 是当天最明确的本地 Agent 产品发布:Perplexity 在 NVIDIA DGX Spark 上推出了 Portable Computer,将其定位为 Perplexity Computer 的完全本地化版本:orchestrator LLM、subagent LLM 和agent harness 全部运行在本地硬件上,无需依赖云端(Perplexity 发布公告、模型详情、NVIDIA、Arav Srinivas)。首发本地技术栈采用经过后训练的 PPLX 27B,同时提供 Qwen 3.8 27B;后续还将支持 Nemotron 3.5 Lightning。
更深层的趋势,是持久在线、始终运行的本地 Agent:Srinivas 描绘了一种未来图景:后台进程持续从各类连接器获取上下文,不断循环执行多跳推理,并运行在用户自己的硬件上(Arav Srinivas)。社区对此反响不一:有人期待本地运行带来的隐私和控制力,也有人质疑“本地优先”不该意味着使用一台5000 美元的 DGX Spark,而应当基于普通消费级设备(theo critique、theo follow-up)。
Apple/macOS 的本地 AI 工具链也在逐渐成熟:exo 表示,Apple 已在新款 M5 Ultra Mac Studio 和 M6/M5 Pro Mac Mini 的产品页面中介绍了 exo,重点强调通过 Thunderbolt 5 实现低延迟 RDMA,将多台 Mac 组成集群,以接近 API 的速度运行 Kimi K3、GLM-5.3 等模型;由 4 台 M5 Ultra 组成的集群,聚合内存带宽约可达4.8 TB/s(exo)。相关讨论还指出,Apple 更快的 PCIe 存储,以及基于 ANE 的视觉处理流水线,让小型本地集群和 CPU/ANE/GPU 混合推理变得更加实用(anemll、onirenaud)。
本地运行时周边的工具也在不断完善:Ollama v0.33 增加了一键集成功能,让 Claude Desktop 可以将 Ollama 作为第三方网关,调用云端和本地模型(Ollama);有人展示了在 Cloudflare Durable Object 中运行 OpenCode v2,说明小型 Agent 运行时正逐渐能够嵌入边缘环境(fayazara)。
模型、检索与搜索基础设施
Qwen 3.8 正在覆盖整个技术栈:从部署到评测,多个帖子都体现了业界对 Qwen3.8 发布的热情。Together 为 Qwen3.8-27B 增加了微调和专用推理支持(Together);Unsloth 则表示,借助优化内核,可以在 Kaggle 免费提供的 2× Tesla T4 实例上,对 27B 模型完成全量 QLoRA 微调(danielhanchen)。在应用侧,Qwen3.8-27B 在 Image-to-WebDev Arena 中位列开源模型第一、总榜第七,输入/输出价格分别为每百万 token 0.40 美元和 3 美元(arena)。
搜索与检索基础设施迎来多项实质性更新:Hugging Face 详细介绍了 Papers with Code 搜索引擎的架构:采用 PostgreSQL + pgvector,搭配 Qwen 3 Embedding 0.6B 和混合检索;通过 Hugging Face Jobs 在 NVIDIA L4 上生成 embedding,将产物存入 bucket,再由 Inference Endpoints 提供在线服务。同一套技术栈还用于论文页面中的“相关论文”功能(Niels Rogge)。由前 Yandex Search 负责人创办、获得2600 万美元种子轮融资的 Keenable 结束隐身,推出面向 AI 的 Web Search API 和 Web Query Language,目标是支持 agent 规模的网页检索(styskin)。
检索模型设计依然是活跃领域:近期围绕后期交互 / 多向量检索的讨论重新升温。有观点认为,检索负载中的扩展性表现终于开始显现;相比存储格式,模型与数据库的协同设计至少同样重要(mixedbread perspective、Silvio Martinico)。
机器人、物理世界模型与具身数据
Figure 发布的“Index”是机器人数据领域的一项重磅进展:Figure 推出了 Index,称其为全球规模最大、类型最多样的机器人数据集。据介绍,该平台目前每秒接收 30 分钟视频上传量,累计上传 1600 万段视频,已为数据贡献者支付 1500 万美元,下载量达到 26.4 万次。公司还表示,未来 12 个月将投入 10 亿美元用于数据和算力建设(Brett Adcock、后续说明)。这一规模意义重大,因为目前许多机器人实验室面临的瓶颈,似乎仍主要在示范数据和感知数据,而非模型架构创新。
大规模物理建模和世界建模持续挑战上下文长度极限:Anima Anandkumar 介绍了初创公司 Accelerated Understanding。该公司正开发面向多模态物理仿真的大型 AI 模型,覆盖 4D 时空,并宣称预训练参数量达到 1T、训练上下文长度达到 1T,推理时上下文长度更是超过 >5T,且无需子采样或分块处理(Anima Anandkumar)。目前公开细节不多,但这条动态体现了部分前沿非语言建模工作的方向:重点正从单纯生成文本或视频,转向超长上下文的多模态仿真。
具身策略的泛化能力仍是重要的评测目标:另一篇机器人领域动态介绍了 S1,这是一种操作模型,能够仅凭一次示范,完成训练分布之外的任务(anag004)。Google Research 还分享了 AgentHands,这是一个 XR 系统,通过为对话代理配备同步的手势,在执行实体任务时提供空间引导(Google Research)。
热门推文(按互动量排序)
OpenAI 芯片发布:@sama 介绍 Jalapeño以及@OpenAI 发布基准测试公告,引发的技术讨论远超其他话题。
本地智能体发布:@perplexity_ai 发布 Portable Computer,成为芯片话题之外最受关注的产品发布。
开发者平台与原生智能体 Web:@OpenAIDevs 宣布 WebMCP Challenge,并宣布ChatGPT 桌面版支持 WebMCP,这表明 OpenAI 正推动网站提供明确的智能体接口。
开源本地任务智能体:@AndrewYNg 介绍 OpenWorker,其将开放式 harness、本地模型与注重安全的工作流结合起来,尤其值得关注。
更贴近现实的编程智能体基准测试:@EinsiaAI 介绍 SWE Refactor Bench,这是本次汇总中更具实用价值的基准测试之一,因为它评估的是整个代码仓库的迁移,而非局部代码修改。