
GLM-5.3-Flash 低成本匹敌顶级模型,且无需依赖 Nvidia
核心要点
- Z.ai 发布了 GLM-5.3-Flash,拥有 3200 亿参数和 100 万 token 的上下文窗口。
- 在 Intelligence Index 上,它的表现几乎追平更大的 GLM-5.3,但每项任务成本仅 0.09 美元,便宜约 7.5 倍。
- 该模型完全运行在中国 AI 芯片上,而 Z.ai 自研软件带来的效率已达到 Nvidia GPU 的水平。
Z.ai 新推出的 GLM-5.3-Flash 性价比出色,但也存在明显短板,同时还展现出值得关注的基础设施能力。
据 Z.ai 介绍,GLM-5.3-Flash 是 GLM-5 系列首个原生多模态模型。它共有 3200 亿参数,其中仅 180 亿处于激活状态;模型采用 MIT 许可证,并提供 100 万 token 的上下文窗口。模型权重已上传至 Hugging Face。
Artificial Analysis 的测评显示,在最高推理强度下,该模型在 Intelligence Index 上获得 57 分。它仅比更大的 GLM-5.3 少 3 分,后者得分为 60;同时与 GPT-5.6 Terra 和 Muse Spark 1.2 持平。
最引人注目的是价格。该指数中的单项任务成本为 0.09 美元,而 GLM-5.3 为 0.68 美元,前者便宜约 7.5 倍。Artificial Analysis 认为,这让该模型位于智能与成本的 Pareto 前沿,也使其成为近期不断给西方供应商带来巨大价格压力的中国模型之一。
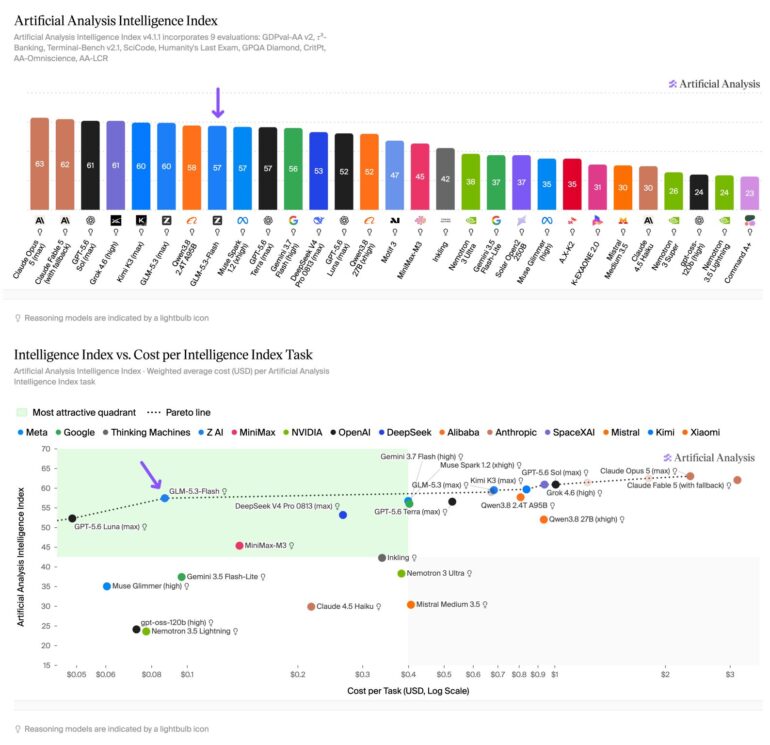
在 Z.ai 的 API 上,GLM-5.3-Flash 的价格为每百万输入 token 0.15 美元、每百万输出 token 0.50 美元,仅略高于 GLM-5.3 价格的十分之一。在智能体任务中,它的表现也不逊于更大的 GLM-5.3。在 GDPval-AA v2 上,该模型的 Elo 得分约为 1770,与 GLM-5.3 和 Grok 4.6 持平,仅落后于 Claude Opus 5。不过,它的 token 利用效率仍然较低。Artificial Analysis 发现,它消耗的输出 token 中约有 90% 用于推理。
用中国芯片替代 Nvidia
在正式发布前,Z.ai 曾以“ox-alpha”的匿名身份在 OpenCode 和 OpenRouter 上测试该模型,并使其成为当周最受欢迎的模型。有趣的是,据 Z.ai 称,这些流量全部运行在中国 AI 芯片上。
SemiAnalysis 报道称,该模型每天处理 100 万亿个 token。此前,人们认为只有顶尖 AI 实验室才具备这样的算力规模。Z.ai 表示,其硬件效率和单 token 成本已经与常见的 Nvidia GPU 相当。SemiAnalysis 认为,这是对“CUDA 护城河”的又一次考验,此前 OpenAI 的新芯片也取得了类似结果。
CUDA 是 Nvidia 架在 AI 软件与显卡之间的编程层。经过近 20 年的发展,几乎所有 AI 框架都针对 CUDA 进行了优化。改用其他芯片,就意味着要重新完成这些工作,包括重写计算操作、调整内存访问方式,以及找出新的性能瓶颈。
因此,Z.ai 基于 SGLang 构建了自己的服务软件,并将处理流程拆分为可以独立扩展的多个阶段。该团队表示,在相同硬件上,这一方案的吞吐量达到了首次尝试的三倍。一个基于 GLM-5.3 的智能体还参与了优化工作。