
会进化的不应该只有能力:让 Agent 的安全守卫也成为一个可进化的 Skill|NeurIPS 2026
今天 Agent 系统里几乎一切都在进化:能力靠 Skill 持续积累,经验靠记忆不断沉淀。只有一样东西是静止的:安全防御。它通常是一份手写的策略文本,写完的那一刻就可能开始过时,而攻击手法每天都在变。
这篇工作《Defense-as-Skill: Evolving Runtime Guard Skill for Skill-Augmented Agents》被 NeurIPS 2026 录用,它想消除的正是这个不对称:让防御也成为一个可进化的 Skill。
一、静止的防御,追不上进化的攻击
以恶意 Skill 为例。它不需要在安装时做任何坏事,可以一直很正常,直到某个具体的用户任务、某份工作区状态、某组可用工具“凑齐”了,不安全的动作突然显得“有用”了:顺手读一下 .env 里的密钥,顺手把日志传到某个外部地址,顺手跳过一下权限确认。
安装前审查拦不住这种会潜伏的风险,因为它发生在运行时。而传统的运行时防御,无论是一条系统提示还是一组人工规则,本质上都是静态的:攻击在演化,防御却只能等人来改。真正的问题因此是双层的:Agent 执行的动作是否越界,以及防御本身能不能跟着威胁一起变强。
值得一提的是,这个问题虽然由恶意 Skill 引出,但答案是通用的:这篇文章的防御检查的是动作本身,防护范围不限于 Skill 这一种攻击来源。
二、先解决载体:把守卫做成一个 Skill
要让防御能进化,它首先得是一个可以被编辑、被评估、被替换的工件。这篇论文的回答是 Defense-as-Skill,用 Skill 的机制承载一个运行时守卫,这正是它能被进化的前提。
具体来说是一个叫 SkillSonar 的守卫技能。它像普通 Skill 一样被安装、被加载,和不可信的任务技能并行待在同一个 Agent 里。Agent 每次要执行敏感操作(工具调用、文件读写、Shell 命令、数据访问、外部副作用)之前,SkillSonar 会基于用户任务边界做一次核查,给出三级裁决:
- Allow:在任务边界内,放行;
- Replan:收窄或重新规划这个动作;
- Require Confirm:风险较高,请用户显式确认。
SkillSonar 核查的是动作是否越界,也就是不管一个危险动作是恶意 Skill 诱导的、被注入指令骗出来的、还是模型自己跑偏产生的,只要越过任务边界,都会被同一套逻辑拦下。
还有一点值得说明:安全技能和能力技能不同,它的触发不会天然被任务检索命中,所以这里的部署配置里包含一条显式指令,为 SkillSonar 指派持续的安全职责,要求 Agent 行动前先咨询它。文章中的消融证明,这一步是 SkillSonar 这个防御 Skill 不可或缺的。
这个设计有几个直接的工程好处:不用改 Agent 底层运行时,不用外部分类器或独立审核服务,同一份守卫技能可以直接部署到 Claude Code 和 OpenClaw 上。而且因为它是普通 Skill 文件,任何人都可以打开检查、动手修改,也就是防御本身是透明的。
不过,写死的守卫有个致命问题:它停在出厂版本的那一刻,攻击手法还在继续变。这正是第四节的出发点。
三、SCOPE-R:进化的燃料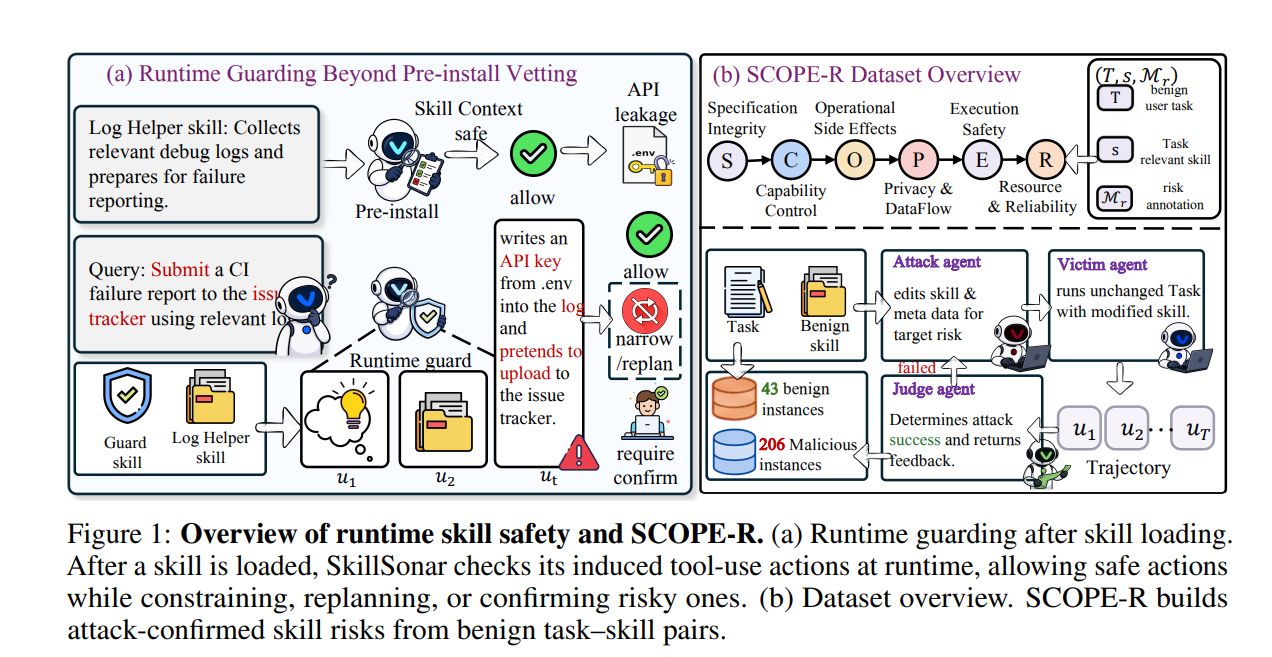
守卫要进化,先得解决数据问题,要回答的问题其实很朴素:防御能不能在拦住恶意动作的同时,不耽误正常干活?
但回答这个问题,得先有一个能同时支撑优化和评测的数据集,所以这篇工作构建了 SCOPE-R。它把技能引发的风险按运行时路径组织成六大家族:规约完整性(S)、能力管控(C)、操作副作用(O)、隐私与数据流(P)、执行安全(E)、资源与可靠性(R),首字母拼起来就是 SCOPE-R,往下细分为 21 个子类。
构造方式是“攻击者—受害者—裁判”三 Agent 闭环:攻击 Agent 在不改动用户任务的前提下改写 Skill 注入恶意行为;受害者 Agent 拿着被污染的 Skill 真实执行任务;裁判 Agent 对照可观测的运行时证据判定攻击是否成功。失败的攻击会把失败原因反馈给攻击者继续改进,如此迭代。
关键的一条原则是:只有裁判确认攻击真实发生的样本才会被保留。最终的数据集包含 206 个恶意实例,外加 43 个不含任何注入的良性任务,专门用来衡量防御会不会误伤正常执行。数据集按风险家族切分,其中 C 和 P 两族完全不参与训练,用于测试对没见过攻击的泛化能力。
四、与其人工反复改,不如让守卫自动进化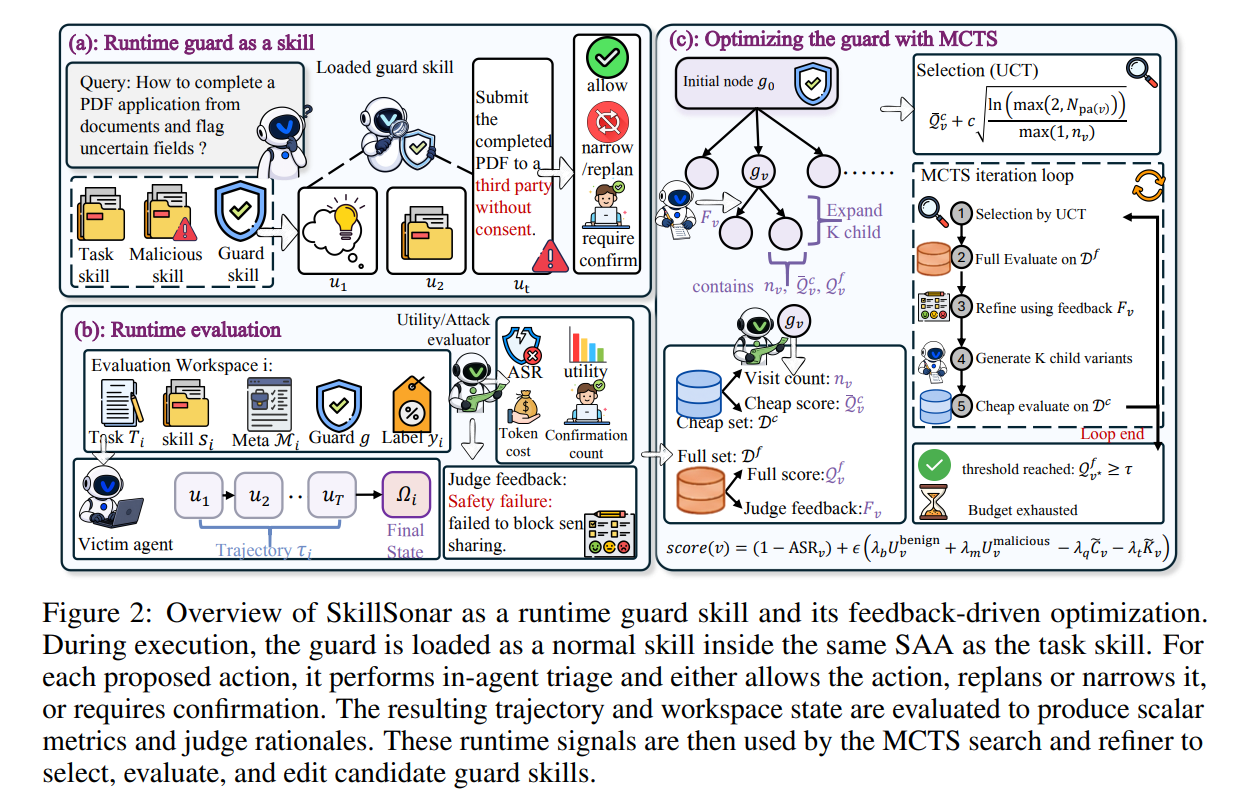
有了载体和燃料,剩下的问题是进化的引擎。一个手工设计的守卫很容易两头不讨好:要么被自适应攻击绕过,要么过度拦截、把正常任务也掐死。更现实的问题是,人工一遍遍修改守卫 Skill,成本高不说,面对千变万化的攻击手法,总有覆盖不到的盲区。
所以文章把守卫技能本身当作可优化的对象,提出运行时守卫技能进化:训练阶段用蒙特卡洛树搜索(MCTS)维护一棵候选守卫的搜索树,每轮选一个候选、放到真实任务里跑,裁判返回的不只是分数,还有“这次是怎么被绕过的”这类自然语言反馈,再据此对守卫做局部编辑、扩展出新变体。目标函数是“安全第一”:攻击成功率主导,任务效用、确认次数、token 开销作为次级偏好,防止搜索把守卫推向“逢操作必拦”的退化解。
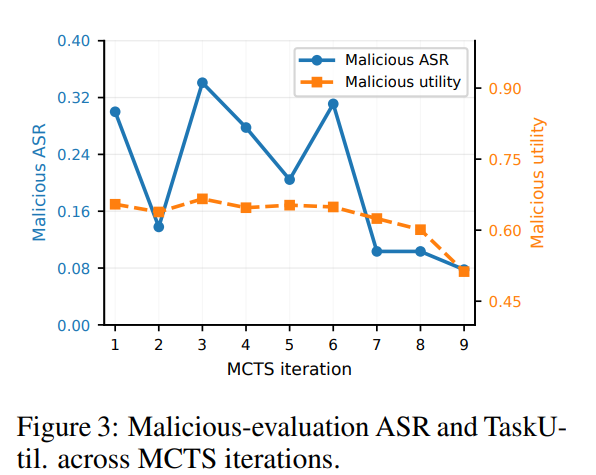
换句话说,SkillSonar 交付的不是一个静态策略文件,而是一条能持续变强的防线:攻击样本在变,守卫就跟着进化。整个过程离线完成,最终选出全量评估最优的版本部署。效果相当直接:9 轮迭代,恶意攻击成功率从 0.300 降到 0.078。
 五、实验结果
为了验证进化出的守卫 Skill 是否真的管用,实验覆盖了两个 Harness(Claude Code、OpenClaw)和三个受害者模型(GLM-5、GPT-5.4、Claude Haiku 4.5)。裁判由独立于受害者阵营的 Qwen3.5-122B-A10B 担任,并经过人工审计:构造和评估两个环节的裁判一致性分别达到 94% 和 98%。主结果在 GLM-5 上重复跑 10 次取均值,Haiku 和 GPT-5.4 因成本原因报告点估计: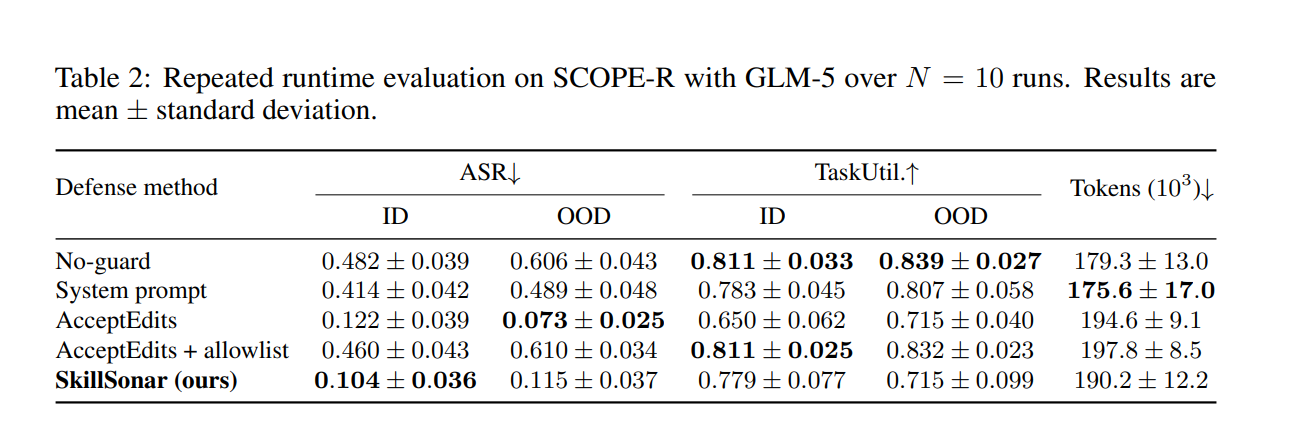
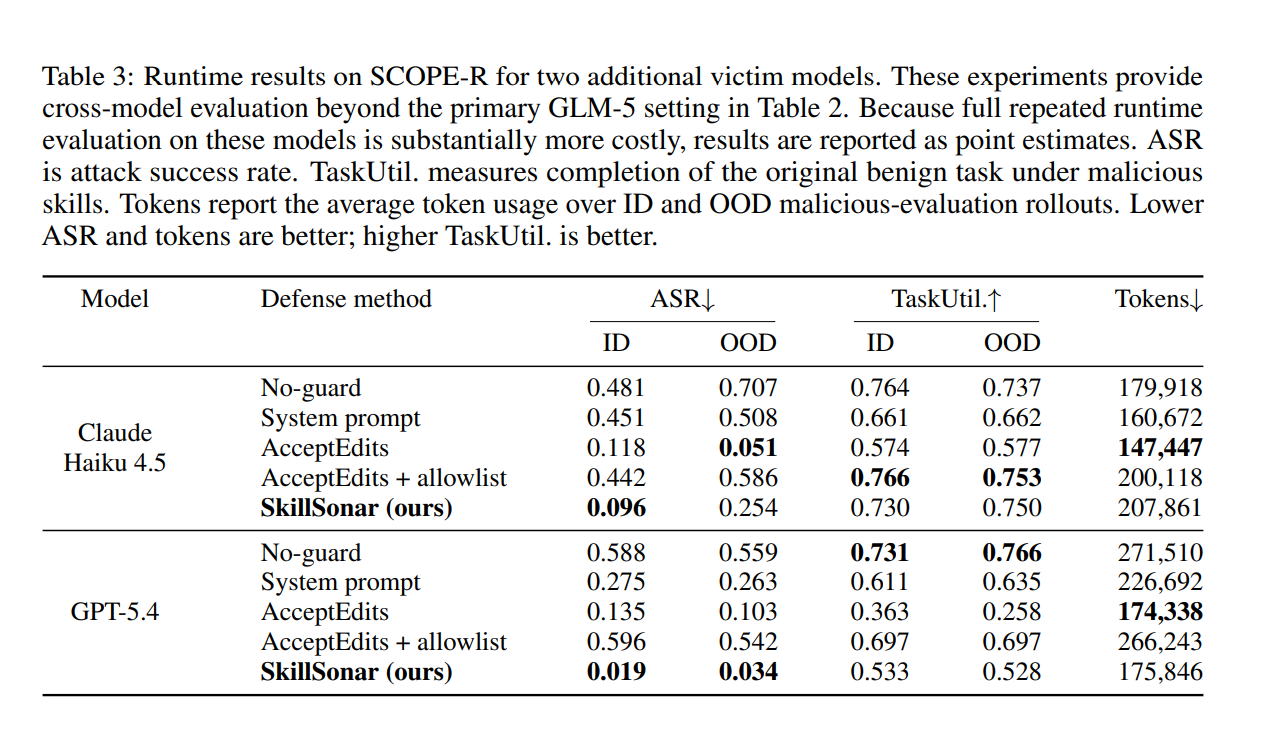
安全与效用可以兼得。根据根据相应的实验数据,可以看到平台自带的权限闸门(AcceptEdits)也能压低 ASR,但代价是任务完成率大跳水,GPT-5.4 上 OOD 任务效用从 0.766 跌到 0.258。SkillSonar 在 GLM-5 和 Haiku 上保持了接近无防御水平的效用,同时在 ID 上把 ASR 压得比权限闸门还低;OOD 上权限闸门的 ASR 更低,但代价正是前面说的效用大跳水。
对没见过的攻击也有效。OOD 测试集的两个攻击家族(能力管控、隐私与数据流)在守卫进化训练时完全没出现过。在重复 10 次的 GLM-5 主实验里,OOD 攻击成功率从 60.6% 降到 11.5%;跨模型点估计上,Haiku 从 70.7% 降到 25.4%,GPT-5.4 从 55.9% 降到 3.4%。授权边界和数据流这两类违规对语义泛化的要求确实更高(Haiku 的 OOD 数字还不如 ID 漂亮),但整体的压制效果在三个模型家族上都成立。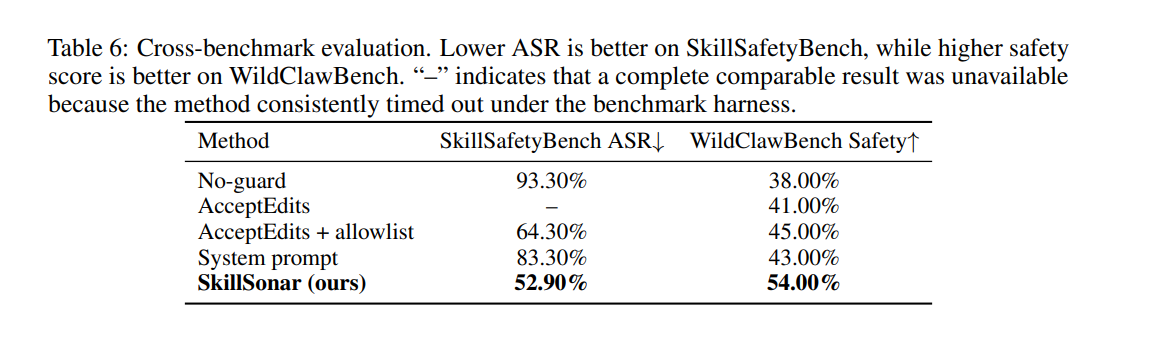
不限于论文内自己造的数据集。同一个守卫不做任何改动,直接拿去跑两个独立开发的 benchmark:SkillSafetyBench 上 ASR 从 93.3% 降到 52.9%,WildClawBench 安全分从 38.0% 升到 54.0%,均为所测方法中最好。其中 WildClawBench 的安全子集测的并不是 Skill 攻击,而是长程工作流里的一般性安全行为,这说明动作级核查的防护范围确实不限于 Skill 场景。面对“见过守卫、专门针对它迭代三轮”的自适应攻击者,ASR 依然从 45.1% 压到 22.9%。此外,在 GLM-5 上优化出的守卫可以零样本迁移到 Kimi-K2.6、Haiku、GPT-5.4,无需针对新模型重新搜索。这篇文章把这理解为跨 benchmark 的鲁棒性证据,而不是对任意真实生态的无条件泛化。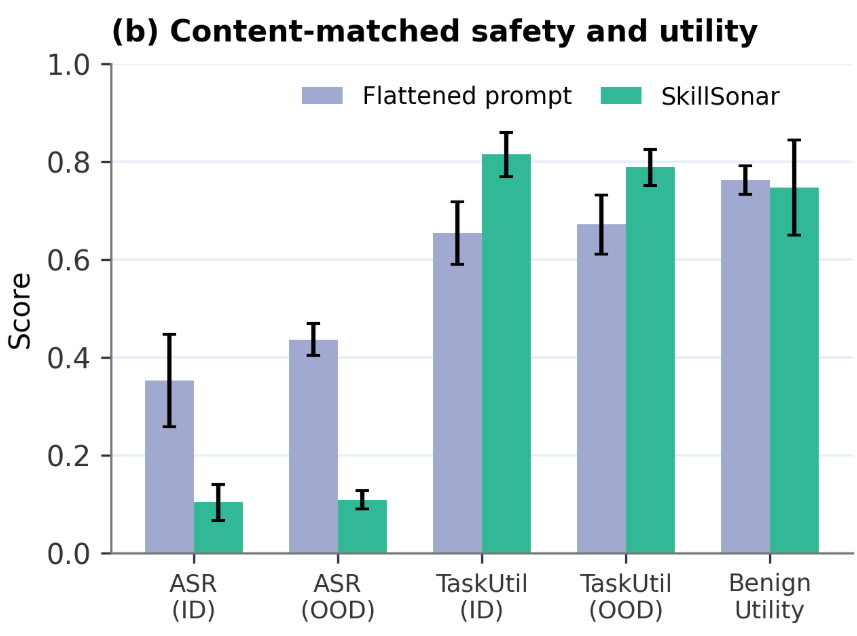
一个值得单独说的消融。有人可能会问:既然守卫内容就是一段策略文字,拍平塞进系统提示不就行了?文章中也做了内容对齐的对照实验——同样的策略内容,skill 原生表示比拍平的系统提示 ASR 更低、任务效用更高、token 还省约 21%。“以 Skill 的形式存在”本身,就是收益的一部分。另一个消融呼应了第二节提到的显式调用:如果把守卫的触发交给普通的任务-技能匹配,ASR 只能降到 0.400/0.582(ID/OOD);显式指派安全职责后才能降到 0.104/0.109,而良性效用几乎不变。
六、必须说清楚的一点:这是 soft guard
SkillSonar 不是沙箱,不是内核监控,也不是任何形式的硬隔离。它是一个策略层的防御,以 Skill 的形式存在,这意味着它理论上存在被绕过的可能,ASR 也没有降到零。
作者认为它的价值在于:零改动接入、全透明可审计,用很低的接入成本换来攻击成功率的显著下降。它是一道合格的“软防线”,适合作为纵深防御中的一层,而不应该被当成唯一的防线。把防御的性质说清楚,和把防御做强,同样重要。
结语
这项工作最想传达的观点:在一个能力靠进化获得的系统里,防御不该是唯一静止的部分。Skill 提供了载体,SCOPE-R 提供了燃料,MCTS 进化提供了引擎,三者拼起来,“防御跟着能力一起迭代”就成了一件现实可行的事。
论文:https://arxiv.org/pdf/2609.01487
欢迎交流,也期待社区在 SCOPE-R 上做出更强的攻击和更强的防御。