Netflix 如何教会大语言模型推荐电影,让你欲罢不能
你的 P99 CONF 免费门票在此——60+ 场纯线上性能主题工程演讲(赞助商内容)
P99 CONF 是专为那些痴迷于高性能、低延迟应用的工程师打造的技术会议。来自当今最具颠覆性产品的资深工程师将带来 60 多场演讲,主题涵盖 Rust、Go、Zig、分布式数据系统、Kubernetes 以及 AI/ML。报名即可免费获得 O'Reilly 完整图书库和学习平台 30 天访问权限、免费电子书,还有机会赢取 500 份限量周边礼包中的一份!
与 3 万名同行一起,抓住这次难得的机会,免费、随时随地向 Chip Huyen(O'Reilly《AI Engineering》作者)、Madelyn Olson(Valkey 共同创建者)以及 Carl Lerche(Tokio 创建者)等专家学习。
额外福利:报名者立即获得 O'Reilly 完整图书库 30 天访问权,参会者还可参加抽奖,赢取 500 份免费周边礼包之一。
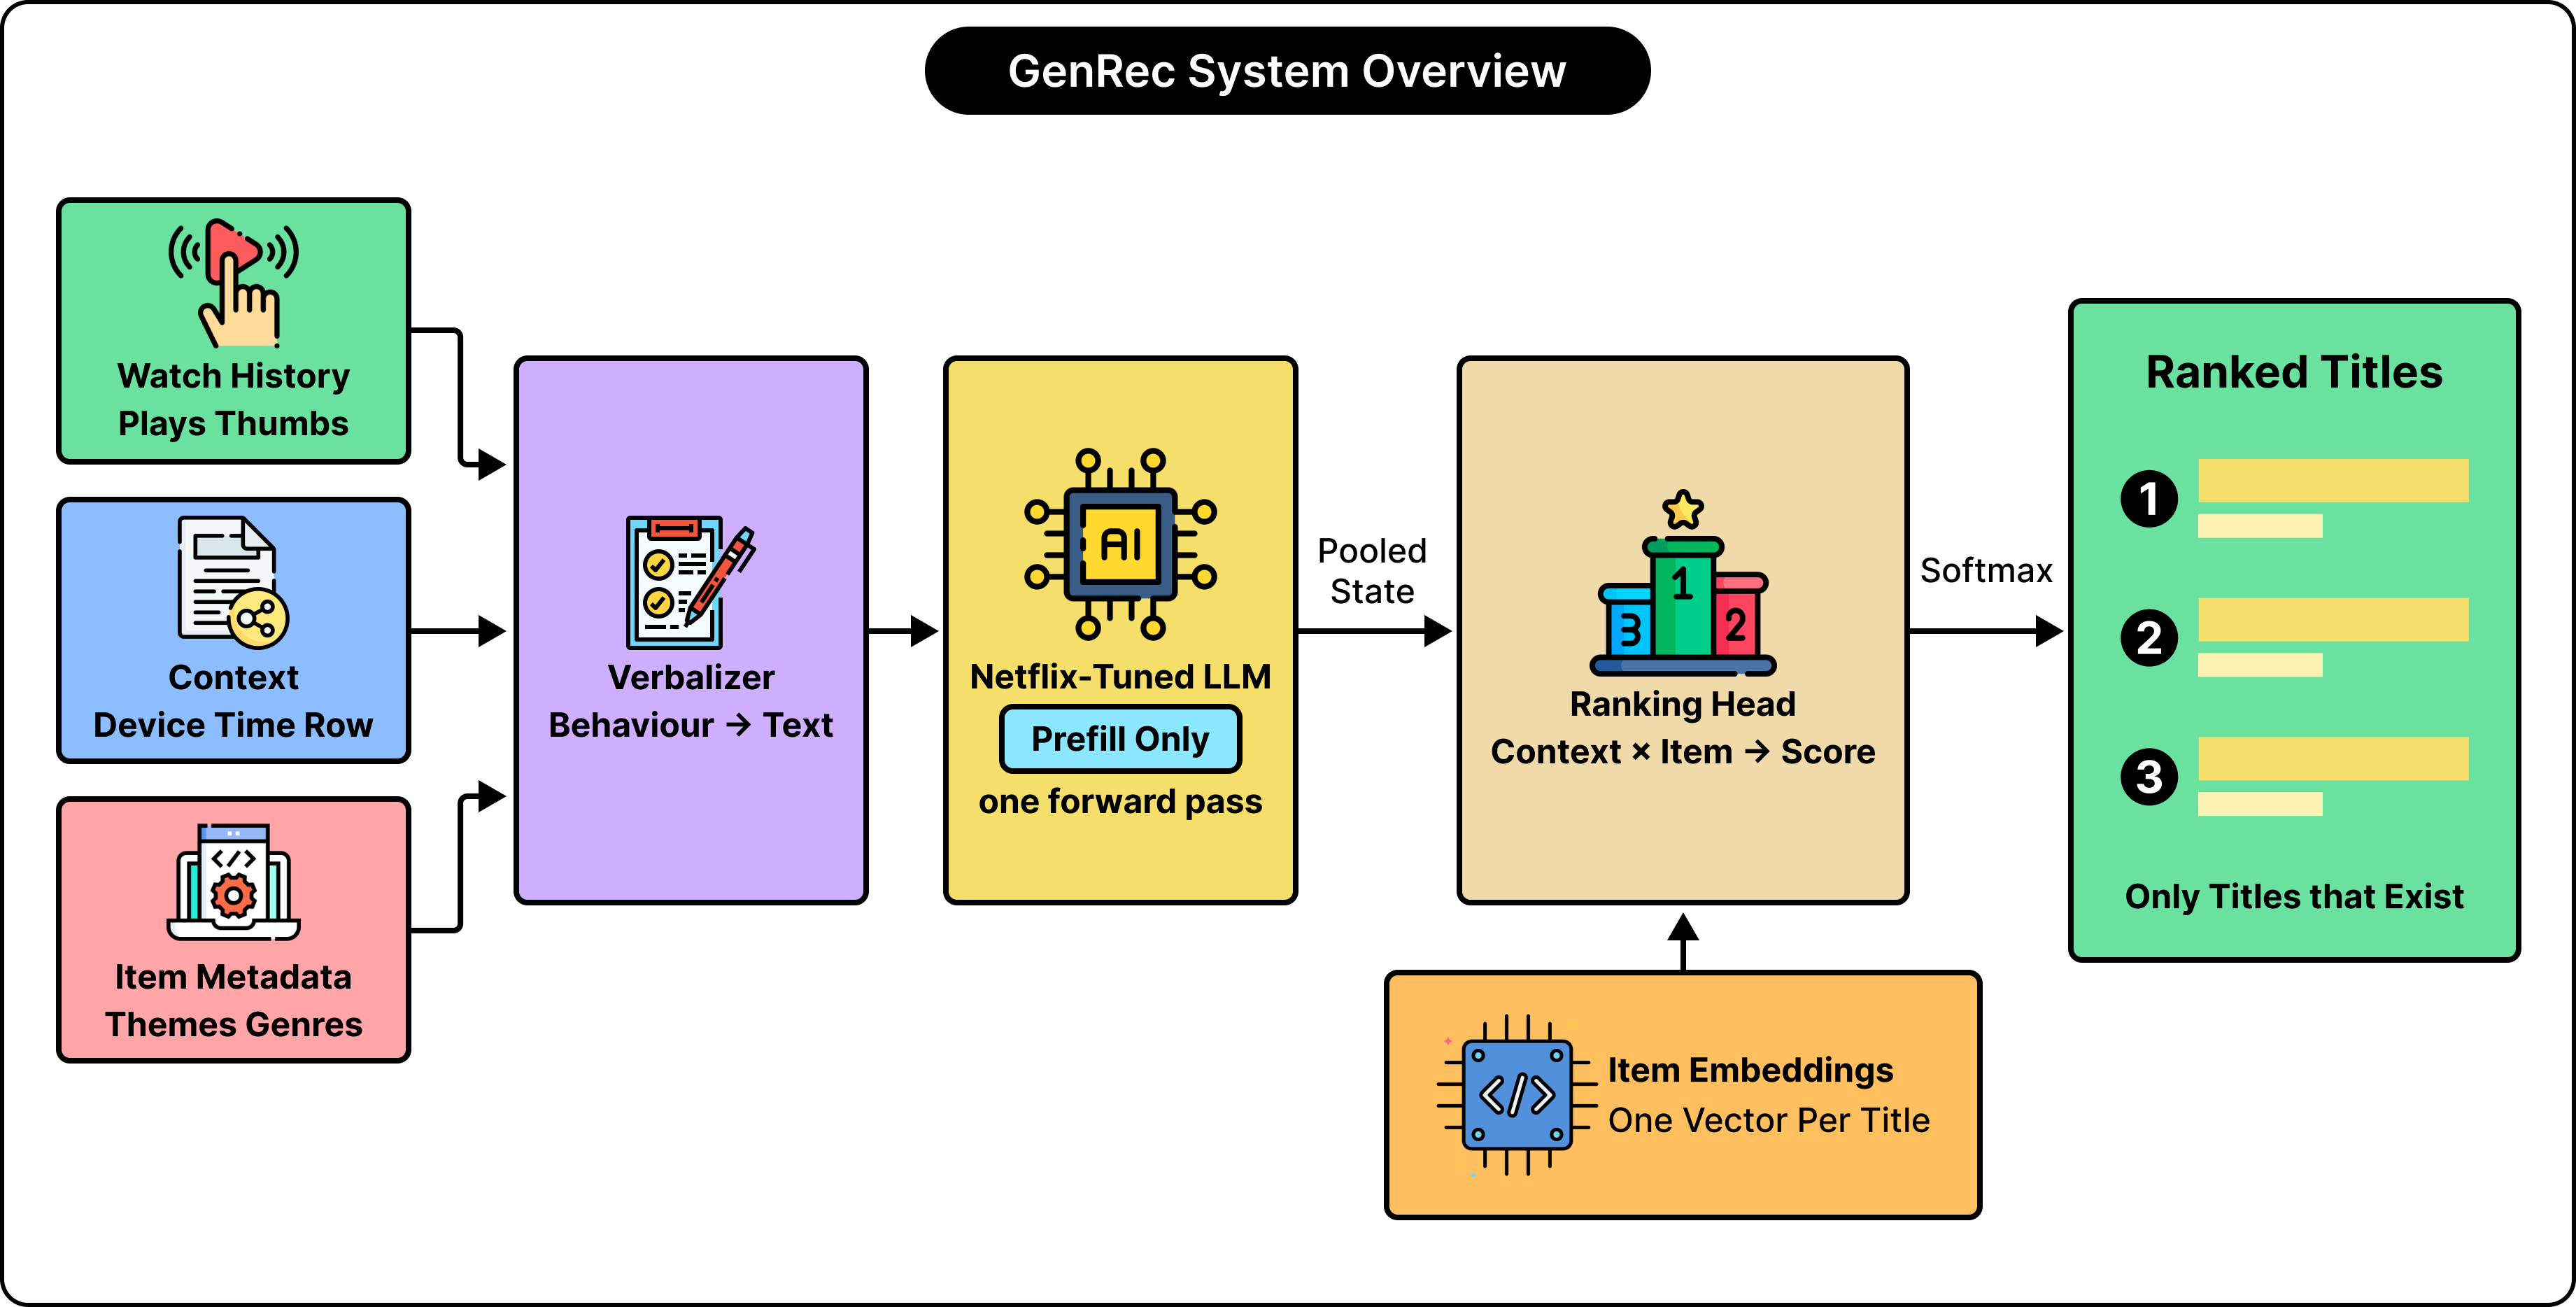
推荐系统是 Netflix 体验的核心组成部分。只要你看过 Netflix,就会发现首页总是推荐大量电影和剧集。而这些推荐往往恰好是你感兴趣的内容,并且会根据你的观看历史实时调整。
Netflix 最初的推荐引擎基于上千个人工特征构建,涵盖用户、物品及交互数据。它还采用了多种专门架构,分别负责推荐任务中的不同功能模块。
虽然这套架构多年来经历了不少变化,但依然相当复杂,接入新的使用场景成本很高。与此同时,大语言模型(LLM)取得了长足进步,在向用户推荐内容这方面的能力提升显著。凭借更广博的世界知识和对语言的理解,LLM 很擅长挖掘不同事物之间的关联,还能用自然语言生成推荐,这是额外的好处。不过,像 Netflix 这样的公司,不可能随便拿一个现成的 LLM 来生成推荐。
这正是 Netflix 工程团队打造 GenRec 的原因。
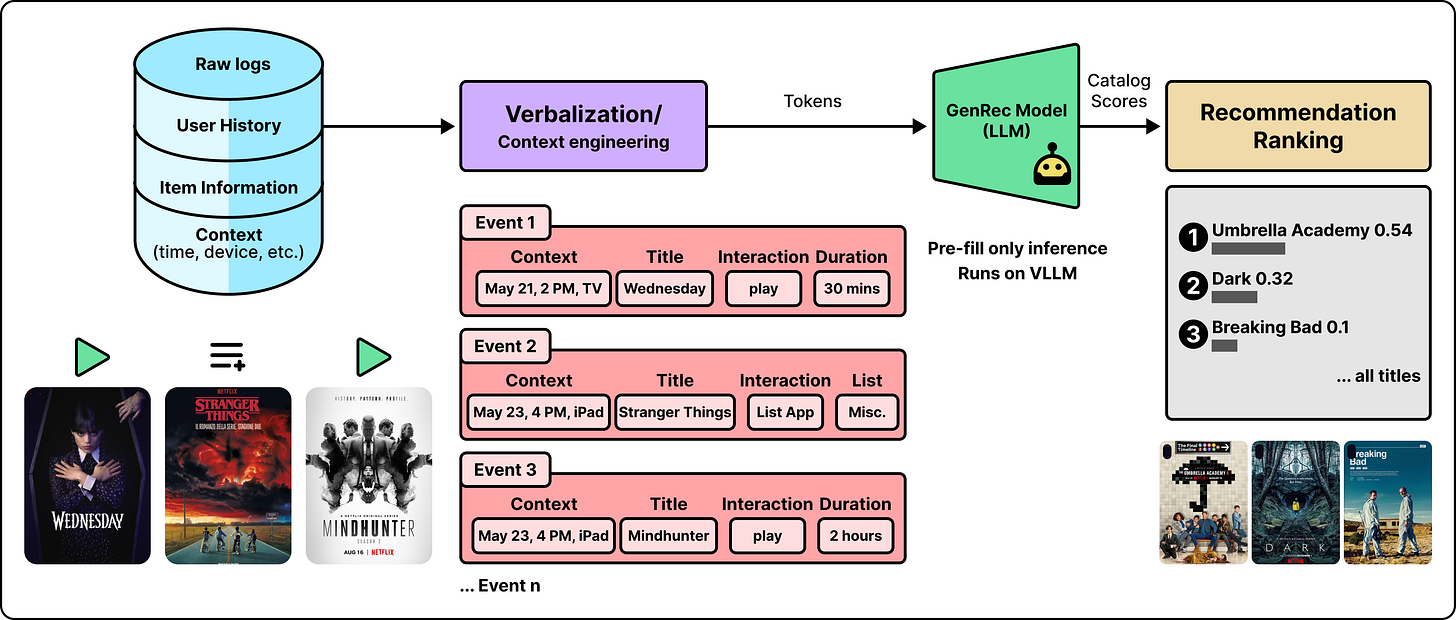
GenRec 的核心思路是:利用 LLM 更深入地理解用户的观看历史,从而给 Netflix 上流媒体播放的各种电影和剧集打分。但你不能直接把一个用户看过的电影或剧集列表丢给通用 LLM,就指望它给出有趣的推荐。Netflix 必须对基础模型做一系列调整,才能让它适配自家的内容和会员行为。
本文将介绍 GenRec 的构建过程,主要涵盖以下内容:
推荐系统的基本问题
Netflix 为什么需要新方案
语言模型为什么能帮上忙
GenRec 的两个训练阶段
如何利用用户行为构造训练样本
GenRec 学到了什么,以及如何生成推荐
Netflix 如何评估 GenRec
声明:本文基于公开渠道分享的信息整理,参考资料见文末。如有不准确之处,欢迎在评论区指出。
推荐系统的基本问题
推荐系统要回答一个基本问题:推荐列表的第一位应该放什么?
这个问题的答案,决定了该向特定用户展示哪些内容以及展示顺序。在 Netflix 上,这些内容可以是电影、剧集、游戏和其他类型。
推荐顺序至关重要。用户的注意力是有限的,他们可能只看几个标题就会做出选择。如果在这段时间内没有找到感兴趣的内容,用户甚至可能离开平台去别处寻找。即使目录中确实有用户可能喜欢的项目,若未能及时呈现,也可以认为推荐系统未能履行职责。
推荐顺序由称为“排序器”的组件负责。它根据项目对特定用户在特定场景下的匹配程度分配分数。分数越高,项目在推荐列表中显示的位置越靠前。为了确定这个分数,排序器需要大量信息,例如:
成员的交互历史,以了解其喜好与厌恶。
项目元数据,以理解内容本身的主题。
观众所用设备的详情、当前时间、语言或地区。
Netflix 的 GenRec 能够对整个内容目录进行排序,也可以处理较小的内容集合。你可以使用 Top-K 排序,即排名最高的 K 个项目,其中 K 是你所需的项目数量。
目标不仅限于预测用户下一步会点击或播放什么。Netflix 希望推荐能够满足用户的内容,让他们持续回归并观看更多。这意味着用户播放电影是一个强烈信号,表明其对推荐感兴趣,但并不保证该推荐具备长期价值。
AI 的下一个瓶颈是部署。(赞助内容)
将新模型转化为融入实际客户运营的系统,仍然充满挑战。
这种能力断层催生了一类新型工程师的需求:他们能在代码、用户场景与生产结果之间自如切换。由此,前置部署工程师应运而生。
《2026 前置部署工程师自由劳动力市场现状报告》梳理了围绕这一工作形态形成的新兴人才市场格局。
Netflix 为何寻求新路径
Netflix 早已拥有相当成熟的推荐模型。其生产系统依赖成千上万种特征、表征和专用模型组件。所谓特征,可理解为帮助模型做出预测的输入信号。例如,我们可以告知推荐模型用户近期看了多少部喜剧电影或剧集;也可以告诉模型用户距离上次观看某项内容已过了多久;或者用户看完整部剧的频率有多高。所有这些特征都有助于模型预测用户接下来想看什么。
创建一个新特征,需要明确哪些观测数据至关重要、如何计算其数值,以及如何为训练和预测环节提供这些数据。这就是特征工程。成熟的系统还需要能够解读用户行为序列,例如,用户连续按顺序观看某部剧的多集,与用户先后点开多部互不相关的剧却在一段时间后弃看,二者传达出的信息截然不同。
随着时间推移,这类系统日趋复杂。若想支持新内容类型或新产品界面,就需要添加更多特征,调整模型架构,并开展相应的底层设施建设,还要运行多组实验以确保系统稳定运行。
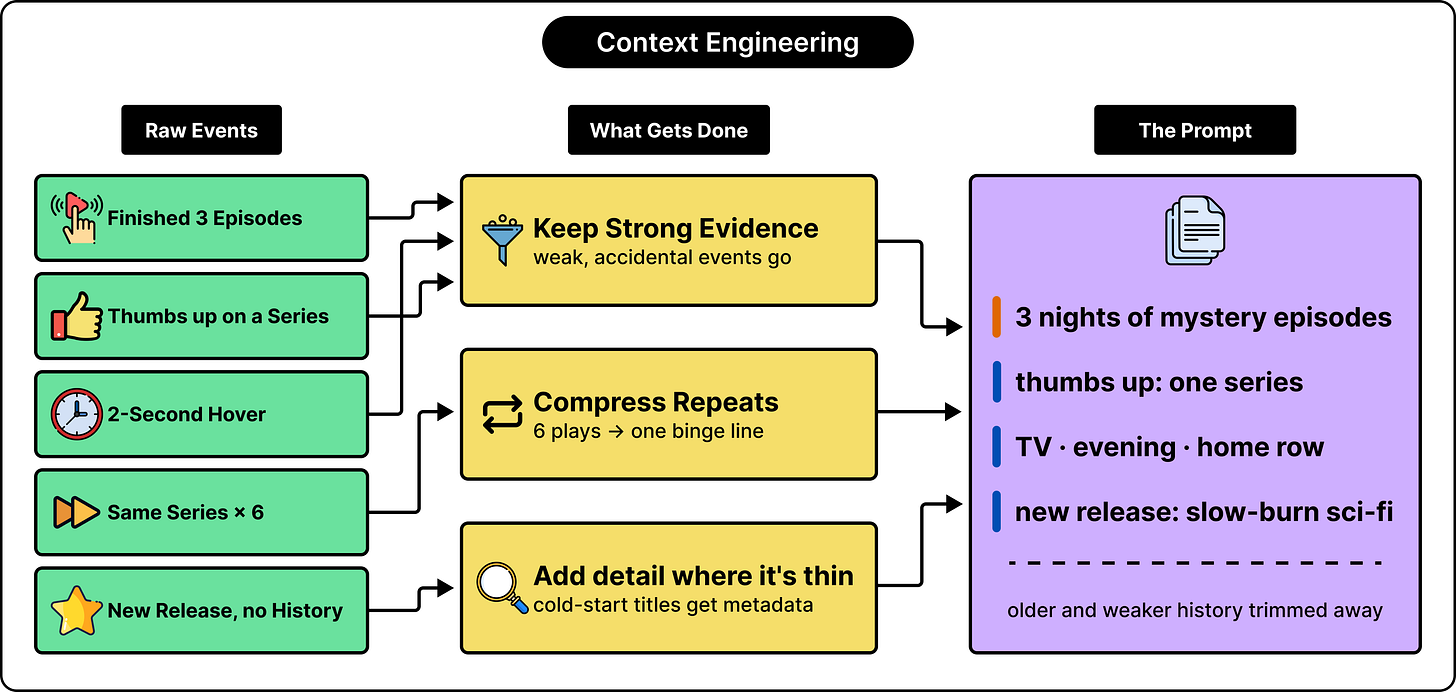
Netflix 工程团队希望验证一种能力更强的 LLM 能否承担更多这类语义解读工作。与其为每个信号单独做特征工程,系统可以直接用自然语言描述相关行为和影视内容,再训练模型去理解这些描述。
为什么语言模型能派上用场
LLM 在训练过程中学到了大量词语、概念和描述之间的关联。
这意味着它在理解影视内容以及用户与内容的互动上,起点要高得多。举例来说,两部电影可能属于不同类型,但主题相近。LLM 能根据简介捕捉到这种联系,也能理解用户的观影历史和行为。
Netflix 把这种将信息转成文本表达的过程称为 verbalization(语言化)。
不过,通用 LLM 并不是一个好的推荐系统,问题不少:它可能偏向全球热门内容,可能推荐根本不在片库里的作品,也无法实现个性化。正因如此,Netflix 没有采用现成的 LLM,而是让工程团队自研了 GenRec。
GenRec 把 LLM 的语言理解能力与专门训练结合起来,使其能够适配 Netflix 的片库。LLM 为数据解读提供了基础,但 Netflix 还需要教会它什么是好的推荐,并控制它可推荐的范围。
GenRec 的两个训练阶段
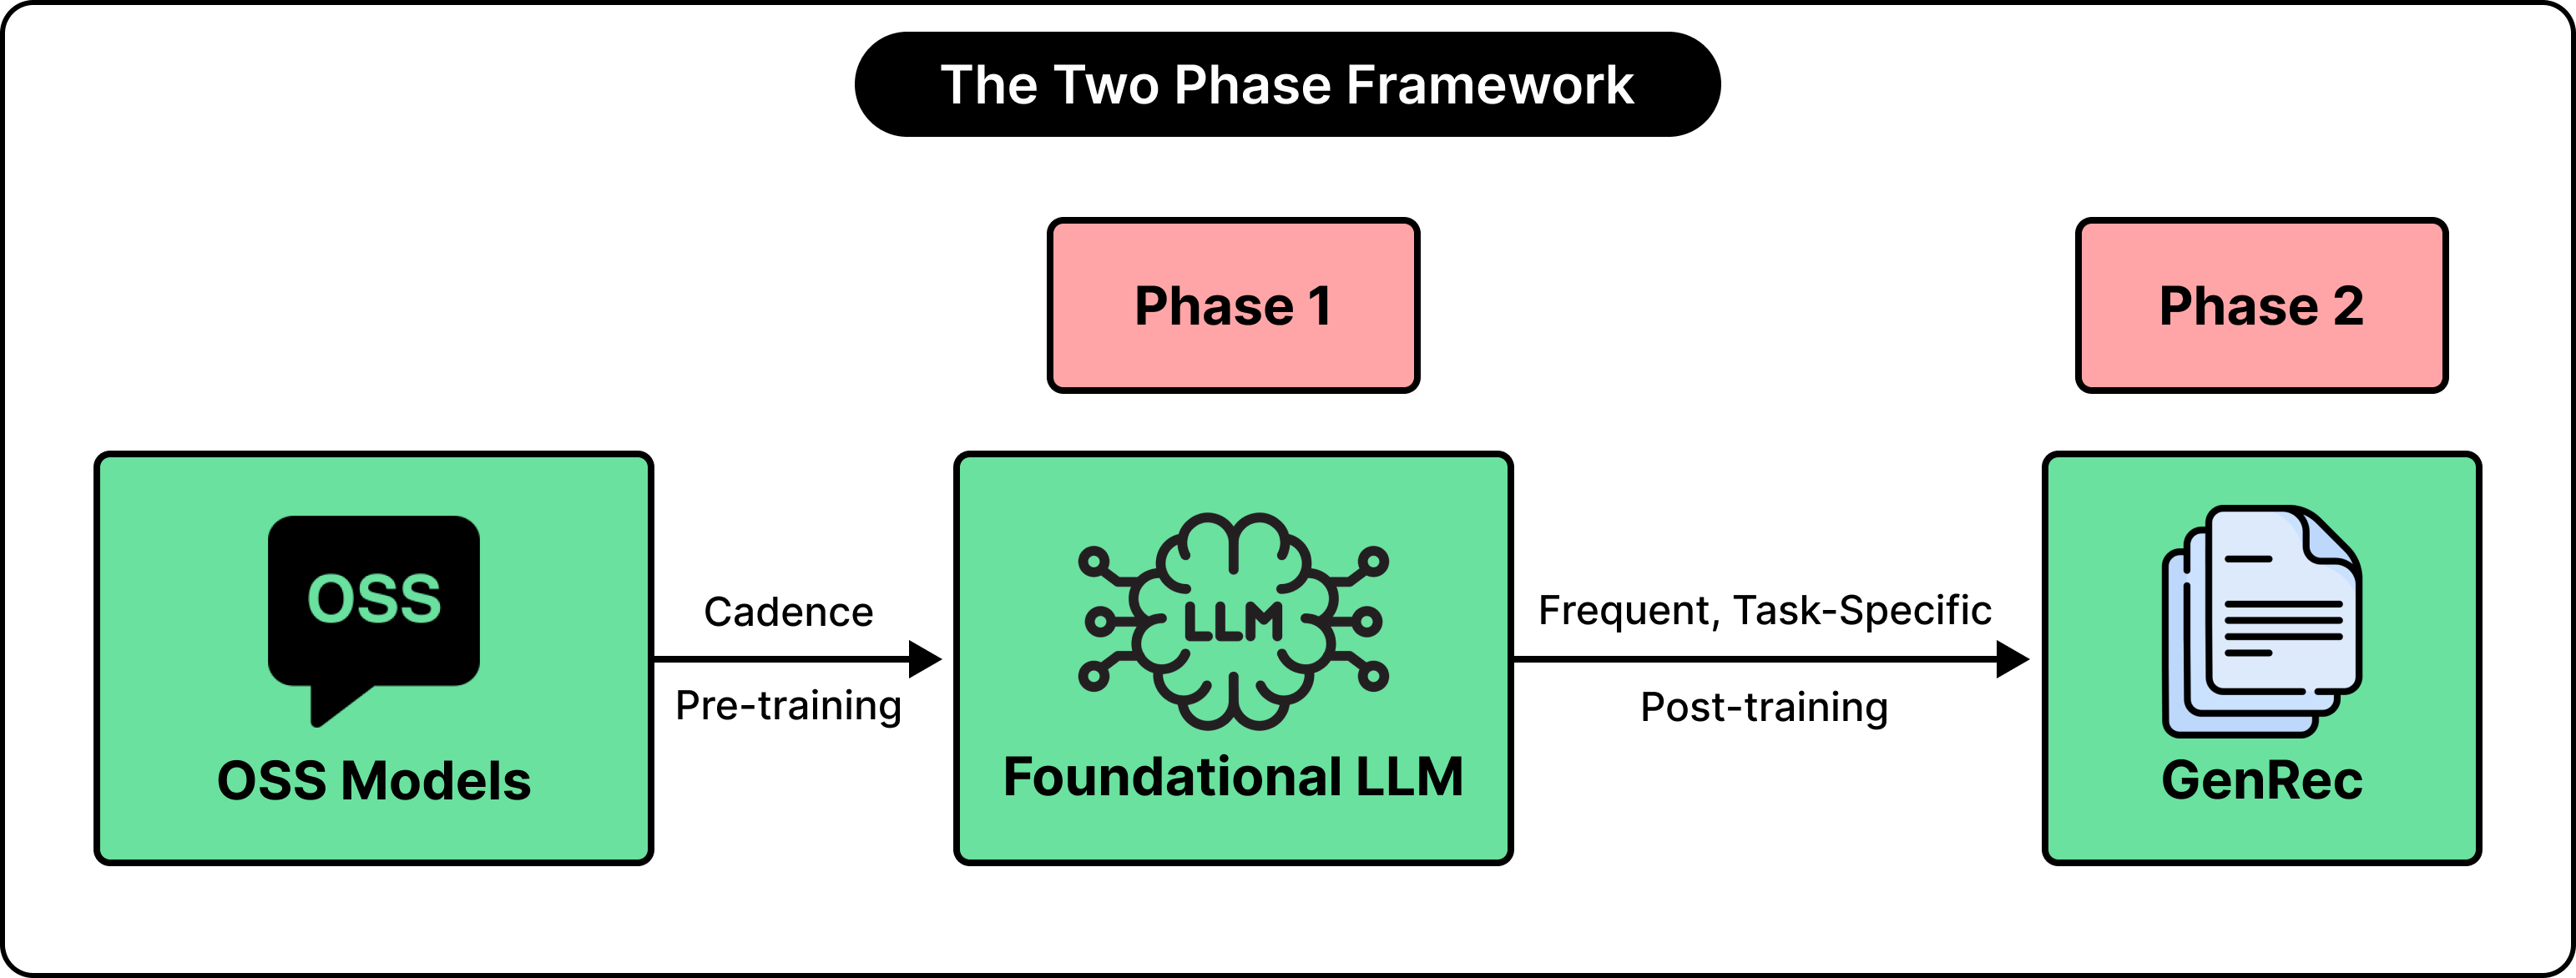
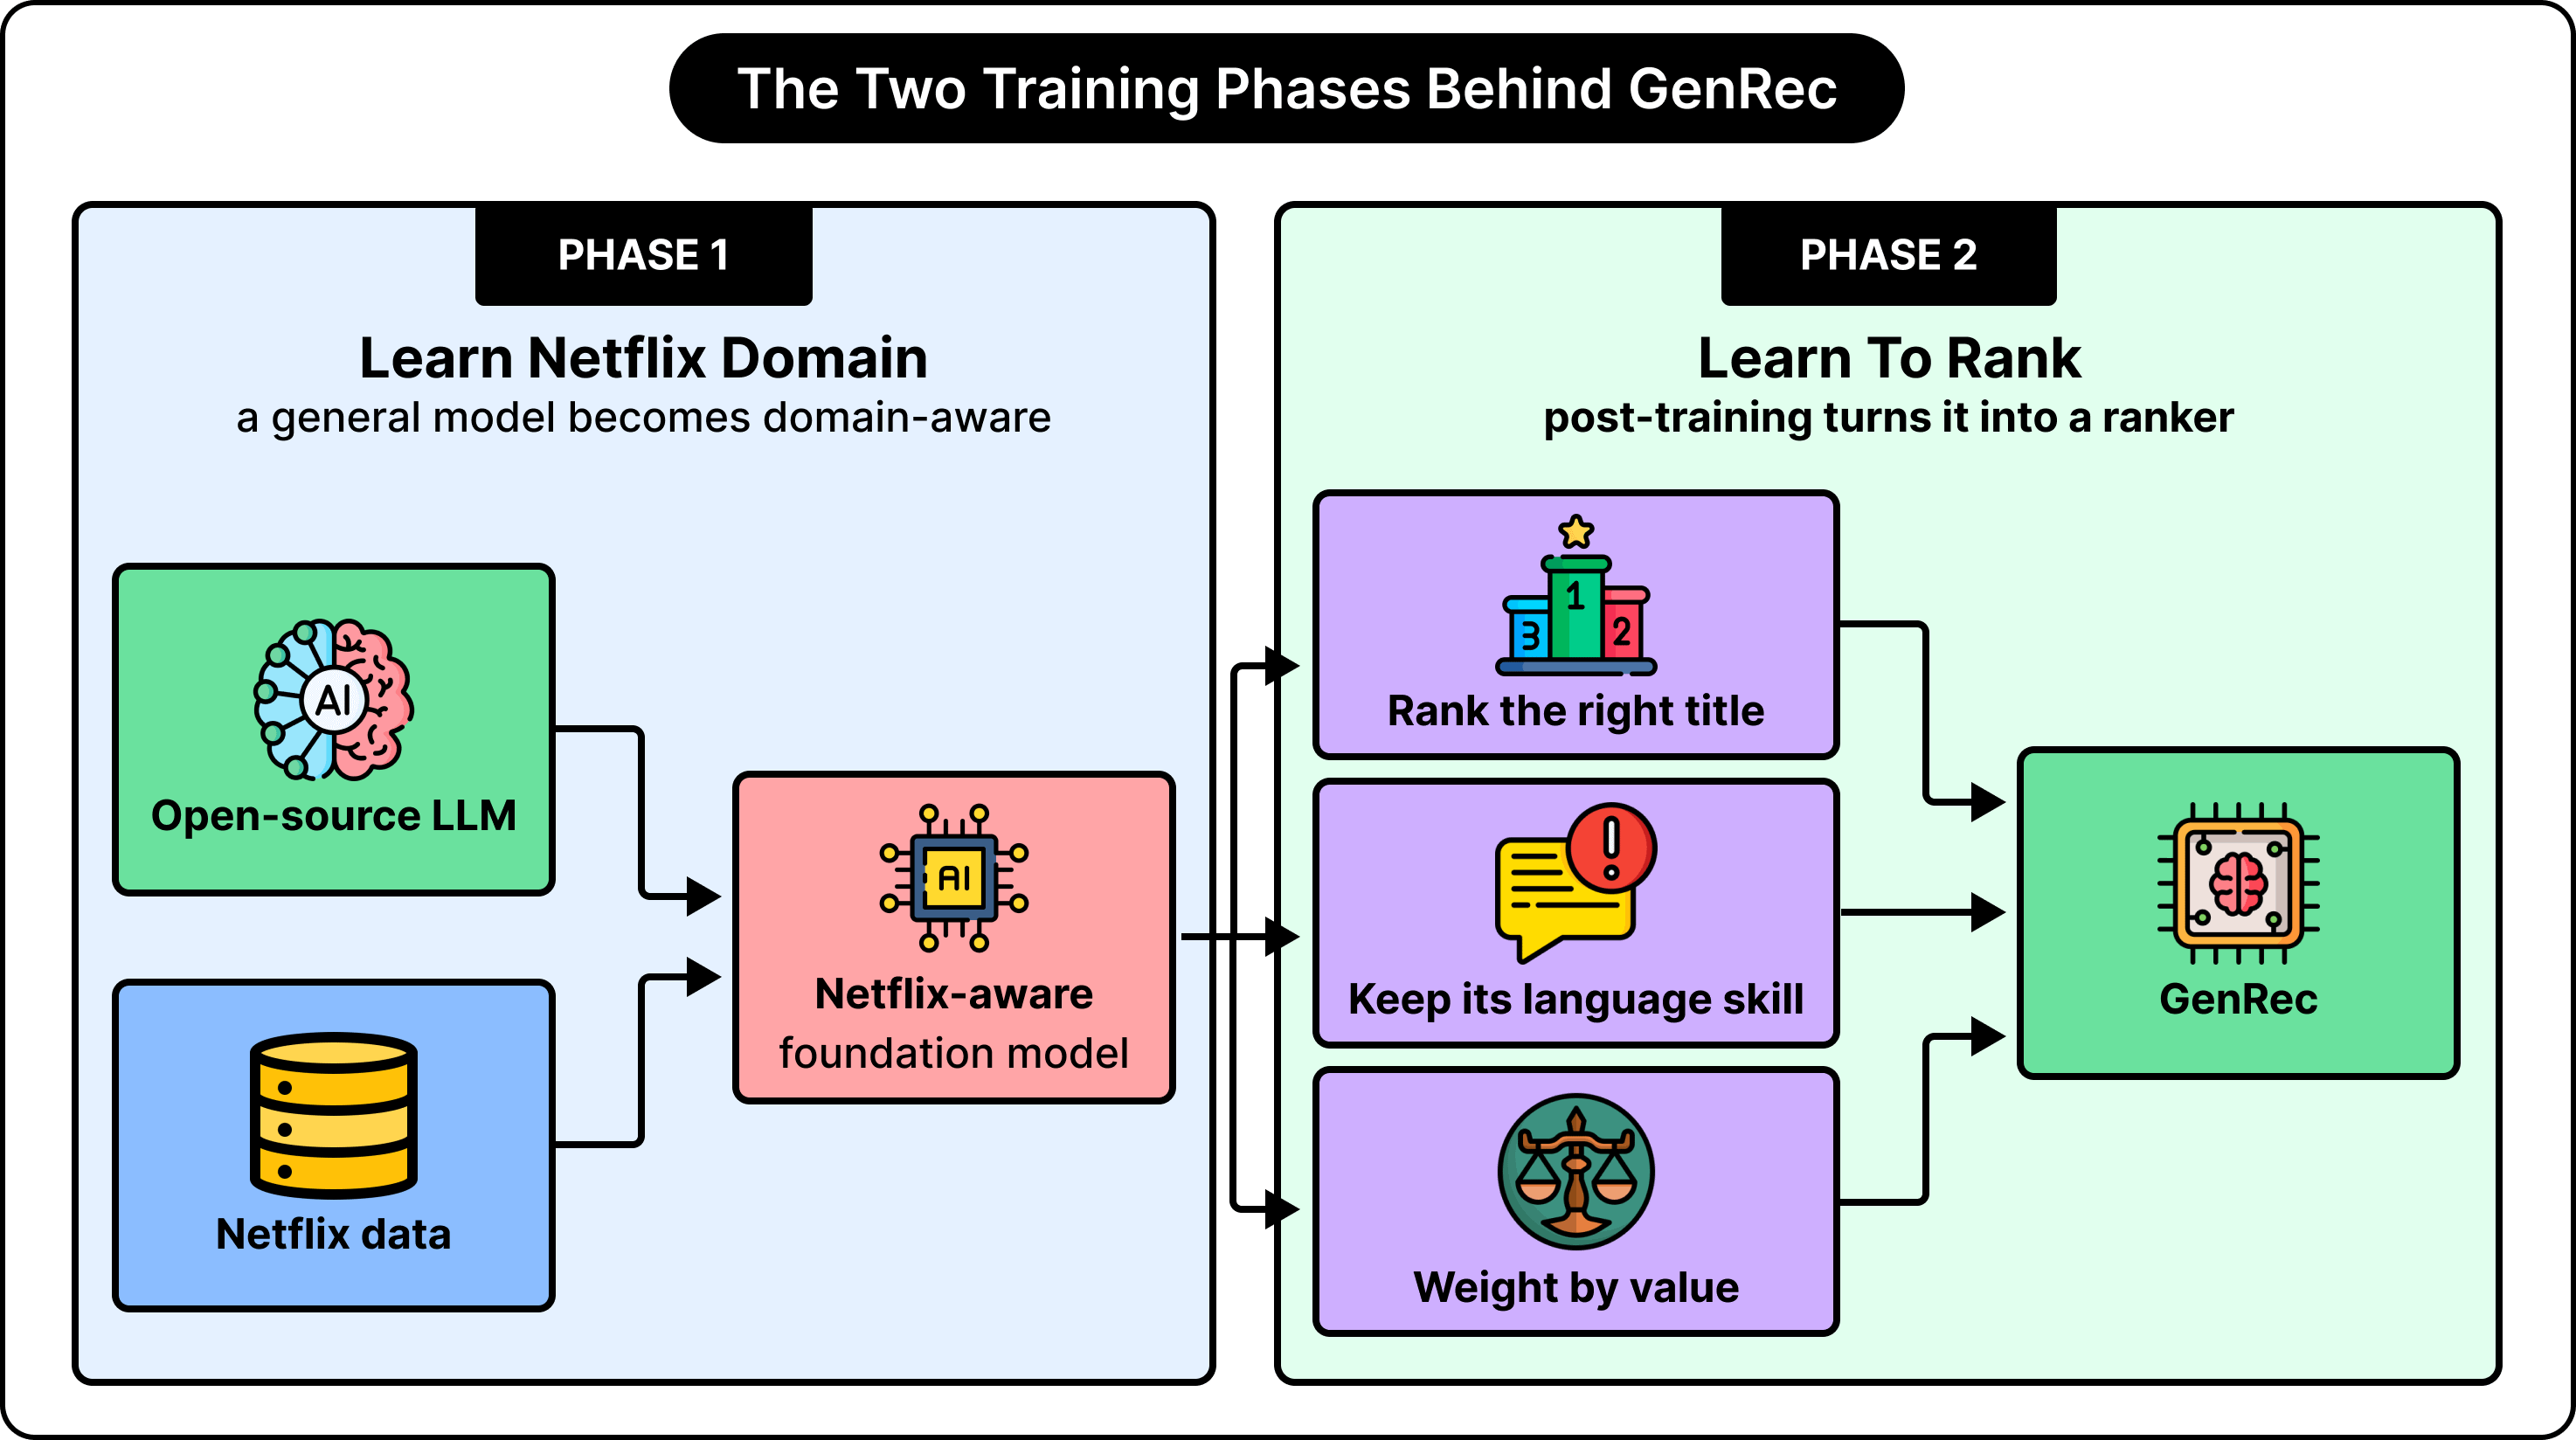
Netflix 分两个阶段训练 GenRec,各有不同目标。下面详细看看这两个阶段。
阶段一:构建理解 Netflix 业务的基础模型
这一阶段旨在让 GenRec 熟悉业务领域。团队让模型学习和解读与 Netflix 相关的信息,之后才会针对推荐排序这一特定任务进行训练。
Netflix 工程团队从一个开源的 LLM 基础模型入手,并利用 Netflix 的专有数据进行适配。你可以把基础模型理解为一种用途广泛、可支持多种应用场景的模型。完成这一步后,模型便掌握了 Netflix 的内容特征和用户行为。
这个新训练出的模型将成为多条研究线的起点。该模型相当稳定,Netflix 只在部分情