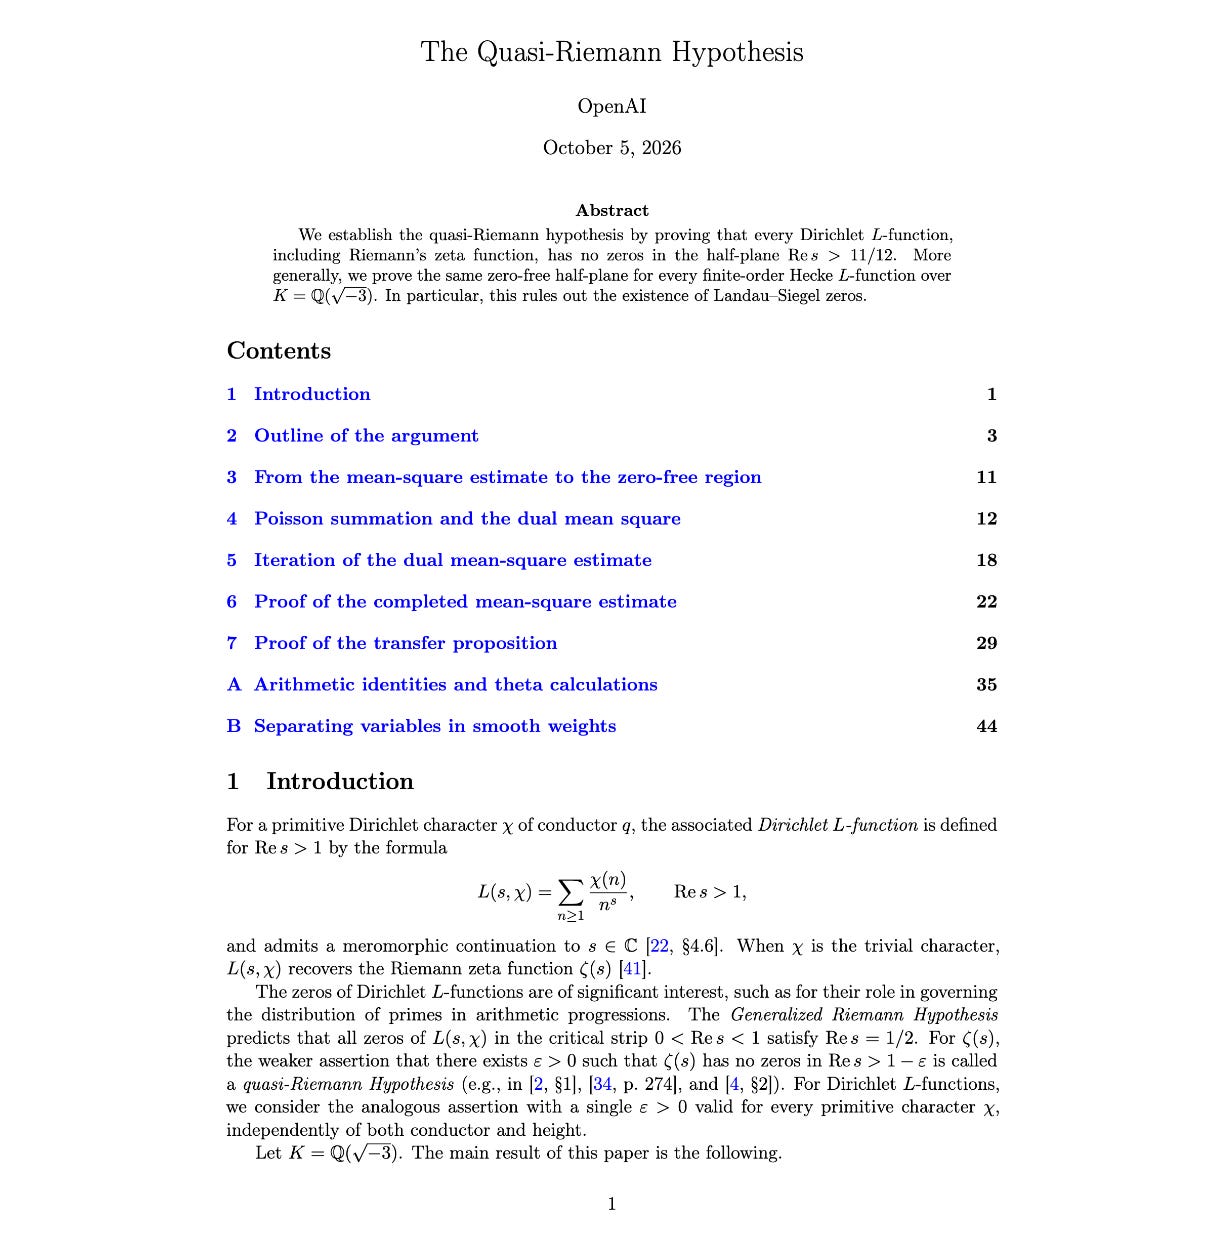
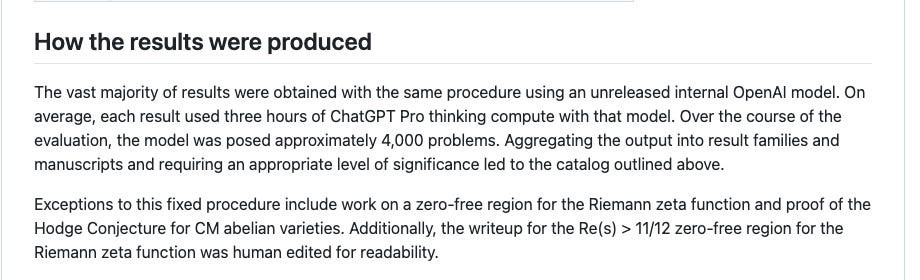
OpenAI 发表 722 篇论文,解决前 500 个开放数学问题中 90 个,被称为百年来数学界“最重大时刻”
AIE NYC 的门票即将售罄!下周见!
往期 AINews 的订阅者可享折扣。
为 Mistral 干一杯吧,他们在由近期 D 轮融资支持的全新 3800 GB300 集群上,发布了一款性能不错的 Large 4 “Le Chonk” 模型。
不过,OpenAI 内部 Navier-Stokes 数学模型取得的其他成果更抢眼——这些成果以博客、代码库和推文的形式公布。来自 Anthropic 的其 Navier-Stokes 竞争对手给出的评价最高。尽管他个人与 OpenAI 有些过节,但评价毫不含糊:“这显然是数学史上最重要的时刻。”
levent@__alpoge__对 Quasi-Riemann 证明没有 Siegel 零点(以及其中其他许多精妙之处),致以极高的敬意。我总在声称这些问题触手可及,却从未真正深入钻研,现在真该打自己一巴掌了。 有一些悲剧故事,与他们的用户被抢先发表或产生冲突有关……10 月 6 日,晚上 11:39 · 99,400 次浏览29 条回复 · 100 次转发 · 1,630 个赞
当然这说法需要一些限定,但大多数专家似乎都认为,它解决了数学前 500 个未解问题中的许多。
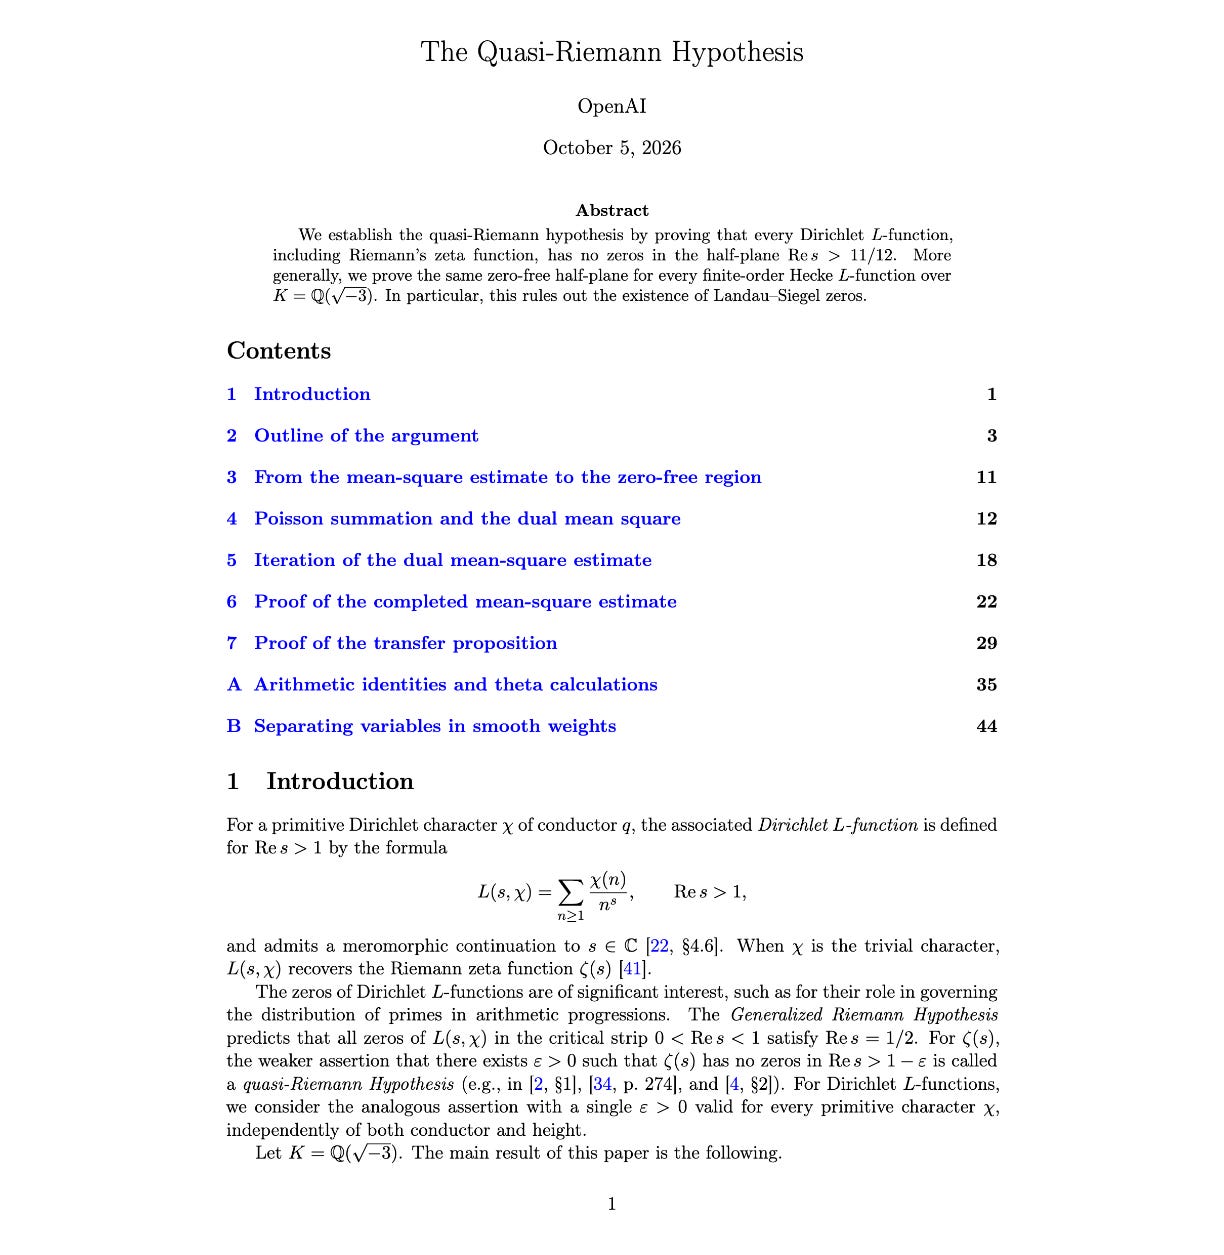
其中成果 003,即准黎曼假设,其分量介于菲尔兹奖级别的成果和“200 年来数论界最重大的突破”之间。
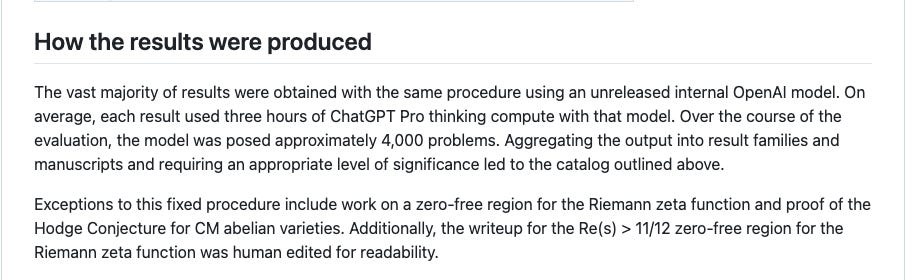
更令人震惊的是实现方式——之前解 Navier-Stokes 用了 88 小时和 1 万个 agent,而这次这些解平均只需 3 小时的 ChatGPT Pro。
2026 年 10 月 5 日至 6 日的 AI 新闻。我们浏览了 12 个 subreddit、544 个 Twitter 账号,Discord 暂无新增内容。AINews 网站支持检索全部往期内容。提醒一下,AINews 现已是 Latent Space 的一个栏目,你可以自行选择是否接收邮件!
AI Twitter 回顾
OpenAI 发布一个未公开内部模型产出的 722 篇数学论文
发布方式:OpenAI 在其公开的 GitHub 仓库中发布了一系列来自内部前沿模型广泛的数学成果。据称,他们曾就发布方案咨询过高等研究院关于数学与人工智能的独立咨询小组。
备受关注的声称结果:以下内容由个别评论者报道,尚未经过独立验证。
整数乘法:一位贡献者强调了一个快于 n log n 的整数乘法结果。
弹性逆问题:另一位评论者特别提到了弹性逆问题的唯一性结果,论文称该问题在三维情况下自 1994 年以来一直未获解决。
邻近千禧年问题的研究:评论者指出在黎曼假设、霍奇猜想和 BSD 猜想方面取得了部分进展。
数学家的反应:Levent Alpöge 赞扬了准黎曼(quasi-Riemann)和无 Siegel 零结果,并称其为“数学历史上最重要的时刻”。他还提到了其他实验室用户涉及的抢发(scooping)和利益冲突问题。
成果构成:有分析指出,约 20% 的结果为证伪或反例。该分析认为,这一数据削弱了“AI 在数学上的主要突破依赖暴力搜索”的观点。
质疑与开放问题:
预期错误:Will Depue 预计 部分结果经不起细致审查。他搭建了 citedbyagi.com 来追踪该系列文章引用了哪些人类学者论文。
算力背景:Teortaxes 指出,三个小时算力“并不算多”。
泛化能力:François Chollet 提问:在有利于 RLVR 的数学和代码领域取得的进展 是否具备泛化性,非可验证领域的瓶颈是否仍受限于人类数据。
Mistral Large 4(“Le Chonk”):发布、定价及争议评测
Mistral Large 4 预览版:该模型拥有 1T 总参数和 49B 激活参数,原生支持多模态,API 现已开放(官方公告)。开放权重承诺将于十月底发布。
训练状态:RL 训练 “仍在进行中,未见饱和迹象”。
算力:该模型在欧洲基于 约 3,800 台 Grace Blackwell 集群 完成预训练和后训练。目前 更大规模的模型正在训练中。
定价:每百万输入/输出 token 分别为 $1.36/$4.18,缓存输入 $0.14,前两周享 5 折优惠(Artificial Analysis)。
上下文:Vals 和 Artificial Analysis 列出的上下文窗口为 512K。OpenRouter 显示 1M 上下文,最大支持 256K 输出。
Mistral 官方宣称:
人工评测:Mistral 称在STEM、CAD 和金融的人工评测中胜过 GLM 5.3,agentic coding 则持平。
编程基准:官方称在 DeepSWE 上超过 GLM 5.3,在 Terminal-Bench 4 上超过 Kimi K3(Rozière)。
盲测评审:在 Surge 的盲测编程评审中位列第二,仅次于 Opus 5。
第三方实测:
Artificial Analysis:Intelligence Index 得分 38,与 GPT-6 Luna (max) 持平,是美中之外模型中的最高分。Cyber Index 得分 50,CyberGym-E2E-AA 得分 82%。每任务成本 $1.13,是同等智力水平开源模型的 4 倍以上。
Vals:HLAB 上排名第一的开源权重模型,Vals Index 开源模型中排第 9。大量上下文使用使其成本高达每次测试 $13.78。
临床分诊:有评测者报告在 669 项临床决策中并列第一,零严重遗漏。
争议与保留意见:
拒答效应:Cline 认为网络安全方面的领先主要归功于拒答更少,称 Opus 5.5 和 Astra 有约 40% 的任务被自身安全过滤拦截。
指数差距:批评者指出它在 AA 的指数上落后于 GLM-5.3,甚至不如 GLM-5.3-Flash。
开源权重质疑:Hugging Face CEO 指出,权重没放出来之前就不算开源权重模型。
配置问题:Mistral 提醒说,许多报告的失败源于没有设置
reasoning_effort="high"。
蒸馏假说:Yuchen Jin 作为尚未证实的观点推测,西方与中国的开源模型差距反映的是中国实验室蒸馏 Anthropic 和 OpenAI 模型的能力。
开源权重与 API 模型发布:Embeddings、图像、决策模型
EmbeddingGemma 2:Google 首个原生多模态开源 embedding 模型,在统一空间中涵盖文本、代码、图像、视频和音频。基于 Gemma 4 构建,采用 Apache 2.0 协议发布(DeepMind)。
规格:采用模块化设计,提供 740M 全模态、440M 文本+视觉、570M 文本+音频和 270M 纯文本变体。支持 768 至 128 的 Matryoshka 维度,8,192 上下文长度,MTEB Code 测试成绩提升 14%(Phil Schmid)。
资源占用:活跃内存约 191–567MB,单次处理最长 5.5 分钟音频或 58 帧视频(Google)。
生态支持:支持首发集成 llama.cpp、vLLM、Ollama 和 Unsloth。亦支持浏览器 WebGPU 运行,单次查询耗时约 20–70ms(Victor Mustar)。
Nano Banana 2.1:Google 更新的图像模型正在 Gemini 应用、AI Studio、搜索及广告产品中逐步推广(Google)。
决策模型成为产品类别:
OpenAI Decisions API:公开测试版基于 GPT-6 Luna,支持返回断言、选项或评分。OpenAI 声称其速度比 Responses API 快至 10 倍(OpenAI Devs)。定价为每百万输入 token $0.10,且输出不计费($0.10/M input with no output charges)。
Perplexity:pplx-decider-v1.1-27b 开放权重,每百万输入 token 成本为 $0.02,并在 HF Decision Index v0.3 榜单中位列第一。
对 Jev 的独立评估:Vals 发现 Jev 在事实核查上达到了 GPT-6 Astra 97.5% 的准确率,而成本仅约为其 1/500。Jev 在 LegalBench 上排名垫底。
质疑观点:Theo 认为模型路由应用场景在选择智能等级方面“毫无用处”。
其他开源发布:
Ling 3.1 Flash:该模型总参数量 560B,激活参数 25B,在 AA 指数上得分 41 分,较之前的 20 分大幅提升。每百万 token 定价为 $0.30/$0.90,权重即将发布。
Reflection Beam:知乎对 Beam 的分析指出,这是一个 501B/23B MoE 架构模型,预训练数据量达 23.8T token。RL 阶段使用了约 10,500 张 GB300 显卡持续四周,训练过程可容忍高达 107 个策略版本的样本陈旧。能力教师和对齐教师通过多教师同策略蒸馏合并。
Kandinsky 6.0:该视频模型采用 MIT 许可证,支持同步音频,并提供vLLM-Omni 首日支持。
搜索评估:OpenAI 内置网络搜索在 AA Search Index 上得分 74 分,在提供商中排名第 5,每任务成本约 $0.05。其在 BrowseComp 表现最弱,在 26 个参与者中排名第 13。
安全、控制与评估完整性
控制干预意识:更新后的 CIAware 基准显示,GPT-6 Astra 在检测控制干预方面已接近饱和。而五月份大多数模型的表现还接近随机水平。作者认为这会泄露监控器的信息,削弱控制协议的有效性(合著者)。
可观测性成为攻击面:METR 警告说,未对齐的智能体可能会入侵人类用于监督它们的日志审查工具。它建议将所有记录和操作都视为不可信输入。
Anthropic 网络安全验证计划:Anthropic 正在为通过验证的防御者扩大开放 Mythos 5.1、Opus 5.5 和 Sonnet 5.5 的使用权限,并新增针对渗透测试、红队演练等授权攻击性工作的分层。
开源模型的网络安全之争:Arvind Narayanan 认为,GLM 5.3 发布数周没有出事,应该下调对其网络风险的估计。Nathan Lambert 也指出,这场争论中闭源模型的风险被低估了。
基准审计:
AutomationBench Verified:对 Zapier 的 AutomationBench 进行审计后发现了 206 个验证器 bug。修复后,1,235 次 Kimi K3 运行中有 27.9% 的评分发生了变化。
AI 担任领域主席:AI 对全部 6,617 篇 ICML 2026 论文的排序与人类评价一致性很弱,Kendall's τ ≈ 0.08。
智能体事故:一个主动行动的智能体以创始人的身份把他的银行余额发到了公司 Slack。
研究、基础设施与开发者工具
研究亮点:
H-JEPA:一种分层世界模型,在降低规划计算量的同时,将 Visual AntMaze 成功率从 18% 提升至 73%。
基座模型中的提示线索:在输入前添加“Okay”等简单提示词,可将 Olmo-3-7B 在 MATH-500 上的得分从 42% 提升至 78%。作者指出,RL 训练主要使模型更倾向于生成此类提示词。
感知框架的蒸馏(Harness-Aware Distillation):学生模型在未见过的 ALFWorld 任务上达到 63.4% 的准确率,优于最佳基线模型(47.0%),并超越了其 8B 教师模型。
其他论文:亚马逊的 循环扩散语言模型;Meta 面向研究智能体的 MIRA 元推理器 以及 Priced Guidance(通过压缩率衡量 LLM 研究的创新性)。
优化器主张:据报道,ANVIL III 在 124M 至 1.2B 参数规模下,损失值比 Muon 低 0.020–0.028 nats。作者称,这意味着在 8 倍 Chinchilla 规模下可节省 50% 的计算资源,且调参难度低于 Muon。
RL 基础设施:
CoreWeave:其 RL Rollouts 功能可在约 15 倍于重新部署的速度 下热切换权重。该功能曾将 Nemotron 3.5 Lightning 在 BrowseComp 上的成绩从 36.97% 提升至 45.45%。
Scale AI:Scale 开源了 AgentEnv,这是其所有 RL 环境的基础。
Marin:Marin 535B-A23B 的公开训练运行已 过半。
硬件:
Intel 18A 拆解:SemiAnalysis 拆解了 Intel 18A 的 PowerVia 技术,这是首款商用背面供电设计。
ClusterMAX 评级:在发现 Slurm 的 GPU 资源声明存在错误且 Kubernetes 中无法使用 RDMA 后,ClusterMAX 将 FarmGPU 评级为“表现不佳”。
开发者工具:
OSC 7501:Mitchell Hashimoto 发布了一项终端规范,允许程序报告其状态。他提到,目前超过 250 个 agent 编排器仍依赖启发式规则来判断 Claude Code 等工具是在工作还是处于阻塞状态。
Bun:下一个版本将附带
bun check,这是用 Rust 编写的类型检查器。OpenAI API 套餐:OpenAI 将其付费套餐从五个精简为三个;最高级的 Grow 套餐现在要求累计支付 500 美元。
Agent 产品:Codex 的Auto-review 功能现已免费,且其审查不消耗套餐用量。Claude Code 的云端会话会在新的 VM 上运行每个任务。Cursor 增加了iOS 远程 agent 控制功能。
行业与政策
中国芯片敞口:Epoch 发现,中国受半导体供应冲击的敞口约为美国的 2.7 倍。其脱钩模拟结果显示,中国的实际 GNE 将下降约 3%,而美国仅下降 0.6%。
中国 AI 收入:Epoch 的另一份报告梳理了中国 AI 公司的五类收入来源。报告指出,2025 年火山引擎承载了中国公有云约 50% 的 AI tokens。
高通–华为更正:高通向第一财经表示,将其交易与华为的 LogicFolding 技术联系起来的报道是不实的。高通还驳斥了其为净支付方的说法。
热门推文(按互动量)
Mistral 发布 Large 4 “Le Chonk” (45.6K)
OpenAI 公布内部模型的数学成绩 (19.0K)
ChatGPT Meetings 插件 (3.9K)
OpenAI Decisions API 公测 (2.8K)
AI Reddit 精选
/r/LocalLlama + /r/localLLM 精选
1. 本地 AI 工具发布
* [google/embeddinggemma-2 · Hugging Face](https://www.reddit.com/r/LocalLLaMA/comments/1wz5va3/googleembeddinggemma2_hugging_face/) (互动量: 543): Google DeepMind 发布了 `google/embeddinggemma-2`,这是一款 `740M` 参数的开源多模态嵌入模型,它将文本/代码、图像、视频、音频及混合输入映射到共享的 `768d` 空间,用于设备端的检索、RAG、分类及聚类。该模型采用模块化编码器—— `270M` 文本、 `170M` 视觉、 `300M` 音频——支持 `8K` 上下文长度、100 多种语言、任务指令前缀以及 Matryoshka Representation Learning,允许截断为 `512/256/128d` ;部署建议包括禁用未使用的编码器、对截断向量进行 L2 重归一化,并优先使用 `bfloat16`/`float32` 而非 `float16` 。社区链接包括 `llama.cpp` 的 支持 PR #30054、 `ggml-org` 的 GGUF 权重,以及 `Unsloth` 的 GGUF 权重。 评论区气氛轻松:用户对 Google 再次发布嵌入模型感到惊讶,并注意到音频嵌入对他们是新事物。一名评论者反对社区帖子主要链接到 Unsloth 的转换版本而非 Google 的原始模型页面,认为应当将发布功劳归于 Google。 * `google/embeddinggemma-2` 的 `llama.cpp` 支持已在 ggml-org/llama.cpp#30054 中合并,使其无需依赖 Hugging Face Transformers 堆栈即可实现本地推理工作流。相应的 GGUF 转换版本可在 ggml-org/embeddinggemma-2-GGUF 获取,这对计划使用该模型进行本地数据集索引或检索流程的用户具有重要参考价值。