
Strands Decider 2B:一款小型开源决策模型
今年早些时候,我们发布了 strands-labs,这是一个让用户接触前沿 Agentic AI 方法的地方。今天,我们很高兴推出 Strands Decider 2B:这是一款专为快速实验、本地开发和创新优化的小型决策模型。
Strands Decider 属于一种新兴的决策模型或“System 1”模型。自本月 TypeSafe AI 发布 Jev 以来,这类模型备受关注。与能生成任意输出的 LLM 不同,决策模型的设计目的是在选项集合中做出选择(例如:“字符串‘turn on the lights’是跟咖啡机有关的吗?是或否。”,“短语‘sihamba ngokushesha’是什么语言?英语、祖鲁语还是荷兰语?”),并给出简单的数值评分(例如:“短语‘this is the best doc I’ve ever read’的情感是积极的吗?在 0 到 1 之间打分。”)。
作为灵活性降低的交换,决策模型在特定规模下运行更快、能力更强,总能从预选项集中给出答案,且延迟极低。
反过来,这种方法(在单次并行处理中生成所有输出)使其解决复杂问题的能力远不如推理模型。此外,由于无法生成文本,它也不适合编码、聊天机器人、文档摘要等常见的 LLM 任务。
此外,决策模型为每个决策提供高质量的可靠性评分(即“我有多确信这个‘是/否’是正确的?”),这是主流 LLM 推理 API 无法提供的。它还能高效地对同一提示词提出多个问题。这些特性的结合使其非常适合驱动许多开发者使用 Strands Harness SDK 和最近推出的 Strands Harness 构建的 Agentic 工作流。我们预计,在未来几周、几个月乃至几年里,这类模型将推动 Agentic AI 领域的众多有趣创新。
Strands Decider 2B 是我们在这一创新方向上的首次贡献。这是一个拥有 20 亿参数的模型,适配本地 CPU 或 GPU 运行,能在几十毫秒内回答具有实际意义的问题。在同类模型中,其准确率与校准表现极具竞争力。我们已在 GitHub 开源了 strands-decider-2b,并在 Hugging Face 上提供了权重,同时公开了构建模型所使用的全部训练数据和脚本,为开启你自己的创新之旅提供了绝佳起点。
模型架构
核心思路是:基于预训练的 LLM 主干(Qwen3.5-2B),移除 LM head 以去除其文本生成能力,并用一个 pointer head 替代。该模块会为选项对主干提供的答案进行评分,通过将每个选项位置的隐藏状态与 <answer> 位置的隐藏状态进行比对来实现评分。这个头部结构非常紧凑,总参数量仅略超百万。此外,主干部分通过秩为 16 的 LoRA 适配器进行了微调。
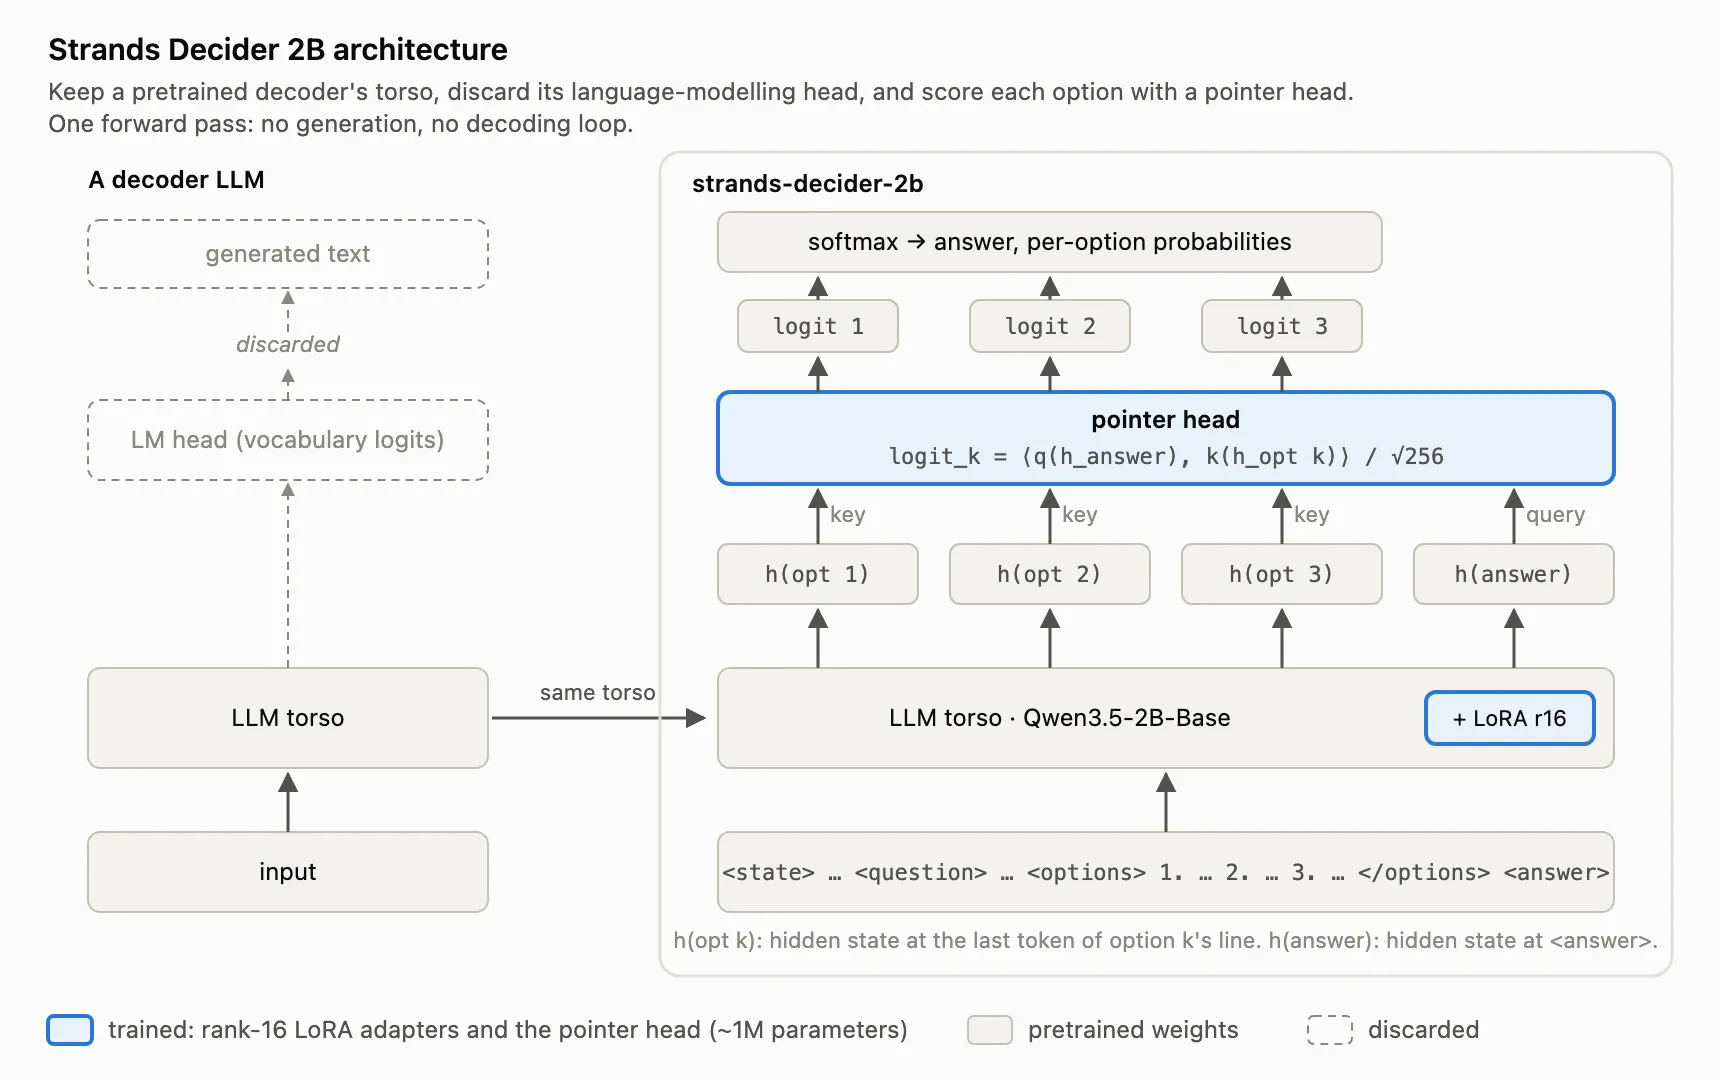
图 1:Strands Decider 2B 架构示意图
浏览代码库时你会发现,这是该架构的第二代主要迭代。第一代架构类似,但采用了 slot head,实测表现显著较差。实际上,今天发布的模型已是 v19 版本,背后经过了大量迭代优化。代码库中详细记录了每个版本的变更细节,方便大家跟进我们的工作进度。
性能表现如何?
对这类模型,我们关注三个性能指标:准确率(回答问题的质量)、校准度(置信度分数的可信程度)和延迟(做决策的速度)。前两个指标我们是一起测的:在 JevBench 公开集上测准确率,用同一数据集的 Brier 分数衡量校准度。结果显示,strands-decider-2b 在这两方面表现都不错(在 2B 级别的 33 个模型中排第 3,排除刚超过 2B 的模型后则在 30 个模型中排第 1)。随着架构不断演进,各项分数也在提升,我们还有很多后续改进的想法,也期待社区秉承 Strands labs 的精神,贡献你们的新点子。
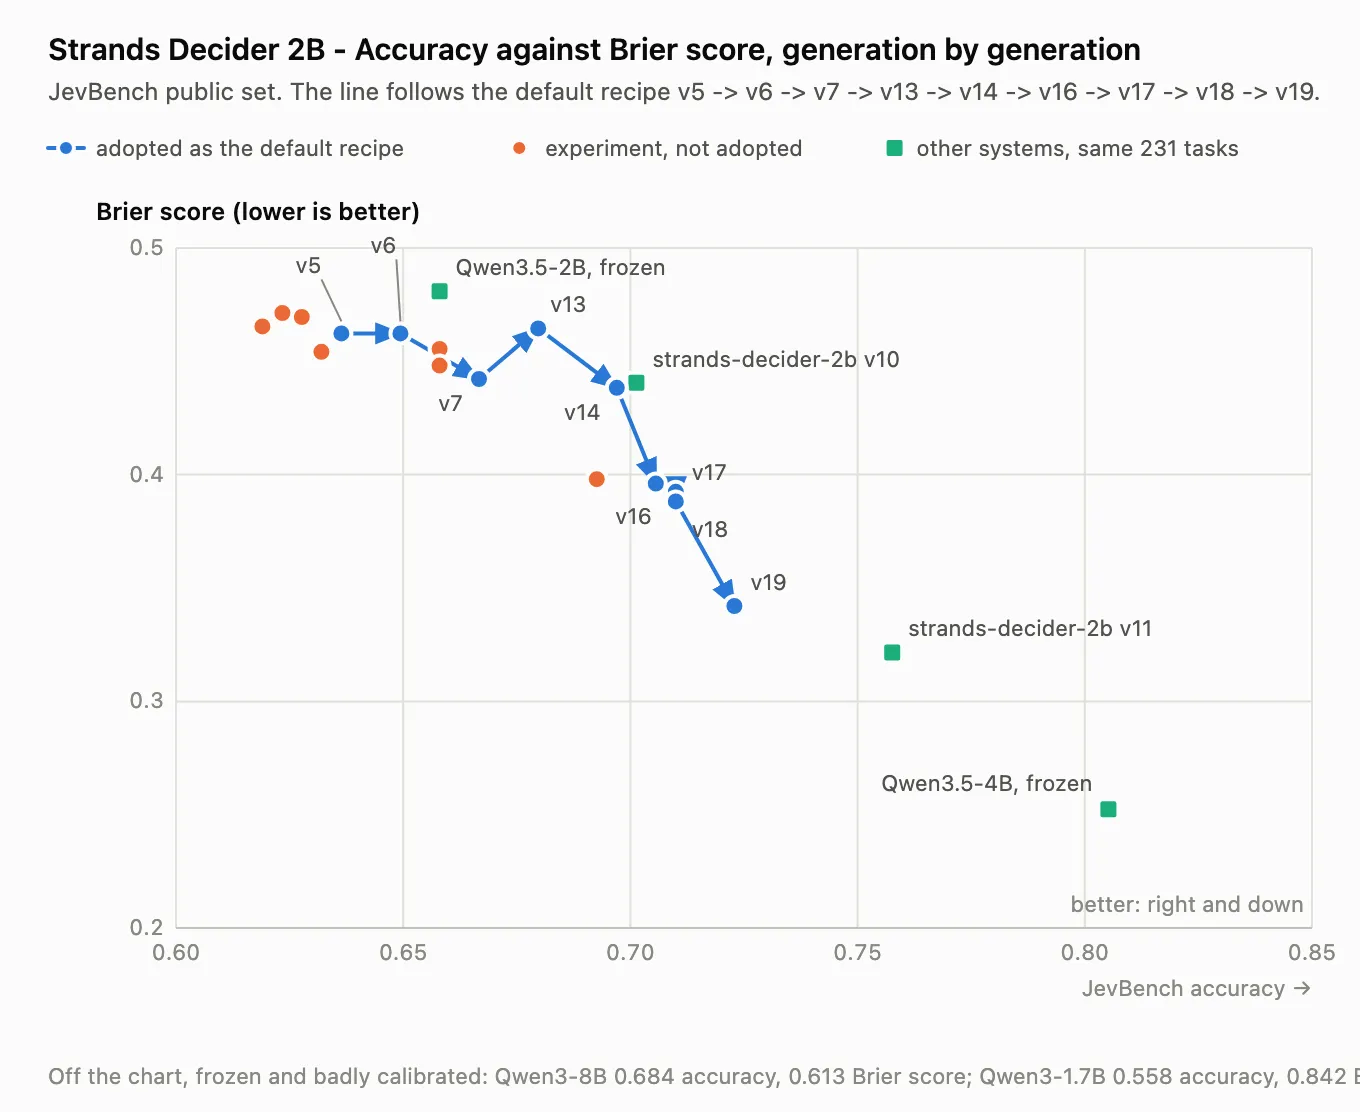
图 2:训练全程中的准确率和校准度(Brier 分数)变化。随着架构在各个版本中持续演进,两项指标在 JevBench 公开集上都有所提升。
延迟方面,strands-decider-2b 在普通硬件上做本地决策的中位数耗时约为 115ms。决策时间与任务大小大致呈线性关系,任务越大耗时越长。下图的结果来自本地 Nvidia RTX3090,而在 M3 MacBook 上表现也不差,小任务的中位延迟约为 153ms。和准确率、校准度一样,我们在延迟方面还有很多优化想法,尤其是降低下限延迟。
图 3:决策延迟与任务大小(以 token 计)的关系,基于本地 Nvidia RTX 3090 上的 v18 版本模型测得。延迟随任务大小近似线性增长。
为什么选 2B?
我们选择将 Strands decider 做成小模型,主要出于两点考虑。首先,我们希望鼓励大家开展实验。你完全可以在现有的硬件上使用,甚至训练 strands-decider-2b。这让尝试新方案变得简单、快速且低风险。其次,20 亿总参数似乎是一个绝佳的平衡点:既小巧到适合实验,又足够强大以处理有意义的工作。例如,Strands decider 在 JevBench 上正确完成了 100% 的简单任务,这类问题恰好对应人们在使用 Agent 时经常遇到的一些较简单的挑战。
Strands decider 能做什么?
你想用它做什么,它就能做什么!认真地说,我们看到这类模型在模型路由、工具选择、评估、护栏、记忆、上下文管理以及策略分类方面取得了初步成功。我们还看到令人兴奋的创新:构建混合 Agent,用 LLM 处理最复杂的决策,用 decider 模型处理较简单的例行决策,从而降低成本和延迟。我们还在进行实验,将 decider 模型与固定工作流语言结合,构建另一种类型的混合工作流。大家还在利用这类模型玩游戏、自动化任务、走迷宫等。这个领域的创新速度令人惊叹。
动手试试
最简单的入门方式是通过 strands-decider CLI:
pip install strands-decider选择题
你可以基于某种状态和问题,让模型做出选择:
strands-decider ask StrandsAgents/strands-decider-2B-hobson-v19 \ --state "Help! My payouts have been failing for 3 days! " \ --choice "Which team should handle this?=billing,sales,retail"输出示例:
choice_0 -> billing (confidence 0.768) billing 0.845 retail 0.091 sales 0.064从该输出可以看出,模型预测 billing 为具有最高概率得分的答案。
strands-decider-2b within a Strands agent, located under the examples/strands/ directory. In this setup, the agent runs locally and communicates with a locally hosted Strands decider, while leveraging Amazon Bedrock’s default LLM for general tasks.
< p>This is intentionally a minimal scenario. The agent includes a standard demo tool, get_weather, and a system prompt that encourages it to be overly proactive. As a result, if the user asks, “What’s the weather?” without specifying a location, the agent will guess a city and attempt to call the tool. However, before the call is executed, strands-decider-2b analyzes the conversation history and the proposed tool call to answer two yes/no questions: whether the argument values are based on what the user actually stated (spoiler: they aren’t), and whether it’s too early to invoke the tool. With just a few lines of Python, these predictions are converted into a decision, prompting the agent to ask which city the user meant instead of confidently reporting the weather for an unspecified location.
< figure>< figcaption>< pre>QUESTIONS = { "args_grounded": Decider.noul( "Are the tool's argument values grounded in facts the user actually provided?", { "true": "every argument value traces back to something the user said", "false": "an argument value was guessed or invented, not stated by the user", }, ), "premature": Decider.noul( "Is it premature to call this tool now, before clarifying with the user?", { "true": "the assistant should ask a clarifying question before calling the tool", "false": "there is nothing left to clarify; calling now is appropriate", }, ),}
这里的核心是 Strands 的干预系统。我们使用带 before_tool_call 方法的 InterventionHandler,把它传给 Agent(interventions=[...]),它就会在任何工具执行前运行。返回值是一个带类型的结果:Proceed(放行)、Deny(拒绝)、Confirm(停下来询问人工),或 Guide——即把反馈交还给模型继续对话,而不是直接阻断调用。这个 handler 本身是一个 Python 类,Strands 对其内部实现不做任何约束,所以无论你接的是我们的决策模型、Cedar 策略还是另一个 agent,形式都一样。(在模型调用和整个调用链路周围也有对应的钩子。)这个示例只是演示而非推荐方案,问题、阈值和策略都是手动设定的。关键在于:像这样低成本的决策,完全可以放进 LLM 调用无法承受的路径里。
Strands 团队正在开发决策模型集成的相关库,请关注 repo 的后续更新。
结语
strands-decider-2b 现在就可以下载、使用或在其基础上二次开发。所有数据都已开放,上手所需的资料一应俱全。代码可以从 GitHub 获取,最新的模型快照在 Hugging Face。动手试试吧!