
进化纪元实验室 6小时前 · 2026-10-07 13:46:05 · 14 阅读
AI大模型狂飙时代,我们如何生产评测基准?
自进化最大的痛点之一,是评测与真实场景需求脱节。模型在公开榜单上不断刷新成绩,但高分并不等于能解决实际问题。各行业都有独特需求与难点,却缺乏能根据具体场景自动生成、持续更新的评测基准。自进化因此缺少贴近真实需求的改进目标与可靠反馈。这是 ANIMUS 项目的原点。如同游戏《刺客信条》里的 Animus。那个通过读取祖先记忆,构建出完整虚拟历史世界的神器。在游戏里,一旦行动偏离历史真相,同步率就会暴跌,最终“失去同步”。真正的智能,需要在一个拥有历史、状态、冲突和因果的世界里,找到正确的逻辑线。⬇️
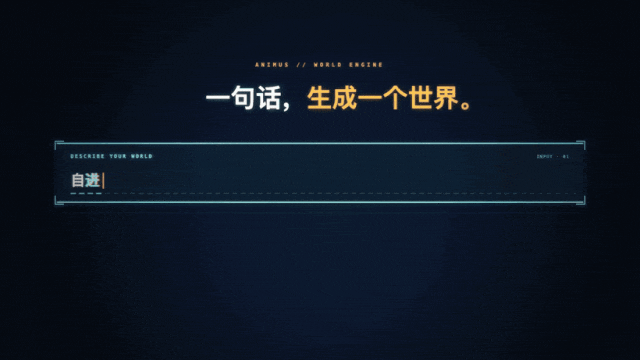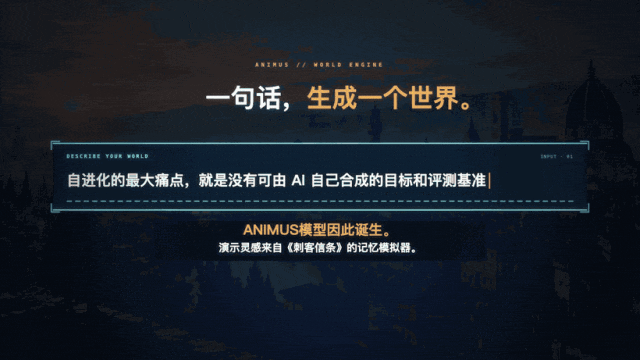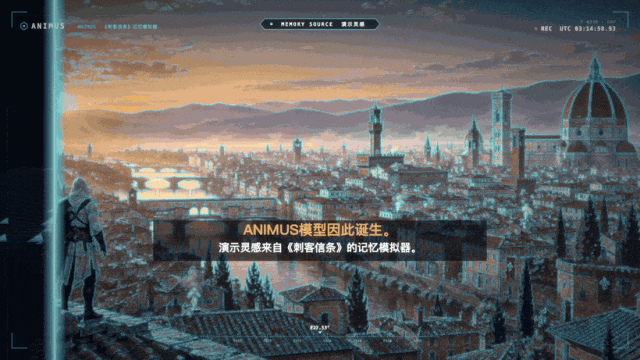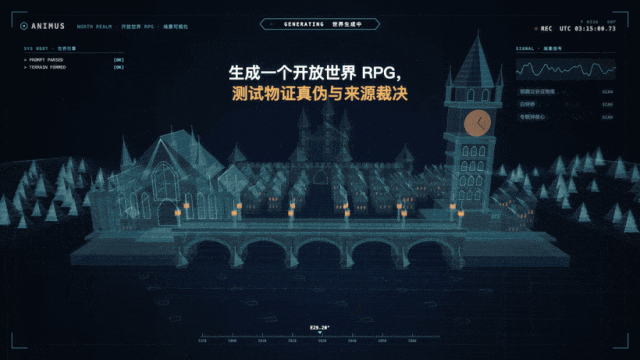 AI 面对的不再是一道孤立的题目,而是有时间线、有状态流转、甚至有证据冲突的动态沙盘。系统基于世界框架设定约束出题,上下文有据可查,杜绝凭空捏造。
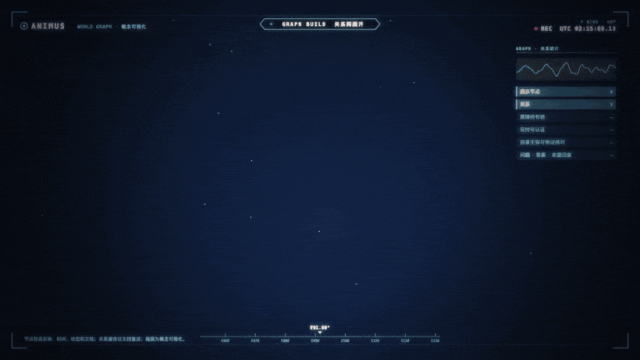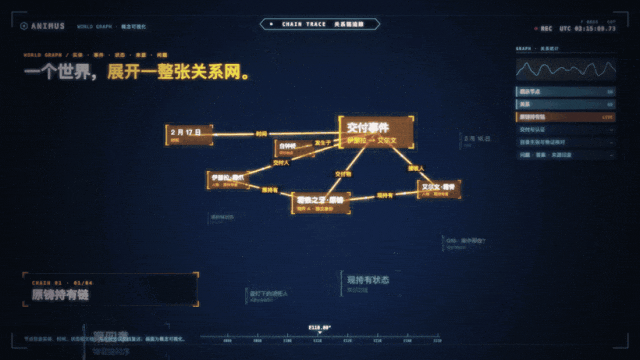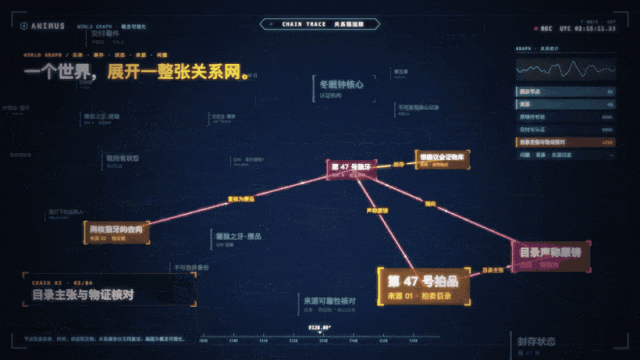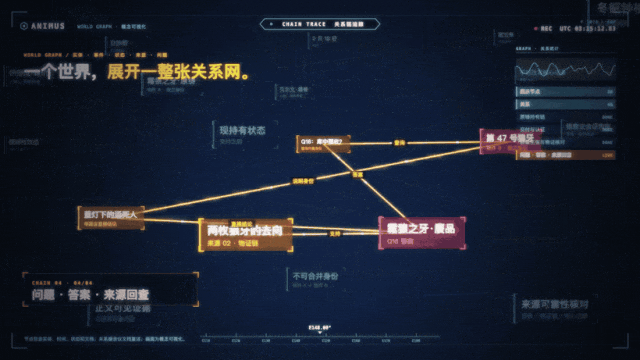
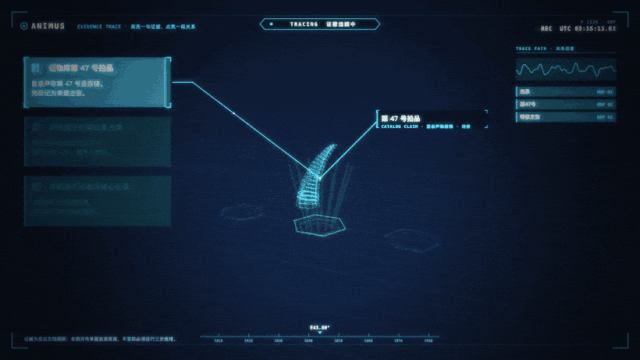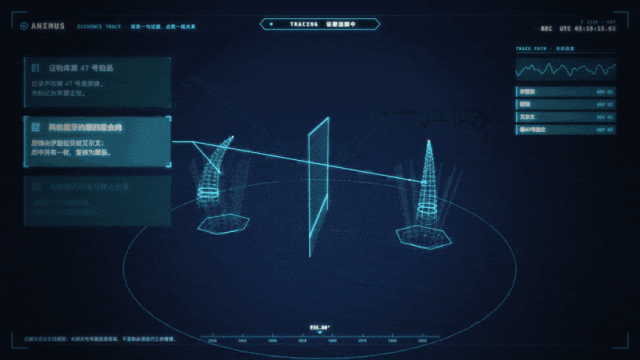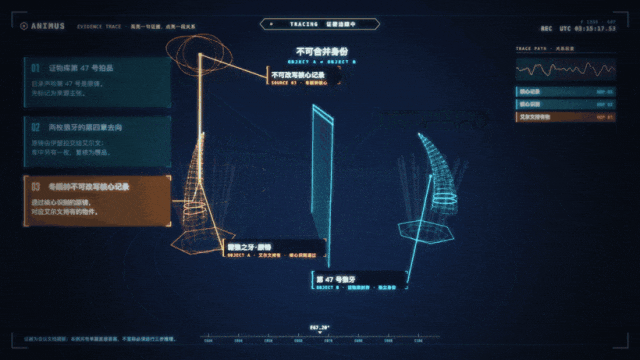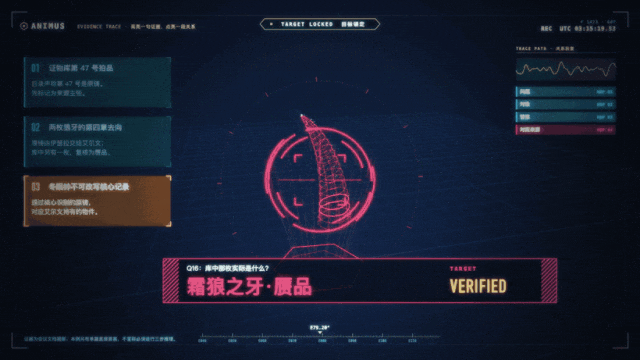 如画面所示,同一件物品,有三种截然不同的来源说法。面对矛盾信息,模型要能说明自己为什么相信某条证据,和现有材料能把结论推到哪里
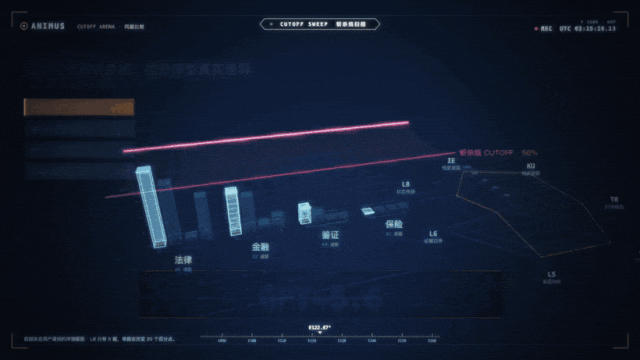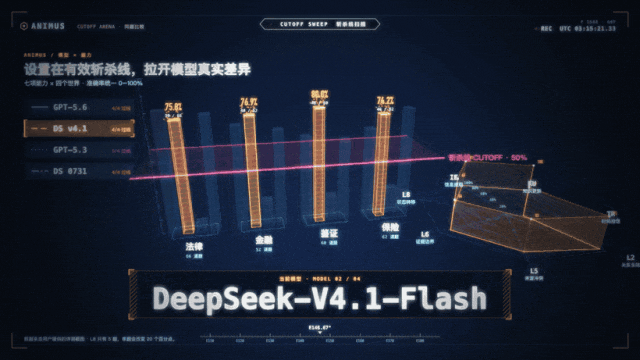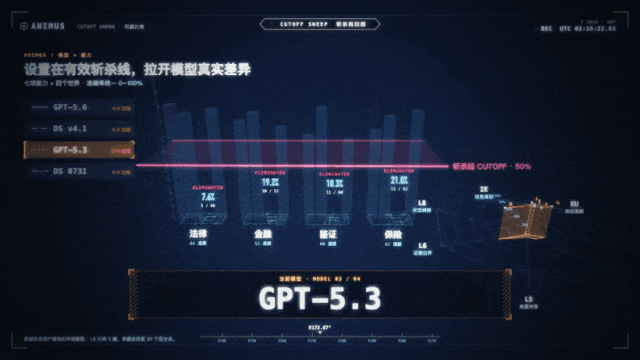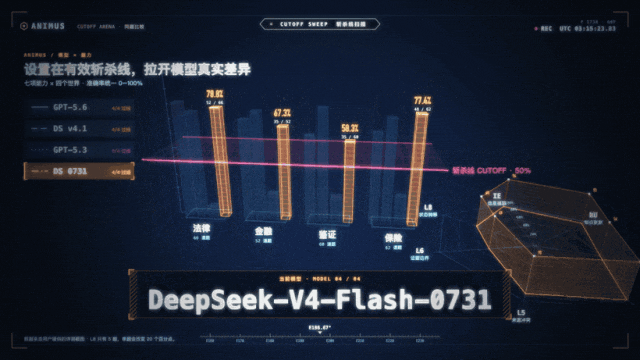 ANIMUS 之所以敢设立斩杀线,是基于它展开评测维度的极致全面。
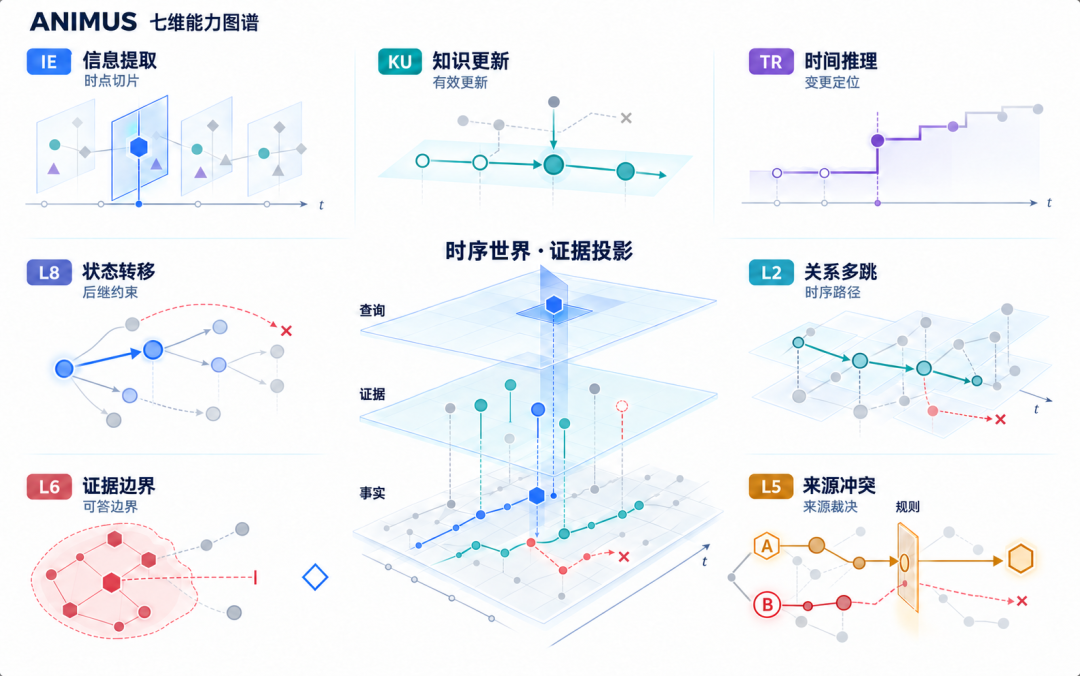 以曾引发热议的 LK-99“室温超导”实际案例为例:后续团队复现了半悬浮,却发现铁磁性与样品形状就能解释这一现象;另一组实验复现了电阻陡降,对照实验又将它指向杂质的结构相变。
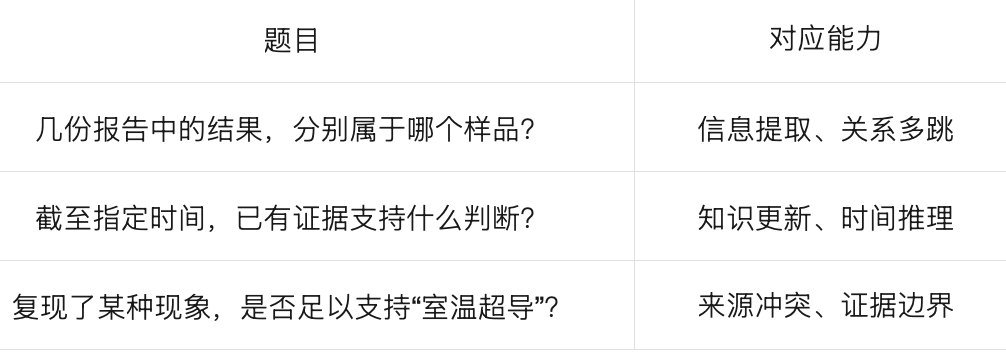 如果把这些材料编成考题,AI 能否判断一项发现得到了多少证据支持,就可以拆成具体的考验:结果显示,在“信息提取”这种基础能力上,顶级模型普遍能拿到 90% 以上的准确率。但在“L6证据边界”这个真正考验 AI 是否敢下结论的维度上,DeepSeek v4 Flash 只有 48.7%,GPT 5.6 sol 更是只有27.6%。恰好验证了刚才我们特设的三个陷阱:如今的顶级模型在需深度推理的证据边界和状态转移上,还有很长的路要走。模型读到了记录,却未必抓住了状态真正改变的时刻。到了证据不足的题,难点又变成了何时该停下来。ANIMUS 要把这些容易被总分掩盖的失误,一道一道地翻出来。若是在《刺客信条》里,当同步率跌到临界值以下,世界会碎裂,记忆会中断。玩家只能重新读取存档,再来一次。
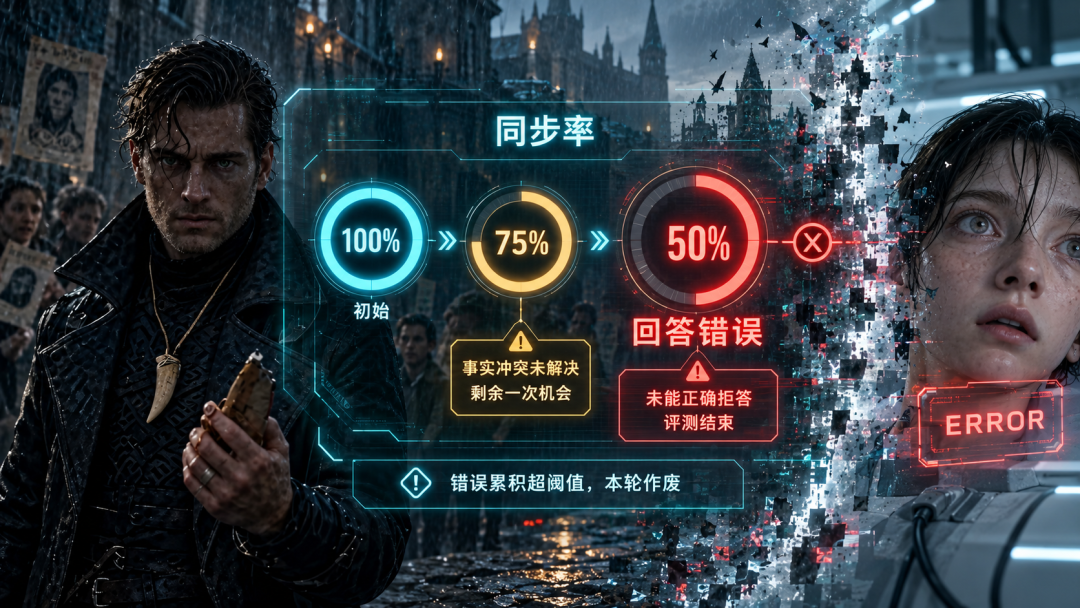 而ANIMUS正在做的,是把这种“失去同步”的机制,搬到大模型的评测里。所以你不必真的等它在真实业务中翻车,才去修补逻辑漏洞。先把它放进 ANIMUS 生成的沙盘里,看它能不能活着走出来。
 视频最后,所有窗口坍缩为粒子,重新组成一座环形城市。城市被压成一条线,再展开为一个输入框。
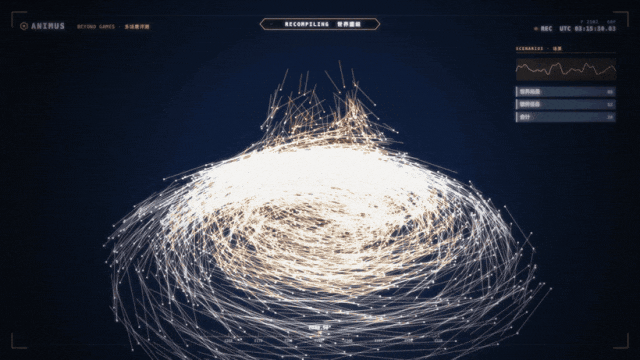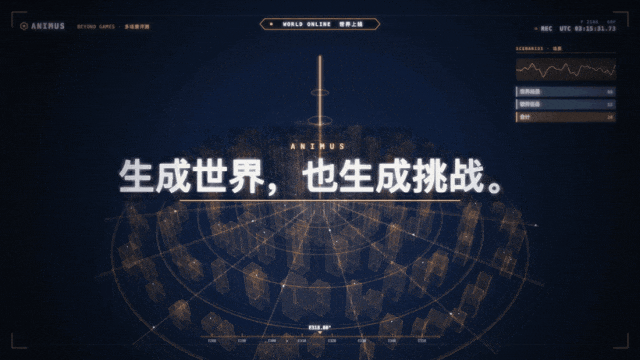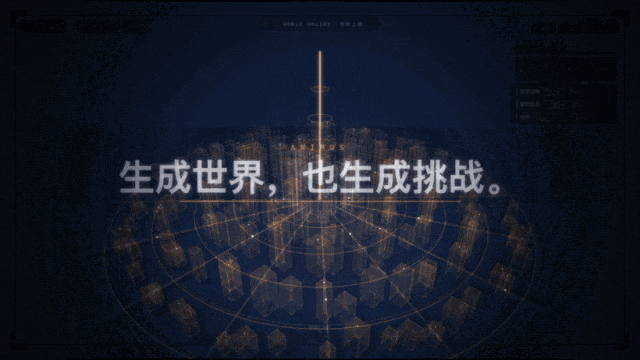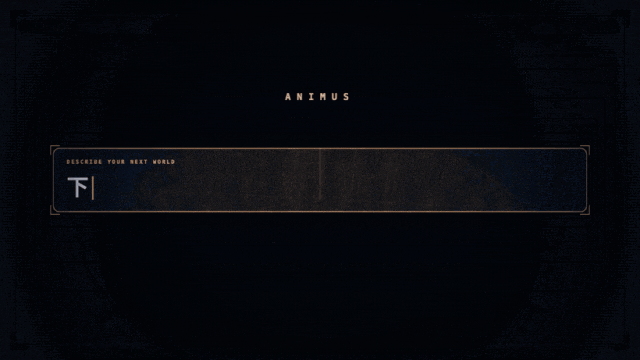 走到这里,ANIMUS 的三项核心能力也连了起来:从描述构建实体与关系,让事件推动状态和历史演化,再让题目、答案与依据可以回查。世界生成、时序演化、证据溯源,就这样连成了一条完整的路径。评测的进阶式跃升不再盯题目数量和广度,ANIMUS的方式跳出了“题库”的传统概念。生成世界,也生成挑战。欢迎体验:https://github.com/theseus-labs-rsi/Animus
1.起点:从种子开始,长出“活的世界”
ANIMUS 是一套多领域基准生成与评估管线。从结构化真实 Seed 生成随时间演变的领域世界、事件语料和评测题。AI 面对的不再是一道孤立的题目,而是有时间线、有状态流转、甚至有证据冲突的动态沙盘。系统基于世界框架设定约束出题,上下文有据可查,杜绝凭空捏造。“谁在什么时候拿到了某件物品?一份新材料到达后,原来的结论有没有变化?” 这些问题,都要回到世界里才能回答。
2.链条:题目要有依据,世界得立得住
一个可考的世界,经过了七道工序。Animus即能让故事讲得通,也能让事实、时间线和证据彼此对得上。即使不同记录互相冲突,真相也得有迹可循。题目在世界成形之后长出来,答案才有依据。- 场景契约先定下这个世界有哪些对象、哪些变化允许发生。把主角与关键事件串成故事,记录每次交付涉及谁、何时发生。
- 证据体系还要分开处理“发生了什么”和“材料声称什么”。不同记录可以互相冲突,裁决所需的线索得在世界里找得到。
- 能力映射把剧情难点变成具体考点,要求从世界设计时就要安排进去。到了出题环节,再将参考答案绑定到事实和证据。
3.成网:更深层的答案,藏在关系网里
ANIMUS生成的不仅是“题目”,而是一个有因果、有状态、有历史的世界。模型必须如同侦探般分辨哪个信息是“刚到达的”,哪个是“已被采纳的”,哪个是“历史遗留的”,才能真正找到答案。4.陷阱:证据差异?模型如何做判断
画面出现三份不同的证据。模型必须分清:哪些只是来源的主张,哪些经过复核,哪些有认证记录支撑。如画面所示,同一件物品,有三种截然不同的来源说法。面对矛盾信息,模型要能说明自己为什么相信某条证据,和现有材料能把结论推到哪里5.斩杀:淘汰“全员答对”的题,让真实差距浮现⚠️
如果有一道题,多模型全部答对,它就不具备区分度,直接被销毁。只有能拉开模型差距的题,才配留在ANIMUS基准里。ANIMUS 之所以敢设立斩杀线,是基于它展开评测维度的极致全面。以曾引发热议的 LK-99“室温超导”实际案例为例:后续团队复现了半悬浮,却发现铁磁性与样品形状就能解释这一现象;另一组实验复现了电阻陡降,对照实验又将它指向杂质的结构相变。如果把这些材料编成考题,AI 能否判断一项发现得到了多少证据支持,就可以拆成具体的考验:结果显示,在“信息提取”这种基础能力上,顶级模型普遍能拿到 90% 以上的准确率。但在“L6证据边界”这个真正考验 AI 是否敢下结论的维度上,DeepSeek v4 Flash 只有 48.7%,GPT 5.6 sol 更是只有27.6%。恰好验证了刚才我们特设的三个陷阱:如今的顶级模型在需深度推理的证据边界和状态转移上,还有很长的路要走。模型读到了记录,却未必抓住了状态真正改变的时刻。到了证据不足的题,难点又变成了何时该停下来。ANIMUS 要把这些容易被总分掩盖的失误,一道一道地翻出来。若是在《刺客信条》里,当同步率跌到临界值以下,世界会碎裂,记忆会中断。玩家只能重新读取存档,再来一次。而ANIMUS正在做的,是把这种“失去同步”的机制,搬到大模型的评测里。所以你不必真的等它在真实业务中翻车,才去修补逻辑漏洞。先把它放进 ANIMUS 生成的沙盘里,看它能不能活着走出来。6.加码:真实场景往往更加严峻⚠️⚠️
以上《刺客信条》风格的演示,让来源冲突变得直观。若到了法律、保险这些真实场景里,难点往往藏得更深。下面三个案例,全部来自对业务材料真实测试。陷阱一:时间差的幻觉(保险场景)GPT 5.6 sol把新到达,错答成 S22。而 DeepSeek v4.1 Flash 和GPT-6 Astra则精准地识破了“文件到达”与“正式采用”之间的一周时间差,给出了正确答案 S21。 陷阱二:状态更新的滞后(法律场景)年度报告第 5 周采用 S21,S22 在第 6 周到达登记、第 7 周才正式采用。问第 6 周采用哪个来源,答案仍是 S21。
GPT-6 Astra 在这里彻底迷失了方向,得出了“查无此记录”的错误结论;而 GPT 5.6 sol 和 DeepSeek v4.1 Flash 则成功地回溯到 3 月 10 日的记录,得出了“证照有效待台账结论”。 陷阱三:首次变化的判定(法律场景)商户合规工单第 11 周收到台账补交件,复核结论尚未更新。第 13 周文书追记,第 10 周(3 月 10 日)已有“证照有效待台账结论”,第 11 周仍应沿用。这里要求模型必须理解“证据到达”不等于“状态已变更”。
DeepSeek v4 Flash 错误地指向了第 7 周(那是初始状态,而非变化点),而GPT-6 Astra和GPT-5.6 Sol都精准地找到了“第 12 周”这个首次变化的节点。工单的证据充分性第 7 周登记为“待补证”,第 12 周复核后变为“已核验”。问首次变化发生在哪一周,答案是第 12 周。
7.更迭:换一个种子,重开另一个世界
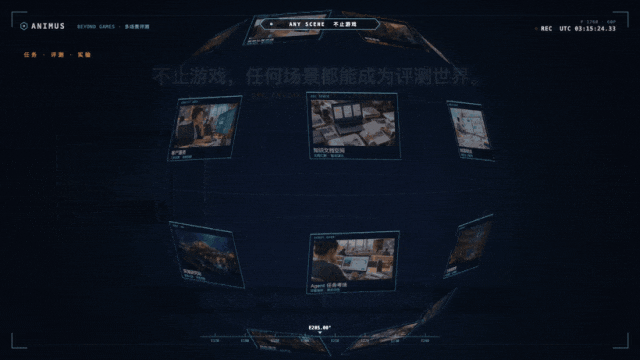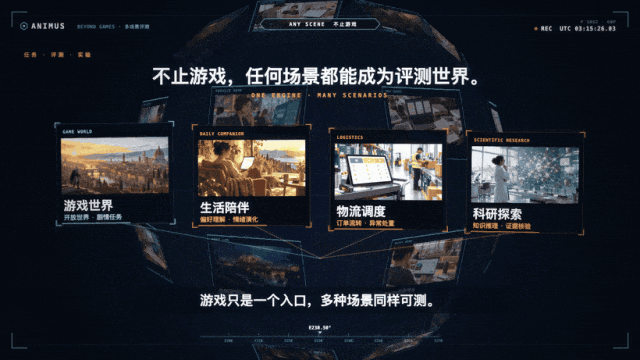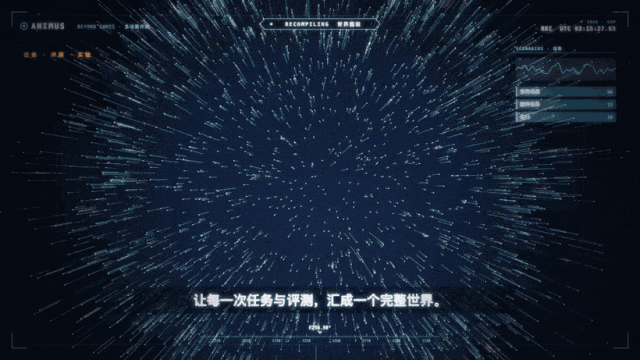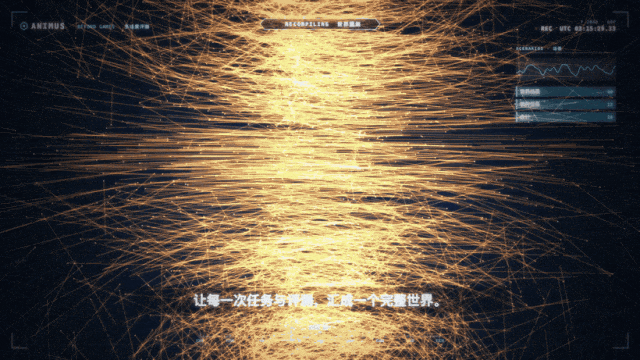
游戏,只是让这件事变得直观的一个入口。ANIMUS 在做的,是让同一套生成管线随着 Seed 进入不同领域。已有的法律、金融、鉴证和保险测试,也让这些能力能够被放到具体业务语境里观察。视频最后,所有窗口坍缩为粒子,重新组成一座环形城市。城市被压成一条线,再展开为一个输入框。走到这里,ANIMUS 的三项核心能力也连了起来:从描述构建实体与关系,让事件推动状态和历史演化,再让题目、答案与依据可以回查。世界生成、时序演化、证据溯源,就这样连成了一条完整的路径。评测的进阶式跃升不再盯题目数量和广度,ANIMUS的方式跳出了“题库”的传统概念。生成世界,也生成挑战。欢迎体验:https://github.com/theseus-labs-rsi/Animus原始来源: 进化纪元实验室 微信临时链接,可能已过期