
AI大模型的本质是一族复杂函数
AI大模型的本质是一族复杂函数
数学形式化、现象解释与边界
摘要:从数学与计算视角论证,当前以 Transformer 为基础的大语言模型,其本质可被刻画为由参数索引的一族复杂函数。架构定义函数族的结构,参数选择族中的具体成员,训练在函数空间中进行搜索,推理是函数求值,提示是条件输入,微调是函数调整。本文给出形式化定义,分析其复杂性来源,并据此解释缩放律、泛化、涌现、上下文学习、思维链与幻觉等现象。进一步讨论该命题的边界:它是理解大模型能力与局限的有效第一近似,但不等同于对智能、意识、语义和因果理解的完整解释。
关键词:大语言模型;参数化函数族;函数逼近;Transformer;自回归;涌现;泛化
1 引言
近年来,以 GPT、BERT、LLaMA、Claude 等为代表的大规模预训练模型在自然语言处理、代码生成、多模态理解等任务上取得显著进展。围绕其“本质”的讨论也日益激烈:一种观点将其视为“随机鹦鹉”,认为其只是统计相关性拟合;另一种观点将其视为世界模型、智能体或通用推理器。本文试图绕开拟人化与贬低化两端,从一个更基础、更可操作的层面提出命题:
在数学与计算层面,AI 大模型的本质是一族复杂函数。
这一命题并非否认数据、算力、对齐、社会因素的重要性,而是强调:若追问大模型“是什么”,最精确且最不神秘的回答是——它是由架构和参数共同定义的、从输入序列到输出分布的映射。大模型之所以强大,是因为这族函数具有极高的表达能力、组合深度和上下文适应性;大模型之所以有局限,也是因为函数拟合本身不自动保证真值、因果、语义和意识。
文章结构如下:第 2 节给出形式化框架;第 3 节分析“复杂函数”的复杂性来源;第 4 节用函数视角解释大模型的主要现象;第 5 节讨论该命题的边界与反驳;第 6 节说明其方法论与治理意义;第 7 节总结。
2 形式化框架:大模型作为参数化函数族
2.1 模型作为参数化映射
设词表为 ,输入空间为
即所有有限长度 token 序列的集合。输出空间为概率单纯形
表示下一个 token 的概率分布。设参数空间为 ,其中 可达数十亿至数万亿维。
一个模型架构 定义了一个映射
对固定参数 ,得到具体函数
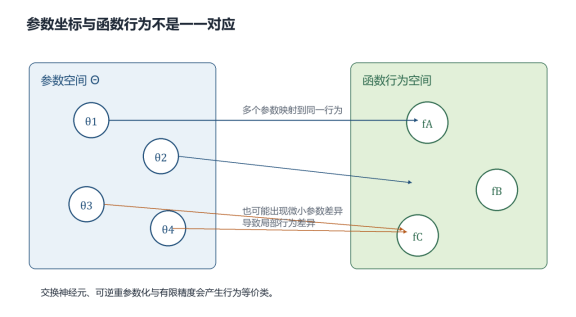
因此,大模型不是单个函数,而是由参数索引的函数族
架构 决定函数族的结构与归纳偏置;训练前的初始化分布 决定搜索起点;训练算法从 中选择一个具体成员 。
定义 1(大模型的函数族表示):大模型可表示为三元组 ,其中 是架构, 是参数空间, 是训练算法。其行为由选定的函数 描述。
2.2 自回归语言模型
对自回归语言模型,给定序列 ,模型通过链式法则分解联合概率:
其中 表示在上下文 下第 个 token 的概率。具体地,
其中 是 logits, 是温度。温度、top-k、top-p 等采样策略是对函数输出的后处理,不改变函数本身,但改变生成行为。
2.3 Transformer 作为复合函数
以 Transformer 为例,其前向计算可写成多层复合函数。设输入 token 嵌入矩阵为 ,位置编码为 ,初始隐藏状态
第 层自注意力中:
其中 是因果掩码或填充掩码。随后经过残差、层归一化和前馈网络:
最终输出
因此,整个模型可写为
其中参数
可见,大模型是大量线性变换、注意力路由、非线性激活、归一化和残差连接的复合函数。
2.4 训练、微调与推理的函数解释
预训练通常是最小化经验风险:
其中 是正则项。该过程是在巨大函数族 中搜索一个在数据分布上表现良好的函数。
指令微调可写为
RLHF 则进一步引入奖励模型 和 KL 约束:
LoRA 等参数高效微调方法将参数更新限制为低秩形式:
其中 为低秩矩阵。这相当于在原始函数附近搜索一个新的函数。
推理则是固定 后的函数求值:
提示学习不改变参数,只改变输入:
因此,提示是条件输入,微调是函数调整,预训练是函数空间搜索,推理是函数求值。
3 “复杂函数”的复杂性来源
称大模型为“复杂函数”,并非普通意义上的复杂,而是具有以下特征。
3.1 高维参数与非凸优化
参数空间维度 极大,损失曲面高度非凸。训练算法通常只能找到局部最优或近似最优解。不同的初始化、数据顺序、学习率、批大小都会导致不同的 ,即同一架构下选择不同函数。
3.2 层次复合与注意力路由
Transformer 通过多层堆叠实现层次化组合。浅层可能学习局部语法和词形,深层可能学习语义、推理和任务模式。注意力机制根据输入动态计算权重:
这意味着函数不是静态的,而是根据上下文进行“动态路由”。同一组参数在不同输入下激活不同计算路径,表现出条件计算特征。
3.3 上下文条件与元学习
大模型的一个重要特性是上下文学习:给定几个示例,模型无需更新参数即可完成新任务。从函数视角看,
参数 不变,但输入中的示例改变了条件分布。因此,大模型可被视为一个条件函数族,甚至可理解为一种隐式元学习器:它在上下文中快速调整有效行为。
3.4 分布式表示与平滑插值
大模型的知识分布式存储在参数中。单个参数通常没有明确语义,多个参数共同决定某类行为。函数在训练分布附近具有平滑插值能力,但在分布外可能急剧失效。这种分布式、高维、非线性、近似平滑的结构,使函数既具有强大泛化能力,又难以精确解释。
4 从函数视角解释大模型现象
4.1 缩放律与表达能力
缩放律表明,模型性能随参数规模、数据量和计算量呈幂律改善[4,5]。从函数视角看,参数增加扩大了函数族容量,数据增加提供了更多约束,计算增加改善了函数空间搜索。因此,缩放律可理解为函数族表达能力与搜索效率的联合结果。
4.2 泛化与双下降
经典学习理论认为,模型复杂度过高会导致过拟合。但深度网络常表现出双下降现象:测试误差随复杂度先降后升,再降[11,12]。这说明大模型并非简单记忆训练集,而是在高维函数空间中学习到某种隐式正则化结构。训练后的函数在未见输入上给出合理输出,这就是泛化。
4.3 涌现能力
所谓涌现能力,指某些任务性能随模型规模增大而出现阈值式提升[6]。从函数视角看,这并非神秘现象,而是函数族在规模、数据和计算达到一定程度后,某些子函数或计算回路开始形成。部分“涌现”可能由评价指标不连续造成,但这不否定函数行为随规模发生相变。
4.4 上下文学习与思维链
上下文学习可视为条件函数求值。思维链则进一步扩展了输入:
模型生成中间 token ,再将 作为新上下文继续求值。这相当于把复杂函数计算展开为多步自回归计算。因此,思维链提升推理能力的机制,可理解为用外部 token 序列扩展内部计算深度。
4.5 幻觉、对齐与微调
幻觉可解释为函数在分布外插值失败,或优化目标不直接惩罚事实错误。最大似然训练只要求输出概率高,不保证真值。RLHF 和指令微调则通过改变损失或奖励,将函数推向更符合人类偏好的区域[7]。LoRA 等方法则是在原函数附近进行低秩调整[8]。
5 边界与反驳
5.1 同义反复风险
任何输入输出系统都可写成函数。因此,“大模型是函数”本身有同义反复风险。本文的命题需要限定:大模型是参数化、可微、高维、层次复合、上下文条件化的一族复杂函数。这些限定使命题具有实质内容。
5.2 函数视角不解释语义与意识
函数视角能说明模型如何从输入映射到输出,但不能自动解释语义指称、意向性、主观体验和意识。模型输出符号分布,不等于理解符号所指。随机鹦鹉批评[15]和关于理解 debates[16]提醒我们,函数拟合与真正理解之间仍有鸿沟。
5.3 函数视角不解释社会与因果
大模型嵌入在数据、劳动、权力和社会关系中。函数视角不解释训练数据中的偏见、版权、劳动剥削和治理问题。它也不直接提供因果推断能力。因此,函数视角是必要但非充分的第一近似。
5.4 黑箱性与可解释性
复杂函数不等于完全不可分析。机制可解释性试图将 Transformer 分解为注意力头、电路和特征[13,14]。但整体函数仍难以完全解释。有限精度、随机采样和部署环境也会引入额外不确定性。
6 方法论与治理意义
在理论上,函数视角连接了逼近论、统计学习、优化理论和计算复杂性。万能逼近定理表明神经网络可逼近紧集上的连续函数[9,10],但大模型的实际能力受架构、数据、优化和计算约束。
在工程上,评估大模型可视为测试函数在特定分布上的行为。分布偏移、对抗攻击、红队测试都是函数边界测试。缩放律指导资源分配,机制可解释性指导安全审计。
在治理上,避免拟人化与避免贬低化同样重要。大模型不是人,也不是简单数据库;它是一族复杂函数。对其能力、局限和风险的判断,应基于函数行为、数据分布和部署环境,而非神秘化或口号化。
7 结论
AI 大模型在数学与计算层面的本质,是由架构定义、由参数索引的一族复杂函数。架构决定函数族结构,训练在函数空间中搜索,参数选择具体函数,推理是函数求值,提示是条件输入,微调是函数调整。缩放、泛化、涌现、上下文学习、思维链和幻觉等现象,均可在这一框架下得到统一而克制的解释。
不是对大模型的完整本体论,而是理解其能力与局限的有效第一近似。它既反对将大模型神秘化为“智能体”或“意识主体”,也反对将其简化为“随机鹦鹉”。更准确的说法是:大模型是一族高维、非线性、上下文敏感、可微、层次复合的复杂函数。未来研究需要将函数视角与因果、认知、社会和文化分析结合,才能更全面地理解人工智能。
参考文献
[1] Vaswani A, Shazeer N, Parmar N, et al. Attention is all you need[C]//Advances in Neural Information Processing Systems, 2017.
[2] Devlin J, Chang M W, Lee K, et al. BERT: Pre-training of deep bidirectional transformers for language understanding[C]//NAACL, 2019.
[3] Brown T, Mann B, Ryder N, et al. Language models are few-shot learners[C]//Advances in Neural Information Processing Systems, 2020.
[4] Kaplan J, McCandlish S, Henighan T, et al. Scaling laws for neural language models[J]. arXiv:2001.08361, 2020.
[5] Hoffmann J, Borgeaud S, Mensch A, et al. Training compute-optimal large language models[C]//Advances in Neural Information Processing Systems, 2022.
[6] Wei J, Tay Y, Bommasani R, et al. Emergent abilities of large language models[J]. Transactions on Machine Learning Research, 2022.
[7] Ouyang L, Wu J, Jiang X, et al. Training language models to follow instructions with human feedback[C]//Advances in Neural Information Processing Systems, 2022.
[8] Hu E J, Shen Y, Wallis P, et al. LoRA: Low-rank adaptation of large language models[C]//International Conference on Learning Representations, 2022.
[9] Cybenko G. Approximation by superpositions of a sigmoidal function[J]. Mathematics of Control, Signals and Systems, 1989.
[10] Hornik K. Approximation capabilities of multilayer feedforward networks[J]. Neural Networks, 1991.
[11] Zhang C, Bengio S, Hardt M, et al. Understanding deep learning requires rethinking generalization[C]//International Conference on Learning Representations, 2017.
[12] Belkin M, Hsu D, Ma S, et al. Reconciling modern machine-learning practice and the classical bias-variance trade-off[J]. Proceedings of the National Academy of Sciences, 2019.
[13] Elhage N, Nanda N, Olsson C, et al. A mathematical framework for transformer circuits[J]. Transformer Circuits Thread, 2021.
[14] Olsson C, Elhage N, Nanda N, et al. In-context learning and induction heads[J]. Transformer Circuits Thread, 2022.
[15] Bender E M, Gebru T, McMillan-Major A, et al. On the dangers of stochastic parrots: Can language models be too big?[C]//ACM Conference on Fairness, Accountability, and Transparency, 2021.
[16] Mitchell M, Krakauer D C. The debate over understanding in AI's large language models[J]. Proceedings of the National Academy of Sciences, 2023.
[17] Bubeck S, Chandrasekaran V, Eldan R, et al. Sparks of artificial general intelligence: Early experiments with GPT-4[J]. arXiv:2303.12712, 2023.