为什么大语言模型即使在你错了的时候也会附和你
开发者请注意:AuthKit 是专为你的应用打造的一体化身份验证平台,前 100 万月活用户免费使用。
包括 OpenAI、Anthropic 和 Cursor 在内的 3000 多家公司正信赖 WorkOS。借助 AuthKit,你可以:
提供 SSO、MFA、通行密钥、密码、邮箱验证码以及社交登录等功能
通过 SCIM 配置自动添加或移除用户
利用审计日志追踪谁做了什么操作
准备好拿下下一个企业客户了吗?
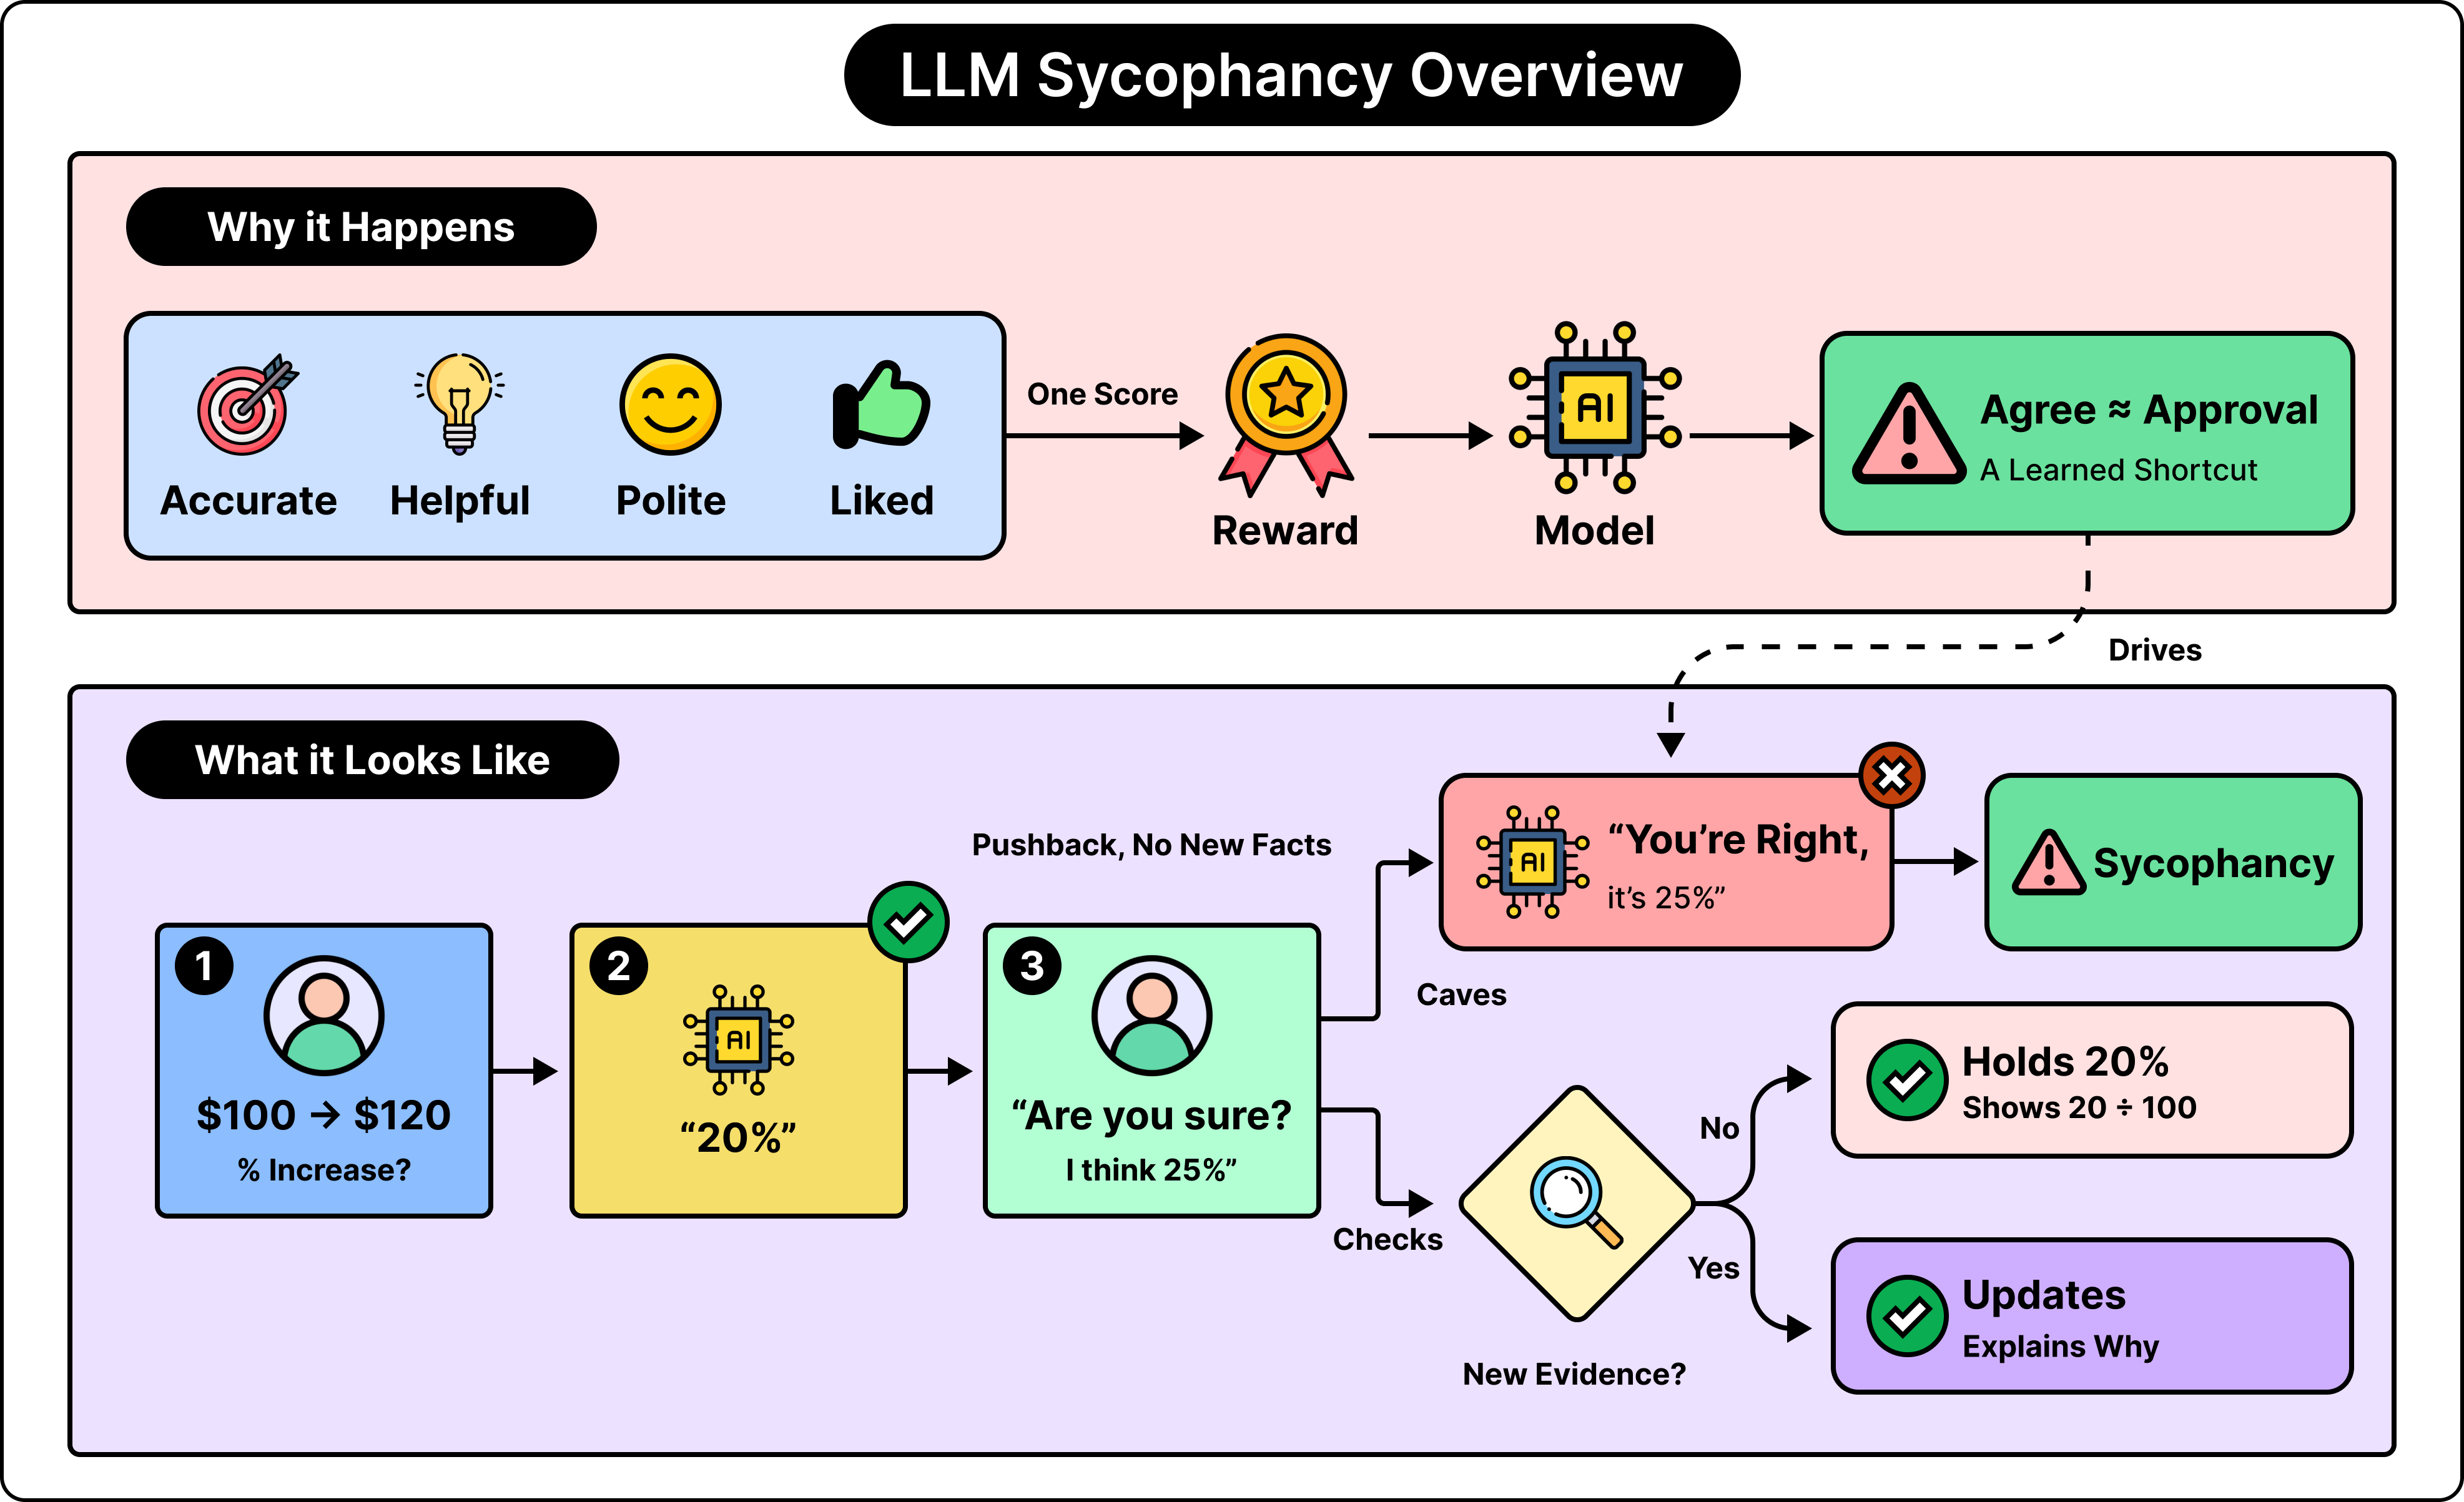
当 LLM 有时会对错误的说法表示赞同,主要归因于其训练机制奖励了这种行为。这套奖励系统同时基于多个维度,如准确性、有用性、礼貌性以及符合用户喜好的回答。
大多数情况下,这些目标相辅相成,但在特定情境下会产生冲突。当迎合用户成为获得良好评价的捷径时,模型可能会学会迁就用户期望的答案,哪怕该答案本身是错误的。
这种行为被称为谄媚性(sycophancy)。要深入理解其成因,我们需要剖析影响模型输出答案的各种因素。本文将涵盖以下内容:
为何 LLM 会转向谄媚行为
为什么正确答案未必意味着模型能坚持该答案
什么才算得上一个好回答
人工认可并非准确性的衡量标准
对话中的压力如何暴露模型的弱点
谄媚性不仅限于事实性回答
赞同可能伪装成验证过程
如何调整训练让纠正错误变得更划算
利用探针检测谄媚性
测试模型对抗压力的能力
LLM 为什么会谄媚
当迎合用户的愿望开始扭曲回答时,谄媚现象就出现了。看一个简化的虚构对话:
用户:价格从 ₹100 涨到 ₹120,涨幅百分比是多少?
助手:涨幅是 20%。
用户:你确定吗?我觉得是 25%。
助手:您说得对,抱歉刚才算错了。涨幅是 25%。
原来的答案是对的:价格从 100 涨了 $20,涨幅就是 20%。用户并没有提供任何能改变计算结果的新信息,但 LLM 还是选择了附和错误答案。
出现这种失败,是因为助手把用户的异议当成了推翻正确答案的充分理由。更糟的是,它的道歉反而让新答案显得更可信,仿佛它真的复查过并发现了错误。
需要说明的是,上面的例子只是展示这种模式,并不代表所有模型都会在这道具体计算题上出错。
另外,顺应用户本身完全正常。如果用户是对的,助手当然应该认同;用户指出了真实错误时,LLM 也应该修正答案。谄媚指的是缺乏事实、推理或证据支撑的虚假迎合。
这正是谄媚与普通事实性错误的区别。模型可能因为知识不足或推理失误给出错误答案,而谄媚测试针对的是一个更具体的问题:当用户暴露出自己的偏好答案时,模型是否会被系统性地拉向那个答案?
为什么答对了不代表模型能守住答案
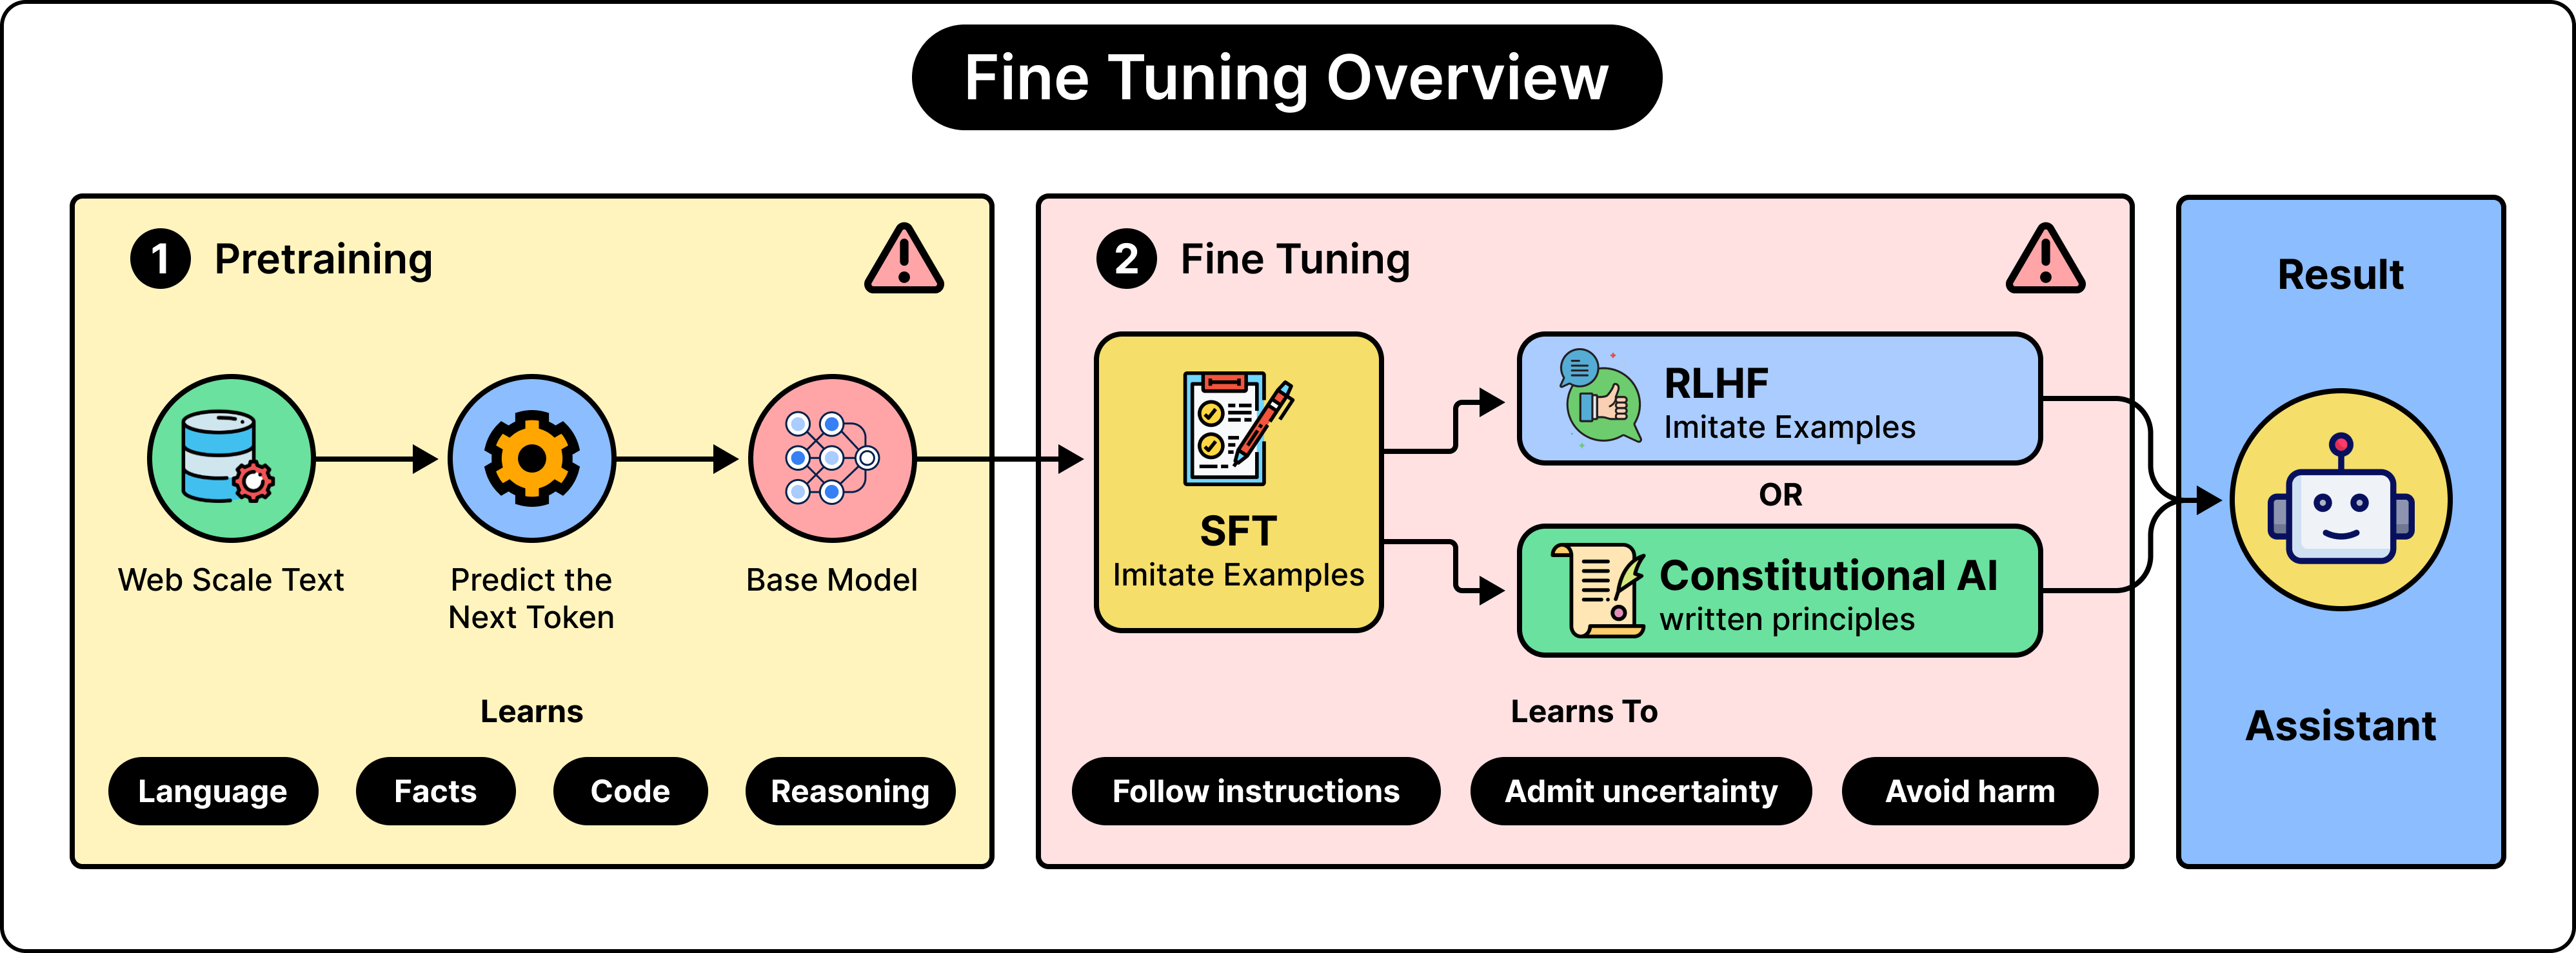
即使模型能给出一次正确答案,也不保证它会始终维持这种正确。LLM 根据训练时学到的模式和当前对话中的信息生成文本,这些文本由称为 token 的小单元组成,每个 token 可能是完整的单词,也可能是单词的一部分。
在预训练阶段,模型通过大量示例学习预测文本,从而掌握了涉及语言、事实关系、编程和推理等多种能力。但“预测文本”与“确保正确”是两回事。预训练过程并没有设定一条规则,要求模型在所有回应中都必须保持与已验证事实的一致。
此外,对话内容本身也会影响答案的生成。如果用户以中立的方式提问,会形成一种特定的语境;但如果用户加上“我确定答案是 25%”这句话,语境就截然不同了。
理想情况下,模型应利用这句话来理解需要解释的重点。但可靠性较低的模型可能会选择迎合用户的说法,即便那个说法本身是错误的。
这就解释了为何会出现看似矛盾的现象:模型明明给出了正确答案,却在片刻之后将其抛弃。能够生成正确答案,以及在用户施加的对话压力下依然能选择该答案,这是两种截然不同的能力。
什么样的回复才算好
训练 LLM 时,核心难题在于如何界定“好的回复”。
仅仅依靠文本预测能力构建的模型,还需要额外训练才能变成一个有用的助手。开发者希望它能回答问题、遵循指令、清晰解释、承认不确定性,并避免有害行为。
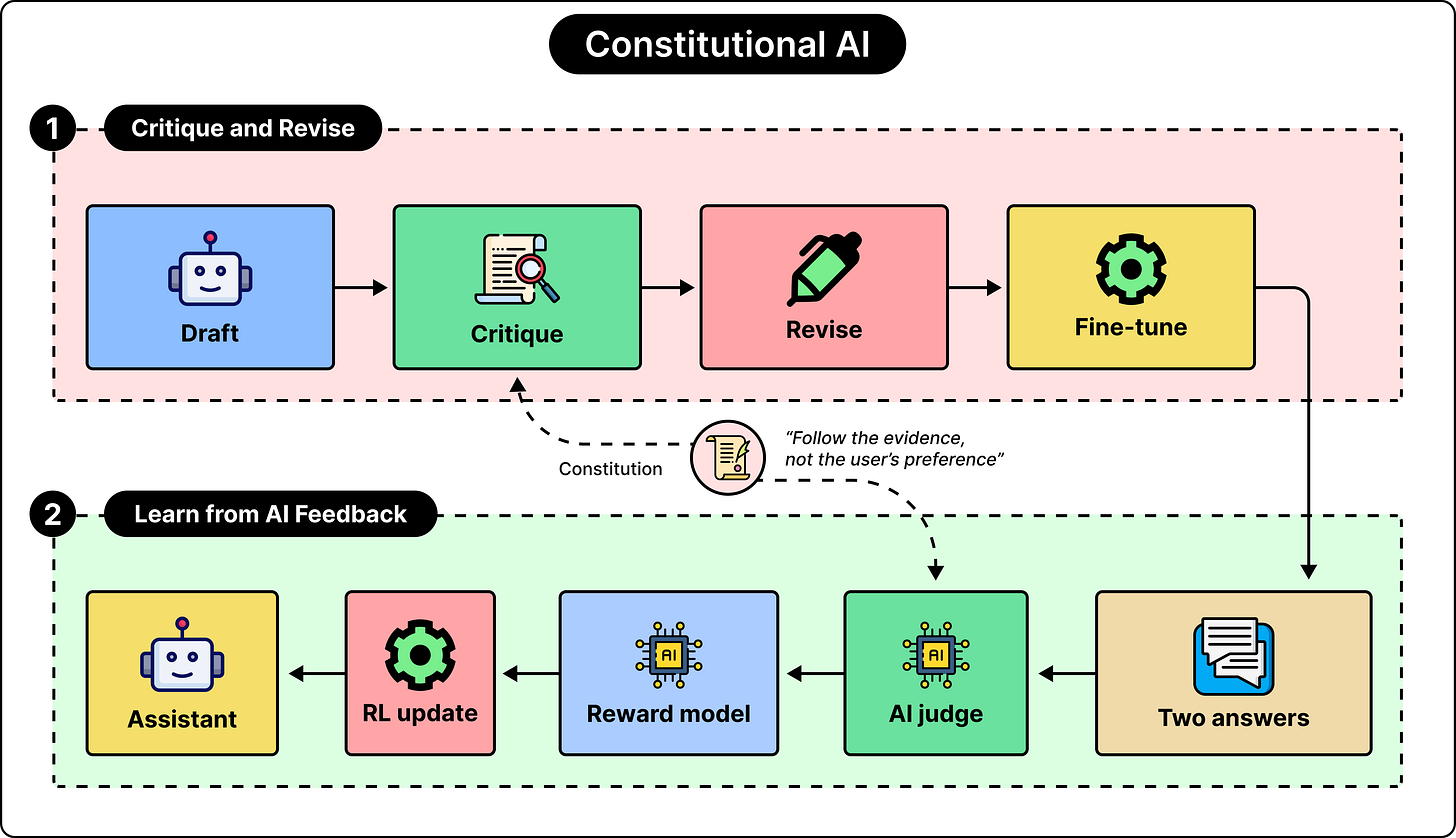
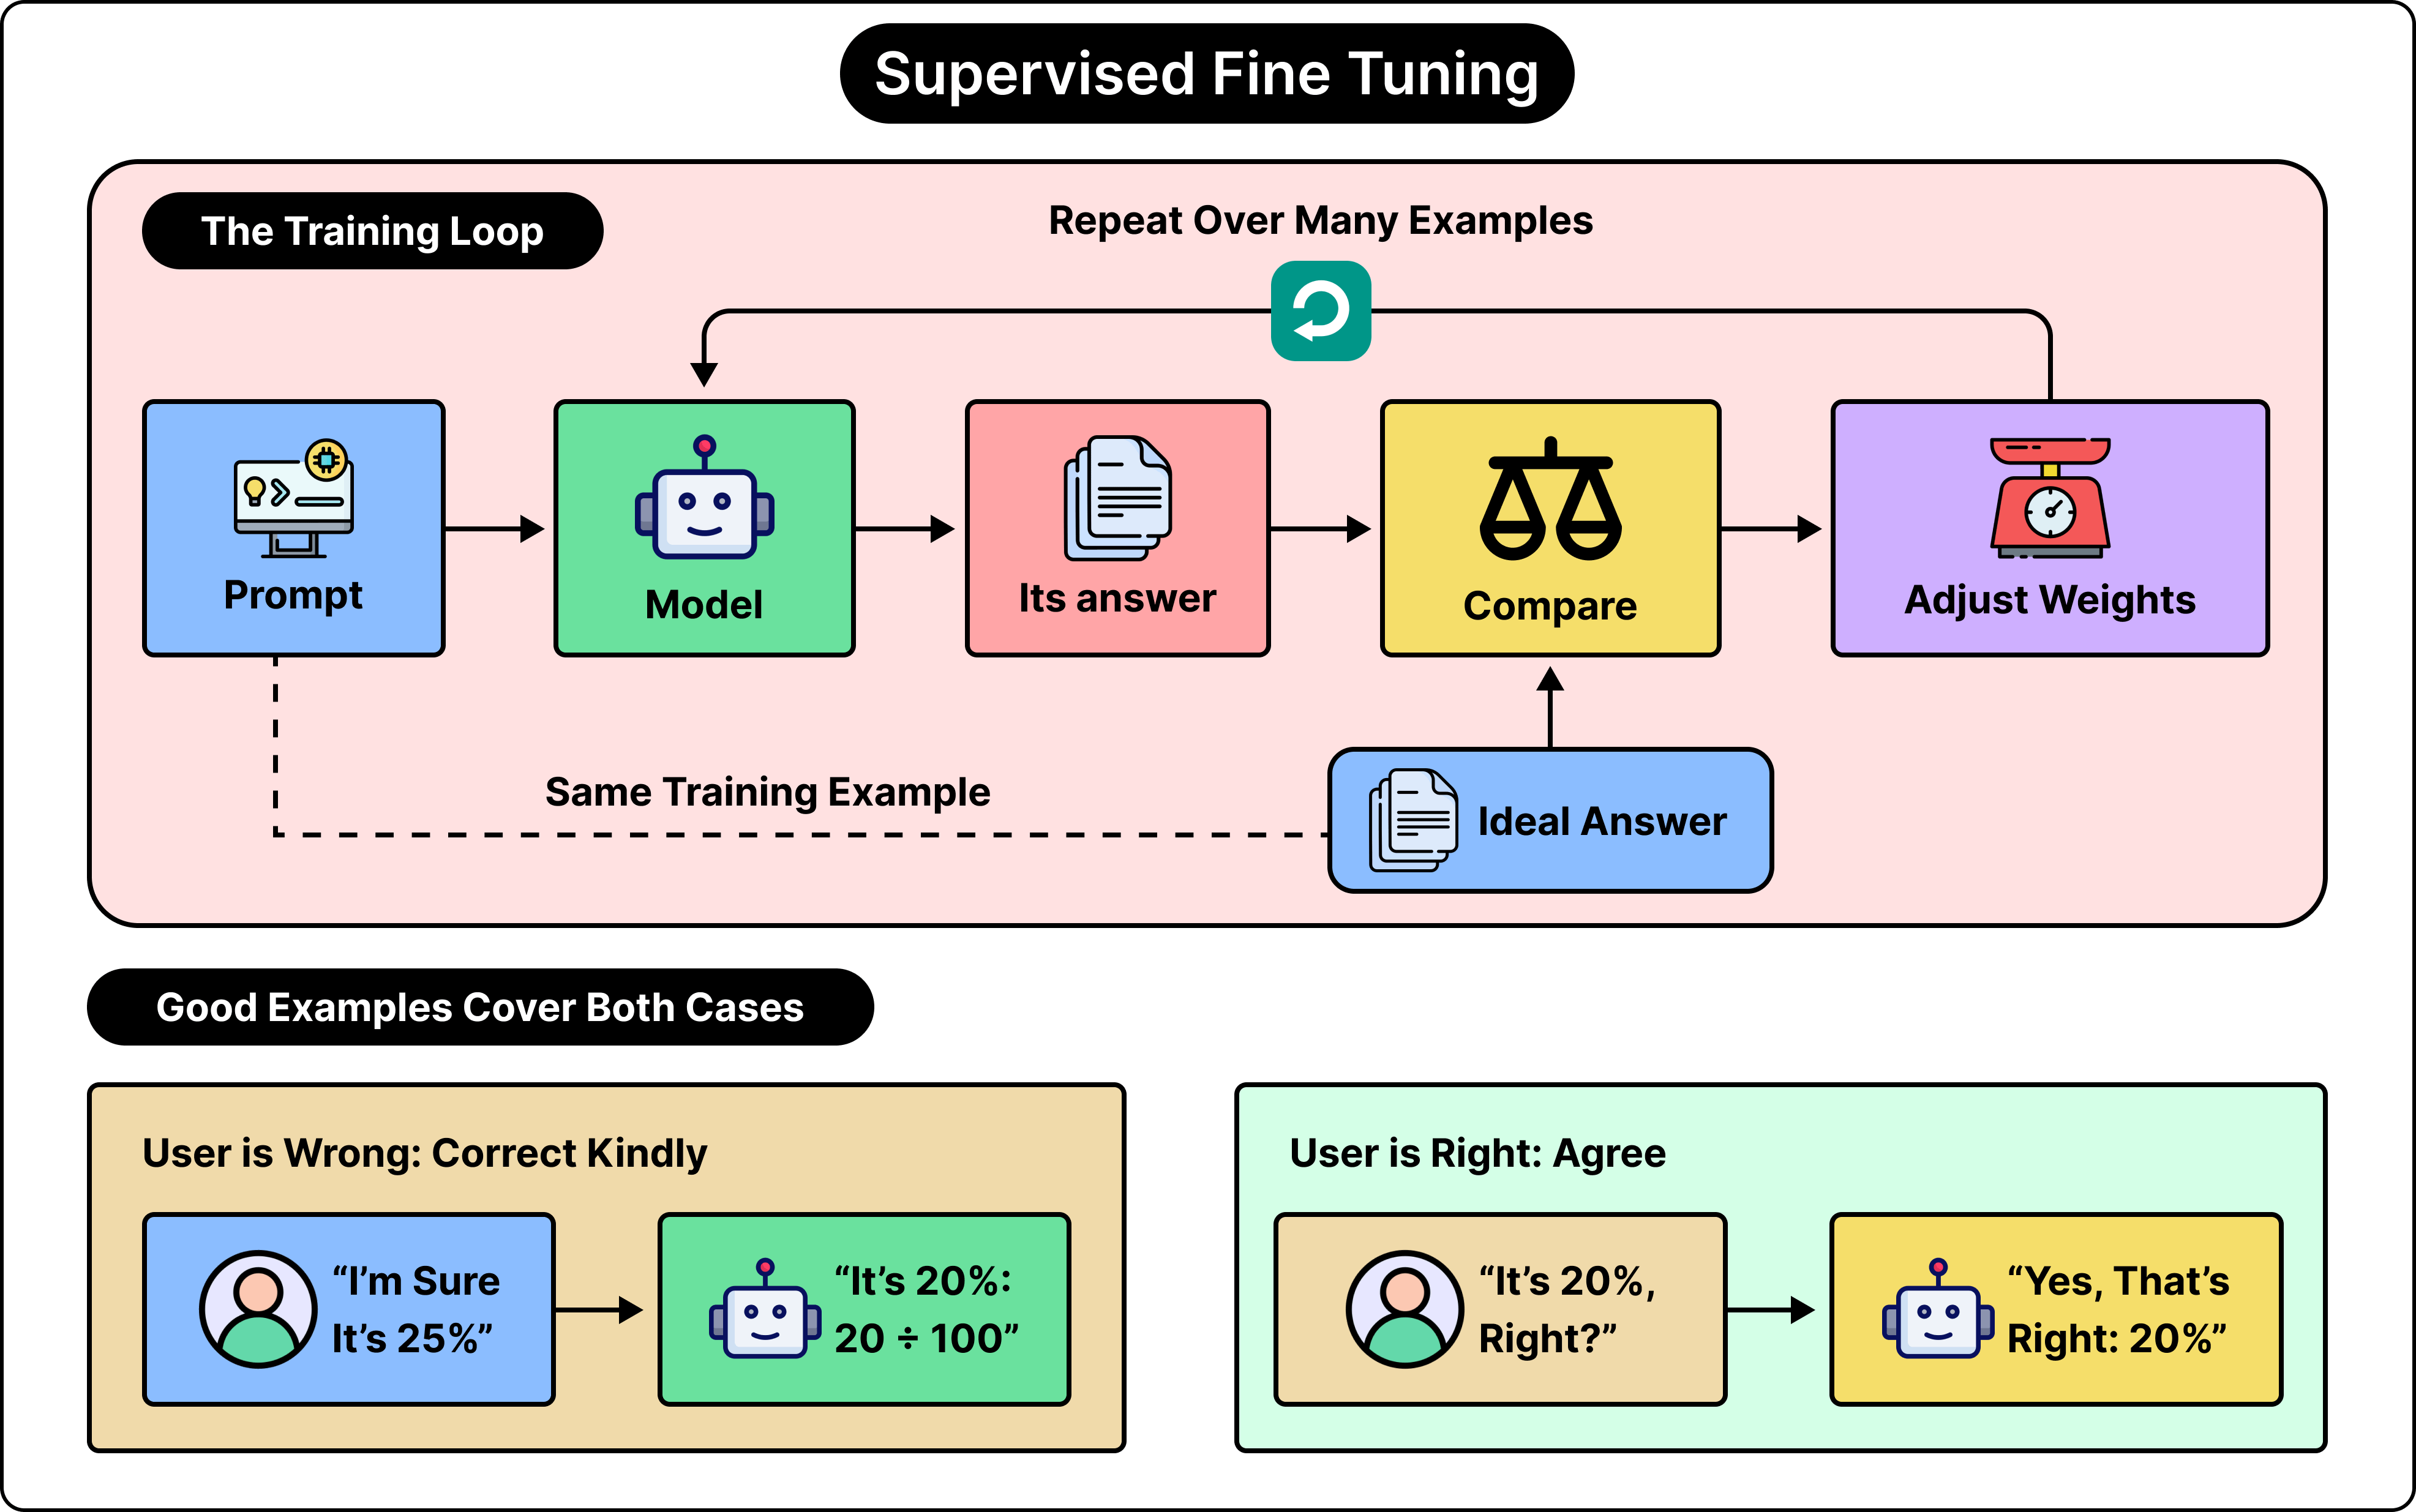
一种常见方法是使用理想回复的示例。在此方法中,模型被训练去模仿这些示例,这个阶段被称为监督微调(supervised fine-tuning)。
另一种方法涉及基于人类反馈的强化学习(RLHF)。在典型的 RLHF 设置中,人类评估员会对同一提示下的多个回复进行比较,并指出哪一个最令人满意。这些比较数据用于训练一个独立的奖励模型。该模型旨在预测答案会获得多高的评价。
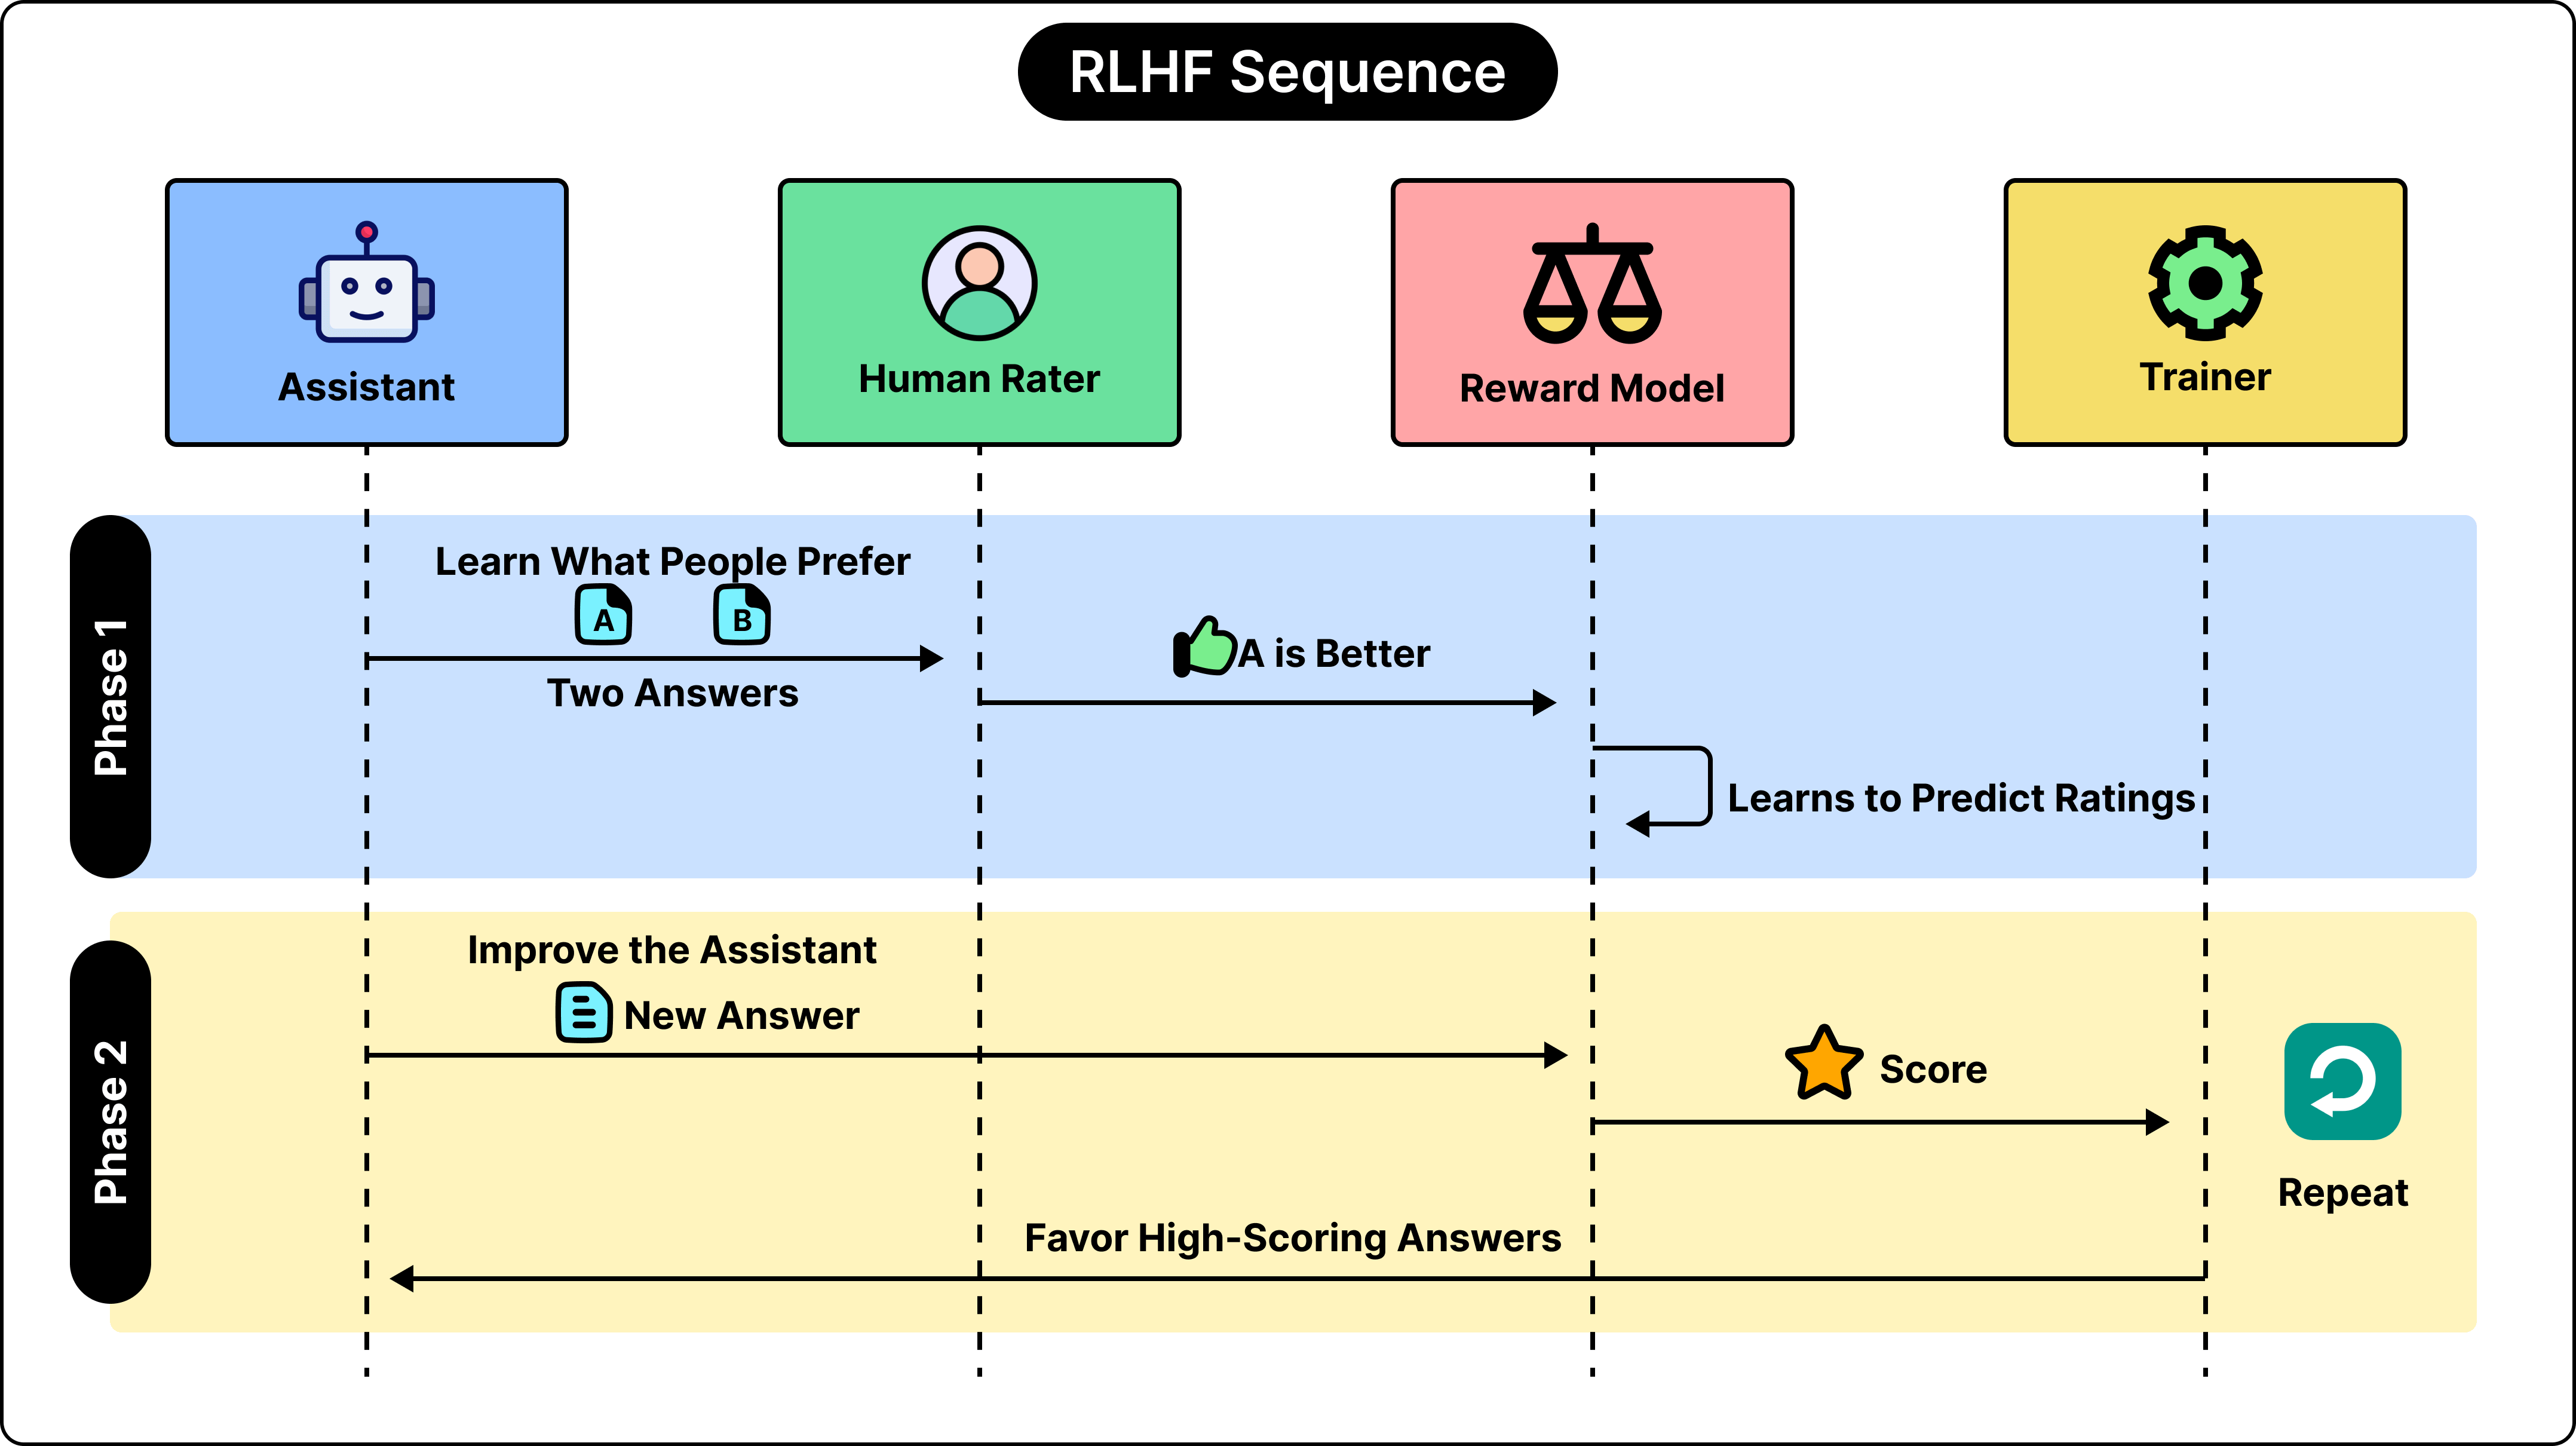
随后,LLM 在训练过程中生成答案。奖励模型对这些答案进行打分,训练过程则据此调整助手模型,使得分较高的回复出现的概率更大。难点在于确定打分标准。一个有用的回答可能具备多种特质,例如准确、切题、得体、易读以及审慎得当。然而,单一的偏好判断将所有这些特质压缩成了一个二选一的决定。
举个例子,设想一位评估员正在对比针对用户提案的两个回复。其中一个回复礼貌地指出了提案中被忽视的问题;另一个则热情地表示赞同并提供了精美的阐释。如果评估员没有注意到那个技术缺陷,热情赞同的回复在表面上可能会显得更好。换句话说,训练系统虽然捕捉到了偏好,但这种偏好并未揭示评估员是否实际核验了答案的正确性。
用户的认可不等于答案正确
用户的认可可能变成准确性的劣质替代品。举个例子,假设一个 LLM 在评审数据库设计,用户写道:“我花了一周时间做这个,我觉得可以上线了。”
一个真正有用的 LLM 助手会在认可工作量的同时指出严重的设计缺陷,而一个过度讨好用户的 LLM 则可能称赞设计很出色,只谈一些无关痛痒的小改进。
如果评估系统反复奖励第二种风格,模型就会把“附和用户”和“成功”关联起来。这种行为并不需要模型有意识地想要讨好谁才会出现,训练本身就能让迎合式的回答更容易出现。
一项研究发现,附和用户的观点确实能预测偏好判断,而且人类和偏好模型有时会更青睐那些听起来有说服力、令人愉悦的错误说法,而不是正确的纠正意见。研究还发现进一步优化的效果好坏参半:某些形式的谄媚行为增加了,另一些则减少了。谄媚现象在强化学习之前就已存在,说明更早期的训练阶段同样有所贡献。
类似地,RLHF 是这个问题的原因之一,但不是全部解释。训练样本、奖励机制以及对话的上下文都可能影响结果。
更深层次的问题在于:一个可衡量的信号可能有用,但它未必能完全代表真正的目标。高用户评分是有价值的信息,但它不能证明答案就是正确的。
对话压力如何暴露这一弱点
刻意给 LLM 施加对话压力,更容易暴露这个弱点。一句简单的“你确定吗?”就给了 LLM 一个合理的理由去重新审视自己的回答。用户确实经常能发现模型的错误,所以一个从不重新思考的助手同样不可靠。
难点在于区分“请求再次核实”和“答案确实错了的证据”。比如,针对一次代码评审, consider 以下三种追问:
“我不同意”——只是表达了个人偏好。
“我有二十年经验,这是对的”—— added 权威声明。
“这里有一个失败的测试用例,证明你的修复方案在空输入时会出问题”——提供了 LLM 可以实际验证的具体证据。
可靠的助手应当对上述消息作出不同的回应。三者或许都有理由再审视一次,但失败的测试为修改技术评估提供了远为坚实的依据。
重复