
Reflection 发布 Beam:成为中国以外性能最强的开源权重模型
核心要点
- AI 初创公司 Reflection 发布 Beam,这是其首个面向编码与推理任务的开源权重模型,重点在于追求计算效率而非极致性能。
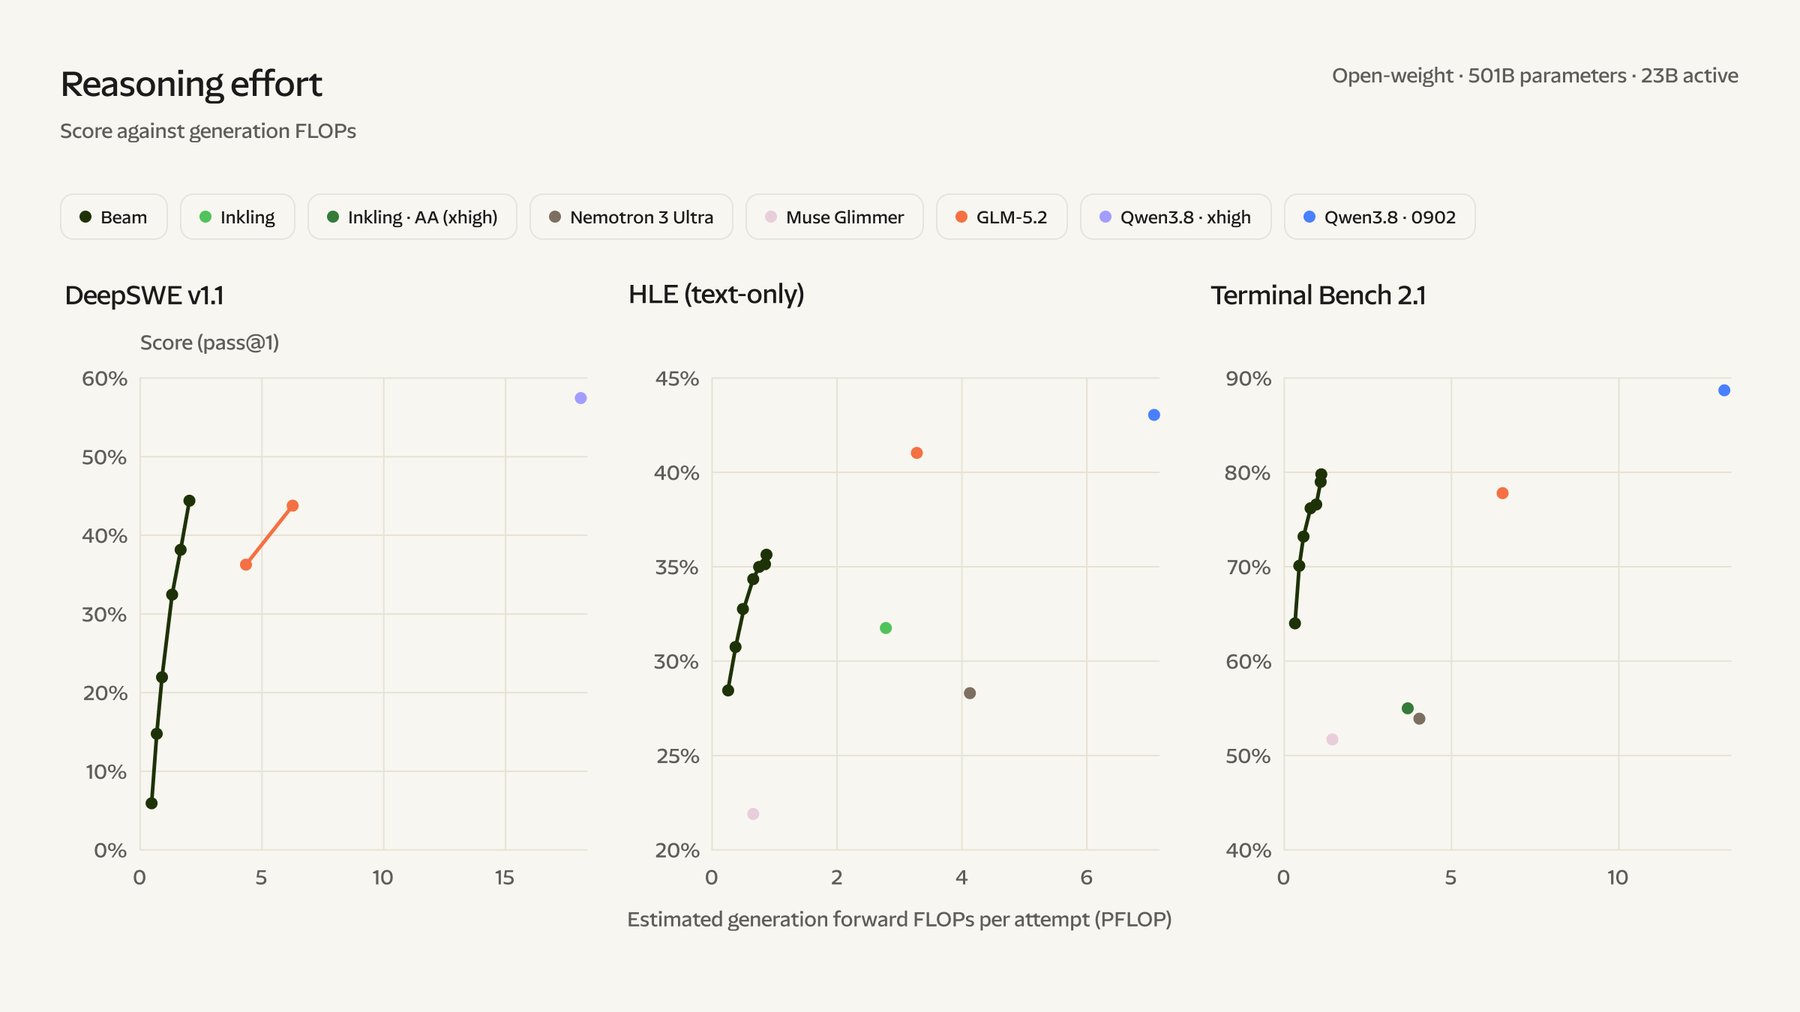
- 据 Reflection 介绍,Beam 每个 token 仅激活 5010 亿总参数中的 230 亿,在关键基准测试中与 GLM 5.2 持平,但计算成本仅为后者的三分之一到四分之一。
- 该模型使用 10,500 块 Nvidia GPU 进行强化学习训练,耗时四周。预计本月晚些时候将以 Apache 2.0 协议发布。
AI 公司 Reflection 宣布推出 Beam,这是其首个可自由获取的模型。与追求极致性能不同,Beam 旨在以最小化的计算量实现强劲表现,直接对标来自 Deepseek 和 Qwen 的中国开源权重模型。
Reflection 为 Beam 设定了编码、逻辑推理及 Agent 任务的目标。这是一款 Mixture-of-Experts(混合专家)模型,每个 token 仅激活 5010 亿总参数中的 230 亿,从而保持相对较低的计算成本。
据 Reflection 称,在高难度推理任务上,Beam 的表现与 GLM 5.2 相当,但计算量仅为后者的三分之一到四分之一。该公司主要瞄准那些利用 AI 进行代码生成和自动化工作流,同时需要控制运营成本的商业客户。
在编码和 Agent 基准测试中,Beam 也接近体量更大的 Qwen3.8-Max。Reflection 表示,像 Kimi K3 这样更强大的开源模型在原始性能上仍领先于 Beam。Reflection 称,他们正在训练下一代模型,旨在缩小与顶级开源性能模型之间剩下的差距。
| 智能体编码基准测试 | Beam | Inkling | Nemotron 3 Ultra | GLM 5.2 | GLM 5.3 | Kimi K3 | Qwen 3.8 Max | DeepSeek V4.1 Flash |
|---|---|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 44.4 | NR | NR | 44.0 | 61.0 | 68.0 | 51.0 | 74.2 |
| SWE Bench Pro v2-Hard | 77.2 | 56.9 | NR | NR | 84.3 | 88.2 | NR | NR |
| SWE Bench Pro v1 | 65.5 | 54.3 | 46.4 | 62.1 | NR | NR | 67.7 | NR |
| Terminal Bench v2.1 | 80.1 | 63.8 | 56.4 | 81.0 | 88.2 | 88.3 | 86.6 | 90.6 |
| SWE Atlas Codebase QnA | 34.6 | NR | NR | NR | 61.0 | 68.0 | NR | NR |
| SWEBench Multilingual | 78.0 | NR | 67.7 | NR | NR | NR | NR | NR |
| SWEBench Verified | 80.9 | 77.6
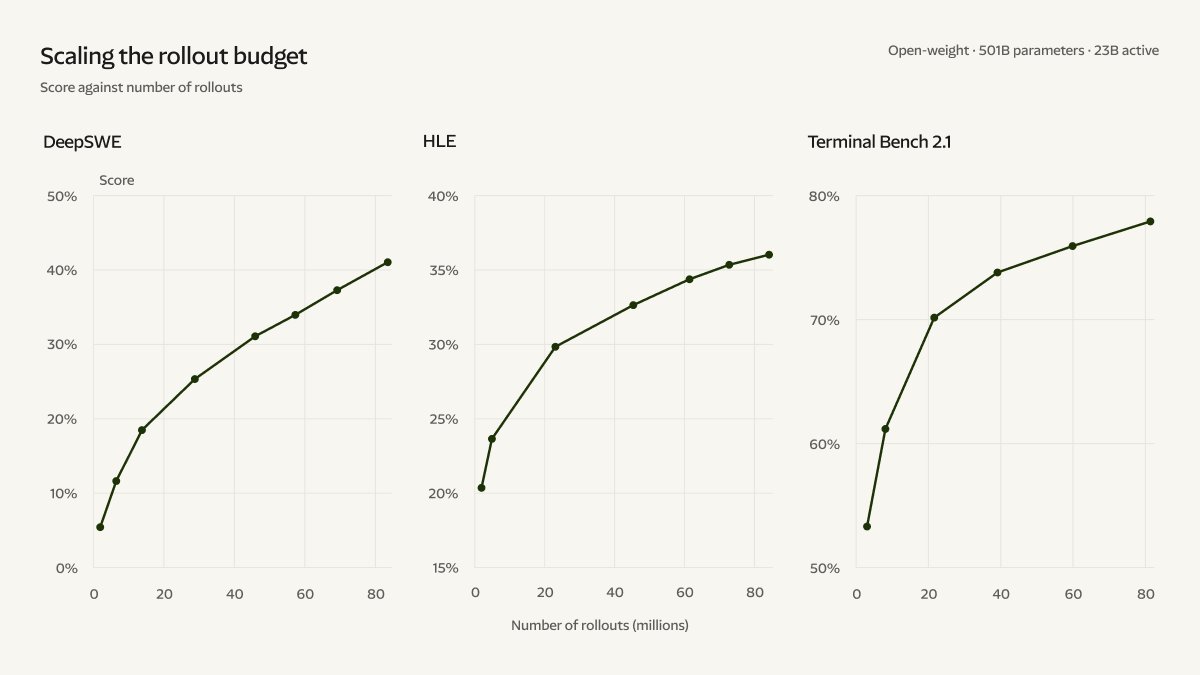 用户还可以控制 Beam 对问题进行推理的深度。通过一个可调参数,你可以让模型快速给出答案,也可以让它在较难的任务上花更多时间思考,在计算成本和输出质量之间做出权衡。 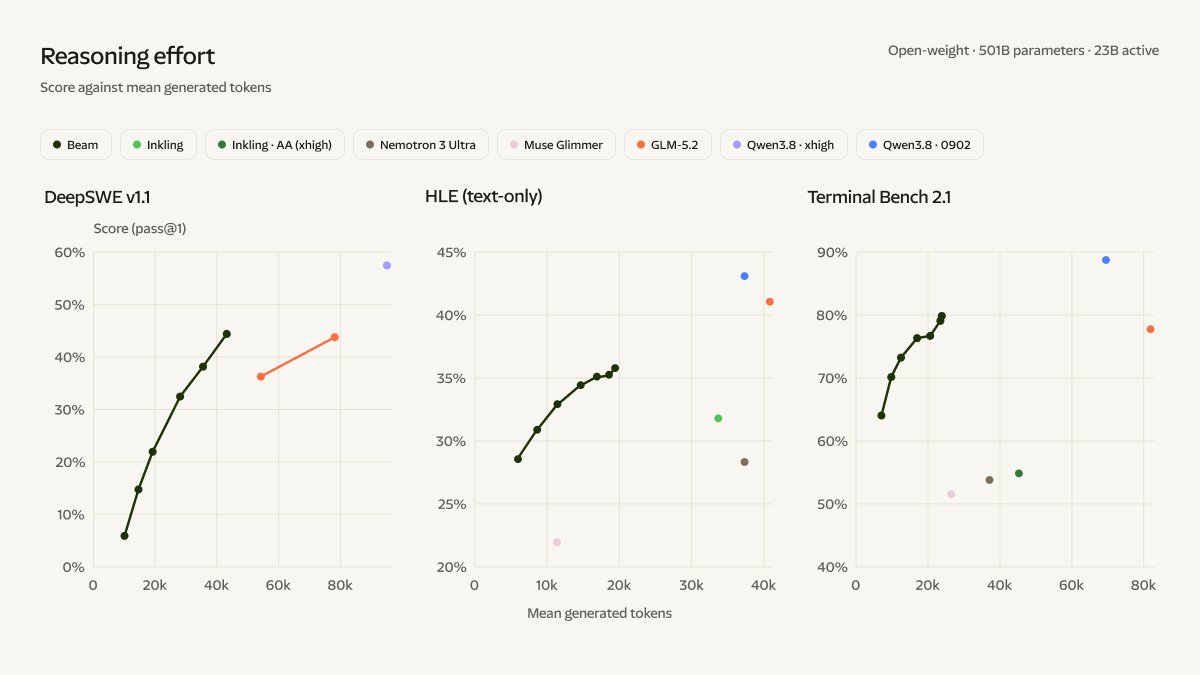 Reflection 在训练过程中观察到了所谓的"涌现能力"。在运行一个混合了推理、软件工程和终端任务的 RL 训练时,公司注意到 Beam 的网页浏览能力也在提升,尽管训练任务中并不包含浏览任务。借助网络访问,模型还自主学会了查询其他语言模型,并从外部服务拉取文档。 Reflection 展示了几个演示,包括一个实时更新的纽约地铁线路图、一个小型 3D 游戏,以及一个用于微调其他 AI 模型的 notebook。Beam 是纯文本模型,但 Reflection 表示,只要其他媒体格式的内容能以文本形式呈现,它就能处理。 由独立的模型负责安全与对齐在安全与对齐方面,Reflection 训练了第二个模型并将其与 Beam 融合。该模型的行为准则涵盖了从绝对禁止违反的硬性规则,到事实准确性、承认不确定性等质量标准,以及直接、深入且主动的响应风格。公司计划通过技术报告发布其安全测试结果,并开源其所开发的评估方法。 据公司透露,技术报告、开发文档以及基于开放 Apache 2.0 许可证的模型权重将于“本月晚些时候”发布。Beam 目前仍在进行最终安全测试,暂仅提供给部分用户试用。 由 20 亿美元资金支持的 ex-DeepMind 研究人员创立Reflection 由前 Google DeepMind 研究人员 Misha Laskin 和 Ioannis Antonoglou 于 2024 年创立。Laskin 曾主导 Gemini 的奖励建模工作,而 Antonoglou 曾参与 AlphaGo 的构建。该公司于 2025 年 3 月正式启动,获得 1.3 亿美元种子轮融资,旨在通过自主编码构建超级智能。其愿景是语言模型能够像 AlphaGo 下棋一样独立地行动,利用计算机进行强化学习。 2025 年夏季,公司推出了 Asimov,一个用于分析大型代码库的 AI 代理。随后,Reflection 于 2025 年 10 月以 80 亿美元估值融资 20 亿美元,投资者包括 Nvidia。自此,该公司将自己定位为 DeepSeek 和 Qwen 的西方对应者。它公开发布模型权重,但保持训练数据和流程的专有性。最近,Reflection 与 SpaceX 及云服务商 Nebius 签署了数十亿美元规模的算力协议。 原始来源: The Decoder 评论 (0) |