
把AI装进家里那台 NAS:本地大模型部署全流程
云端大模型好用,但每次对话、每张照片、每份文档都要先传到别人服务器上。对在意隐私的人来说,这始终是个心结。
飞牛 NAS 本身是台小电脑,跑几个开源大模型绰绰有余。这篇文章不绕弯子,直接给两条可落地的路:应用中心一键装、Docker 手动装,配齐模型选择、硬件门槛和常见报错。
01 先看硬件够不够
本地跑模型,拼的是内存和存储,CPU 反而不是最大瓶颈。
- 内存:跑 0.8B~1.5B 的小模型,4GB 够用;跑 7B 模型建议 8GB 起,边跑边聊不卡。
- 存储:模型文件按体积算,0.8B 约 1GB,7B 约 4~5GB,预留 20GB 空间比较稳。
- GPU(可选):有核显或 NVIDIA 独显可显著提速;没有也能纯 CPU 跑,就是慢一些。
- 系统:飞牛 fnOS 应用中心或 Docker 环境即可,X86 和 ARM 都支持。
判断标准一句话:能跑飞牛影视转码的机器,就能跑本地小模型。
02 路线 A:应用中心一键装(推荐新手)
飞牛应用中心已经收录了 LobeChat 这类 AI 对话前端,安装和装相册、影视一样简单。
1. 打开飞牛控制面板 → 应用中心 → 搜索「LobeChat」; 2. 点安装,选好安装位置(建议放到容量大的存储空间); 3. 等待安装完成 → 打开应用,浏览器进入前端页面; 4. 在设置里把模型服务地址指向本机或局域网内的模型服务。
前端装好后,背后需要一个模型服务。继续看路线 B,把模型服务也搬进 NAS。
03 路线 B:Docker 手动部署模型服务
以 Ollama 为例,它是目前最主流的本地模型运行器,支持 Qwen、Llama、DeepSeek 等大量开源模型,一条命令就能拉模型。
第一步:在飞牛 Docker 里新建项目。打开飞牛 Docker → 项目 → 新增,粘贴下面的 compose 配置:
```yaml services: ollama: image: ollama/ollama:latest container_name: ollama ports:
- "11434:11434"
volumes:
- ./models:/root/.ollama
environment:
- OLLAMA_HOST=0.0.0.0
restart: always ```
第二步:启动容器。点「部署」,等状态变为运行中。端口 11434 就是模型服务的 API 入口。
第三步:拉取模型。进入飞牛 Docker → 容器 → ollama → 终端,执行:
```bash ollama pull qwen2.5:7b ```
想先试小的,可以换 `qwen2.5:0.5b` 或 `qwen3:0.6b`,下载快、内存要求低。
第四步:验证服务。浏览器访问 `http://NAS的IP:11434`,能返回 Ollama 信息就说明服务起来了。
04 把前端和模型服务连起来
回到 LobeChat(或任何 OpenAI 兼容前端),在模型服务配置里填:
- API 地址:`http://NAS的IP:11434/v1`(同一台机器可填 `http://127.0.0.1:11434/v1`);
- 模型名称:填你拉取的模型名,如 `qwen2.5:7b`;
- API Key:本地服务一般不需要,随便填一个占位即可。
保存后新建对话,能看到模型开始回复,就是全部打通了。局域网内手机、电脑都能通过 NAS 的 IP 访问。
LobeChat 桌面端界面:左侧会话列表,中间聊天区,配置好本地模型后直接对话。
05 模型怎么选:按内存对号入座
- 4GB 内存:qwen2.5:0.5b / qwen3:0.6b,日常问答、写文案够用。
- 8GB 内存:qwen2.5:7b / deepseek-r1:7b,推理和中文能力明显更好。
- 16GB 以上:可以试 14B 甚至 32B 模型,接近云端中小模型的体验。
- 显存用户:有 NVIDIA 显卡可在 Ollama 里开 GPU 推理,速度翻倍。
判断原则:模型越大越聪明,但越吃内存。先小后大,跑不动就降一档,比硬上大模型体验好得多。
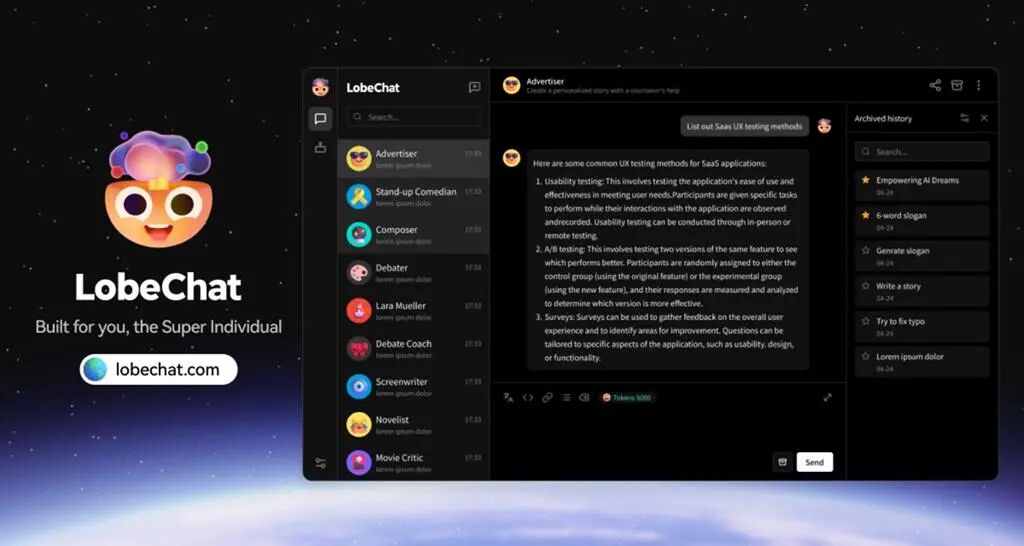
LobeChat 对话界面:选好模型后即可对话,界面和云端 AI 基本一致。
06 三个常见报错,直接照做
- 模型下载慢:Ollama 默认走官方源,国内网络可能慢。可配置镜像源(如 `OLLAMA_HOST` 环境变量配代理地址),或选择 Qwen 等国内模型源。
- 启动后报内存不足:模型档位选太高。换更小的模型,或给容器加内存限制后重启。
- 局域网其他设备连不上:检查容器是否映射了 `0.0.0.0:11434`,并确认防火墙放行 11434 端口。
07 本地模型的边界,说清楚
本地模型不是「云端替代品」,更像「家庭数据管家」:处理相册、文档、日志这类隐私重、不需要最强能力的任务,它免费、离线、随时可用。
它做不到的事也要讲明白:参数量决定了能力上限,复杂推理、最新知识、多模态理解,本地小模型和云端旗舰仍有差距。正确用法是隐私任务走本地,重任务走云端,各管各的。