
AI新闻周报:Reflection 发布 501B-A23B 美国本土开源模型 Beam
距离 Reflection 与我们一同发布 已经过去了一年多,当时他们立下了在编码领域的宏大目标(并暗示了其 RL 方法):
但他们“隐身”的时间比 Thinking Machines 更长。原本不明朗,因为更广泛的开放模型生态系统并没有为他们放慢脚步。嗯,我们做到了:
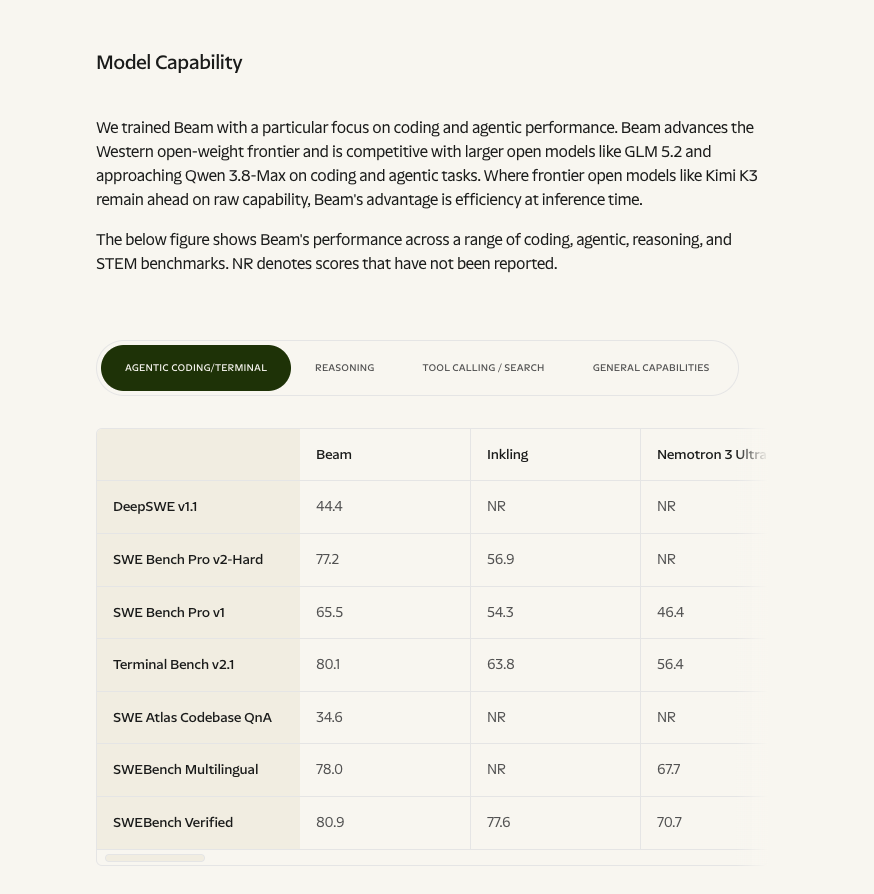
他们将自身与 Inkling、Nemotron 和 GLM 5.2 进行了对比,但 SOTA 的 GLM 5.3、Kimi K3、Qwen 3.8 Max 和 DeepSeek V4.1 Flash 通常更具优势。不过,既然该模型完全在美国从头训练,市场上一部分人一直在急切等待更多此类选择。更重要的是,Reflection 如今已宣布其作为一个功能性新实验室(neolab)的到来!
2026年10月3日至10月5日的 AI 新闻。我们检查了12个 subreddit、544 个 Twitter 账号以及更多的 Discord。通过 AINews 网站,你可以搜索所有过往刊期。提醒一下,AINews 现在是 Latent Space 的一部分。你可以 选择是否接收 邮件频率!
AI Twitter 回顾
Reflection 的 Beam 引领了一波开放权重模型的发布浪潮
Beam 发布:Reflection 发布了 Beam,这是一款专为编码、智能体及科学工作设计的纯文本 MoE 模型,总参数量 501B,激活参数 23B。该模型从头训练,其完整的 Apache 2.0 许可证权重预计将于本月开放(公告、Laskin)。
训练规模:团队官方帖子称预训练使用 23.8T tokens,部分来自对数亿份 PDF 的 OCR 管线(数据负责人)。他们还提到在 1 万张 GB300 上稳定运行 RL/OPD,覆盖约 100 万个任务、超过 1 亿条 rollout(Damos)。
宣称结果:Reflection 的总结显示 SWE-bench Verified 得分为 80.9,推理效率是 GLM 5.2 的 3–4 倍,且预训练与 RL 各训练了 4 周,约使用 10,500 张 GB300(总结)。技术报告和开源集成也在路上(Polozov)。
背景信息:Axios 提前报道了这次发布。报道指出 Reflection 每月为 Colossus 算力支付 1.5 亿美元,另有与 Nebius 的 10 亿美元协议;同时多家未具名的美国实验室将在本月发布开放模型(Curran)。
独立与批判性解读:Artificial Analysis 已获早期访问权限,预计 Beam 在其智能水平下是最 token 高效的开源模型之一(AA)。
MFU 与架构:Elie Bakouch 估算预训练 BF16 MFU 仅约 12%。他判断架构采用 3:1 的全局/滑动窗口注意力交错,并表示其 held-out 代码 perplexity 优于 DSv4(分析)。
算力对比:Teortaxes 称 Beam 是 DeepSeek V3 的 iso-FLOP 复制品(帖子)。他推测 4 周内 RL 共启动约 13 亿个沙箱,峰值同时运行多达 17 万个(沙箱数据)。
定位:观察者普遍认为 Beam 处于 GLM-5.2 水平(iScienceLuvr),在部分基准上低于 DSv4 Flash(点评)。Nathan Lambert 将它与 Nvidia 和 Thinking Machines 的模型归为一类——都是实力强劲的美国发布,但仍落后于中国同行(Lambert)。
其他开源与专业模型:
Aleph Alpha Kolibri:总参数 78B / 激活 3.46B,Apache 2.0 协议,专为德语和英语打造。官方自报成绩为 AIME 2025 达 96.9%、GPQA Diamond 达 84.3%、SWE-Bench Verified 达 66.4%(汇总)。不过训练数据集未公开,agentic 评测也明显低于 Qwen(Jitsev)。
Reka Rho-1:一款 19B 全模态模型,可理解和生成文本、图像、视频及机器人动作,从零训练,仅用 320 张 H100 耗时约 3 个月(发布,算力)。
决策模型:Command Code 的 Agr(31B)和 Agr-flash(360M)不生成文本,而是直接返回带各选项概率的类型化数值,用于工具调用和路由(Agr)。SemiAnalysis 指出 TypeSafe 的 Jev 采用同样的免解码方案,主要在路由场景中替代前沿模型(解读)。
小型发布:Upstage 的 Solar Mini 4(35B / 激活 3B,512K 上下文)在 Nous Portal 上免费开放两周(Nous)。Eleven v4 Turbo 以 v4 一半的价格登顶 AA 的 Provider Voice TTS 竞技场(AA)。
OpenAI 与 Anthropic:订阅价值、速度与评测
SemiAnalysis 限制测试:SemiAnalysis 针对 Anthropic、OpenAI、Meta、SpaceXAI、MiniMax、Moonshot、Cursor、Cognition 等公司的订阅计划进行了测试。结果显示,Claude 的订阅提供的 API 等效价值是 OpenAI 计划的 5 倍以上(报告)。
OpenAI 容量紧张:用户反映,新用户的 $200 订阅已暂停办理,且各档位的用量限制实际上减半。GPT-6.1 Sol 被定位为高效替代方案(分析)。Theo 描述了 7 月至 9 月期间编码模型偏好的逆转(帖子)。
企业需求(报道):The Information 报道称,微软将内部 Anthropic 支出的预测值削减了三分之一以上。报道还指出,Meta 的 Claude Code 用户数从约 6 万降至约 3 万,主要原因是 Meta 大力推广其自有工具(摘要)。
排行榜:
Agent Arena:Anthropic 在 Code、Work 和 Chat 类别中均位居第一。Fable 5.1 领先 Code 和 Work 类别,而 GPT-6 Astra 在 Code 类别中排名第二(Arena)。
Design Arena:GPT-6 Astra 在 3D Design、Frontend、Full Stack 和 Image-to-HTML 类别中均排名第一(Design Arena)。
幻觉测试:在 AA-Omniscience 测试中,Gemini 4 Argon 在未知问题的错误猜测率为 15%,而表现第二好的模型为 29%。GPT-6 Astra 准确率最高,达到 61%(数据)。
Agent 运行环境、RL 环境与开发者工具
多环境 RL(Hugging Face):一款捕获代理支持 OpenAI Chat、OpenAI Responses、Anthropic 和 Gemini 格式。它将对调用转发给 vLLM,并记录精确的 token ID 和 logprobs 以供 TRL 使用,从而使 10 个未修改的运行环境转变为 RL 环境(Delangue,解析)。
结果:相同权重的模型在 Mini-SWE-Agent 下得分为 62%,而在 Claude Code 下仅为 33%。在 4 个运行环境下训练 LFM2.5-2.6B 使首次尝试解决率从 42% 提升至 54%,并引入工具调用奖励可将调用次数减少 31%。在 3,189 次 rollout 上进行 SFT 后,性能稳定在 47.5%。
局限性:该运行实验仅使用了一个任务族和一个种子。
环境托管:RL 环境如今像数据集一样在 HF Hub 上托管和版本控制(博客)。
Pi Durable:Earendil 的运行环境围绕小型基于任务的工作流引擎构建,使长时运行、多人 Agent 可以在任意位置暂停和恢复(Pi)。
Agent 记忆:Cognition 推出 Devin「Dreaming」,夜间自动修剪并链接记忆图谱,并将基于 git 和 markdown 的格式开源为 Agent Memory Repo(发布,格式)。
Cursor SDK:本次更新支持运行中途干预(mid-run steering)、可向主 agent 汇报的后台 subagent、可替换的 system prompt,以及在自定义工具上添加 MCP
readOnlyHint和destructiveHint注解(steering,注解)。DeepSeek Harness:v0.2.1-alpha.1 中加入了一个实验性的 Claude Code Mods 兼容层,用来验证 DSH 的「一切皆插件」架构是否是 Claude Code 扩展点的超集(团队帖子)。
路由与访问:
Agent 与训练研究
验证优于采样:
上下文管理:
自我改进框架:
优化与架构:
Dust:一种基于激活扰动“虚拟种群”的零阶方法,在 Transformer 预训练中接近甚至有时超越反向传播。其计算效率据称比 EGGROLL 高 1,000–10,000 倍(帖子)。
LOOM:循环 MoE 在 9–12 次循环下训练保持稳定,且 700M 模型在 5 次循环时 iso-FLOP 表现最佳(线索)。
ImageNet 策略梯度:Ian Osband 指出,在 ImageNet 上,精确策略梯度可达 4%(对比交叉熵 62%),他主张 RL-loss 的失败并非仅由探索问题导致(帖子)。
RL 动态:Base Labs 发现 RL 更新的低秩性低于先前的说法(rollout)。Datalab 报告称,单靠 RL 即可在温度 0 时消除工具调用循环,相比之下 SFT 的循环率高达 92%(分析)。
AI 科学应用:Vals AI 报道,90 多个 Opus 5.5 智能体在 3 天内运行了 DFT 模拟,并标出两个室温磁性半导体候选材料,其中一个早在 1999 年就被合成过。结果仅为预测,且有公开账本(线索、注意事项)。
智能体支出:Epoch 估算 OpenAI 研究人员用于编码智能体的开销(按 API 价格计价)大致每月翻一番。中位数研究员至 8 月中旬已达约 600 美元/天(Epoch)。
推理系统与硬件
OpenRouter 定价失真:Horace He 指出 GLM 5.3 在 inference.net 上的输入价为 0.08 美元/M,而输出价却高达 5.00 美元/M。他将其归因于 OpenRouter 的平方反比价格路由以及对输入价格的显著过度加权(线索、路由)。
llama.cpp:
Agentic 内核开发:Baseten 宣布用智能体在一周内基本自主完成了一个推理引擎的开发,解码速度比开源基线快 90%,TTFT 降低 57%(博客)。
通信优化:NCCL 与 PyTorch 对称内存加速了中小规模集合通信(Bekman)。
中国加速器:阿里平头哥的镇武 V900 配备 216 GB 显存、1200 GB/s 互联带宽,宣称性能达 M890 的 3 倍,预计 2027 年 Q1 上市(SemiAnalysis)。
安全、政策与行业动态
OpenAI 文本水印:根据欧盟 AI Act,OpenAI 将为符合条件的 ChatGPT 和 Codex 文本添加隐形统计水印,并通过 API 向全球提供可选开关(公告)。
智能体事故与安全治理:
政策声音:
中国的算力获取:
行业整合:
AMD 与 World Labs(据报道):AMD 据报道以 82 亿美元收购 World Labs(DL Weekly)。
NVIDIA 的中立性:SemiAnalysis 质疑 NVIDIA 在收购 SchedMD/SLURM 和 Hugging Face 后硬件中立性的立场(SemiAnalysis)。
热门推文(按互动量排序)
Tibo:Codex 每日改进或重置,持续 28 天 — 3.09 万
Achiam:应禁止某些自主武器 — 1.12 万
OpenAI 欧盟文本水印政策 — 7700
Reflection 推出 Beam 模型 — 7400
HF:将编码测试床作为 RL 强化学习环境 — 2500