
一张游戏显卡跑1250亿参数的AI大模型,124 token/秒,这个开源项目火了
Hacker News 上有个热度很高的帖子:用消费级硬件跑 1250 亿参数的 Qwen3.8-Flash-Next。
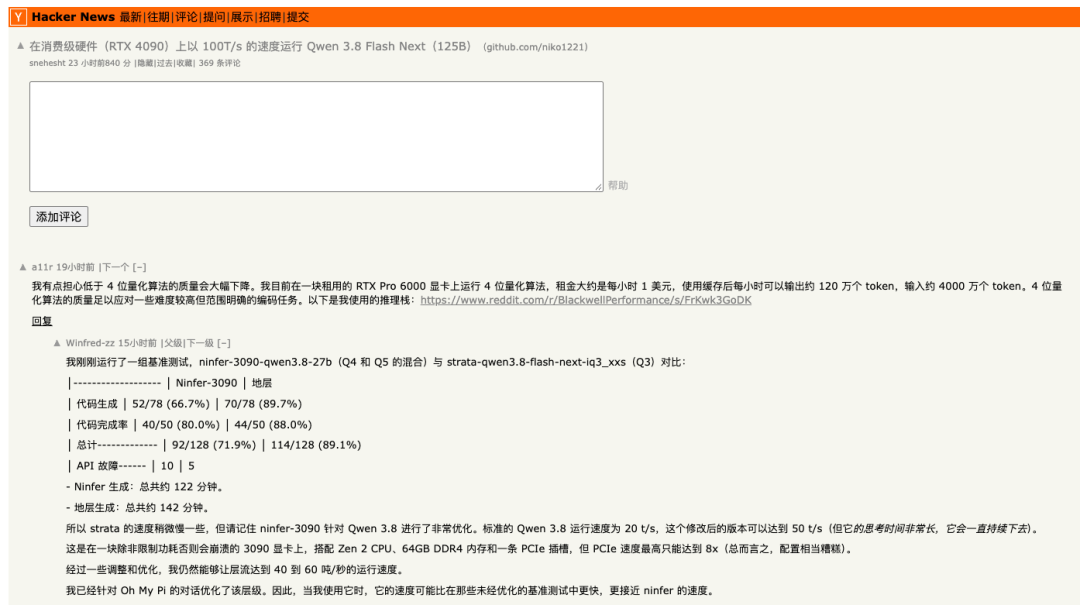
发帖人自己上手测了,机器是一张 RTX 4090,配 128G DDR5 内存,CPU 是锐龙 7950X3D,跑出来 124 token/秒。帖子发出来一天就攒了 776 分,我写这篇的时候又去看了一眼,已经 831 分了,评论三百多条。
本地跑大模型,我之前也介绍过几个开源框架,但实际情况基本都是能跑通,但速度感人,只有验证价值没有使用价值。
之前普遍的情况是,显存不够的,模型直接加载不起来;好不容易加载起来的,生成速度又慢得离谱,一分钟出不来一个字是常有的事,基本就是装个新鲜,然后放在那吃灰。
但今天要说的这个开源框架 Strata,和之前的不一样。这个项目很新,9 月 24 日才建的库,MIT 协议,十来天 Star 就过了 1.2 万。
125B 的模型是怎么塞进游戏电脑的
1250 亿参数听着挺吓人,不过它是 MoE 架构。说白了,模型里面其实有两万四千多个"专家",每往外吐一个词,真正参与计算的只有其中十来个,大部分专家大部分时间是闲着的。
Strata 干的事情就是把这批专家分开安置。最忙的那几千个放进显卡里常驻,全部专家在内存里放着,CPU 顺手把不忙的那些算掉,SSD 上还存了一张查询表,用来快速找到该叫哪个专家起来干活。就这样的一个分工架构,把我们电脑的显卡、内存、CPU、SSD 都用上了,整机没有一个闲着的。
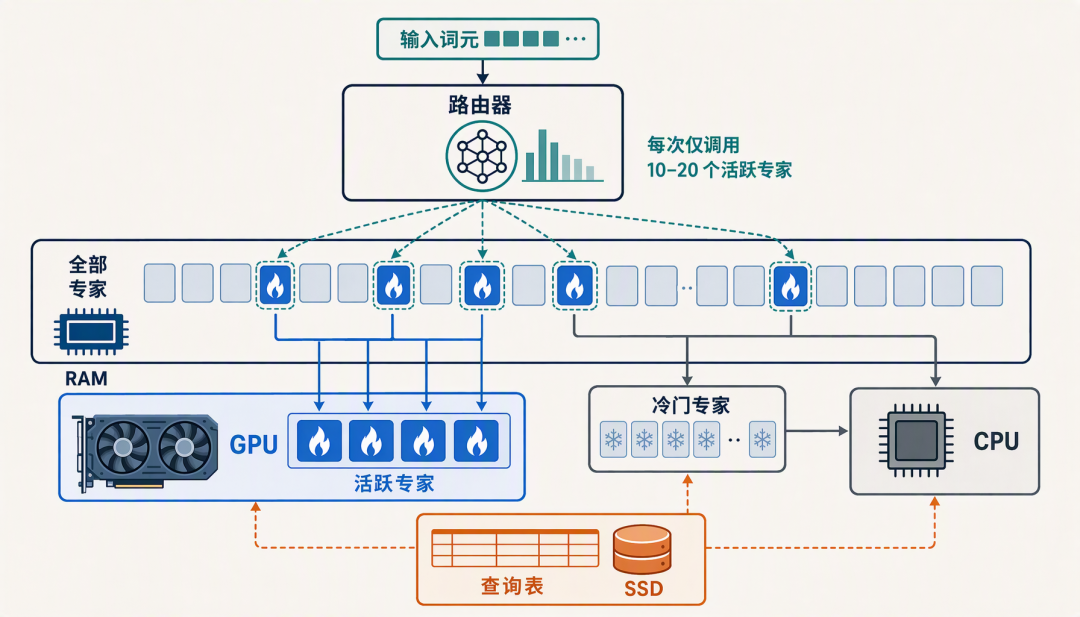
还有一点,模型往外写字的时候,Strata 会让一个小模型先猜后面几个词,然后大模型一次性验证。猜对了就一口气多出好几个词,速度能快 1.6 到 1.8 倍,答案跟原来一模一样。
能做什么
装好以后,主要能干这些事:
聊天、写东西、读长文档。 上下文默认 128K,最长可以到 256K,一整本书或者一个代码仓库塞进去都没问题。官方的说法是 32K 的文档大概一分钟读完,反正比我读得快多了。
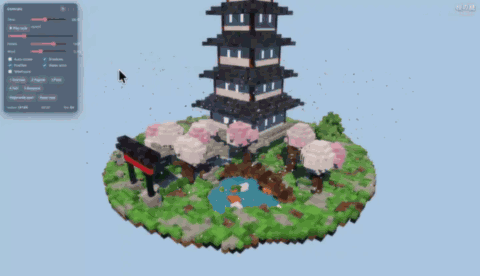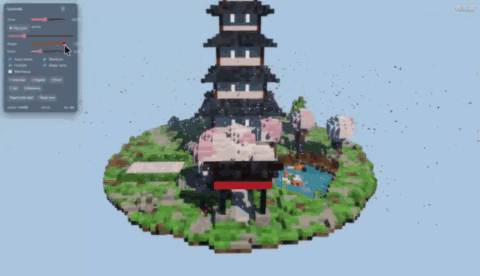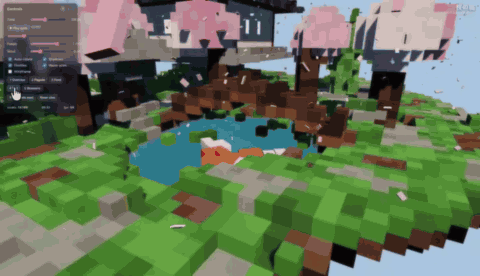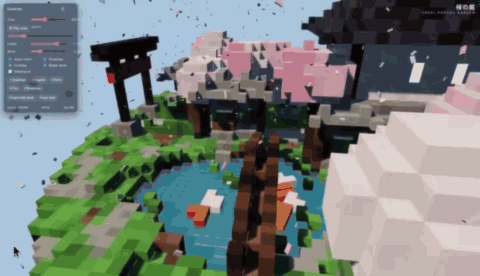
写代码。 官方演示里有个例子挺直观的:一句话提示,它现场写了一个能在浏览器里拖来拖去看的 3D 体素宝塔花园,一个 HTML 文件,1226 行,一次写完,是在 RTX 5070 上跑的。
看图。 截图、照片直接贴给它就行。有个限制要说一下:AMD 卡在 Linux 上是走 CPU 处理图片的,Windows 上暂时还不支持。
给编程工具当本地后端。 它在本地起了兼容 OpenAI 和 Anthropic 的 API,Claude Code、Cursor、Codex 这类工具把地址指过来就能用。模型跑在自己机器上,token 不花钱,代码也不用传出去。
思考深度可调。 off、low、medium、high 四档,平时闲聊关掉思考最快,遇到难题再开 high。
速度到底怎么样
作者自己拿两台游戏 PC 测过,一台 N 卡一台 A 卡。先说一下 tok/s 这个概念,就是每秒出几个词,60 以上基本就比你眼睛看得快了。下面是写答案的速度:
| 量化版本 | RTX 5070(12G 显存 + 64G 内存) | RX 9070 XT(16G 显存 + 47G 内存) |
|---|---|---|
| Q2_0(压缩最狠) | 94 tok/s | 60 tok/s |
| IQ2_XS | 79 tok/s | 52 tok/s |
| IQ3_XXS | 62 tok/s | - |
| IQ3_S(质量最好) | 53 tok/s | - |
| Coder(写代码专用) | 55 tok/s | 44 tok/s |
提醒一句,Q2_0 是压缩最狠的版本,跑得快,聪明程度打折也最多。表里那个 94 看看就好,不要当真,只有质量和速度得放在一起才有实际意义。不然就像那个小品了,回答贼快,但都是错的!
官方数据之外,社区里的实测也不少。
开头说的那个 HN 发帖人,就是 4090 加 128G 内存跑出来的 124 tok/s。那个帖子的评论区里还有个人,显卡是 8G 显存的 RTX 2060,够老了吧,跑 Q2_0 也有 33 tok/s。
Reddit 上有个用笔记本的老哥,RTX 5070 Ti 移动版 12G 显存加 64G 内存,43K 上下文跑到 51 tok/s,同样的模型他用原版 llama.cpp 只有 23。
微博上也有人拿 RTX 3090 跑 IQ3_S,短问答 67 tok/s,同样的硬件 llama.cpp 只有 20 左右。
这些数字受 CPU、内存、量化版本影响很大,不能当成统一成绩看。不过大方向差不多:同一个模型,Strata 比通用方案快不少。
硬件要求
| 项目 | 要求 |
|---|---|
| 显卡 | NVIDIA RTX 20/30/40/50 系,或 AMD RX 7900 XT/XTX、7800 XT、9070 系、RX 6800/6900 系等,显存 12G 起步 |
| 内存 | 32G 起步,64G 能跑所有版本 |
| 硬盘 | 留 80G 空间,最好用 SSD,首次加载快很多 |
| 系统 | Windows 10/11 或 Linux,显卡驱动要新 |
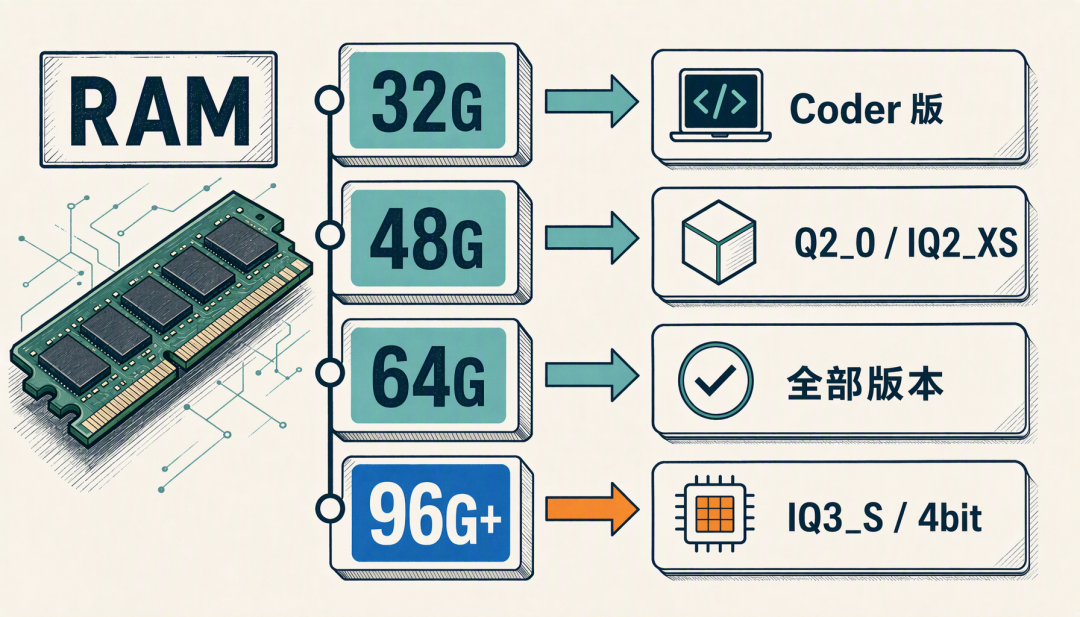
装之前有几点要先知道,你能装哪个版本是内存决定的:32G 内存基本只能跑 Coder 版,显卡显存有 24G 的话 Q2_0 和 IQ2_XS 也能跑;48G 能跑 Q2_0 和 IQ2_XS;64G 就全都能跑了。
老显卡像 Tesla P40、GTX 10 系这些,社区里有实验性的支持,Intel Arc 在 Linux 上也有人从源码编译跑通过,不过这些都算折腾区,新手别碰。
另外头一回启动会有个状况:机器会卡个 1 到 3 分钟,因为它要往内存里灌 35 到 55G 的东西,还要锁一部分给显卡用。这是正常的,等着就行,千万别以为死机了把窗口关了。
模型版本怎么选
安装器会根据你的内存推荐一个,一般听它的就行。
自己选的话参考这个:
- • 32G 内存: Coder 版。这个版本专为写代码砍了一半专家,代码能力保留了完整模型的 91%,这是 SWE-bench Verified 的成绩,模型作者自己测的。代价是代码以外的能力弱了,中文尤其明显,社区里专门有人反馈过这个事。
- • 48G 内存: IQ2_XS,或者 Q2_0,Q2_0 更快一些。
- • 64G 内存: 推荐 IQ2_XS。想要质量更好就 IQ3_S,它质量最好,也最慢。
- • 96G 以上: IQ3_S,或者 Unsloth 的 4bit 版本。
如果你主要用来中文聊天,就老老实实选保留全部专家的那几个,Q2_0、IQ2_XS、IQ3_S 都行,别碰 Coder。
安装
安装有两种方式,都挺简单。
一种是让 AI 帮你装。你在用 Claude Code、Cursor、Codex 这类工具的话,直接把仓库地址丢给它,让它去读仓库里的 AI_SETUP.md。它会自己检查你的显卡、内存、硬盘,挑个合适的版本装好,完事还会告诉你怎么把工具接上。
另一种是自己手动来。把仓库下载下来解压,或者直接 git clone。Windows 双击里面的 START-HERE.bat,Linux 在文件夹里跑 ./setup.sh。过程中它会问你几个问题,选哪个模型、上下文留多长、要不要读图,不想动脑子就一路回车,全是推荐值。问完它就开始下载模型,大概 70G,耐心等。下载万一断了也不用慌,重跑一次会接着上次的地方继续下。装完浏览器会自动打开 127.0.0.1:8080。
以后每次要用,跑一遍 START-HERE.bat 就启动了,不会重复下载什么东西。
用起来是什么样
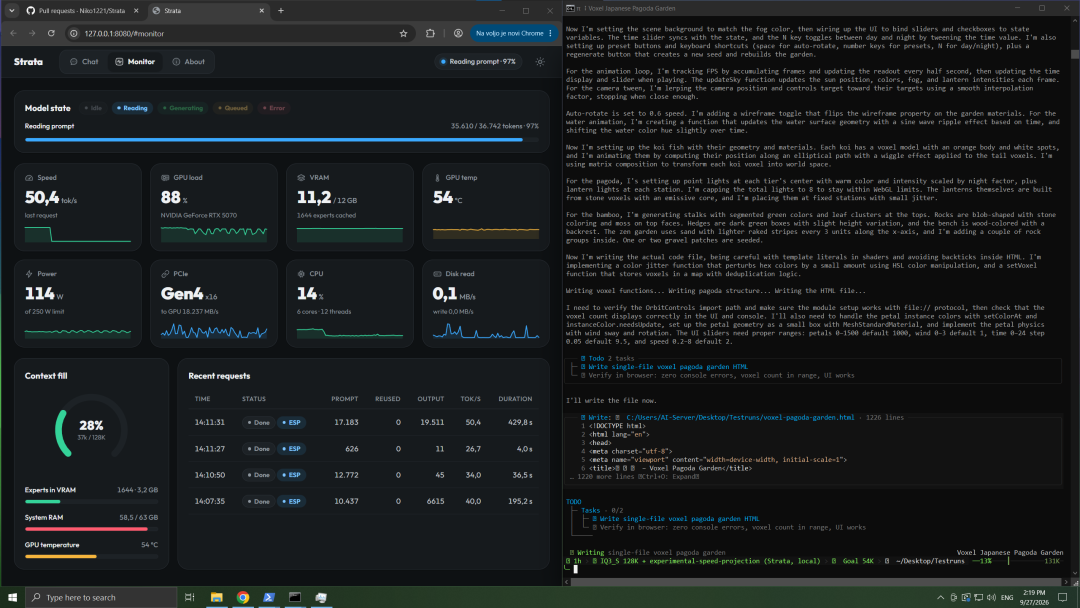
最简单的用法就是浏览器里直接聊,打开 8080 端口是个完整的应用,有聊天窗口,还有一个实时监控页,GPU 占用、显存、内存、每秒出词速度都有曲线在跑,挺适合盯着看的。下面这张图左边就是监控页,右边是一个编程智能体在干活。
想接现有工具的话,base URL 填 http://127.0.0.1:8080/v1,API key 随便填一个。Claude Code 的话设个环境变量 ANTHROPIC_BASE_URL 指向它就行,Codex CLI 走 /v1/responses。原来连云端模型的那些编程工具,把地址改成这个本地的就能用了。
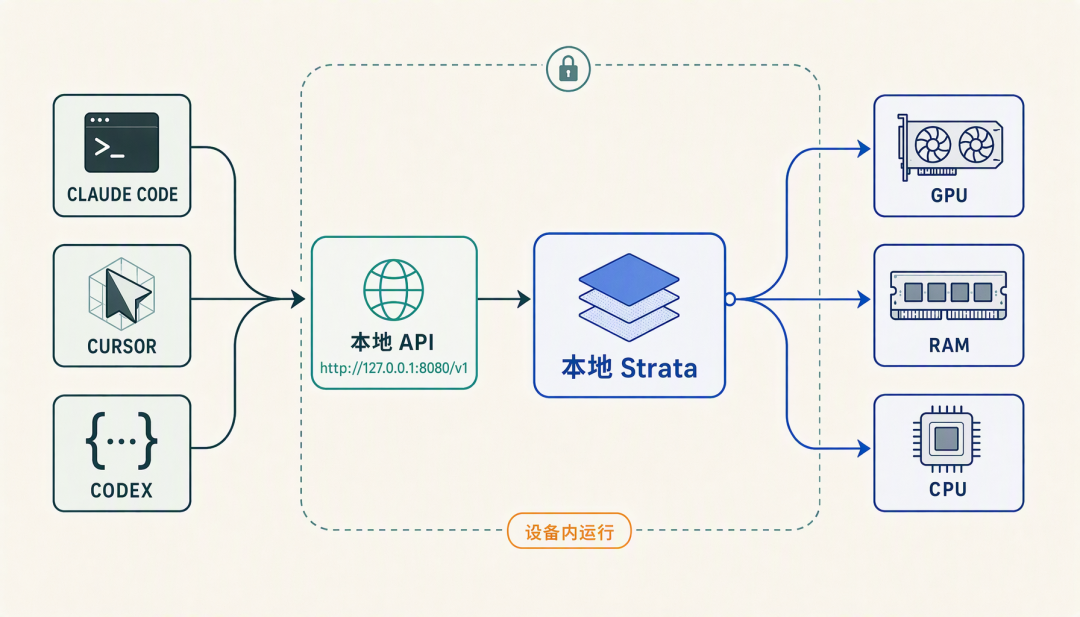
还有一点,它默认一次只处理一个请求,多出来的排队。想让两个请求同时跑可以改配置开并行,不过 12G 显存的卡上每个请求都会变慢,自己权衡。
最后
以前本地跑大模型,一分钟出不了一个字,这个阶段现在算是被这类项目翻过去了。一张游戏卡再加 64G 内存,不少人还是有这个配置的,跑出来的速度拿来日常用也够。
当然问题也有:默认只能单请求,多人同时用就得排队;CPU 和内存对速度影响很大,同一张显卡换台机器,速度可能差出好几倍。
项目建库才十来天,作者更新很勤,issue 区也挺活跃,后面应该还会继续快。机器够的话,可以装一个试试。