
Dust:无需反向传播预训练 Transformer
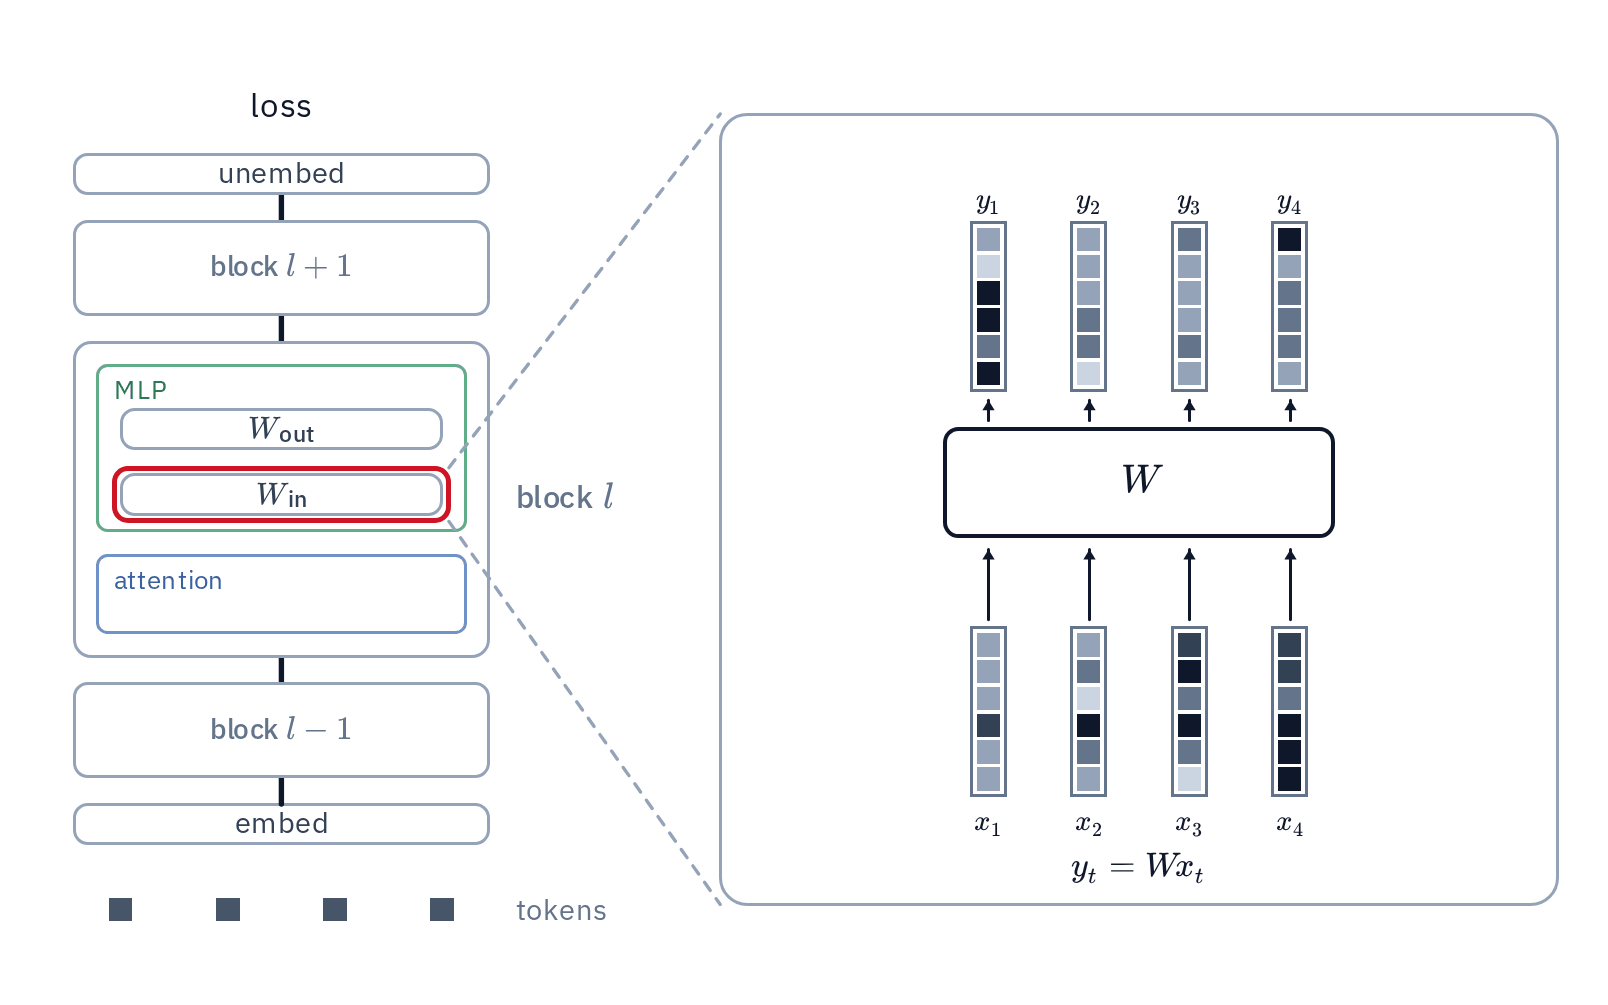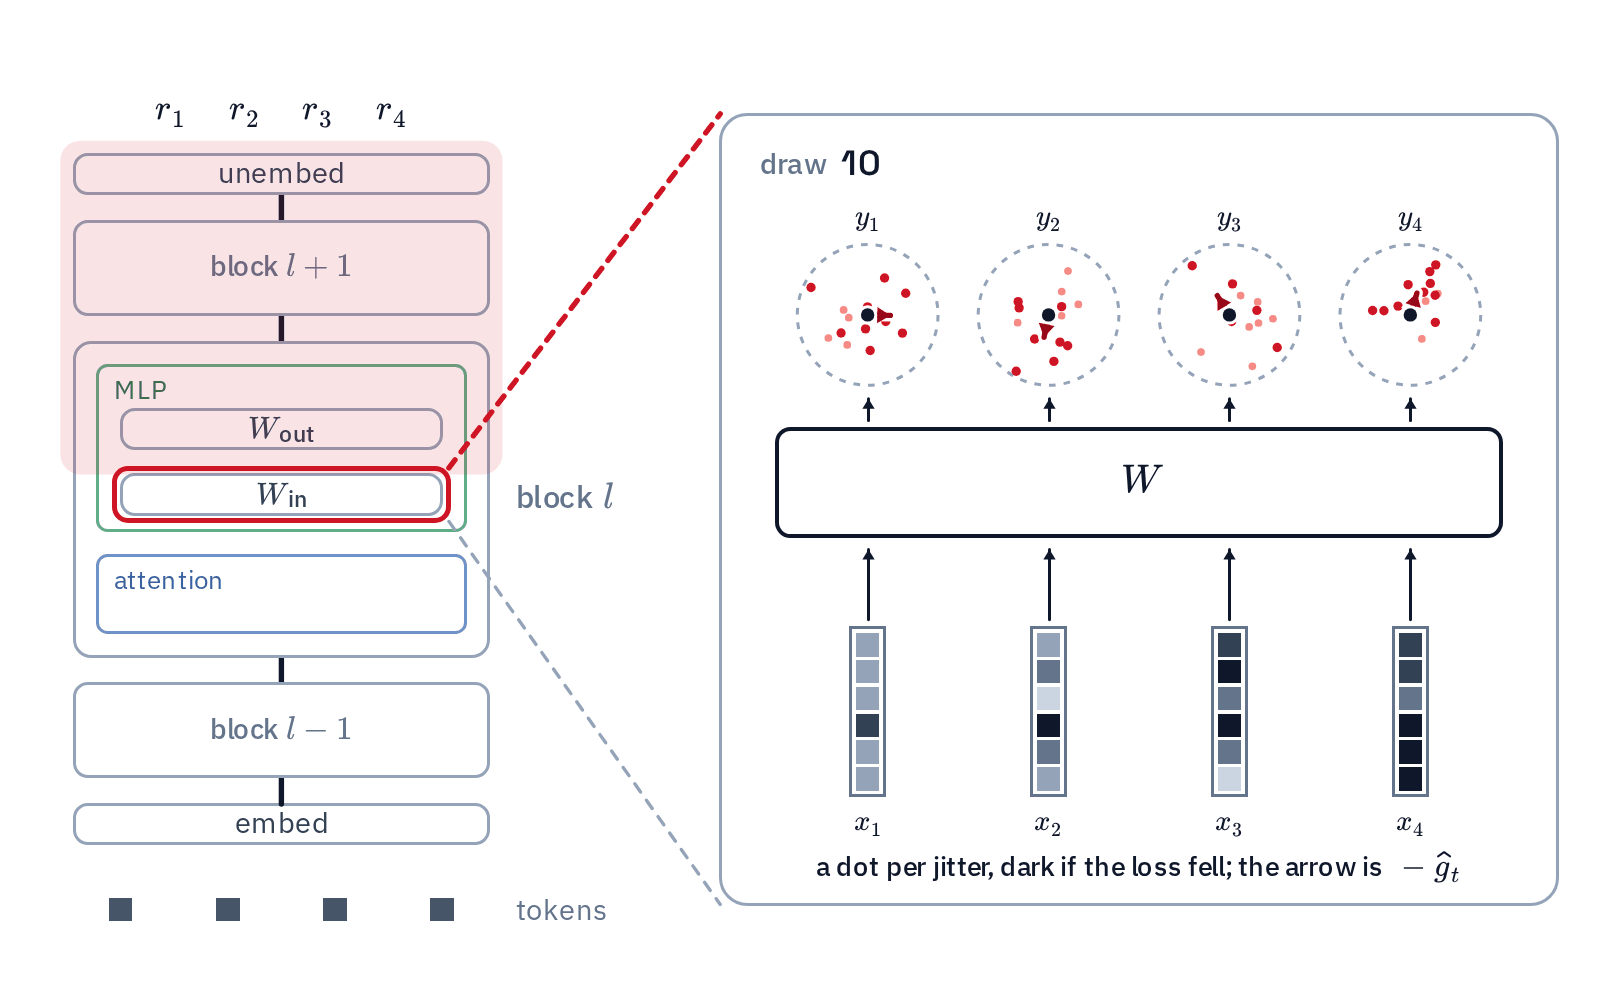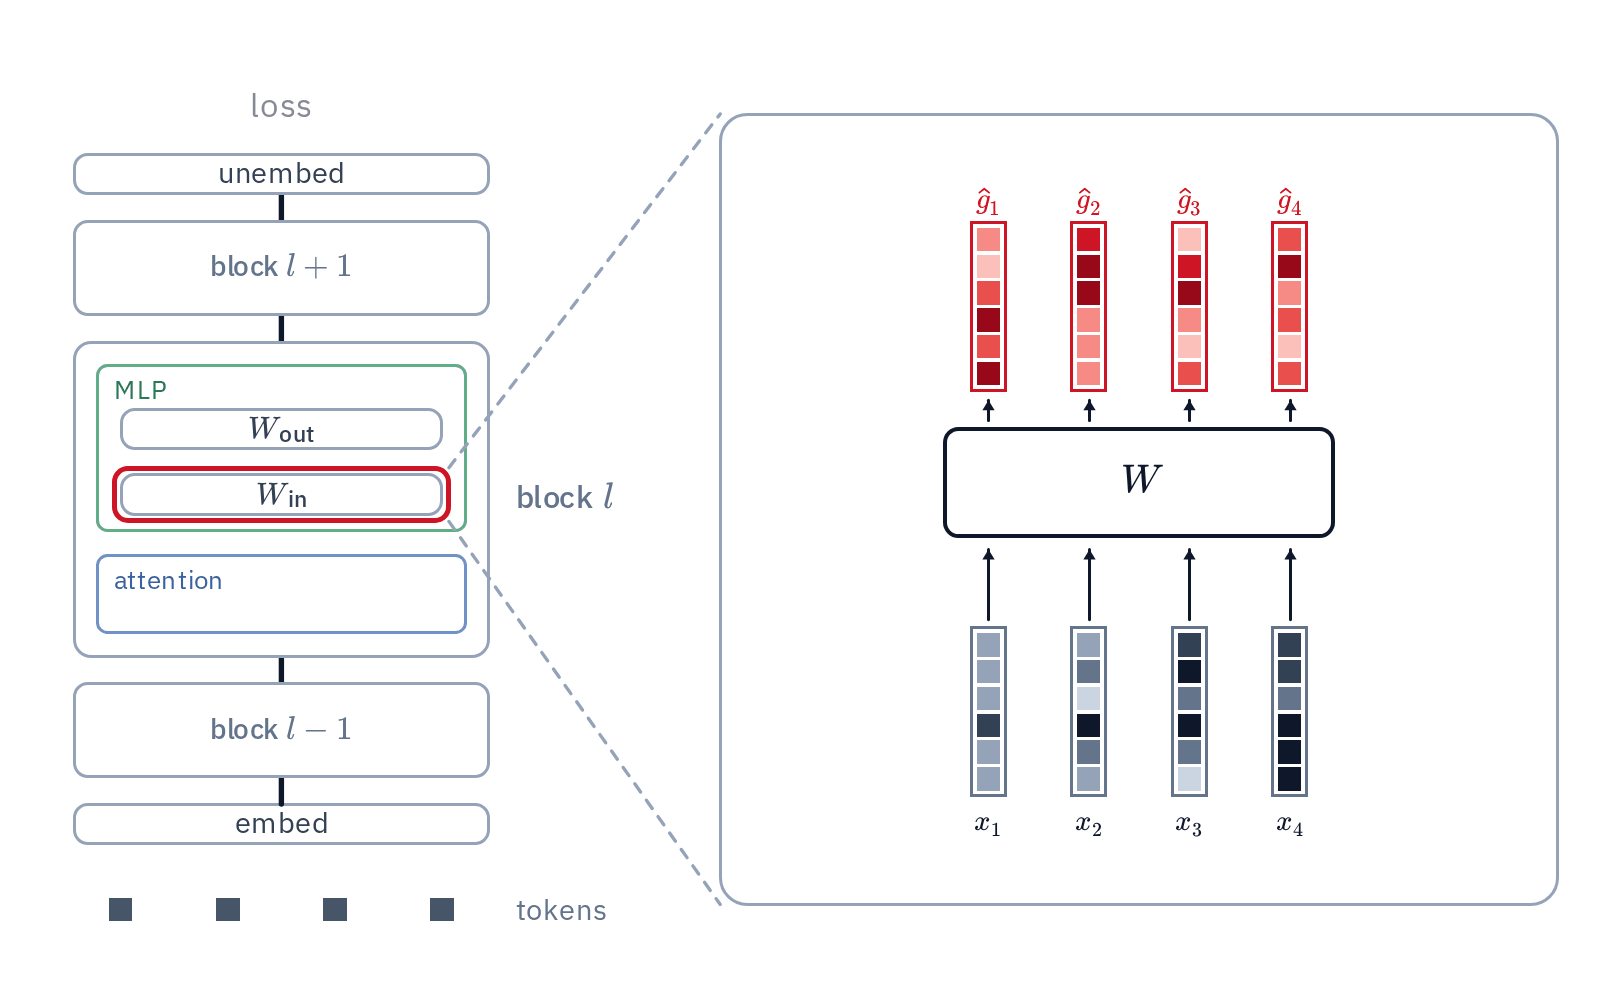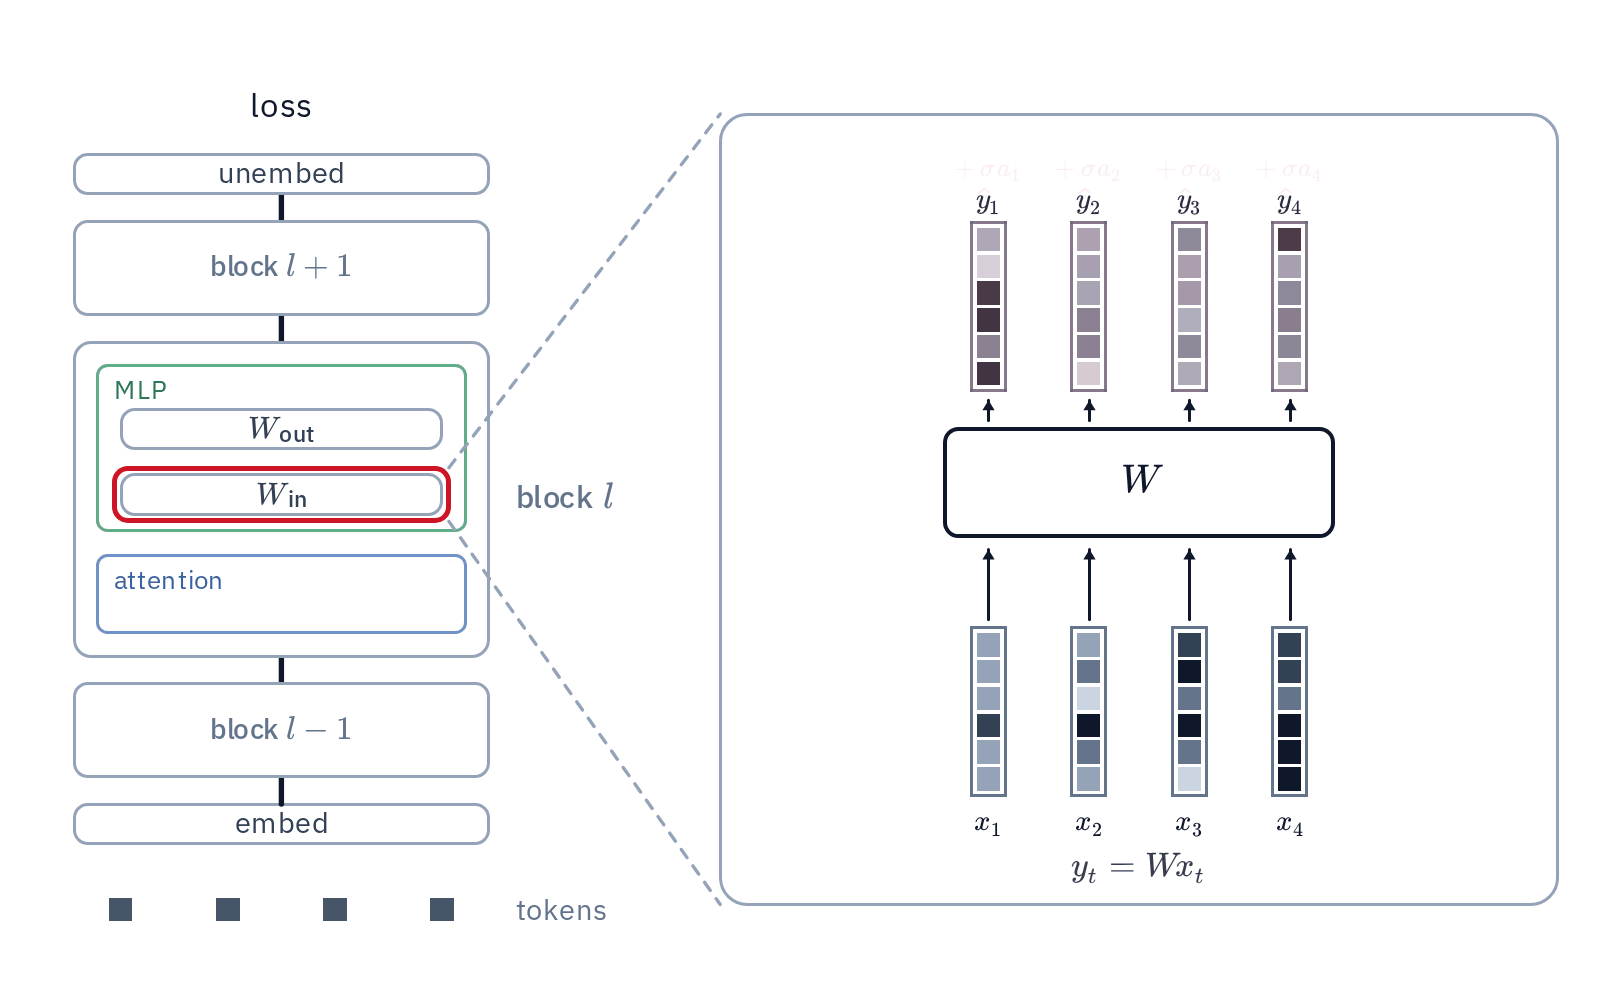
- 我们提出了首个能与 backprop 在预训练 Transformer 语言模型上相抗衡的零阶方法。Dust 对每个 token 的激活值独立施加扰动(node perturbation),因此每个 token 都是一个种群成员,一次前向传播即可并行评估整个种群。
- 在大种群(即算力大幅增加)的情况下,Dust 能紧密逼近 backprop,并且在多种设置下甚至超越它。这暗示在算力充裕的场景中,我们或许能够超越 backprop。
- Dust 比权重空间的 ES(进化策略)高效多个数量级。根据我们的外推,从 100 万 token 起,Dust 的效率比最先进的 ES 方法 EGGROLL 的 Transformer 实现高出约 $10^3$ 到 $10^4$ 倍。
- 人们普遍认为零阶方法无法扩展到大网络。令人惊讶的是,我们发现模型越大种群效率反而越高:一个 2.43 亿参数的模型在大多数种群规模下都优于比它小 $120\times$ 的模型。
- 随着种群规模增大,Dust 的梯度估计与 backprop 越来越一致,且在我们测试的每个规模(直到 10 亿 token)上都保持高度一致,这对可扩展性来说是个好兆头。
深度学习一直建立在 backprop 之上——它是唯一能够训练现代神经网络(包括基于 Transformer 的语言模型)的信用分配算法。Backprop 要求模型可微,并且只能产生一阶梯度,而深度学习的架构、优化器和硬件正是围绕这一约束共同演化而来的。
然而,随着全球可用算力的不断攀升,我们或许会更倾向于使用基于搜索的通用、蛮力学习算法,而非可微性、反向传播及高阶梯度近似等归纳偏置。“苦涩的教训”(The Bitter Lesson)(Sutton, 2019Richard S. Sutton. The bitter lesson. http://www.incompleteideas.net/IncIdeas/BitterLesson.html, 2019. Blog post.)指出,能够随算力扩展的通用方法最终会胜出,AlphaGo Zero(Silver et al., 2017David Silver, Julian Schrittwieser, Karen Simonyan, Ioannis Antonoglou, Aja Huang, Arthur Guez, Thomas Hubert, Lucas Baker, Matthew Lai, Adrian Bolton, Yutian Chen, Timothy Lillicrap, Fan Hui, Laurent Sifre, George van den Driessche, Thore Graepel, and Demis Hassabis. Mastering the game of Go without human knowledge. Nature, 550 (7676): 354–359, 2017. doi: 10.1038/nature24270.)便是明证。虽然利用人类数据引导 AlphaGo 起初能帮网络学得更快,但在足量的计算资源下,纯自我对弈的网络最终超越了前者。同理,可微性与反向传播在低算力阶段是良好的归纳偏置,能提升学习效率;但在高算力阶段,它们反而限制了可行架构的空间。即便在同一架构内,基于梯度的方法也无法在损失景观上进行最优探索(Liu et al., 2020Shengchao Liu, Dimitris Papailiopoulos, and Dimitris Achlioptas. Bad global minima exist and SGD can reach them. In Advances in Neural Information Processing Systems, volume 33, 2020.)。这也可能解释了为何当前的神经网络需要海量数据才能实现泛化。一种基于搜索、更具灵活性的信用分配算法,可能是迈向更好泛化能力的重要一步。
本文旨在用一种更依赖暴力计算、更少依赖解析结构的学习算法来取代反向传播。我们将其命名为 Dust。Dust 是一种零阶优化算法,它通过扰动激活值,根据每个扰动降低损失的程度给予奖励,并取群体中奖励加权扰动的平均值来估计梯度。传统通过扰动权重来进化的进化策略方法(如 Salimans et al., 2017;EGGROLL,Sarkar et al., 2025)虽然具备可扩展性,但群体规模的扩大成本高昂,因为必须实例化并评估每个成员。我们通过引入“虚拟群体”的概念消除了这两项成本:完全绕过权重空间,转而扰动激活值(类似于节点扰动,Werfel et al., 2003;Widrow and Lehr, 1990),从而避免了实例化每个成员。这一过程在每个 token 上独立进行,因此每个 token 都相当于一个群体成员,一次前向传播即可并行评估所有成员。
相比权重,激活值是更有意思的搜索空间。机制可解释性研究表明,无论推理能否被语言化描述,它都存在于激活值中(Gurnee et al., 2026Wes Gurnee, Nicholas Sofroniew, Adam Pearce, Mateusz Piotrowski, Isaac Kauvar, Runjin Chen, Anna Soligo, Paul Bogdan, Euan Ong, Rowan Wang, Ben Thompson, David Abrahams, Subhash Kantamneni, Emmanuel Ameisen, Joshua Batson, and Jack Lindsey. Verbalizable representations form a global workspace in language models. arXiv preprint arXiv:2607.15495, 2026.;Lindsey et al., 2025Jack Lindsey, Wes Gurnee, Emmanuel Ameisen, Brian Chen, Adam Pearce, Nicholas L. Turner, Craig Citro, et al. On the biology of a large language model. Transformer Circuits Thread, 2025.),这意味着我们的方法可以把训练转化为对潜在推理的搜索(Vegesna and Dahal, 2025Akshay Vegesna and Samip Dahal. Decoupling search and learning in neural net training. arXiv preprint arXiv:2509.10973, 2025.)。接着,我们把激活空间的扰动与一条非常通用的信用分配规则结合,为 transformer block 中不同类型的层分配不同的 token 级奖励。这两个偏向性设计,加上一些实现细节和效率优化(比如避免被扰动模块之间的相互干扰),就构成了完整的算法。
我们的主要贡献如下:
- 我们提出了首个在预训练 transformer 语言模型上能与 backprop 竞争的零阶方法。在大规模种群下,Dust 在多种设置中都超过了 backprop,这表明在算力充足的条件下我们或许能实现超越。
- Dust 比权重空间的 ES 高效几个数量级。根据我们的外推,从 1M tokens 起,Dust 的效率比 transformer 版的 EGGROLL 实现高约 $10^3$ 到 $10^4$ 倍。
- 与传统认知相反,更大的模型往往不是更不擅长利用种群,反而更具种群效率,还能利用更大的种群。这为过参数化提供了一个新视角:它是一个几何性质可能更优的更大搜索空间。
- 随着种群规模增大,Dust 的梯度估计与 backprop 越来越一致,且在我们测试的所有规模(最高 1B tokens)上都保持一致,这对扩展性而言是个好兆头。
本文旨在为一种基于搜索的信用分配算法奠定基础,使其在极其困难的预训练 Transformer 任务上能与反向传播(backprop)相竞争。我们并未试图将其优化到足以在今天取代反向传播的计算效率,也没有训练该算法启用的新型神经网络,例如包含外部程序回路的网络,或反向传播难以训练的多步循环 Transformer。这些都留待未来工作解决。
2 方法
Dust 的工作流程如下。我们在每个线性层的输出上独立地加入高斯噪声(针对每个 token),执行前向传播,并根据该 token 处的损失变化来给每个 token 的噪声赋予奖励。奖励加权后的噪声在多次采样中的平均值,即为该层输出处的估计误差;而该误差与层输入的矩阵外积,便是权重的梯度。Attention 内部机制则采用其变体:不直接依据 token 的损失进行归因,而是通过 Attention 输出在所有当前及未来 token 上的估计误差来归因。核心直觉在于:权重空间的进化策略(ES)每次前向传播只能评估一个种群成员,而我们每次前向传播可并行评估每个 token 对应成员——即通过在隐状态上添加噪声来实例化成员,这一过程成本极低。因此,在现代 Transformer 中,单次前向传播所评估的种群规模至少比权重空间的 ES 大三个数量级。下文将详细阐述各组件。
2.1 激活空间扰动
进化策略的瓶颈在于种群规模:每个成员都需要一份独立扰动的权重副本及单独的前向传播。EGGROLL(Sarkar et al., 2025Bidipta Sarkar, Mattie Fellows, Juan Agustin Duque, Alistair Letcher, Antonio León Villares, Anya Sims, Clarisse Wibault, Dmitry Samsonov, Dylan Cope, Jarek Liesen, Kang Li, Lukas Seier, Theo Wolf, Uljad Berdica, Valentin Mohl, Alexander David Goldie, Aaron Courville, Karin Sevegnani, Shimon Whiteson, and Jakob Nicolaus Foerster. Evolution strategies at the hyperscale. arXiv preprint arXiv:2511.16652, 2025.)通过低秩扰动降低副本开销,但每个成员仍占批量中的一个序列元素,因此种群规模受制于可承受的前向传播次数。我们改为对激活进行扰动,在每个 token 处独立操作:在该位置,网络的行为等同于对产生该激活的层权重施加了低秩扰动,而扰动本身从不实际写入权重。我们称此为虚拟种群。Transformer 的序列通常含数千个 token,因此一次前向传播即可评估每个序列数千个“成员”,而非仅仅一个。模型中所有参数均采用此方式训练,唯独 $2L$ 个残差混合标量除外,它们通过常规权重空间的进化策略训练。
在激活值而非权重上加噪声,这种方法叫做节点扰动(node perturbation,Widrow and Lehr, 1990Bernard Widrow and Michael A. Lehr. 30 years of adaptive neural networks: Perceptron, Madaline, and backpropagation. Proceedings of the IEEE, 78 (9): 1415–1442, 1990. doi: 10.1109/5.58323.),支持它的常见理由是维度:一层输出的维度是 $d_{\mathrm{out}}$,而权重的维度是 $d_{\mathrm{out}} \times d_{\mathrm{in}}$,所以激活噪声所在的空间要小得多。但朴素地看,这个维度论证对激活值横跨多个 token 的 transformer 并不成立:一条序列上的噪声是 $T \times d_{\mathrm{out}}$ 的张量,一旦 $T \ge d_{\mathrm{in}}$,其元素数量就不小于权重矩阵了。不过,采用逐 token 独立的扰动和奖励后,扰动激活值带来的是一个沿 token 轴分布的新种群,它与 EGGROLL 已经依赖的 batch 轴是正交的,因此非常高效。
2.2 信用分配
对线性层 $y_t = W x_t$,我们在所有 token 上抖动其输出:$y_t \to y_t + \sigma a_t$,其中 $a_t \sim \mathcal{N}(0, I)$,$\sigma$ 为噪声强度,然后执行前向传播。在每个 token $s$ 处计算中心化的损失下降量 $c_s = \tilde{\ell}_s - \ell_s$,其中 $\ell_s$ 是扰动后的损失,$\tilde{\ell}_s$ 是在同一批次前向中一起评估的多次采样下,该 token 扰动损失的平均值。token $t$ 处抖动的奖励就是 $t$ 处的损失下降量,再乘以衰减因子 $\gamma$,加上其后各个 token 的损失下降量——这些 token 通过注意力机制也能被该抖动影响到,
$$r_t = \sum_{s \ge t} \gamma^{\,s-t} c_s .$$(1)当 $\gamma = 0$ 时,抖动仅由其自身的 token 获得奖励。我们将决定哪些层能看到未来 token 的工作留给第 2.3 节的调优部分。对所有 token 进行一次独立抖动称为一次 采样,而总体则指 $K$ 次采样。在多次采样上取平均后,奖励加权的噪声
$$\hat g_t = -\frac{1}{K\sigma}\sum_{i=1}^{K} r_t^{(i)} a_t^{(i)}$$(2)估计的是该层输出的误差,将其与该层输入(已在正向传播中计算)的外积,并对所有 token 求和,即可得到权重梯度:
$$\widehat{G}_W = \sum_t \hat g_t\, x_t^\top .$$(3)反向传播形成相同的外积,使用相同的输入。唯一的区别在于:反向传播通过链式法则获取输出误差,而我们是从总体中获取的。对于嵌入层,$x_t$ 是独热向量,因此外积相当于将 $\hat g_t$ 累加到该 token 对应的行中。
如果总体无限大,上述估计器就是完整的方法,且每次扰动都可以整合到一次正向传播中。每次采样的奖励加权噪声等于梯度加上一个无优先方向的误差。随着采样次数增加,梯度线性累加,而误差按平方根增长,因此两者的比值随着总体增大而下降,干扰在极限情况下消失。
2.3 干扰与调优
对于我们能承受的总体规模,主要成本是干扰,即在同一次正向传播中对许多层的许多 token 进行抖动,因此奖励某个 token 噪声的损失变化也会捕获该传播中所有其他扰动的影响。我们通过三种方式减少此类干扰。首先,不同类型的层在不同的正向传播中抖动,每个类型使用自己的噪声尺度,每个模块也有独立的传播。由于干净的正向传播被缓存,且对模块 $l$ 的采样仅重新运行从 $l$ 开始的后续模块,这些传播比完整正向传播成本更低。其次,注意力内部结构(查询、键、值、门控、值嵌入)是分开抖动的。由于 token 损失几乎不感知这些抖动,因此通过注意力输出进行奖励,具体如下所述。第三,语言建模头部直接在缓存的 logits 上抖动,仅重新计算交叉熵,且每次采样仅处理词汇表的一小部分,其成本仅为一次正向传播的极小比例,使头部能够运行更大规模的整体。
对于注意力模块的内部参数,我们从缓存的干净激活值出发,仅针对其所在 Block 的注意力输出应用抖动并重新计算。随后,根据这些抖动与估计的注意力输出梯度之间的对齐程度来评估各候选方案,得分为:
$$c_s = -\langle \hat g_s, \Delta o_s \rangle ,$$其中 $\Delta o_s$ 表示抖动在 Token $s$ 处引起的注意力输出变化,$\hat g_s$ 是该输出的估计误差,即公式 2 所示。最终采用的奖励机制基于公式 1,但按 Head 计算并使用上述得分替代原本用于统计的 Loss 指标。
超参数(包括各层类型的噪声幅度、注意力内部参数的信用衰减率以及每层在总体中获得的份额)可通过两种方式进行调优。第一种是网格搜索:对每组设置使用少量 Token 预算进行训练,保留能最大程度降低 Loss 的设置。该方法可靠但成本较高。第二种是网格搜索:在单个 Batch 上最大化我们的梯度估计与反向传播梯度之间的余弦值,此过程无需训练。单个 Batch 上余弦值更大并不总能确保训练后 Loss 降低,因此余弦值用于筛选候选项,最终由训练结果决定。总体而言,这种调优大多是一次性成本,因为找到的设置在不同 Token 预算和总体大小下通常能良好泛化,但有一个例外。当总体大小达到 10M 和 20M Token 的最高规格时,更慢的信用衰减率以及将抽取权重向注意力侧偏移仍能带来收益(附录 F)。由此可见,该搜索过程恢复的是方法的通用原则,而非针对特定运行的一次性设置。与预期一致,除 Keys、Values、Gates 和 Value Embeddings 外,所有层均不需要来自未来 Token 的信用。因为这些参数会被关注它们的后续 Token 读取,其对应的 $\gamma$ 值接近于 1。
3 无反向传播的预训练
3.1 环境设置
我们在 FineWeb 上训练 GPT 风格的 Transformer,使用 4096-token 的 BPE 分词器、16k token 的批次(8 条 2048 token 的序列)、单轮训练,以及恒定学习率的带动量 SGD。基础模型有 8 层、宽度 512。所有方法遵循完全相同的实验协议,每个单元格跑三个随机种子,并在每个 token 预算和种群规模下分别调参。Dust 与反向传播共享同一组动量与学习率网格;我们用相同的 Transformer 架构实现了 EGGROLL(称为 EGGROLL-Transformer),并针对其自身的步长、动量、噪声尺度和适应度塑形网格进行调参。验证集和测试集各含 544 条留出序列。我们报告验证集最优 checkpoint 对应的测试损失。
种群规模的计数方式:Dust 按 draws 计数,EGGROLL(我们的权重空间基线,Sarkar et al., 2025Bidipta Sarkar, Mattie Fellows, Juan Agustin Duque, Alistair Letcher, Antonio León Villares, Anya Sims, Clarisse Wibault, Dmitry Samsonov, Dylan Cope, Jarek Liesen, Kang Li, Lukas Seier, Theo Wolf, Uljad Berdica, Valentin Mohl, Alexander David Goldie, Aaron Courville, Karin Sevegnani, Shimon Whiteson, and Jakob Nicolaus Foerster. Evolution strategies at the hyperscale. arXiv preprint arXiv:2511.16652, 2025.)按批次的 forward pass 次数计数。一次 draw 是对所选层全部 token 的激活做一次扰动,并以 token 损失作为回报,种群规模 $K$ 即每次更新所含的 draw 数。一次 draw 比一次 forward pass 略便宜,因为干净的前向结果已被缓存,扰动第 $l$ 层的 draw 只需重跑第 $l$ 层及之后的模块。$K$ 未计入 head 和注意力内部的 draws,它们只占每次更新 FLOPs 的一小部分(附录 E)。综合来看,当种群规模达到 256 及以上时,Dust 在相同种群规模下的计算量低于 EGGROLL,因此这种对比对 EGGROLL 是宽松的。
3.2 主要结果
我们在 64 到 16k 的种群规模下,将 token 预算从 100k 扫描至 20M,并在同一网格的每个预算点上对反向传播进行调优(表 1,图 2)。在 100k 和 1M token 时,Dust 的表现优于反向传播:前者从数百次采样开始,后者则从一千次开始。当 token 数达到 10M 和 20M 时,Dust 与反向传播的差距随种群扩大而缩小。在 10M 时,梯级曲线趋于平坦,其拟合极限值略高于反向传播。在 20M 时,梯级曲线在 16k 次采样时仍在下降。其幂律拟合将极限值定为 4.431(95% 区间 3.89 至 4.58),低于反向传播的 4.633,但由于梯级曲线仍在下降,拟合约束较松,因此我们将此解读为差距随种群扩大而持续缩小的证据,而非已测量的极限值。
权重空间进化搜索的效率低得多。即便种群规模扩大到 256 倍,EGGROLL 在 1.6 万(16k)的种群下仍未达到 Dust 在 64 次采样下的表现。在 10 万(100k)词元时,两者差距缩小至 0.02;而在 100 万(1M)、1000 万(10M)和 2000 万(20M)词元时,EGGROLL 的损失值始终高出 0.4 到 0.6(图 2)。EGGROLL 的性能阶梯在 1.6 万处仍呈陡峭下降趋势,意味着扩大种群规模能带来进一步提升,但若要匹配 Dust 最小种群的表现,所需种群规模约为后者的数千倍甚至 $10^4$ 倍(附录 D)。图 1 还展示了训练过程中的差距:在 1000 和 1.6 万次采样时,Dust 全程紧随反向传播曲线,而所有 EGGROLL 曲线早期便落后,且始终高于 Dust 在 64 次采样时的表现。
3.3 Adam 优化器下的 Dust
尽管本文后续主要关注 SGD,我们仍在所有三种方法上复现了 Adam 优化器下的 100 万词元阶梯实验(图 3),并对反向传播的学习率、Dust 自身的超参数以及 EGGROLL 的步长、动量和适应度整形在每个种群规模下进行重新调优。有趣的是,Adam 对 EGGROLL 几乎没有提升,其调优后的 Adam 阶梯在表 1 中所有种群规模下的表现均与 SGD 阶梯相差不足 0.01。然而,Adam 改善了 Dust 和反向传播的效果,且阶梯的整体形状与之前相似。在大规模种群下,Dust 逼近反向传播的表现,且其极限值的置信区间位于反向传播之下(图 3)。因此,尽管现代优化器是为反向传播梯度设计的,但 Dust 的估计方法已能与现代优化器良好配合。我们推测优化器与 Dust 的协同进化可能带来进一步收益,将此留作未来工作。
4 高维空间搜索
4.1 过参数化
| 种群规模 | 参数量 | 不同规模对比 | |||
|---|---|---|---|---|---|
| 2.0M | 7.3M | 38M | 243M | ||
| 64 | 5.705 | 5.556 | 5.558 | 5.719 | |
| 256 | 5.486 | 5.362 | 5.358 | 5.419 | |
| 1k | 5.265 | 5.161 | 5.158 | 5.214 | |
| 4k | 5.189 | 5.095 | 5.053 | 5.124 | |
| 16k | 5.171 | 5.065 | 5.036 | 5.086 | |
| Backprop | 5.180 | 5.066 | 5.015 | 5.048 |
传统观点认为,零阶方法无法训练大型网络(Lillicrap 等人, 2020Timothy P. Lillicrap, Adam Santoro, Luke Marris, Colin J. Akerman, and Geoffrey Hinton. Backpropagation and the brain. Nature Reviews Neuroscience, 21 (6): 335–346, 2020. doi: 10.1038/s41583-020-0277-3.; Nesterov 和 Spokoiny, 2017Yurii Nesterov and Vladimir Spokoiny. Random gradient-free minimization of convex functions. Foundations of Computational Mathematics, 17 (2): 527–566, 2017. doi: 10.1007/s10208-015-9296-2.; Werfel 等人, 2003Justin Werfel, Xiaohui Xie, and H. Sebastian Seung. Learning curves for stochastic gradient descent in linear feedforward networks. In Advances in Neural Information Processing Systems, volume 16, 2003.)。前向传播仅返回一个标量,导致梯度估计的方差随扰动维度数量增加而增大,进而使得实现有效更新所需的 population 规模也随之膨胀(Nesterov 和 Spokoiny, 2017Yurii Nesterov and Vladimir Spokoiny. Random gradient-free minimization of convex functions. Foundations of Computational Mathematics, 17 (2): 527–566, 2017. doi: 10.1007/s10208-015-9296-2.; Werfel 等人, 2003Justin Werfel, Xiaohui Xie, and H. Sebastian Seung. Learning curves for stochastic gradient descent in linear feedforward networks. In Advances in Neural Information Processing Systems, volume 16, 2003.)。我们直接对此进行了验证:在固定的 10M token 预算下,训练了四种规模的模型,参数量分别为 2M、7M、38M 和 243M(跨度达 $120\times$),并随着 population 扫描绘制了损失曲线(图 4;调整细节见附录 F)。我们观察到两个引人注目的现象,它们对传统认知提出了挑战。
- 更大的模型往往在 population 利用上更高效,而非更低效。 在从 256 开始的所有 population 规模下,随着参数量从 2M 增至 7M 再增至 38M,损失持续下降,而 243M 模型的表现仅略逊一筹。即便在我们测试的最小 population 规模下,参数量大 $120\times$ 的模型表现也相当接近,且在所有其他 population 规模下表现更优。在一定程度上,大模型从规模扩张中获得的收益超过了因方差增加而造成的损失。然而,我们观察到,在相同 population 和模型规模下,模型与 backprop 之间的差距虽随模型规模增大而扩大,但这一现象并不显著,尤其是在大 population 规模下。
- 随着种群规模扩大,大模型持续改进,而小模型则趋于饱和。小模型的饱和出现得更早,而大模型在大种群规模下仍能持续提升。当种群超过 1k 后,38M 和 243M 模型比 2M 和 7M 模型多提升约 30%,且无论如何扩大种群,极小模型都无法具备竞争力。
因此,理解模型大小的正确方式是将它视为搜索空间的大小和几何形状。更大的模型拥有更大的搜索空间,这使其能够利用大种群;同时,其损失景观的几何条件可能更好,这也解释了为何即使在较小种群下,搜索依然更有效。
4.2 类反向传播梯度的涌现
我们在跨越两个数量级 tokens(从 10M 到 1B)的反向传播训练检查点上,测量 Dust 估计值与反向传播梯度在同一批次、各层类型及每层的余弦值,同时种群规模从每步 64 次前向传播增长至 128k 次(图 5)。在训练的每个阶段,所有层类型的余弦值均随种群规模上升,且符合一个双参数规律
$$\cos(K) = \frac{c_{\max}}{\sqrt{1 + c/K}}$$(5)对各类层的拟合 RMSE 均低于 0.06,其中 $c_{\max}$ 是上限,$c$ 是层达到 $c_{\max}/\sqrt{2}$ 时的种群规模。有效梯度自发涌现于大规模种群本身,并非内建了链式法则,只是按第 2.3 节所述对超参数做了轻量调优以最大化余弦相似度。对于 100M token 的检查点,各类层平均余弦相似度的拟合 RMSE 为 $0.0032$–$0.0367$(详见附录 G)。Dust 的梯度在余弦相似度上接近 backprop,但接近程度因层类型和层深度而异。用相同方式、相同前向传播次数测得的 EGGROLL 估计值虽随种群增长而上升,但在 128k 规模下除 head 外所有层的余弦相似度仍低于 0.05,这或许能解释为什么第 3.2 节中基于它的训练毫无进展。
重要的是,随着 token 数量增长,余弦相似度在大多数层上保持稳定,这对扩展性来说是个好迹象。第 3 节显示,追平并超越 backprop 所需的种群规模随 token 数增长。但在大规模种群下,余弦相似度在两个数量级的 token 范围内保持平稳,这意味着当种群足够大时,这一要求可能不再随 token 增多而增长。此外,Dust 的梯度接近 backprop 却并不完全收敛于它,这其实是个优点:估计值指向类似方向却不是 backprop 的梯度,因而产生不同的优化轨迹,而在我们的实验中,这条轨迹甚至可能优于 backprop(第 3.2 节)。
5 结论
自 Rumelhart 等人(1986)David E. Rumelhart, Geoffrey E. Hinton, and Ronald J. Williams. Learning representations by back-propagating errors. Nature, 323: 533–536, 1986. 以来,反向传播一直是训练神经网络的核心算法,我们现有的架构、优化器乃至硬件设计都围绕其构建。随着计算资源的日益丰富,我们认为可能存在更优的替代方案。我们提出了 Dust 算法,它显著改进了现有的进化策略(ES),在预训练 Transformer 时能紧密逼近反向传播的效果,甚至在投入大量算力时表现超越后者。
目前仍有许多值得探讨的开放问题。首先,Dust 能否以及如何通过隐式探索损失景观来寻找比反向传播一阶梯度更优的方向,即捕捉高阶曲率从而将搜索引导至平坦区域?线索表明它或许可以,因为在大规模种群实验中,其表现有时甚至低于反向传播(注:此处原文 "below backprop" 语境下指损失值更低,即表现更好),但具体机制尚不明确。其次,由于 Dust 不要求网络具备端到端的可微性,它开辟了新的架构搜索空间,可能在反向传播已知表现不佳的领域(如通过时间反向传播训练的循环或循环计算)带来突破。第三是计算效率,这并非本文重点。在当前算力水平下,Dust 若要在实际应用中成为反向传播的替代方案,其计算效率仍需提升数个数量级。
6 相关工作
语言模型零阶预训练的早期工作(Allaire 等, 2025)探讨了使用权重扰动从头训练 Transformer 的难度。他们后来提出的 KronZO 方法(Allaire 等, 2026)利用具有 Kronecker 结构的紧凑扰动以及选择性方向更新,在降低内存占用的同时提升了预训练效果。EGGROLL(Sarkar 等, 2025)通过低秩结构,使得在 GPU 上高效运行大规模权重扰动种群成为可能。相比之下,Dust 针对激活进行搜索,并利用每个 token 的奖励,从而从每次前向传播中提取更多的信用(credit)。
在微调方面,MeZO(Malladi et al., 2023Sadhika Malladi, Tianyu Gao, Eshaan Nichani, Alex Damian, Jason D. Lee, Danqi Chen, and Sanjeev Arora. Fine-tuning language models with just forward passes. In Advances in Neural Information Processing Systems, volume 36, 2023.)表明语言模型可以仅靠前向传播进行适配,内存占用接近推理水平。Evolution Strategies at Scale(Qiu et al., 2026Xin Qiu, Yulu Gan, Conor F. Hayes, Qiyao Liang, Yinggan Xu, Roberto Dailey, Elliot Meyerson, Babak Hodjat, and Risto Miikkulainen. Evolution strategies at scale: LLM fine-tuning beyond reinforcement learning. In Proceedings of the International Conference on Machine Learning, 2026. URL https://arxiv.org/abs/2509.24372. arXiv:2509.24372.)展示了用 ES 对数十亿参数规模的语言模型进行全参数微调。Neural Thickets(Gan and Isola, 2026Yulu Gan and Phillip Isola. Neural thickets: Diverse task experts are dense around pretrained weights. arXiv preprint arXiv:2603.12228, 2026. URL https://arxiv.org/abs/2603.12228.)通过对预训练权重做随机扰动,筛选最优候选并将其预测集成,从而找到有用的任务专家。这些结果展示了围绕预训练模型进行搜索的潜力,而我们的实验则更进一步:从零开始预训练,学习表示本身。
我们的激活扰动方法建立在节点扰动(Werfel et al., 2003)的基础上。GEMINI(Le Cun et al., 1988)将噪声注入到第一个隐藏层中,并通过迭代矩阵求逆来恢复逐层的梯度估计。Zoop(Hu et al., 2025)利用输出扰动进行语言模型的微调,将估计的输出梯度转化为基于局部导数的参数更新。结合局部损失扩展前向梯度(Ren et al., 2023)将激活扰动与局部损失以及前向模式自动微分相结合,以降低估计方差。多切线前向梯度(Flügel et al., 2025)同样使用前向模式微分,通过正交投影组合多个方向导数来改善梯度估计。
另一条研究路线则用局部学习动态取代全局反向传播:Sakana AI 提出的 PC-ALM(Seely and Gould, 2026Jeffrey Seely and Julian Gould. Augmented Lagrangian predictive coding. arXiv preprint arXiv:2605.31022, 2026. URL https://arxiv.org/abs/2605.31022)通过局部预测编码动态和拉格朗日乘子进行信用分配。它利用局部导数,并在图像分类任务上进行了评估。Dust 则在 Transformer 预训练过程中通过前向扰动估算信用,将每个 token 的奖励与注意力输出的局部目标相结合。
参考文献
Nathan Allaire, Mahsa Ghazvini Nejad, Sébastien Le Digabel, and Vahid Partovi Nia. Zeroth order optimization for pretraining language models. In Proceedings of ICPRAM, pages 113–121, 2025. doi: 10.5220/0013261100003905. URL https://doi.org/10.5220/0013261100003905.
Nathan Allaire, Sébastien Le Digabel, Dominique Orban, and Vahid Partovi Nia. Zeroth-order Kronecker optimization for pretraining language models. SN Computer Science, 7, 2026. URL https://www.gerad.ca/en/papers/G-2025-44. Article 162.
Katharina Flügel, Daniel Coquelin, Marie Weiel, Charlotte Debus, Achim Streit, and Markus Götz. Beyond backpropagation: Optimization with multi-tangent forward gradients. In International Joint Conference on Neural Networks, 2025. URL https://arxiv.org/pdf/2410.17764v2.
Yulu Gan and Phillip Isola. Neural thickets: Diverse task experts are dense around pretrained weights. arXiv preprint arXiv:2603.12228, 2026. URL https://arxiv.org/abs/2603.12228.
Wes Gurnee, Nicholas Sofroniew, Adam Pearce, Mateusz Piotrowski, Isaac Kauvar, Runjin Chen, Anna Soligo, Paul Bogdan, Euan Ong, Rowan Wang, Ben Thompson, David Abrahams, Subhash Kantamneni, Emmanuel Ameisen, Joshua Batson, and Jack Lindsey. Verbalizable representations form a global workspace in language models. arXiv preprint arXiv:2607.15495, 2026.
Xixi Hu, Bo Liu, Qiang Liu, Xiaocong Du, Bhargav Bhushanam, Louis Feng, Chengyue Gong, Kaizhao Liang. Zoop it! Efficient zero-order optimization with output perturbation. 发表于 ICML Workshop on Tiny Titans: The next wave of On-Device Learning for Foundation Models,2025。URL https://openreview.net/forum?id=Tc8vFyRhPO。
Yann Le Cun, Conrad C. Galland, Geoffrey E. Hinton. GEMINI: Gradient estimation through matrix inversion after noise injection(GEMINI:通过噪声注入后的矩阵求逆进行梯度估计)。发表于 Advances in Neural Information Processing Systems,第 1 卷,第 141–148 页,1988。URL https://papers.neurips.cc/paper_files/paper/1988/file/a0a080f42e6f13b3a2df133f073095dd-Paper.pdf。
Timothy P. Lillicrap, Adam Santoro, Luke Marris, Colin J. Akerman, Geoffrey Hinton. Backpropagation and the brain(反向传播与大脑)。Nature Reviews Neuroscience,21 (6):335–346,2020。doi:10.1038/s41583-020-0277-3。
Jack Lindsey, Wes Gurnee, Emmanuel Ameisen, Brian Chen, Adam Pearce, Nicholas L. Turner, Craig Citro 等。On the biology of a large language model(论大语言模型的生物学)。Transformer Circuits Thread,2025。
Shengchao Liu, Dimitris Papailiopoulos, Dimitris Achlioptas. Bad global minima exist and SGD can reach them(糟糕的全局极小值确实存在,且 SGD 可能收敛到它们)。发表于 Advances in Neural Information Processing Systems,第 33 卷,2020。
Sadhika Malladi, Tianyu Gao, Eshaan Nichani, Alex Damian, Jason D. Lee, Danqi Chen, Sanjeev Arora. Fine-tuning language models with just forward passes(仅用前向传播微调语言模型)。发表于 Advances in Neural Information Processing Systems,第 36 卷,2023。
Yurii Nesterov, Vladimir Spokoiny. Random gradient-free minimization of convex functions(凸函数的随机无梯度最小化)。Foundations of Computational Mathematics,17 (2):527–566,2017。doi:10.1007/s10208-015-9296-2。
Xin Qiu, Yulu Gan, Conor F. Hayes, Qiyao Liang, Yinggan Xu, Roberto Dailey, Elliot Meyerson, Babak Hodjat, Risto Miikkulainen. Evolution strategies at scale: LLM fine-tuning beyond reinforcement learning(大规模进化策略:超越强化学习的 LLM 微调)。发表于 Proceedings of the International Conference on Machine Learning,2026。URL https://arxiv.org/abs/2509.24372。arXiv:2509.24372。
Mengye Ren, Simon Kornblith, Renjie Liao, and Geoffrey Hinton. Scaling forward gradient with local losses. In International Conference on Learning Representations, 2023.
David E. Rumelhart, Geoffrey E. Hinton, and Ronald J. Williams. Learning representations by back-propagating errors. Nature, 323: 533–536, 1986.
Tim Salimans, Jonathan Ho, Xi Chen, Szymon Sidor, and Ilya Sutskever. Evolution strategies as a scalable alternative to reinforcement learning. arXiv preprint arXiv:1703.03864, 2017.
Bidipta Sarkar, Mattie Fellows, Juan Agustin Duque, Alistair Letcher, Antonio León Villares, Anya Sims, Clarisse Wibault, Dmitry Samsonov, Dylan Cope, Jarek Liesen, Kang Li, Lukas Seier, Theo Wolf, Uljad Berdica, Valentin Mohl, Alexander David Goldie, Aaron Courville, Karin Sevegnani, Shimon Whiteson, and Jakob Nicolaus Foerster. Evolution strategies at the hyperscale. arXiv preprint arXiv:2511.16652, 2025.
Jeffrey Seely and Julian Gould. Augmented Lagrangian predictive coding. arXiv preprint arXiv:2605.31022, 2026. URL https://arxiv.org/abs/2605.31022.
David Silver, Julian Schrittwieser, Karen Simonyan, Ioannis Antonoglou, Aja Huang, Arthur Guez, Thomas Hubert, Lucas Baker, Matthew Lai, Adrian Bolton, Yutian Chen, Timothy Lillicrap, Fan Hui, Laurent Sifre, George van den Driessche, Thore Graepel, and Demis Hassabis. Mastering the game of Go without human knowledge. Nature, 550 (7676): 354–359, 2017. doi: 10.1038/nature24270.
Richard S. Sutton. The bitter lesson. http://www.incompleteideas.net/IncIdeas/BitterLesson.html, 2019. Blog post.
Akshay Vegesna and Samip Dahal. Decoupling search and learning in neural net training. arXiv preprint arXiv:2509.10973, 2025.
Justin Werfel, Xiaohui Xie, and H. Sebastian Seung. Learning curves for stochastic gradient descent in linear feedforward networks. In Advances in Neural Information Processing Systems, volume 16, 2003.
Bernard Widrow and Michael A. Lehr. 30 years of adaptive neural networks: Perceptron, Madaline, and backpropagation. Proceedings of the IEEE, 78 (9): 1415–1442, 1990. doi: 10.1109/5.58323.