
Simon Willison 6小时前 · 2026-10-06 01:31:15 · 9 阅读
Qwen3.8 27B 模型英文单词加法运算基准测试
研究
Qwen3.8 27B 以文字形式进行加法运算
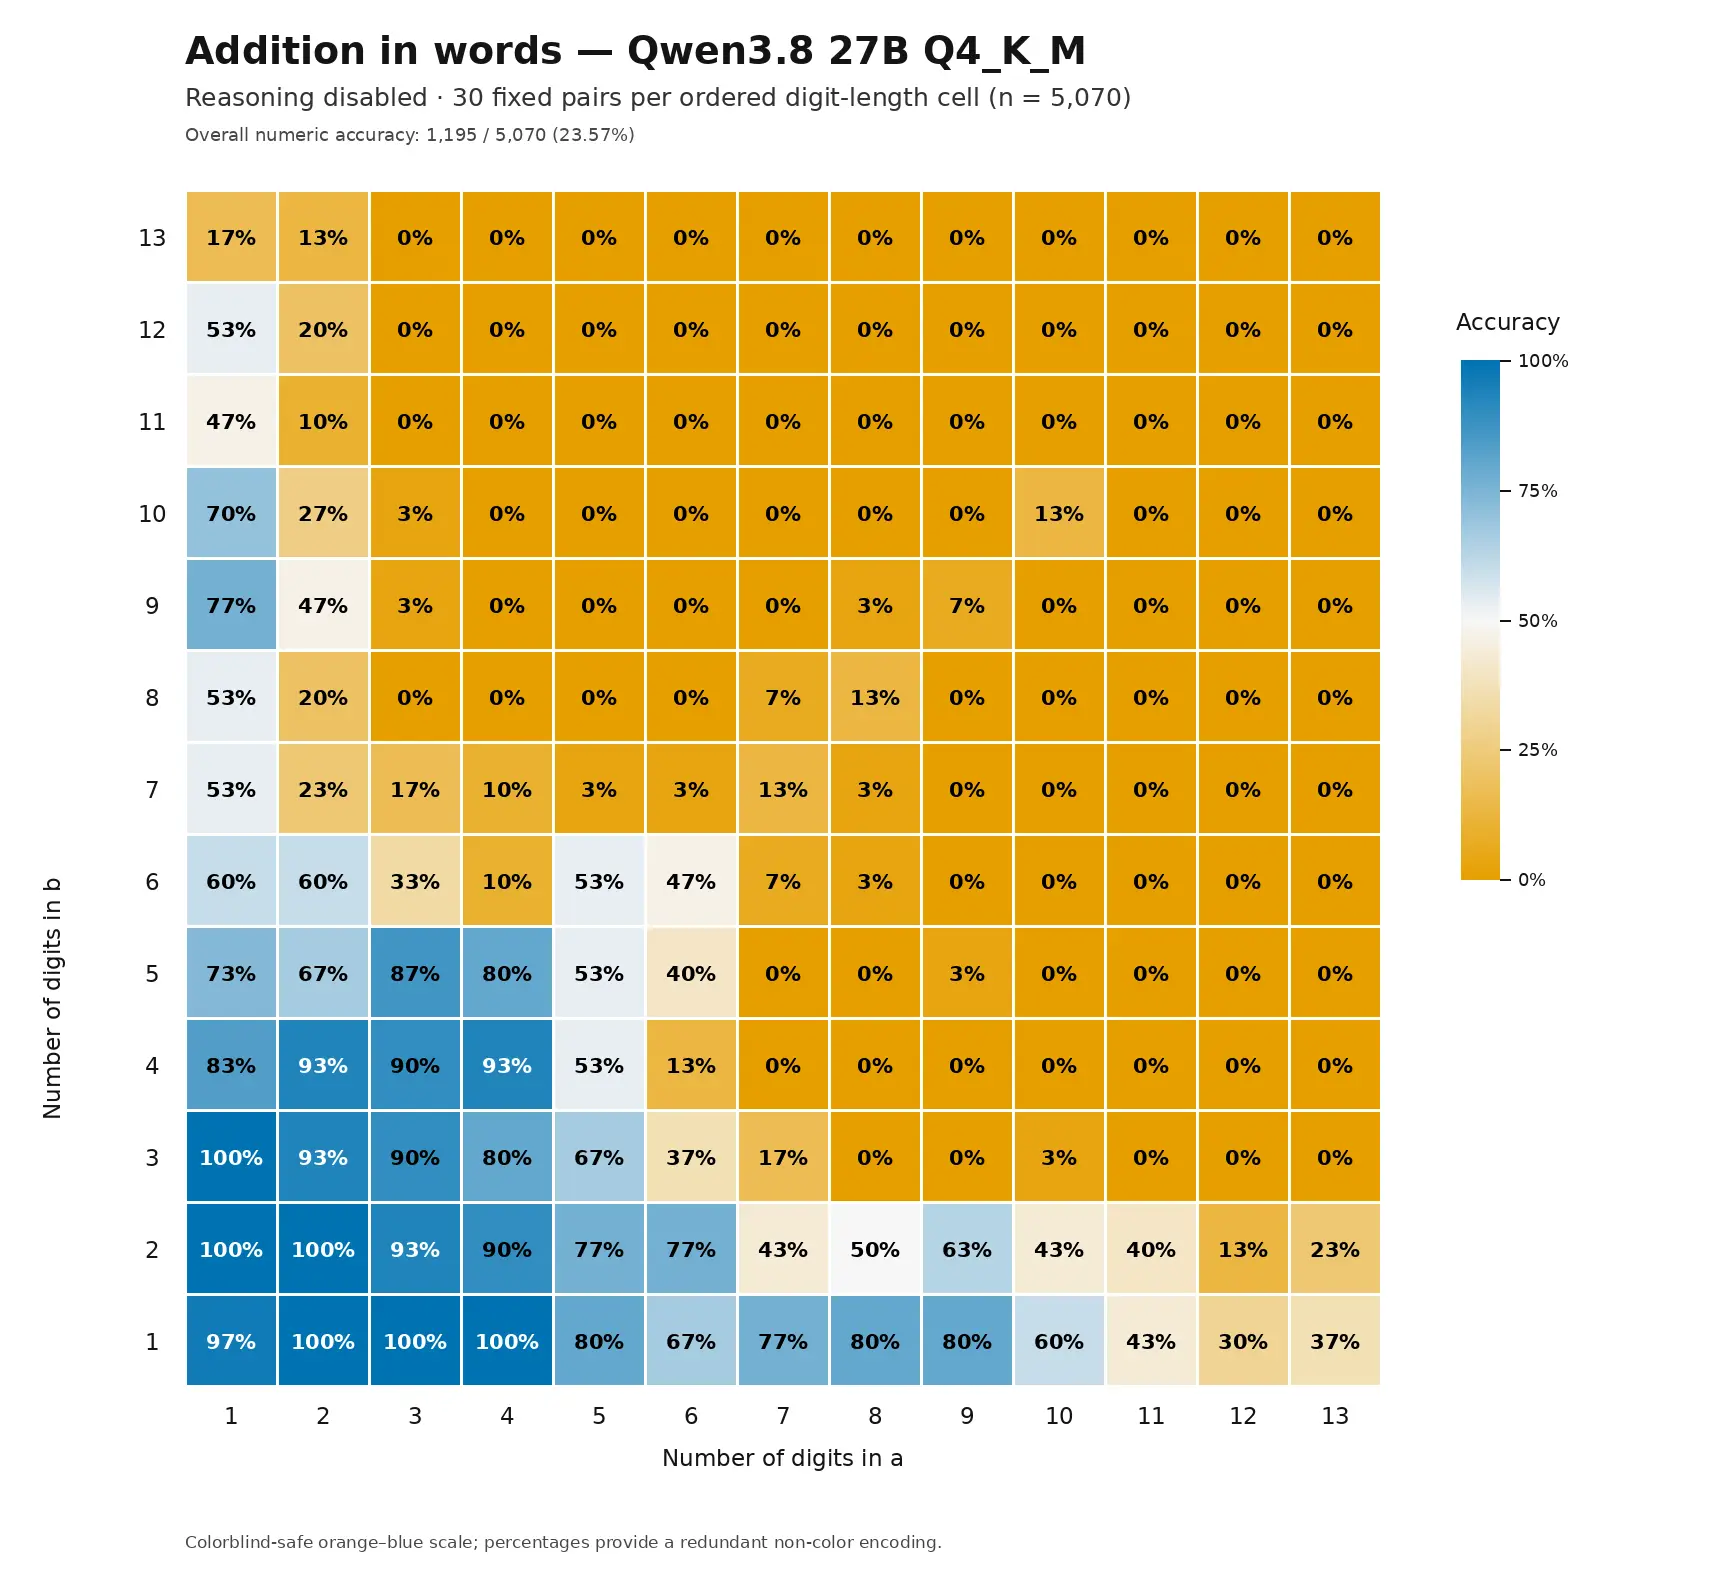
— 一项基准测试验证了本地 `Qwen3.8-27B-Q4_K_M.gguf` 模型是否能在禁用推理模式的情况下,仅用英文单词表达正整数加法的确切结果。测试包含 5,070 个禁用推理案例,并搭配一组 169 个中等推理案例进行对比。在禁用推理时,模型数值准确率为 23.57%;尽管格式合规率高达 96.17%,准确率仍从一位至三位操作数的 97.04% 骤降至十位至十三位操作数的 6.44%。
Colin Frasier 在 Bluesky 上发帖分享了他两年前使用 GPT-4o 进行的一项实验,旨在观察模型随着数字位数增加,在“计算总和但用文字返回答案”任务中的表现。以下是他分享的相应结果图表:
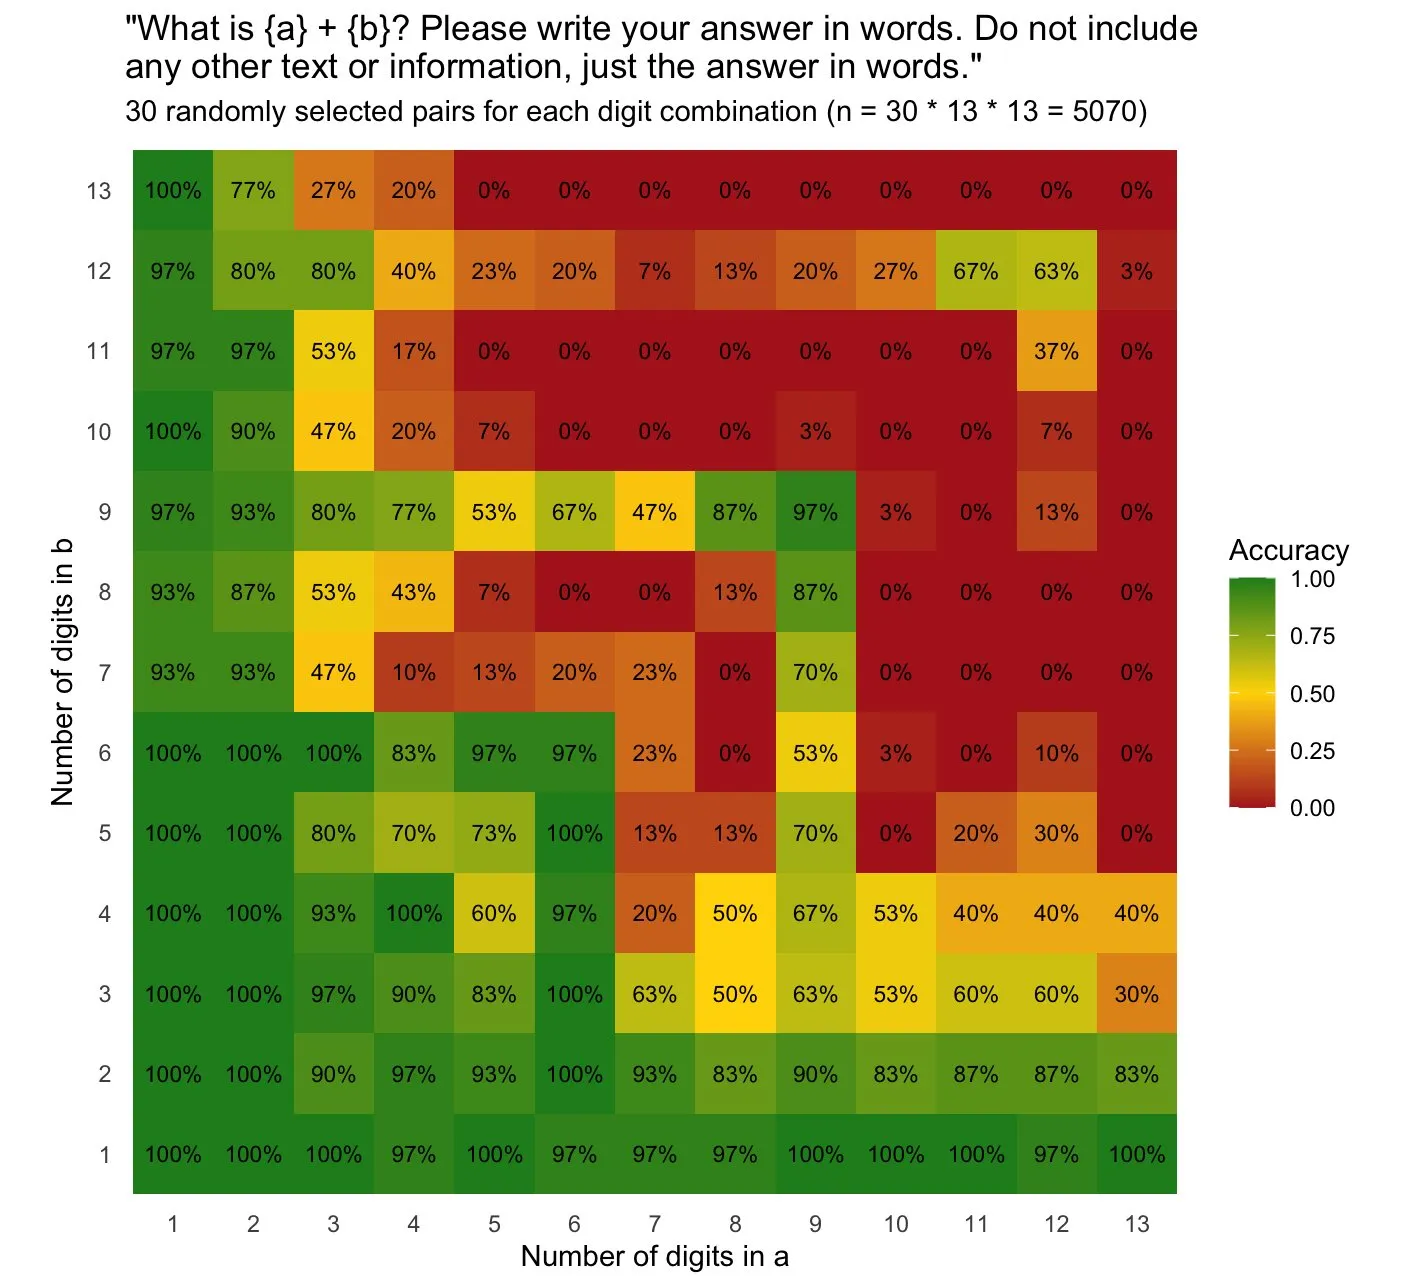
我确信 GPT-4o 没有作弊使用计算器,特别是考虑到它在许多计算中出现了错误。但这次经历启发了我在本地硬件(DGX Spark)上重新运行该实验,以在完全受控的环境中探索这一效应。
我将他的图像粘贴到 Codex Remote 会话(GPT-6 Astra)中,让它使用 Qwen3.8-27B-Q4_K_M.gguf 运行相同的实验。以下是每个组合运行 30 次且禁用推理时的结果:
随后我再次运行实验,这次启用了推理。每对数据的耗时大幅增加,因此我没有像之前那样每个方块运行 30 个样本,而是只运行了一次——这使得热力图在视觉上吸引力较低,因为每个方块只能是 100% 或 0%:
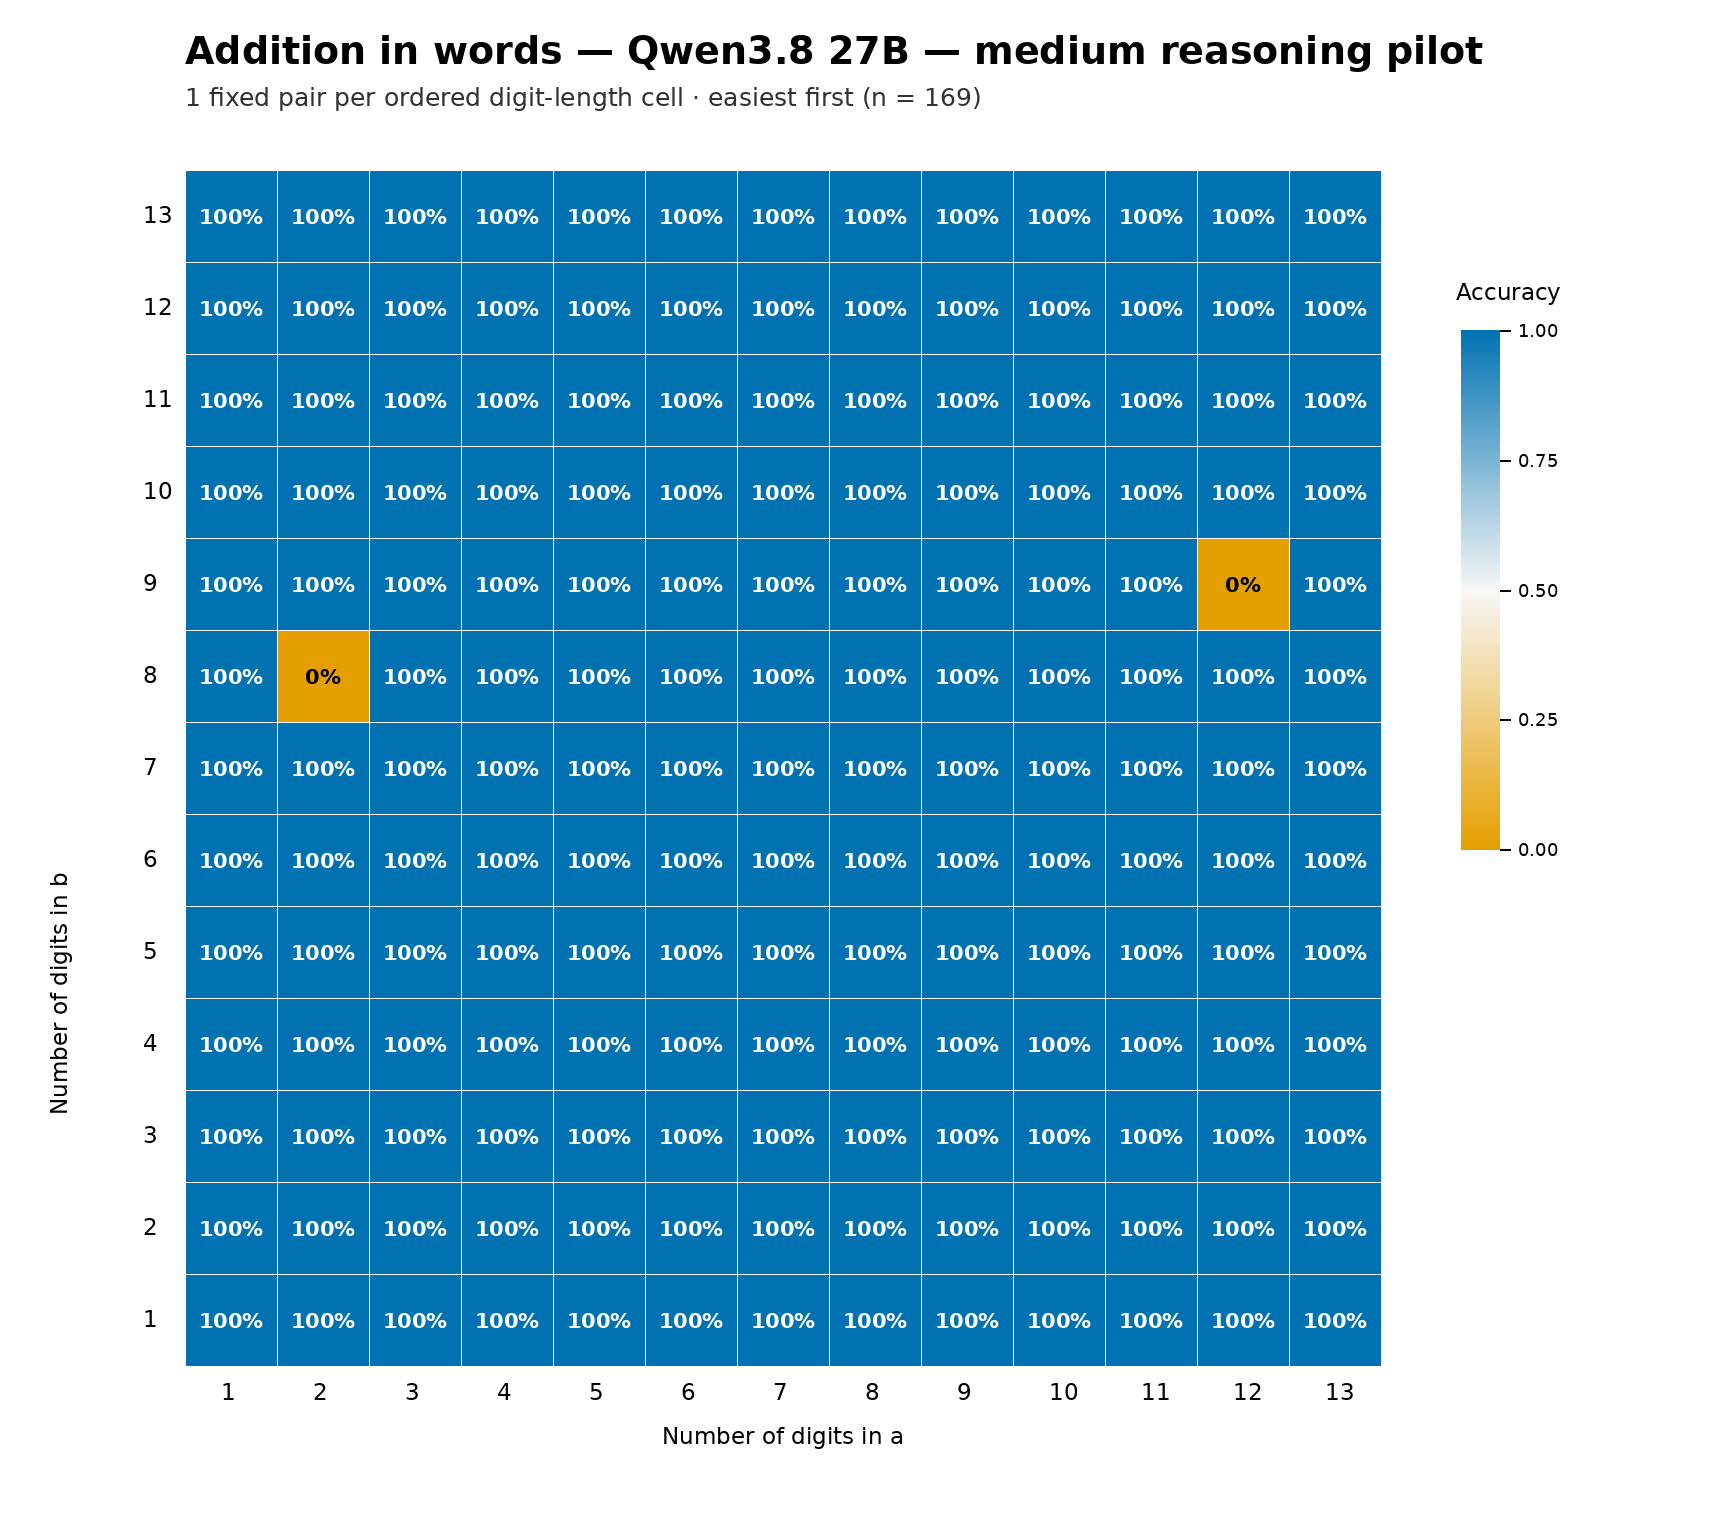
169 次尝试中有 167 次得到了正确答案。由于这些都是单次运行,我确信再跑一次结果会有所不同。
这份报告版本包含了一些大型计算的推理轨迹,其中有这样的内容:
Wait, let me redo this more carefully.

4,299,366,105,622
6,088,794,067,970

Let me align them:
4 2 9 9 3 6 6 1 0 5 6 2 2
6 0 8 8 7 9 4 0 6 7 9 7 0

Adding from right to left:
Position 1 (units): 2 + 0 = 2
Position 2 (tens): 2 + 7 = 9
Position 3 (hundreds): 6 + 9 = 15, write 5, carry 1
原始来源: Simon Willison