
小说交给AI做短剧,第3个分镜我笑不出来
实战 · AI 短剧管道
约 9 分钟读完 · 数据均来自可查证公开报道
2026-10-04 · AI 项目实战④ · 作者:潇然 · 全文约 4600 字 · 阅读约 15 分钟
上篇结尾我埋了话头:AI 做内容,瓶颈不在生成。这话听着像鸡汤,我是被一台机器当面点破的。
我给一条自建的小说改短剧管道喂了一篇民国悬疑微型小说《渡口》,两分钟一集,共六集。第一集切到第三个分镜的时候,校验脚本吐出一行红字:
✗ 1 处违规: 质量门未过:剧本节拍被恰好一次、按顺序、连续认领(分镜级) (E01 第 1 场第 4 拍没人认领)
画面里第 4 拍的内容其实拍了——一个货郎挑着担子挤上跳板。但我在分镜 JSON 里给这一切声明的认领区间写的是 [5,5],第 4 拍就这样从账面上消失了。生成模型没犯错,犯错的是“戏分给了谁”的账。
这一课值一整篇文章。
※ ※ ※
先给你全景:五层管道,每层只干一件事
这条管道是我这半年陆续搭的,五个技能层接力,每层吃上一层的 JSON,吐自己那份 JSON:
| 层 | 吃什么 | 吐什么 | 管什么 | 质量门 |
|---|---|---|---|---|
| 大纲 | 原著小说 | outline.json | 改成什么样:留谁、砍谁、几集 | 14 道 |
| 角色 | 原著 + 大纲 | cast.json | 谁出场:画像、三视图、音色 | 逐字引文核对 |
| 美术 | 大纲 | art.json | 在哪拍:场景锚点、光照变体、道具 | 11 道 |
| 剧本 | 大纲 | script.json | 演什么:场次、节拍、台词 | 10 道 |
| 分镜 | 剧本 + 上述全部 | storyboard.json | 怎么拍:镜头、切点、生成提示词 | 17 道 |
五层里没有任何一层碰“生成”两个字——不调生图 API、不跑视频模型。生成分数只在最后一步:分镜层给每一段产出一条可以直接下单的提示词。这个设计是我踩出来的:把生成从管道里剥出去之后,前面每一层的对错都变成了机器可判的,人只审两件事——戏好不好,画面像不像。
大纲、角色、美术、剧本四层上一篇之前都各自立过功,今天的主战场是分镜层:那 17 道质量门,和“第 4 拍没人认领”背后的一整套账本思想。
※ ※ ※
节拍:把“戏”切成可认领的最小单元
剧本层输出的不是文字,是节拍流。一场戏被拆成一串带编号的最小戏剧单元,动作和台词交替:
{"action": "冷开场:一个年轻女人抱着旧皮箱,在雾里的河岸土路上跑……"} {"action": "跑到头,雾里才露出栈桥,只剩三步能见……"} {"speaker": "C03", "line": "上船喽——过河的抓紧,雾要变天。", "delivery": "扯着嗓子,不急不躁"} {"action": "跳板尽头传来担子的响动,胡二爷挑着货担赶上来,嗓门比人先到。"} {"speaker": "C04", "line": "等等二爷我!这雾天赶船,命都得跑掉半条。", "delivery": "气喘吁吁,自来熟"}每拍几秒是算出来的,不是估出来的。剧本层写死了一个换算口径:台词按中文口语语速折算(我查了源码,默认每秒 4.5 个字,标点也算时间,停顿也是时间),动作节拍按固定 2.5 秒计。《渡口》第一集两个场次一共 35 拍,全部加起来约 104 秒,对 120 秒的集目标——误差在质量门的 ±15% 容忍带内,这个“内”还是算出来的。
为什么要算?因为下游全部依赖秒数:分镜的长度、切点时刻、台词能不能装下、整集时长是不是超标。如果秒数是拍脑袋估的,上面这些判断全都在骰子上。分镜层的工作流文档里那句话我很喜欢:“每拍几秒是算出来的,不要让模型重新估。”
※ ※ ※
认领:分镜层的核心动作,也是最容易翻车的地方
现在到正题。分镜层拿到 35 拍的底稿(seed 命令会自动展开成每场的节拍清单,含编号、秒数、说话人),要干的事只有一件:
把每一拍交给某一个镜头,不重、不漏、不乱序。
每个分镜声明自己的认领区间,比如第三个切 “beats”: [3, 3] 表示它只覆盖第 3 拍——老周扯嗓子喊上船那一镜。第四个切认领 [4, 5],就是“货郎赶来 + 货郎台词”合成一个 5 秒的跟拍长切。
规则听起来平淡无奇,魔鬼在于它同时有三条约束在打架:
- 一个镜头认领的节拍必须连续,不能跨场次——换景必换镜;
- 每个镜头 2–5 秒(硬门),短剧的注意力节奏就这个粒度;
- 认领节拍的台词秒数 ≤ 镜头秒数——4.4 秒的台词只给 3 秒的切,门直接响。
这三条打架的地方就是创作空间:一集 120 秒的戏,35 拍,要切成 2–5 秒的格子,还要让台词装得下、场次不跨、节拍不重不漏。这不是“让 AI 发挥”的事,这是排班表。
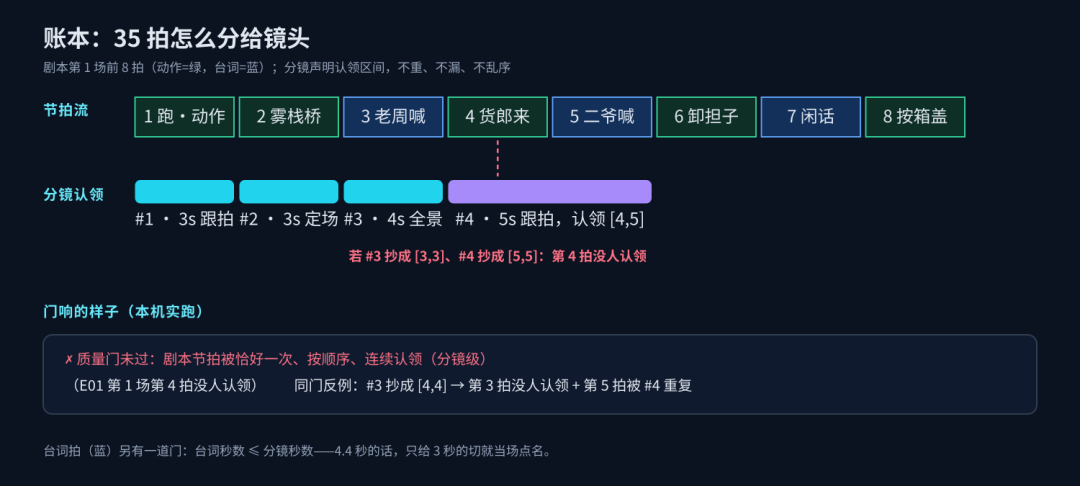
我又试了反向操作:把 #3 的认领从 [3,3] 改成 [4,4]——第 4 拍这下同时挂在 #3 和 #4 两本的账上,想看看门会不会“宽容”一点。机器的回答比我预期的狠:
✗ 1 处违规: 质量门未过:剧本节拍被恰好一次、按顺序、连续认领(分镜级) (E01 第 1 场第 3 拍没人认领;E01 第 1 场第 5 拍被 E01-01#4 重复认领)
我明明只动了第 4 拍,它点的却是第 3 拍和第 5 拍——门是按认领顺序扫游标的:#3 本该从第 3 拍接上却从第 4 拍起,游标当场宣布第 3 拍没人认领;扫到 #4 时游标已经推到第 5 拍,#4 还从第 4 拍开始认领,就点 #4 重复。机器不跟你讨论“你以为错在哪”,它只报账本断在哪。
没人认领,它报;重复认领,它也报。这一道门把“戏有没有丢”变成了和“括号匹不匹配”同级的确定性检查。我后来复盘,第 4 拍之所以漏掉,是因为我在给这一切配画面提示词的时候光顾着想构图,认领区间少写了一拍——模型(包括我雇的那个)在这种地方就是会漂,账本思想的第一条:漂,是要被抓到的。
※ ※ ※
秒数不是估算,是下单
比漏拍更阴的坑在后面。每个镜头的秒数写进 JSON 的那一刻,它就不只是“我打算拍几秒”,而是直接决定切点时刻的视频生成指令。
分镜层为每一次生成产出一条完整的提示词(我用的模型按多参考图输入组织),开头是一段对齐指令,声明每张分镜图钉在视频的第几秒:
How the reference pictures align with the target video — Picture 1 (from Shot 1) aligns with the 0.00-second mark ... Picture 2 (from Shot 2) aligns with the 3.00-second mark ... Picture 3 (from Shot 3) aligns with the 6.00-second mark ... Picture 4 (from Shot 4) aligns with the 10.00-second mark ...
这段文字是从分镜结构推导的:第 2 图的 3.00 秒 = 第 1 切 3 秒,第 4 图的 10.00 秒 = 3+3+4。校验脚本会逐字重算一遍,和 JSON 里的秒数对账。
我做过一次实测:把第 3 切从 4 秒改成 5 秒(想给台词多留点余量),忘了同步改提示词。跑校验:
✗ 2 处违规: 质量门未过:每段 0 < 总秒数 ≤ 15(一次生成的上限)(E01-01 共 16 秒) 质量门未过:H3 首行对齐指令由分镜结构推导逐字对账,切点时刻逐个对 (E01-01 首行对齐指令和分镜结构对不上(promptLang=en))
一次改动,两条门响:改 1 秒顶穿了一次生成的 15 秒上限,且对齐指令里的切点全部漂移。如果这两条没有门兜着,会发生什么?提示词说 Picture 4 钉在 10.00 秒,视频实际第 11 秒才切画面——第 4 张分镜图控制的构图整体错位 1 秒,台词口型、转场重音全歪。AI 视频管道里最贵的错误不是生成得丑,而是生成得歪,歪还很难在成片里一眼看出来。
改秒数必须同步改提示词,改提示词必须重跑对账。这一条没有豁免。
※ ※ ※
一致性闸门:画风漂、人名、中英漂,全在门里
认领账本管戏不丢,还有三组门管“东西长得一样”。我在《渡口》上撞到的、和故意撞的,凑一桌:
画风漂。 我把一个子分镜的图提示词里 cinematic film still, cold gray-green palette 改成 anime style, warm pastel palette,手痒想看看同一集里混一格日漫会不会出事:
✗ 1 处违规: 质量门未过:分镜图风格短语统一(realistic:cinematic film still) ——同剧不许画风漂(E01-01#2 的分镜图提示词缺风格短语)
提示词禁人名。 分镜图和视频提示词里不许出现“沈知微”三个字,只许写 a young woman in a plain qipao。原因不是保密,是生成纪律:参考图才是长相的唯一权威,提示词里写了人名,模型并不会知道她长什么样,但会开始自由发挥补脸;用通用身份描述 + 挂角色设定图,长相才被钉死。这条门同时查提示词语言——写英文的任务里混进中文描述,双向都拦。
时长装不下。 台词 4.4 秒给 3 秒的切,单独成门。这个最直白:口播都装不下,画面再美也是废的。
三组门合起来指向同一件事:AI 生成内容的难点从来不是“这一次生成得好不好看”,而是“第 1 格和第 34 格是不是同一个世界”。雾的颜色、女主的袖口、船帮的木纹,这些在单格里模型随手就给对了,跨 34 格没有一个还成立——除非你把它们的定义权收走:长相交给角色设定图,场景交给场景图,光照交给光照状态,画风交给一句锁死的短语。
※ ※ ※
算总账:34 个切,119 秒,2 个批次
全过校验的那一行输出,我截在这里:
✓ 1 集 / 10 段 / 34 个分镜全部通过校验(共 119s / 目标 120s / 2 个生成批次)
拆开看这串数字,比“生成了 34 张图”有意思得多:
- ▪ 10 段 = 10 次视频生成调用。每段 9–15 秒、不跨场,是模型单次生成的上限决定的(默认 15 秒,按你的模型改参数)。两分钟一集的戏,一次管道跑完要下 10 个单子。
- ▪ 平均一切 3.5 秒,34 切里 25 个固定镜头、5 推、3 跟、1 拉。运镜克制不是玄学:固定是默认,推给情绪,拉给收场,跟给移动。景别分布中景 13、全景 9、特写 8、大远 2、大特 2——正反打和“进场三件套”(运动主体→大远景定场→关键局部特写)的节奏就藏在这组数里。
- ▪ 2 个生成批次:同场景 + 同光照的分镜自动归一批,共用同一套环境参考图——相当于 AI 版的顺场表。34 张分镜图不用每次重新描述渡口长什么样,场景设定图挂上去,一致性就有了锚。
- ▪ 提示词体量:每段一条完整下单提示词,实测 1212–2020 字符,平均约 1500 字符;19 段 <d> 台词块逐字嵌在里面——剧本里的台词不经过任何转写,直接逐字进视频指令,这也是“台词不丢”的另一半保障。
第一集最终产出是:1 份 storyboard.json、1 份 Markdown 分镜表、1 页评审报告(节奏带、逐镜表、批次单、配音对齐单),外加 10 条可以直接贴给视频模型的提示词。全程没打开过一次生图界面。
对了,这五层管道的自测我那天挨个跑了一遍:1170 项断言全绿。17 道分镜门里每一道都有对应的击穿用例——这套门不是摆设,是被真实输出一次次打出来的。
※ ※ ※
给你的三条结论
搭之前我以为这篇文章会写“AI 做短剧最难的是生成质量”。写完我发现自己错了,生成是这条管道里最便宜的一环——丑可以重roll,歪才是返工地狱,而歪只有账本能抓到。分人群说:
做内容的。 别把“一致性”当玄学叮嘱给 AI(“注意角色长得一样哦”),把它做成机器可判的声明:谁在画面里、第几拍归谁、第几秒切、什么画风。凡是你口头强调的,模型都会漂;凡是你让脚本对账的,才真的算数。
做工程的。 这套“认领 + 逐字对账”的模式不短剧专属。任何多阶段生成管道——报告、课件、营销物料——只要产物之间有引用关系(第 N 页引用第 M 节的数字),都可以抄:让上游结构唯一决定下游文本,校验时重算一遍对账,漂即报错。确定性检查的成本是一次脚本运行,漂移的代价是一整批废生成。
想上手的。 不需要从零造。这套东西的价值在骨架不在皮肉:节拍怎么算秒、认领怎么声明、切点怎么进提示词,把这三条抄进你自己的流程,门可以慢慢加。我最后悔的不是第 4 拍没人认领——那只是一行报错的事;是我一开始真打算让模型“凭感觉”切 35 拍的戏。凭感觉切出来的东西,漂亮,但账是烂的。
下一篇预告:我扔掉了 Chrome,拿一个 60MB 的小内核跑了一个礼拜无头浏览器——JS 渲染、截图、CDP 兼容,四条实测结论,哪些站能跑、哪些必翻车,一次说清。
※ ※ ※
资料来源
- ▪ 自建小说改短剧管道:大纲/角色/美术/剧本/分镜五层技能的 SKILL.md 与参考文档(质量门规则、切镜纪律、H3 提示词规范)
- ▪ 语速换算(每秒 4.5 字)与动作节拍估时(2.5 秒)取自剧本层源码 DEFAULT_PARAMS;段上限 15 秒、单切 2–5 秒取自分镜层参数与质量门实现
- ▪ 示例数据全部来自自造微型小说《渡口》的改编产物:6 集 / 9 场 / 123 句台词(约 1956 字)/ 87 个动作节拍;第一集 35 拍 → 10 段 34 切 / 119 秒
- ▪ 文中终端输出(通过行、五处违规报错)均为本机管道实跑,未做拼接;示例为作者自创作品,示例主机信息均已脱敏
- ▪ 五层管道自测:249 + 154 + 158 + 355 + 254 = 1170 项断言,实测全部通过
生成是这条管道里最便宜的一环——丑可以重roll,歪才是返工地狱。