
SQL移植版Doom:将1993经典游戏跑在数据库里
TL;DR:我们把 1993 年初代 Doom 的游戏逻辑和渲染器移植到了 SQL,并在数据库里运行起来。 游戏循环保持原版的 35 FPS,渲染器在我的笔记本上能以最高 60 Hz 输出完整的 320x200 帧缓冲。 Python 只负责计时、读取键盘和显示返回的位图。多人联机也能玩。
您的浏览器不支持 video 标签。AMD Ryzen 7 7840U 上运行的 SQLDoom现在就能玩 死亡竞技模式,四个名额,先到先得。
这是第一关的共享软件版。如果名额满了,你会进入排队队列。 即使排队,你也可以通过 SQL 实时查询游戏状态,随便看看。
SQLDoom
去年,我发布了 DOOMQL [Github]。 它以 30 FPS 渲染出一些大致像 Doom 的 ASCII 画,反响很不错。 但有人正确地指出,它其实更接近 Wolfenstein 3D 而不是 Doom,因为它用的是光线投射(raycasting)方法。 而 Doom 使用的是 BSP 树,让深度排序的代价足够低,从而能支持贴图、任意角度的墙面和高低起伏的地板。
这事我一直放不下,折腾了一阵子之后(你猜对了,又休育儿假了),我终于可以让真正的 Doom 完全跑在 SQL 里了。
规则
先定几条我们要达成的底线规则:
- 画面要像真的 Doom。现在回头看,DOOMQL 的视觉还原度实在有点拿不出手。
- 但更重要的是,玩起来也要像真的 Doom。原版游戏的乐趣是纯粹的。
- 渲染必须完全基于 SQL。可接受的 SQL 输出只有一种:一张为每个像素编码精确 RGB 值的表或位图。
- 游戏主循环也必须完全基于 SQL 实现。不过,允许在数据库内部使用用户定义函数。
- 允许用其他编程语言编写客户端,前提是它只负责解析输入、驱动游戏帧循环以及渲染输出位图。
架构
Python 被刻意设计得很简单无趣(规则 5)。单个脚本利用 pygame 驱动输入、绘制输出位图,并以每秒 35 次的频率触发游戏帧。
游戏逻辑、游戏状态和渲染器都驻留在数据库内部。
                         Python
                 input / timing / display
                    |              ^
                    |              |
          run game tic        request frame
                    |              |
                    v              |
          +----------------+  +----------------+
          |                |  |                |
          | SQL game logic |  |  SQL renderer  |
          |                |  |                |
          +-------+--------+  +--------+-------+
                  |                    ^
                  |                    |
                  v                    |
             +-----------------------------+
             |                             |
             |       game state tables     |
             |                             |
             +-----------------------------+
两条路径被刻意分离:游戏逻辑运行在 35 Hz 的固定循环上, 而渲染器是游戏状态表的纯函数,客户端可以随时(尽可能快、尽可能频繁地)请求新帧。
加载游戏数据
便利的是,Doom 的 .wad 文件格式本身具有高度的关系特性。
两个 VERTEXES 由一条 LINEDEF 连接,该 LINEDEF 拥有两个 SIDEDEF。SIDEDEF 绑定了一个 SECTOR,其中可以包含
THINGS,依此类推。
将整个 WAD 转换为数据库的过程出人意料地直接,仅需约 1000 行 Python 代码。
在我的笔记本电脑上,导入 Doom 1 的全部内容大约需要 18 秒。
例如,以下是一个渲染 E1M1 俯瞰视图的查询:
WITH wall AS (
  SELECT round((v1.x + (v2.x - v1.x) * t / 32.0) / 48) AS col, -- 48 units per column
         round((v1.y + (v2.y - v1.y) * t / 32.0) / 96) AS row, -- chars are 2:1
         l.left_sd_id < 0 AS solid -- one-sided lines are pass-through
  FROM linedefs l, generate_series(0, 32) AS t        -- walk each line in 32 steps
  JOIN vertexes v1 ON (v1.map_id, v1.id) = (l.map_id, l.v1_id)
  JOIN vertexes v2 ON (v2.map_id, v2.id) = (l.map_id, l.v2_id)
  WHERE l.map_id = 1
)
SELECT string_agg(CASE WHEN (col, row) IN (SELECT col, row FROM wall WHERE solid) THEN '#'
                       WHEN (col, row) IN (SELECT col, row FROM wall)             THEN '.'
                       ELSE ' ' END, '' ORDER BY col)
FROM generate_series(-16, 79) AS col, generate_series(-51, -21) AS row
GROUP BY row ORDER BY row DESC;
输出结果:
                                                 #####################
                                                 # ..................#
                                                 # . ......         .#
                                                 # . ...... ######  .#
                                              ######         .. ##  .#
                                          #####..  .         .. ##  ##
                                          #  ####### ...... ######  ##########
                                          # ##   # .                ###..  ..##
  ################                       ## #    ###.........######## #####.  ##
###  ........... #                ########..########.........###         #### .##     ######
#  ..           ##########     ####         ##                 ##        #..... #######    ##
#  .          #####  ... ##  ###   #.....#..##    ........      ##########..... ....##.#### ##
#  .     ###.###  ......  ###  .   .        ##  ...      ...             . ......     .#  ##  ##
#  .     ##..  .  ......  ##   .   .        ##  .           .            . ..........  ##  ## ##
#  .     ###.######  ...  ######   #.....#..##  ...        ..            #.    ... ..   # ## ##
#  .           ############    #            ..    ..........             #.......... ...# #  #
###.........     #             #####     #####                           ##..... ... ##.###  #
  ################                 #######   ####.........##.##........####### .#######  ### #
                                                 ###########.#################  #  ####  # # ##
                                                           #.#      ####......  #  # .   ### ##
                                                           #.#################  #  ###########
                                                           ####. .####       #..#
                                                              #####     ######..######
                                                                        #   .    ..  #
                                                                        #   ##...##  #
                                                                        #   ##   ##  #
                                                                        ######..######
                                                                             ####
                                                                             #####
                                                                             #.. #
                                                                             #####
游戏循环
对我而言,真正的移植 Doom 至关重要,而不仅仅是渲染出几帧乍看像 Doom 的画面。 当然,视觉效果是大头,但 Doom 玩起来那种爽感也是核心体验。 来看看下面这个场景,这是规则 2 的实际表现(我玩得挺开心):
如你所见,画面信息量很大。仅在这段短视频里就能看到:
- 需要轮询并处理玩家输入(移动、转身、射击),
- 敌人会移动和攻击,
- 物品会被拾取,
- 火箭发射器会射出移动的弹体,
- 火箭爆炸带有冲击波范围,
- 需要渲染敌人精灵图,
- 动画、视角晃动以及 HUD
我们处理这些逻辑的时间非常有限:
原版 Doom 运行在 35 Hz 的固定时钟上,因此每个 tick(节拍)的预算为 1000 ms × 35 Hz = 28.6 ms。
同时它每个 tick 恰好绘制一帧,所以上限也是 35 FPS。
SQLDoom 将游戏逻辑保持在 35 Hz(以便所有原始常量继续有效),但将渲染过程解耦。 客户端可随时查询(get it?)获取一帧,我们则在不同 tick 之间对相机位置进行插值。 因此有两项预算需要关注:
- 每 28.6 ms 执行一次 tick(否则手感会完全不对)
- 至少每秒渲染 35 帧(低于此值尚可接受,但会显得不流畅)
Tick 执行序列
游戏 tick 本质上是过程式的。每次执行 tick 时,我们必须按顺序执行一系列操作。
CedarDB 有一种名为 cedarscript 的脚本语言,它类似于 PL/pgSQL,允许我们预先规划每个 tick 的执行步骤。
以下是 tick 函数的一小段代码:
doom_cs_clock(map, p);
let mut plan = doom_cs_plan(map, p);    -- 返回需要触发的函数位掩码

let use_queued = doom_tic_use(map, p, plan);
if (plan & 2) <> 0 OR use_queued { active = doom_cs_activate_specials(map); }
if (plan & 4) <> 0 OR active <> 0 { doom_cs_doors(map, p); }

doom_tic_move(map, p);                  -- 完整移动或仅转向
doom_cs_death(map, p);                  -- 处理死亡

plan = doom_cs_plan(map, p);            -- 世界已变化;重新规划
plan = doom_tic_secrets(map, p, plan);  -- 秘密、踩线触发、拾取
plan = doom_tic_weapon(map, p, plan);   -- 武器状态、命中扫描、伤害
...
if sound_due { doom_cs_sound(map, p); } -- 是的,我们还播放声音
doom_cs_monsters(map, p);               -- 总是执行
doom_cs_sector_fx(map, p);              -- 总是执行
doom_cs_thing_physics(map);             -- 总是执行
上面提到的 Python 驱动程序每秒调用 SELECT doom_run_game_tic(...) 35 次。
这些被调用的函数接着执行一批 SQL 语句。 下面是怪物 AI 状态机的部分示例。
-- 节选自 sql/runtime/functions/26_cs_monsters.sql。
WITH RECURSIVE
  monsters AS ( [...] ),   -- 谁还活着、什么类型、在哪里
  los      AS ( [...] ),   -- 可见性、视野范围内、距离:递归实现,会沿墙搜索
  decision AS ( [...] ),   -- 每个角色一行:其状态及视野内的情况
  transitions AS (
    SELECT d.*,
      CASE
        WHEN NOT d.alive AND d.state NOT IN ('die', 'dead', 'xdeath') THEN
          CASE WHEN d.health < -d.max_health AND d.xdeath_frame IS NOT NULL
               THEN 'xdeath'::actor_state ELSE 'die'::actor_state END -- 血腥爆炸!
        WHEN d.state = 'stand' THEN
          CASE WHEN d.visible AND d.in_view_cone AND d.dist <= sight_range
               THEN 'see'::actor_state ELSE 'stand'::actor_state END
        WHEN d.state_tics > 1 THEN d.state          -- 动画还在播放中
        WHEN d.state = 'see' THEN
          CASE WHEN d.visible AND d.dist <= d.attack_range
                    AND d.attack_cooldown <= 0
               THEN 'missile'::actor_state ELSE 'see'::actor_state END
        [...]                -- die、xdeath、missile、pain、barrel:还有 5 种状态
        ELSE d.state
      END AS next_state
    FROM decision d
  )
UPDATE monster_ai ai
SET state = n.next_state, state_tics = n.next_tics, seq_index = n.next_seq,
    fired_this_tick = n.advances AND n.lands_on_attack_frame
FROM next_values n
WHERE ai.map_id = n.map_id AND ai.thing_id = n.thing_id;
可以看到,这段 SQL 就实现了上面视频里的行为:当敌人受到极高伤害时(CASE WHEN d.health < -d.max_health AND d.xdeath_frame IS NOT NULL),它会猛烈爆炸!(THEN 'xdeath'::actor_state)。
Tic 驱动器的性能
下面是一次游戏 tic 的瀑布图:
我能找到的最慢的一次游戏 tic这确实是我能找到的最慢的一次 tic。场景是 E4M1 关卡,46 只已苏醒的怪物全都试图挤过一扇正在打开的门冲向我。这一次 tic 耗时 10.45 毫秒,约占可用时间预算的 37%。
而一个更典型的情况——6 只怪物苏醒——平均每次 tic 只需 2.15 毫秒,约占预算的 8%。余量非常充足!
说实话,我没想到用 SQL 表达相当复杂的游戏逻辑会这么容易。整个游戏逻辑只有大约 5900 行 SQL。听起来不少,但完成同样功能的原始 C 源码可是要 9000 行左右呢!
SQL 还迫使你换一种思维模式来思考问题。比如处理敌人时,你不再需要逐个遍历,只需写一条简单的 `UPDATE ... WHERE condition`,剩下的就交给数据库去并行自动处理!
这也让我终于顿悟了 实体组件系统(ECS) 的设计模式。在这个架构里,每个 `entity`(玩家、怪物、物件等)由多个 `components`(位置、贴图、属性等)组成,而 `system`(怪物 AI、玩家移动、伤害计算等)则决定拥有特定属性组合的实体之间如何交互。ECS 的核心在于数据局部性,以及如何高效遍历拥有特定组件集合的实体。而 SQL 恰恰擅长处理这类密集型数据!每一个组件对应一张表,每一个系统则是一条 `update` 或 `insert` 语句,它只关联自己关心的表,并以实体作为连接键即可。
渲染
每一帧本质上就是一个巨大的视图:它读取关卡几何结构、游戏状态和玩家位置作为输入,返回完整的帧缓冲。以下是整个渲染流程的草图:
WITH RECURSIVE
  render_context AS (SELECT $1 AS map_id, $2 AS player_thing_id, $3 AS difficulty),
  pos            AS (SELECT $4 AS x, $5 AS y, $6 AS z, $7 AS angle),
  visible_children AS ( ... ),    -- 遍历 BSP 树,剔除不可见区块
  clipped, projected, on_screen,  -- 将区块投影到屏幕坐标系
  wall_parts, columns, fragments, -- 每个墙面像素一行
  panel_clips, plane_spans, ...,  -- 使用窗口函数处理天花板/地板裁剪,生成可见平面
  thing_pixels, sprite_fragments, -- 贴图精灵
  fragment_union, resolved,       -- 收集所有候选像素,并解析出最近者
  view_colored, ui_colored,       -- 应用色表映射,叠加状态栏
  framebuffer AS ( ... )          -- 64,000 行 (x, y, rgb) 数据
SELECT string_agg(rgb, ''::bytea ORDER BY y, x) AS frame_rgb
FROM framebuffer;                  -- 192,000 字节,合并为单行
该实现包含约 1300 行 SQL(不含注释),分布在 89 个 CTE 中,作为一条 SQL 查询来说相当复杂。
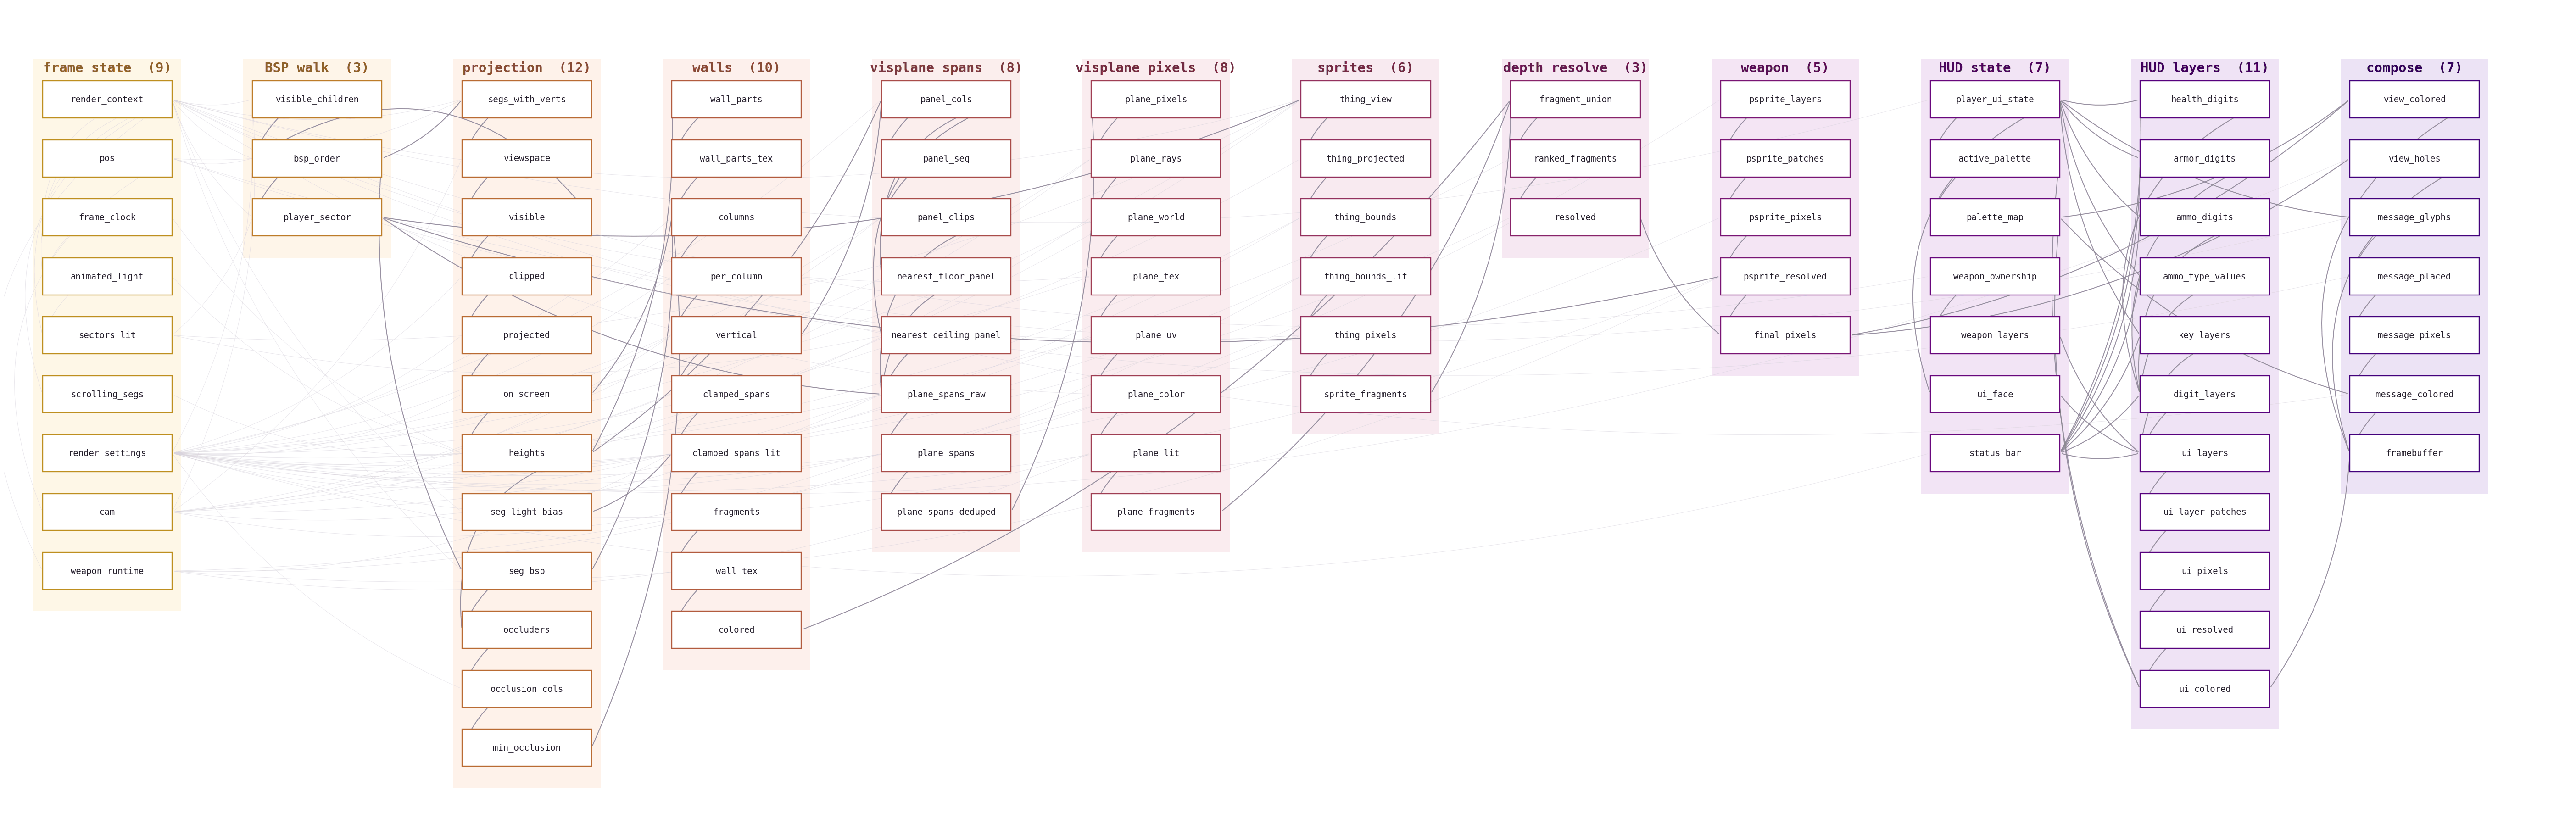
尽管这套流程看似疯狂,但它实际上非常贴近 Doom 真实的渲染逻辑。
SQL 甚至具备一个优势:
linux_doom 源码的渲染引擎约有 3300 行代码(不含注释),
比 SQLDoom 多了大约 2.5 倍。最初这个设计是否明智,另当别论,我们稍后再谈。
先来看看渲染流水线中最有趣的部分:
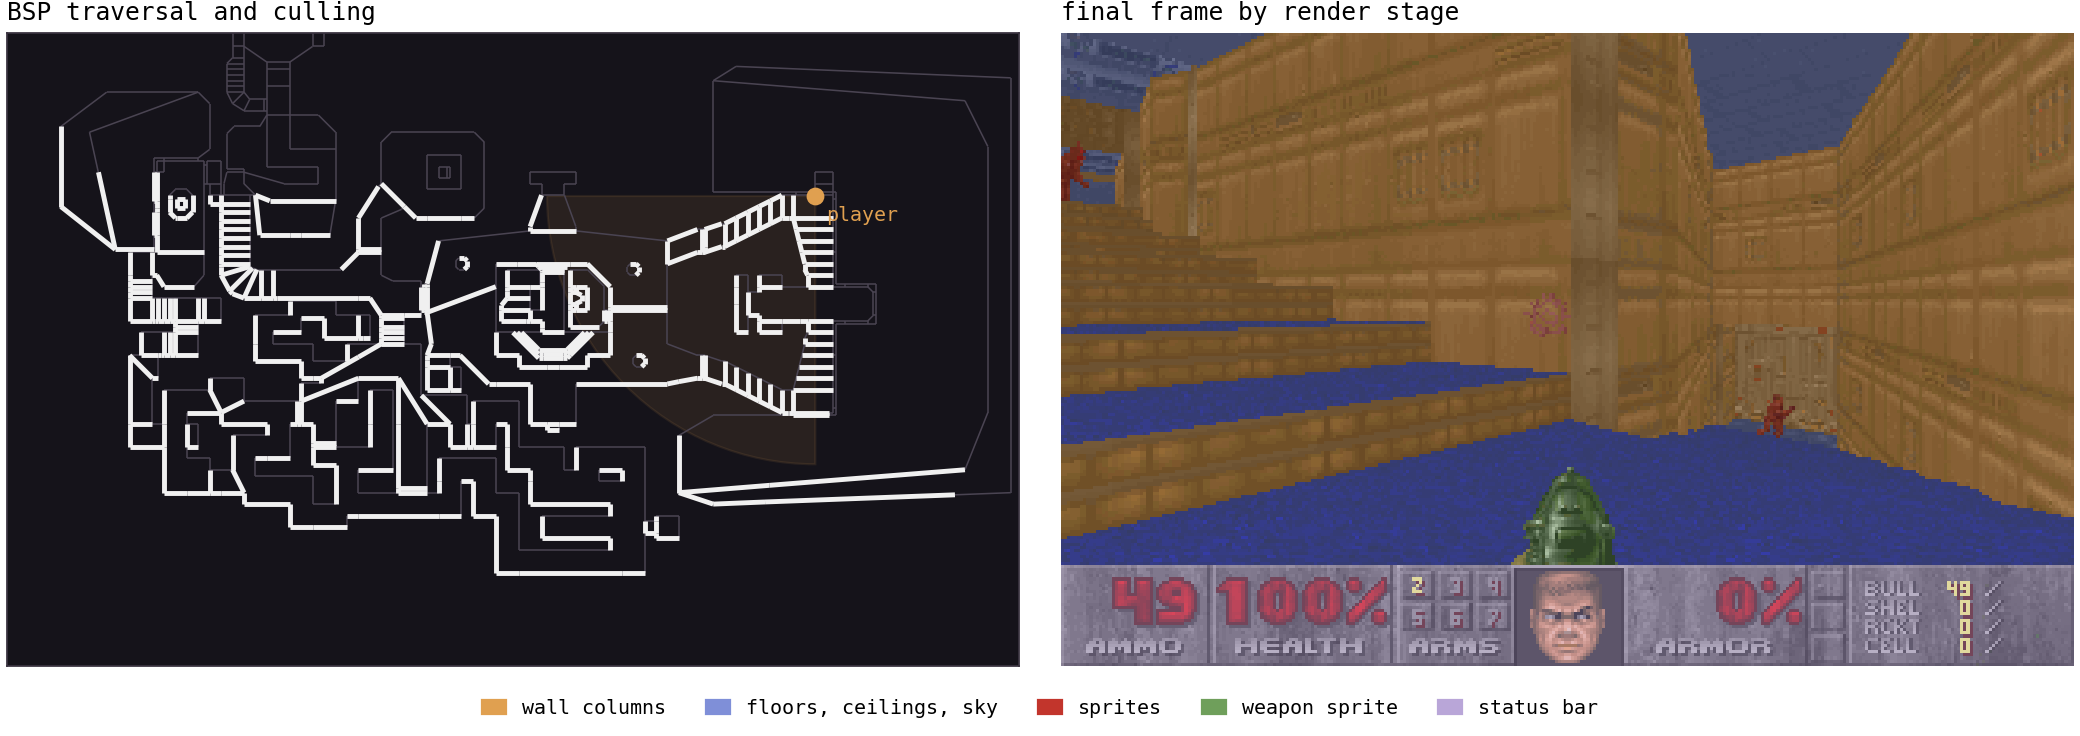
左半部分展示了基于 BSP 的剔除(culling),右半部分则可视化了墙壁渲染和可见平面(visplanes)。
BSP 遍历
1993 年没人拥有带硬件加速 Z-buffering 的 GPU, 因此 Doom 必须通过按正确顺序绘制来处理遮挡。 Doom 采用的方法相当巧妙:它从前往后绘制,并跟踪哪些像素已经绘制过(换句话说,如果某个墙体像素已画好,就不必再画后面的怪物)。 但说起来容易做起来难:我们需要一种高效的方法,将关卡中的所有元素按深度排序。
Doom 通过预先计算并烘焙到 doom.wad 文件中的 BSP 树来获取这种排序。
树的每个节点是一条将地图一分为二的分割线。地图的扇区(sectors)因此被切割成许多位于这些线条两侧的次级扇区(subsectors),随后插入树中,从而满足以下属性:
- 每个次级扇区都是叶子节点,并且
- 每个次级扇区都是凸的(即在内部任意位置都能看到所有墙壁)
- 在每个树节点处,位于摄像机一侧的整棵子树保证位于另一侧子树的前方。
通过递归遍历 BSP 树,我们就能得到所有次级扇区的从前往后的顺序。这直接决定了渲染顺序: 一旦某个屏幕区域被更近的物体覆盖,后面的物体就可以被跳过。
这是动态效果演示(你可能需要全屏观看): 您的浏览器不支持 video 标签。
BSP 遍历的可视化左侧按从前到后的顺序排列了 subsector,视野外的 BSP 分支会被直接裁剪掉。中间是 SQLDoom 给每个区域分配的顺序,右侧是最终生成的画面,墙面颜色对应其所在的 subsector。
中间那幅图展示了 SQLDoom 做的一项优化:为了提升性能,我们在加载时一次性预计算好 BSP 树中的所有路径。对于给定的位置,路径上的每一步要么走前侧(编码为 0),要么走后侧(编码为 1)。把这些决策打包进一个 bigint,再按字典序排序(order by),就能得到正确的前后顺序。
SELECT ssector_id, ROW_NUMBER() OVER (ORDER BY sort_key) AS bsp_seq
FROM (
  SELECT st.ssector_id,
         -- back = 1 at bit (40 - depth), front = 0.
         SUM(CASE WHEN st.side = fs.front_side THEN 0::bigint
                  ELSE (1::bigint << (40 - st.depth)) END) AS sort_key,
         BOOL_AND(vc.keep) AS visible   -- was any parent bbox culled?
  FROM node_path_steps st -- materialized view, every root-to-ssector path
  JOIN nodes n ON ...
  CROSS JOIN LATERAL (SELECT ... AS front_side) fs -- on which side are we?
  JOIN visible_children vc ON ...
  GROUP BY st.ssector_id
) s WHERE s.visible;
一个 sum() ... order by 就替代了整个递归下降!40 位也足以应对任何地图:最深的 BSP 树是 E4M8 的,也只有 32 层。只要你的地图不超过原版最大地图的 256 倍,就完全够用!
仔细看会发现,我们的 BSP 遍历还顺带处理了裁剪:.wad 中的每个节点恰好都定义了其所有子节点的包围盒。如果能证明视锥体完全落在包围盒之外,那这个子树就无需参与渲染——这正是 visible_children.keep 的含义。于是 bool_and(vc.keep) 会过滤掉所有存在不合格祖先节点的 subsector。
管线中后续的所有步骤都通过 bsp_seq 做 join,因此只处理可见的 subsector,且顺序正确。
Walls 与 Visplanes
Doom 有点作弊的味道:它看起来是 3D 的,实际上是个 2.5D 游戏。 本质上就是一个平面,配上完全垂直的墙和始终与地面平行的天花板。 这让渲染比真正的 3D 引擎简单得多:
- 绘制所有墙(从前往后,如前文所述)
- 还没画到的部分,不是地板就是天花板,把它们画上。
- 精灵(怪物、桶、道具)都是始终面向你的平面贴图(想想纸板剪影),所以不需要复杂的变换(它们与墙重叠时除外,后面会讲)。
墙体
一面墙占据屏幕上若干连续的列,在每一列内是一段连续的像素。
所以我们可以用 generate_series() 展开行和列,从前往后一面一面地画墙:
columns AS ( -- 为墙 w 覆盖的每个屏幕列生成一行
  SELECT w.*, x AS col_x, ...
  FROM wall_parts_tex w
  CROSS JOIN LATERAL generate_series(
    GREATEST(0, FLOOR(w.screen_x1)::int),
    LEAST(screen_w - 1, CEIL(w.screen_x2)::int)) AS x
),
fragments AS ( -- 该列中墙覆盖的每个像素生成一行
  SELECT c.col_x AS x, y, c.depth_x AS depth, c.u_i, c.v_i
  FROM clamped_spans c
  CROSS JOIN LATERAL generate_series(c.y_start, c.y_end) AS y
)
原版 Doom 用的是两个循环:R_RenderSegLoop 遍历屏幕列,R_DrawColumn 绘制像素。
绘制墙体平均花费我们 1.7 毫秒。
Visplanes
墙画完了,接下来聊聊有趣的部分:地板和天花板,Doom 里称之为 visplanes。
不幸的是,Doom 的渲染算法很难直接移植到 SQL,因为它具有强烈的命令式特征:
Doom 维护了两个数组 ceilingclip 和 floorclip,每个屏幕列各有一条记录。
它们标记每列中尚未渲染的“开放”区域(即还需要绘制为地板或天花板的部分)。
每当绘制一面新墙时,这两个数组会被修改,直到所有像素被填充完毕。
Doom 不仅会修改这两个数组,而且修改的顺序至关重要。这设计得很巧妙!归根结底,这只是个泛洪填充(flood fill)算法,但基本上就免费获得了 3D 视觉效果(当然,前提是用 C 语言实现)。
SQLDoom 必须用不同的方式处理这个问题,因为 SQL 没有循环或可变状态的概念。 所以我们不循环,而是对排序后的结果集进行排序和聚合——一种穷人式的循环!
这里遍历的对象被称为面板(panels):墙面在屏幕某一列中显现的某一部分。
有些面板负责绘制内容:实心墙(solid)、门上方的墙面(upper)、或窗户/女儿墙下方的墙面部分(lower);有些面板则只用来影响其他面板的渲染方式:例如你站在阳台下方的门口,上方有遮挡物,而它得在某处结束。
因此,对于每个屏幕列(col_x),我们都有一份从近到远的面板有序列表。
某个面板之前的裁剪状态,完全由它前面那一行的数据定义。难道我闻到了窗口函数的味道?
光用文字解释这块相当困难,咱们直接看视频吧! 您的浏览器不支持视频标签。
使用窗口函数确定视平面(visplanes)的位置下面是(简化后的)SQL 查询:
panel_clips AS (
  -- 1. 记录较近的面板保留下来的带状区域
  SELECT p.*,
    COALESCE(MAX(CASE WHEN part IN ('solid','upper','upper_flush')
                      THEN y_bot::int + 1 END) OVER w, 0)            AS cc_before,
    COALESCE(MIN(CASE WHEN part IN ('solid','lower','lower_down')
                      THEN y_top::int - 1 END) OVER w, screen_h - 1) AS fc_before
  FROM panel_seq p
  WINDOW w AS (PARTITION BY col_x ORDER BY depth_x, bsp_seq, part, seg_id
               ROWS BETWEEN UNBOUNDED PRECEDING AND 1 PRECEDING)
),
plane_spans_raw AS (
  -- 2. 带状区域未覆盖的部分就是墙壁上方的天花板……
  SELECT col_x, fsec AS sector_id, f_ceil AS plane_z, 'ceil' AS plane,
         cc_before         AS y0,   -- 从较近墙壁结束处开始
         f_ceil_y::int - 1 AS y1    -- 延伸至当前面板自身的天花板
  FROM panel_clips
  WHERE part IN ('solid','upper','upper_open','upper_flush')
    AND f_ceil_y::int - 1 >= cc_before          -- 若已完全覆盖则跳过
  UNION ALL
  -- ……以及下方的地板
  SELECT col_x, fsec, f_floor, 'floor',
         f_floor_y::int AS y0,      -- 从当前面板自身的地板开始
         fc_before      AS y1       -- 延伸至较近墙壁结束处
  FROM panel_clips
  WHERE ...
)
首先,对于场景中每一个可能渲染像素的面板,我们计算该列中尚未分配的区域大小。此时仅有可能被分配的像素来自更近的面板(即(1)中的 ROWS BETWEEN UNBOUNDED PRECEDING AND 1 PRECEDING 窗口部分)。
接着,我们从上一个面板的结尾到下一个面板的开头绘制像素(2),天花板和地板均如此处理。
这种将命令式算法伪装成集合操作的方式相当粗糙,好在我们有窗口函数……
渲染地板、天花板和天空通常耗时约 3 ms。
丑陋的部分
很遗憾,我之前骗了大家:墙壁、视平面(visplane)和精灵(sprite)的解析目前还不会真正绘制任何东西。它们只是输出形如 (x, y, depth, colour) 的候选像素,同一位置可能对应多个不同深度的像素。由于我们没有实现 Doom 的定点运算,不同墙壁、地面和天空之间可能会发生重叠。此外,我们还要渲染精灵,而精灵又可能被墙壁部分遮挡。Doom 原本有一套精密编排的逻辑来确保这种情况永不发生,从而省去了 Z-buffer。我尝试在 SQL 中复刻这套逻辑但失败了,索性放弃,改用暴力法:先生成所有候选项,再从中选出胜者。
((LEAST(depth, 131071.0) * 4096)::bigint << 34) -- depth, clamped to 17.12 fixed-point
| ((2 - surface_priority) << 32)                -- wall > sprite > plane
| (LEAST(source_priority, 3) << 30)
| ((stable_id + 32768) << 14)                   -- stable tiebreak
| (light_index << 8) | palette_index            -- the payload
AS winner_key
...
SELECT pix, MIN(winner_key) FROM ranked_fragments GROUP BY pix
这和用 BSP 树的技巧如出一辙:把所有信息打包进一个 bigint,然后取最小值即可。由于最高有效位是深度,直接取 min 就能找到胜者。而且因为 payload(即像素颜色)也包含在 key 中,我们甚至不需要再做一次 join!这招有点取巧,但由于这是逐像素的操作(单帧 Doom 有 320*200=64000 个像素),我们必须小心控制计算量。
即便做了这个优化,它仍是整帧中最昂贵的部分:平均耗时 8.2 毫秒,占整帧时间的三分之一以上。这也正是 John Carmack 当初刻意避开的原因。不过现在运气不错,即便是用 SQL 运行,机器也足以达成 35 FPS 的目标。未来已来,老人家!
渲染性能
下面展示了与 Doom 35 FPS 帧目标对比的流水线瀑布图。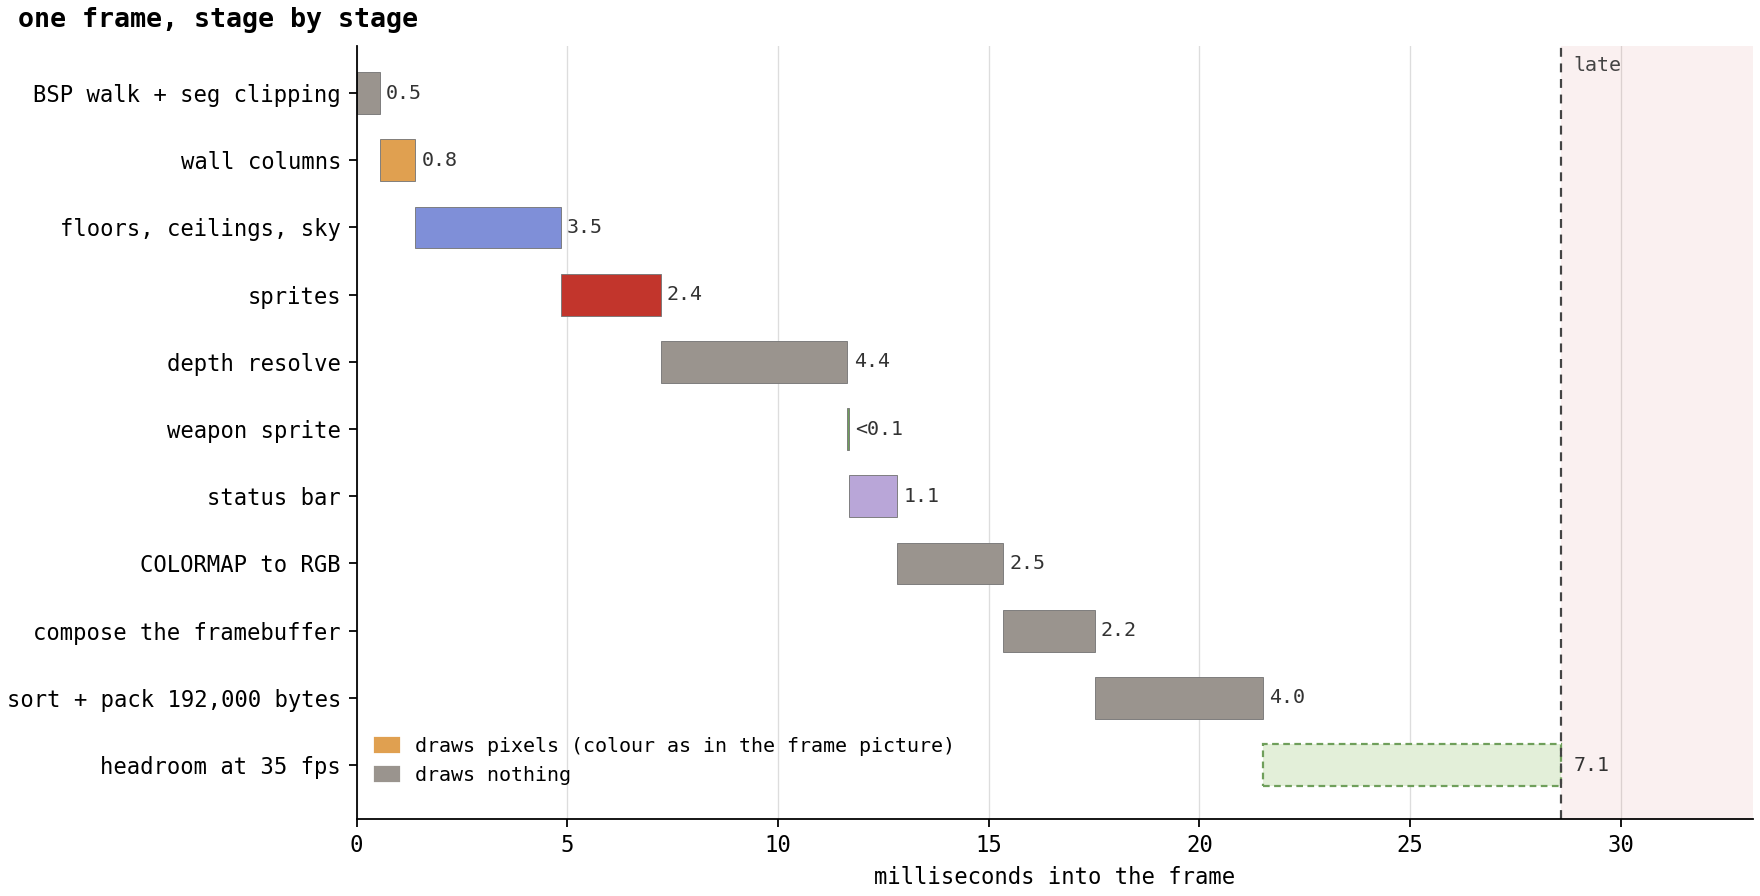
在我的笔记本(Ryzen 7 PRO 7840U)上,通常能跑约 60 FPS,但在画面特别复杂的场景下会掉到 35 FPS。
整条渲染流水线中开销最大的部分(不出所料)是:
- 渲染 visplane(我们需要模拟一个迭代算法)
- 深度解析(原版 Doom 本来就巧妙地避开了这一步)
- 以及所有需要逐像素处理的操作(比如查 colormap、打包 framebuffer)
数据库真正派上用场的地方
在数据库里渲染 Doom 显然是个馊主意。但确实有几个地方,数据库反而是个不错的契合点——这一点我死也要辩护到底!
一切皆数据
把物品的属性翻译成关系型数据集,这种体验的快乐程度出乎我的意料。一方面,你能很清楚地看到游戏里到底装了些什么;更重要的是,改起来也特别方便。
玩家的霰弹枪就是一行记录:
doom=# SELECT name, ammo_type, ammo_per_shot, pellet_count,
doom-#        dmg_dice_count, dmg_dice_mult, max_range
doom-#   FROM weapon_defs WHERE name = 'shotgun';
  name   | ammo_type | ammo_per_shot | pellet_count | dmg_dice_count | dmg_dice_mult | max_range
---------+-----------+---------------+--------------+----------------+---------------+-----------
 shotgun | shells    |             1 |            7 |              3 |             5 |      2048
(1 row)
七颗弹丸,每颗造成 3d5 点伤害。
连动画都是数据!下面就是霰弹枪完整的状态机:
doom=# SELECT state, seq_index AS seq, frame, tics,
doom-#        is_attack_frame AS shoots, refire_check AS refire
doom-#   FROM weapon_frames WHERE weapon_id = 3 ORDER BY state, seq_index;
 state | seq | frame | tics | shoots | refire
-------+-----+-------+------+--------+--------
 ready |   0 | A     |    1 | f      | f
 fire  |   0 | A     |    3 | f      | f
 fire  |   1 | A     |    7 | t      | f
 fire  |   2 | B     |    5 | f      | f
 fire  |   3 | C     |    5 | f      | f
 fire  |   4 | D     |    4 | f      | f
 fire  |   5 | C     |    5 | f      | f
 fire  |   6 | B     |    5 | f      | f
 fire  |   7 | A     |    3 | f      | t
 fire  |   8 | A     |    7 | f      | f
 flash |   0 | A     |    4 | f      | f
 flash |   1 | B     |    3 | f      | f
(12 rows)
万物皆存于表中的特性,让修改几乎所有内容都变得极其容易。 看看下面这段视频,我因为伤害不足感到沮丧,于是直接给霰弹枪打个 Mod,让它一次发射 500 发子弹,扩散角度更大!
当然,我们也可以把所有数据以 JSON 等格式存储在文件里,但那样意味着
- 约束在修改时不会被校验,且
- 必须重载才能生效。
多人联机几乎免费获得
好吧,费这么大劲把 Doom 移植到 SQL,却还没用上数据库最大的优势:免费拥有一个多人服务器! 听我说,我们免费获得了很多传统游戏开发者必须自行构建的东西:
- 身份认证
- 并发控制
- 访问控制
- 游戏状态的一致性快照
- 二进制网络协议
一个独立的 Python referee 脚本驱动共享的 35 Hz 时钟并轮换地图。在线玩家客户端提供输入。
不过,我最喜欢的部分是原子性:每次运行游戏 tick 时,只需执行 begin transaction,最后 commit 即可。
每位玩家(Doom 死斗模式支持最多 4 人)始终获得一致视图:要么是 tick 事务开始前世界的样子,要么是完全提交后的样子。不存在部分更新的逻辑,没有物理 Bug,大家也不会对火箭到底有没有命中产生分歧。
第二个让人惊讶其优雅的点是访问控制。 虽然 sqldoom 本身约有 110 张表和 100 多个函数, 但四种玩家角色仅被允许通过少数几个定义良好的 API 函数与之交互。 我们对其他所有权限直接撤销!
接收玩家输入的 input 函数就是一个很好的例子:
CREATE OR REPLACE FUNCTION api_input(
  p_fwd real, p_strafe real, p_run boolean, p_turn real,
  p_fire boolean, p_weapon integer, p_use boolean) RETURNS integer
LANGUAGE cedarscript SECURITY DEFINER AS $doom$
INSERT INTO mp_inputs
SELECT mp.map_id, mp.player_thing_id,
       LEAST(1.0, GREATEST(-1.0, COALESCE(p_fwd, 0)))::real,
       LEAST(1.0, GREATEST(-1.0, COALESCE(p_strafe, 0)))::real,
       [...]
FROM mp_players mp WHERE mp.role_name = session_user::text;
return 1;
$doom$;
虽然 函数 被允许修改表(security definer),但玩家仅被允许调用该函数。他们能控制的参数包括:前向动量(w/s 是否按下)、侧向移动(a/d 是否按下)、是否奔跑、通过鼠标转向、是否开火、当前选中的武器,以及是否尝试按键或开门(spacebar)。我们甚至无需信任玩家的输入值,因为函数会将输入限制在允许范围内。
多人游戏的性能也出人意料地好:每个客户端分配 3 个核心即可稳定运行在 35 FPS,且游戏 tick 仍远低于预算值。若为 tick 驱动器额外分配 1 个核心,一台 16 核机器就足以运行原版 -altdeath 死亡竞赛模式。
公共实例会循环轮换第一章节的地图,每 10 分钟切换一张新地图。即使四个玩家槽位已满,你仍可通过 SQL 控制台查询实时对局信息。 游玩或查询实时对局 →
彩蛋:编译 SQL
用 C++ 编写的数据库解释执行 SQL,效率肯定极低,无法与 C 语言相提并论? 可能确实如此,但我想评估它到底相差多少。
CedarDB 是一个编译型数据库系统:每个复杂查询都会经过多步流程降低为 LLVM IR,随后编译为机器代码。因此,我提出了一个问题:生成的机器代码与原始编译的 linux_doom C 代码有何不同?
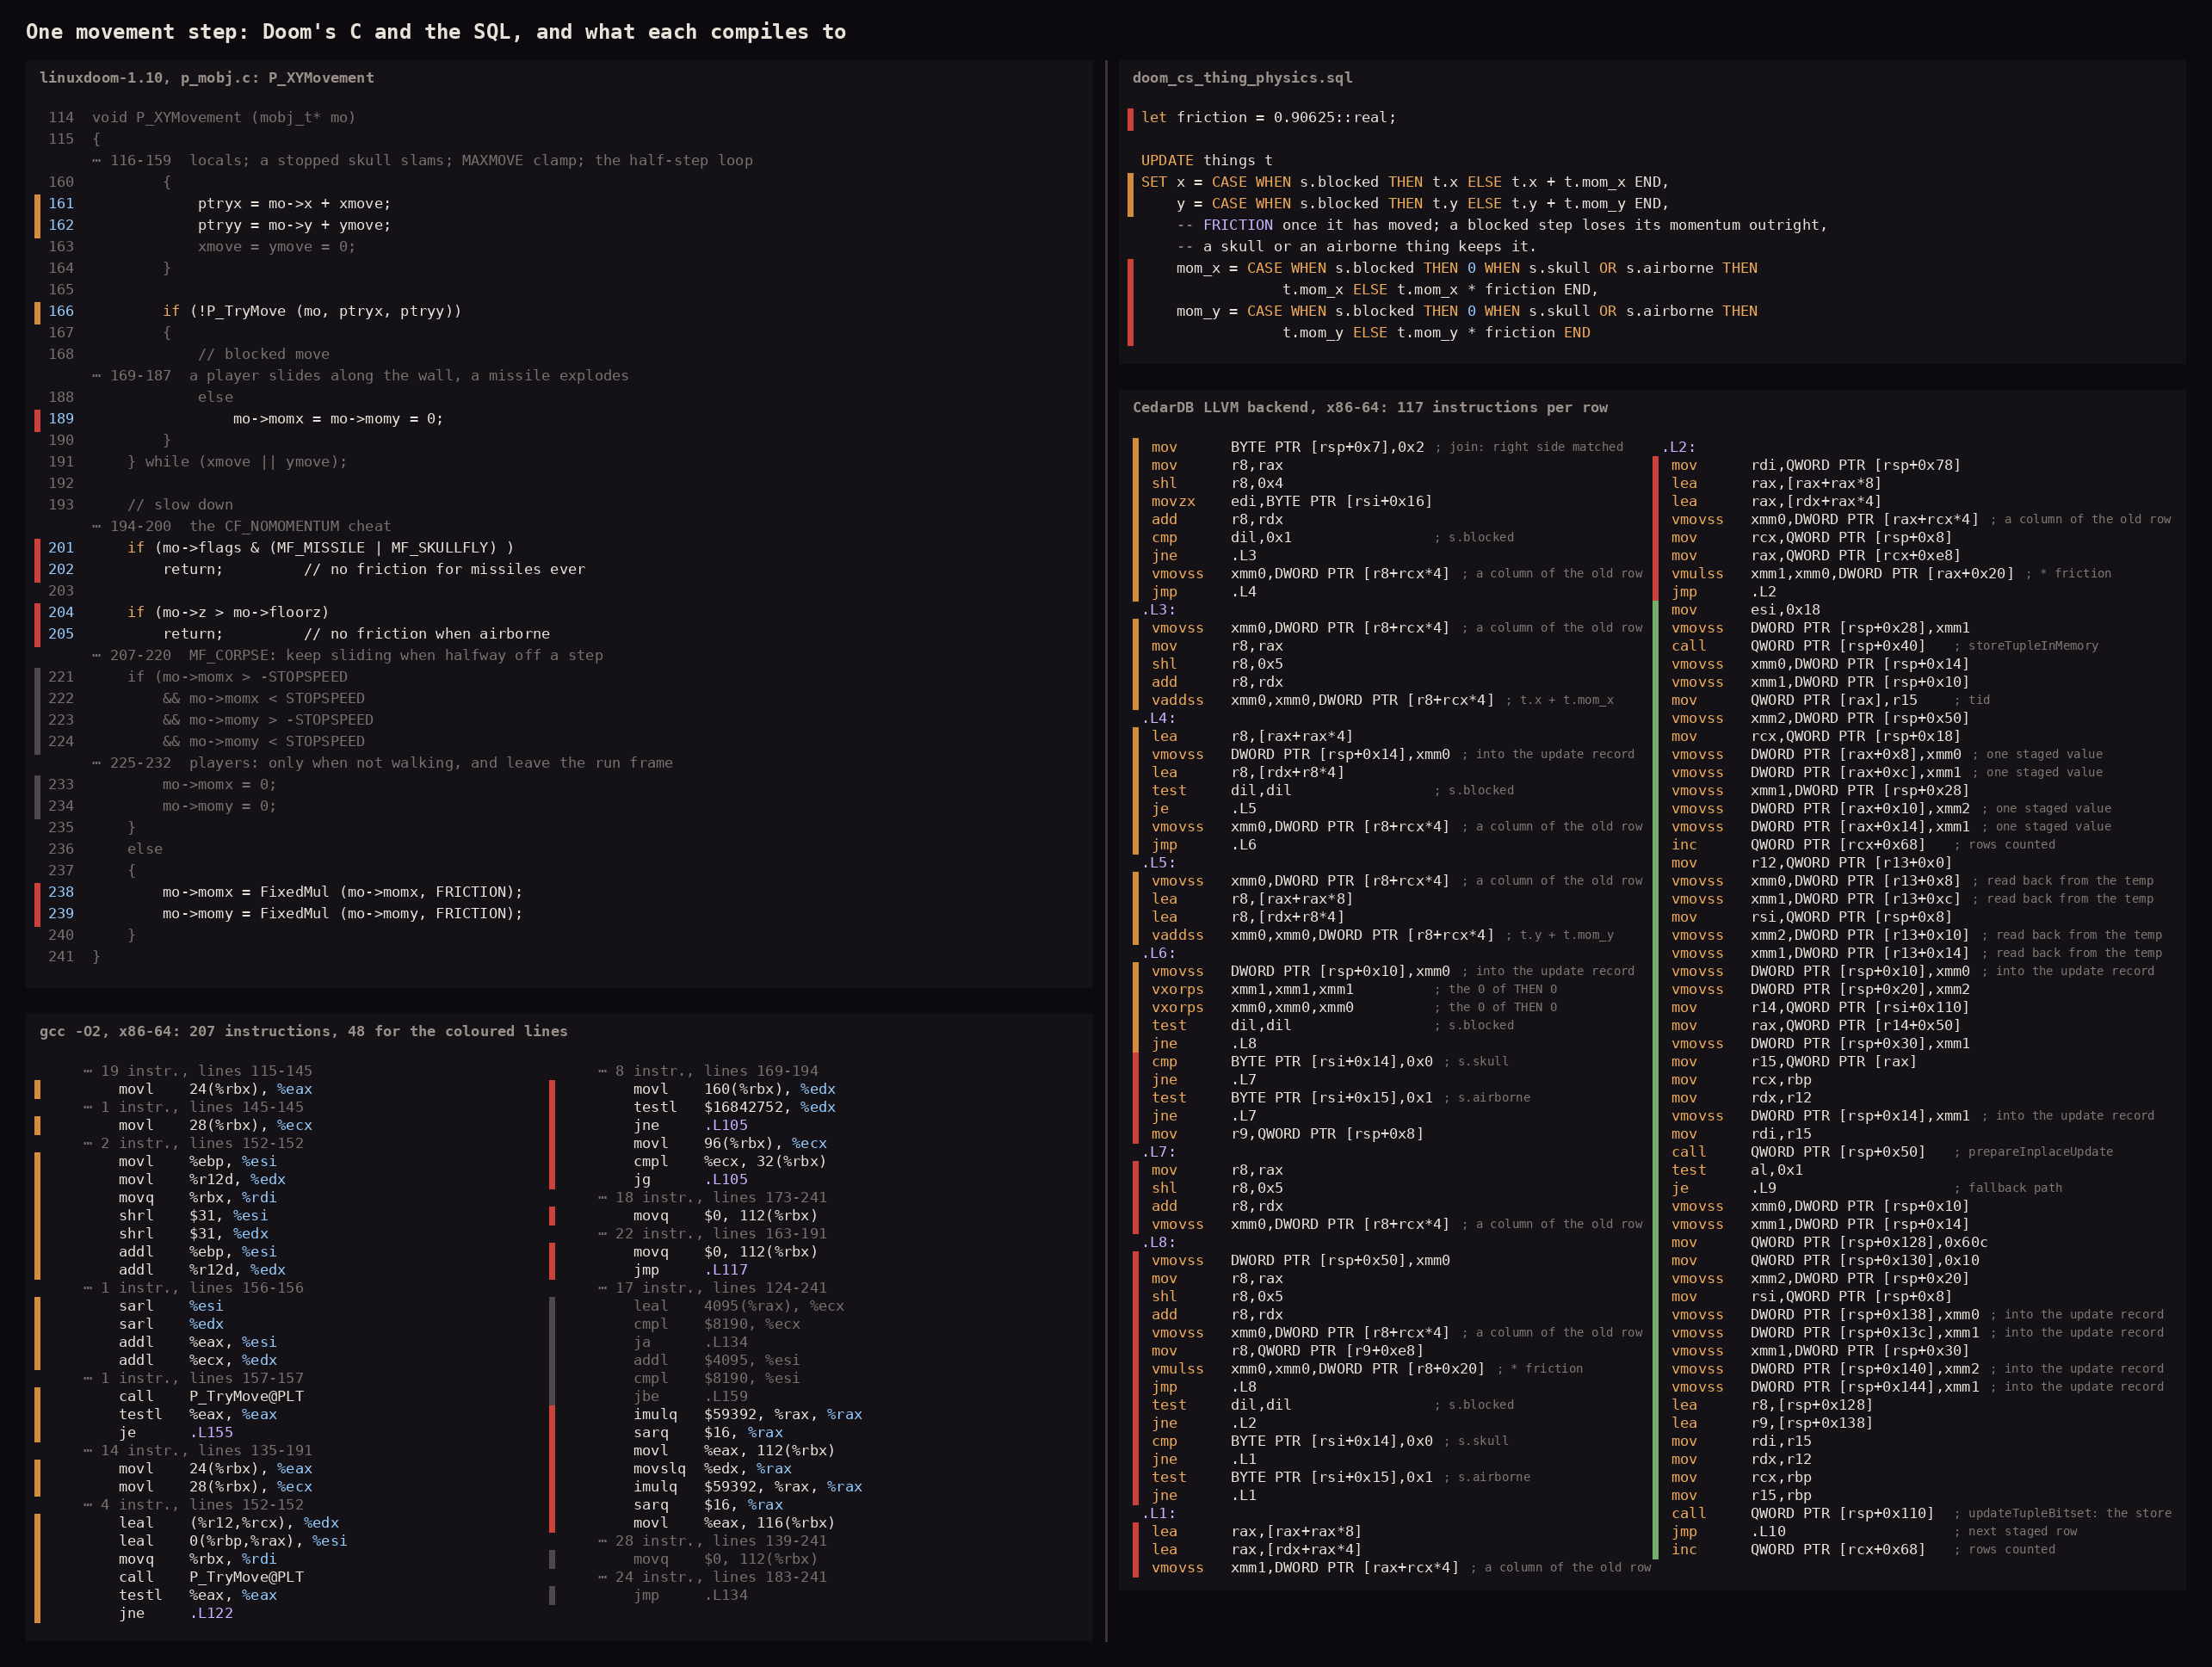
上半部分展示了一个物体的移动逻辑,以及动量对它的影响。左边是原版 Doom 的源代码,右边是 SQLDoom 的实现。两者并不是严格一一对应的,因为逻辑的分布略有不同,但这段 C 代码编译后只有 48 条指令,而 SQLDoom 需要 117 条。其中多出来的指令里有 42 条其实是把结果重新写回表(绿色部分),C 代码自然不需要这一步。所以它确实更慢,这一点要说明白,但考虑到 SQL 和 CPU 之间通常隔着好几层抽象,这个差距其实不算太大。毕竟这段代码从 SQL 出发,经过查询优化器,最后才到 LLVM,能有这样的表现已经出乎我的意料了。
John Carmack 是个天才。
不信的话,拿 SQLDoom 和它那个类似 Wolfenstein 3D 的前辈 DOOMQL 比比看: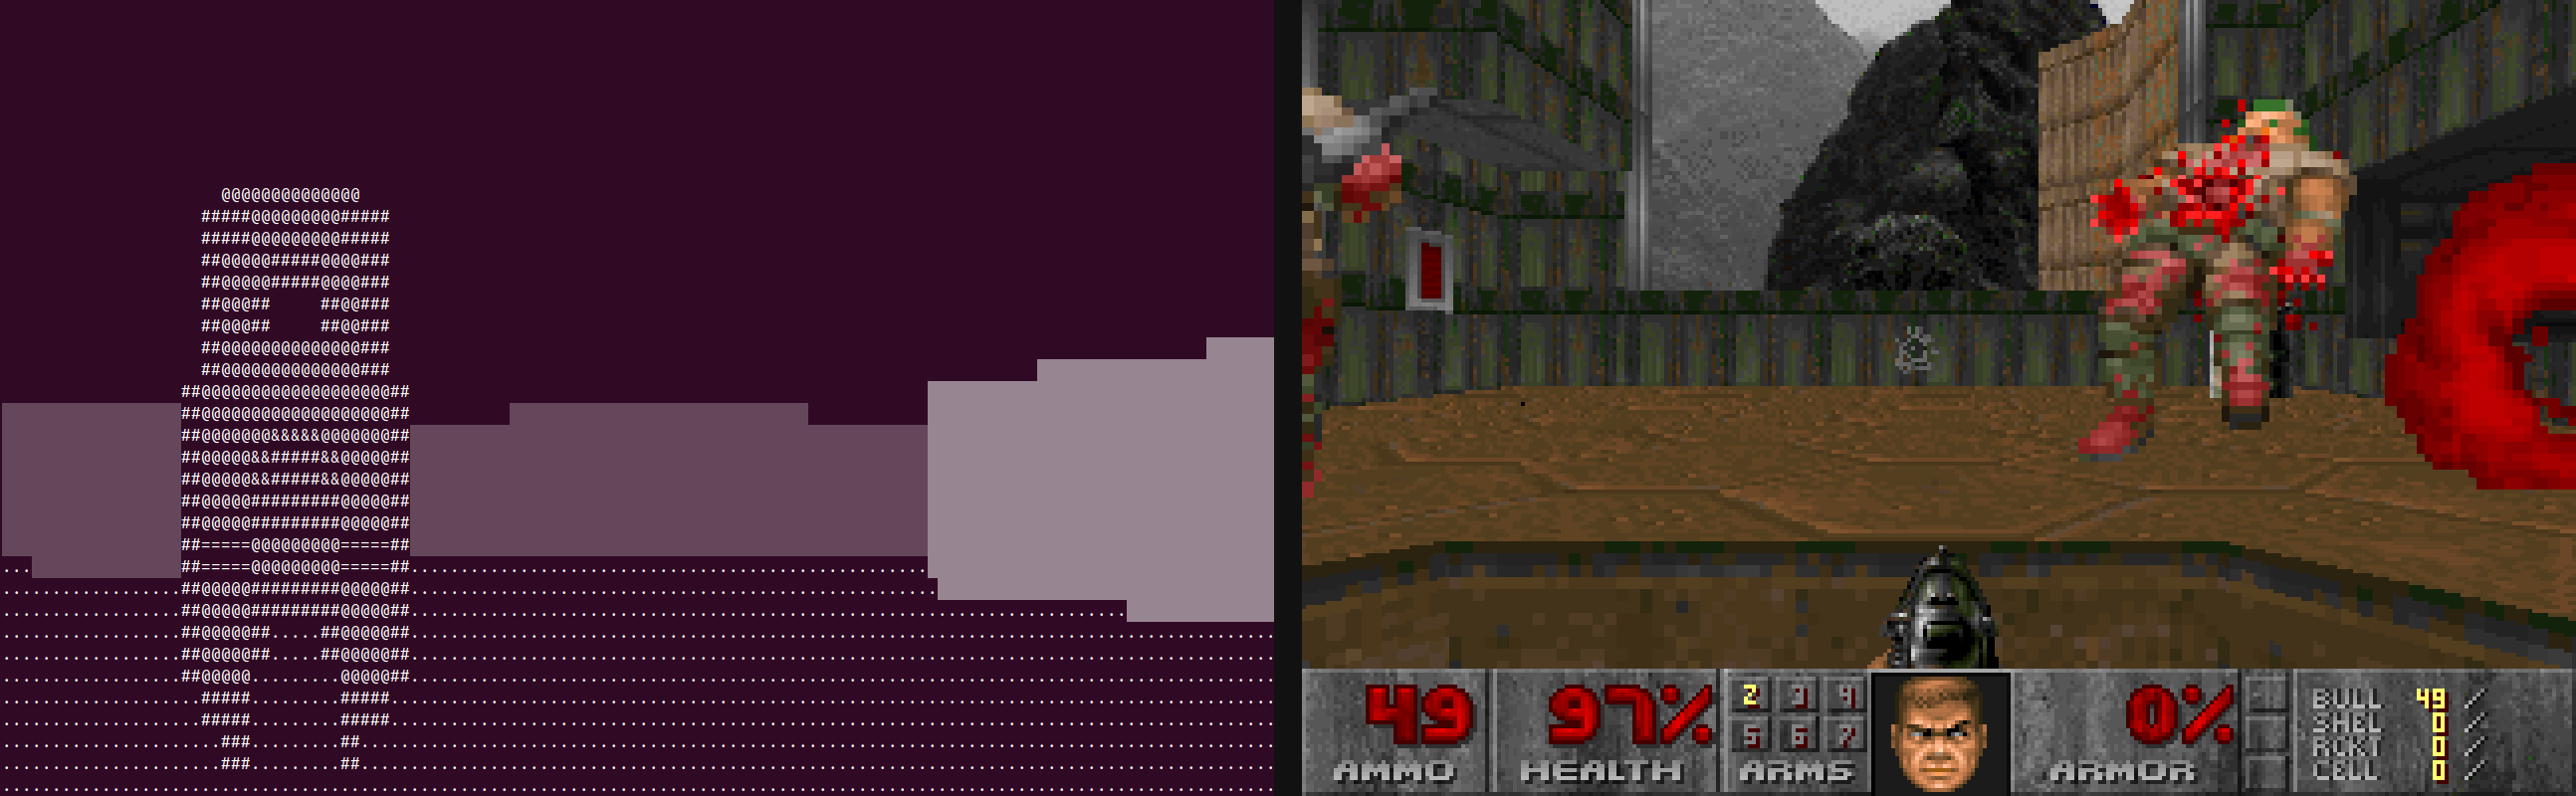
两者用的是同一个引擎、同样的约束:输入是 SQL,输出是位图。必须承认,DOOMQL 那种朴素的 raycasting 方案很了不起——用 SQL 表达起来容易得多,步骤之间的依赖也更少,天生更适合 SQL 基于集合的处理方式。
但事实证明,“最合适”的方案未必是效果最好的方案。SQLDoom 的 BSP-tree 方案不仅快得多,画面精细度还更高。这一切都要归功于 John Carmack 当年苦心钻研,靠一点障眼法就榨干了 486 的性能。
另外说实话,CedarDB 也跟上了时代的脚步。我做 DOOMQL 的时候,引擎还慢了不少,也还没有基于角色的权限系统。
如何自己运行
项目托管在 Github 上:github.com/cedardb/sqldoom。
你需要准备三样东西:
- CedarDB Community Edition;
- 装了
psycopg2和pygame的 Python; - 还有一个我没办法提供给你的 Doom IWAD。共享版的 doom1.wad 可以自由分发(
apt install doom-wad-shareware),足够玩第一章;如果你拥有零售版 WAD,也可以直接使用。
之后就照着 README 操作,很快就能跑起你自己的 SQLDoom 了!
如果觉得自搭太麻烦,直接加入公共实例的多人游戏:
加入游戏 · 🇪🇺 欧洲 加入游戏 · 🇺🇸 美国