
AI写标书:哪些判断该交给大模型,哪些不该
点击下方名片关注「AI 硅基科技分享」,第一时间获取前沿 AI 行业资讯、技术拆解干货!
AI 写标书:哪些判断该交给大模型,哪些不该
一个做投标文件(标书)的 AI 系统,把它流程里那些"判断"从大模型身上拆了下来。以前要让大模型生成一段结论、再从这段文字里解析出结果,现在改成直接算出一个带概率的答案。作者公开的项目复盘里,合规检查这一环从 21 次模型调用降到 1 次,整批耗时从几十秒到十几分钟压到不足一秒,省下来的是量级。它的可复用之处是一条原则:系统里能被枚举的判断题,不该再用大模型去"写"。
这套系统叫 BidMaster-Pro ,是一个开源的 AI 招投标平台。它把招投标拆成四段流水线:招标解读、投标生成、投标检查、文档排版,底下靠三个引擎撑着——大语言模型、 RAG 知识库、可插拔的技能引擎。其中一项核心功能是 21 项合规检查,逐条核对保证金、签字盖章、投标有效期、资料一致性、报价合理性等。
问题就出在这些检查上。它们的答案空间本来就很小:某份招标文件属于哪个行业、某条要求满不满足、这份标书该用哪种生成模式。可系统当时仍走完整的大模型生成流程——模型先写一段话,再从文字里解析出 JSON 或字段,最后做格式校验。代价是三重的:为了说清结论要额外生成解释性文字, token 消耗大;生成的解释有时和它自己的结论对不上;生成是逐字的,延迟被拖高。作者把这个现象说得很直:要的其实是一个判断,系统却让模型写了一篇文章。
重构的做法,是把这层判断从大模型里解耦出来,分成三层:大模型负责理解招标文件和生成正文内容,决策模型负责各种判断,代码负责控制流程。作者用的决策模型是 TypeSafe AI 的 Jev ,它不生成文字,只接收现场信息加一组带类型的问题,一次性返回带概率的答案。作者定的分工原则是:代码拥有工作流,决策模型提供判断和置信度,大模型负责内容生成。
具体换了哪些环节,这张清单本身就是"哪些判断适合直接算"的样板。
• 招标文件分类:从"让大模型生成分类文本"改成从行业、采购方式、紧急度等预设选项里选一个;
• 21 项合规检查:每一项拆成一个"是/否"判断, 21 项并行、一次算出,不再逐条让大模型写解释;
• 正文生成模式选择:从硬编码规则改成从四种模式里选一个;
• 文档段落分类:用同一个判断模型替代原来那套需要单独训练和维护的分类小模型,段落分七类(标题、摘要、正文、表格标题、图片说明、列表项、签署区);
• 风险等级、方案完整度、商机匹配度:改成在自定义的等级刻度上打分,再配一个"是否存在致命问题"的是非判断。
省下来的时间从哪来?机制在于问题之间是并行求值的:同一个现场信息配上一组问题,多加几个问题几乎不增加等待。这正是"21 项检查 = 1 次调用"能成立的机制来源。
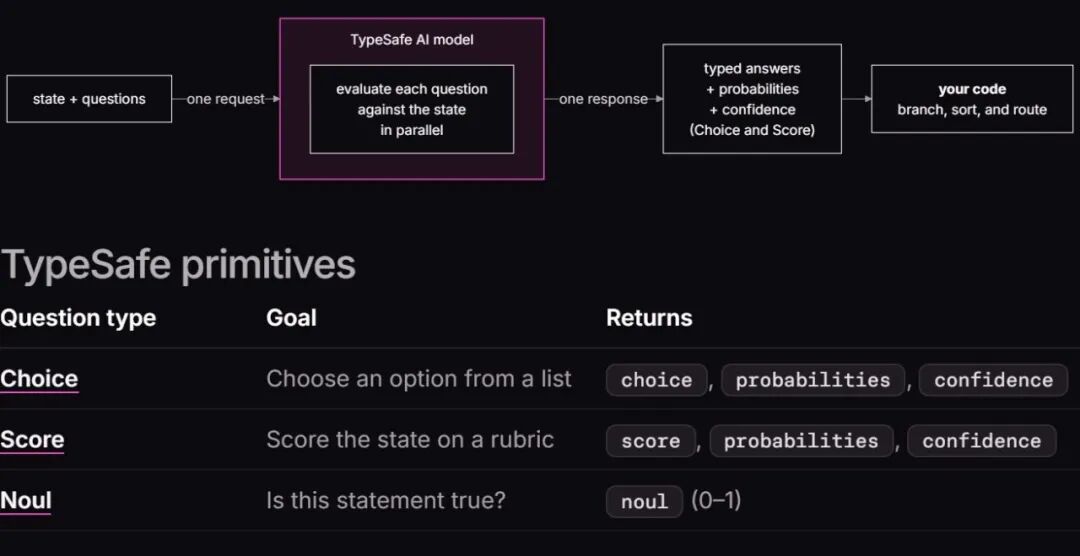
官方文档列出三种「判断原语」——Choice (选择:从给定选项里选一个)、 Score (打分:按评分标准给分)、 Noul (是非:判断一句话真假)。右侧 Returns 是各自返回的字段: Choice 返回选中的选项、各选项概率与置信度; Score 返回分数、概率与置信度; Noul 只返回一个 0 到 1 的概率值。上方示意图讲的是它的调用形态:把现场信息和一组问题一次送出,模型并行求值、一次返回带概率的结构化答案。
收益账要分成两笔看。一笔是机制账:问题并行、单次前向返回,这部分是可核的。另一笔是作者自己的测算: 21 项检查的耗时从原来的 42 到 630 秒,压到 0.07 到 0.5 秒,约一百到一千倍;成本因为不再生成解释性文字、只算输入,降低九成以上。这些倍数出自作者本人的项目口径,不是第三方复测的结果,看的时候要带上"这是作者测算"这个前提。
判断拿到了,还得决定"信到什么程度才敢自动放行"。作者给每个判断的概率配了阈值,把结果分成三条路:概率足够高就自动通过,足够低就自动判不通过,落在中间那段不确定区间的,转人工复核。所有阈值和问题集中放在一个文件里,方便人工审查。
但阈值这里有个坑,作者专门提醒了一句,也是最容易被忽略的一点:判断返回的那个数,不等于准确率。具体还要分开看: Noul 只有那一个 0 到 1 的概率值,没有单独的置信度字段; Choice 和 Score 才另带一个置信度,它由概率分布的集中程度算出,同样不代表"报了 0.9 就必然有九成准"。还有一处容易误读: Noul 报 0.5 不代表"中等强度",它的意思是模型不知道。所以阈值必须拿自己的招投标业务数据现场校准,不能照搬别人的数字。
这篇复盘里分量最重的,是作者花了大篇幅划的能力边界。这套"直接算判断"的方案不是万能钥匙,有几类环节他明确留在原地。
一是不会算。报价计算、税率、日期差这类精确计算,留在代码里,不交给判断模型。二是不会数。像"这份招标文件一共有多少条要求"这种计数,它做不可靠;正确做法是代码负责遍历,模型只对每一条单独做语义判断,再由代码加总。三是只顾字面。中文里的模糊表述容易被误判,对策是把问题措辞写得具体,把边界情况直接写进选项里。
四是中文支持弱于英语,这一条对国内团队是硬约束。 TypeSafe 官方文档写得很直白:英语是主要训练语言,包括中日韩在内的其他语言"可以处理,但效果并不均衡",非英文的工作负载要先用你自己的内容测过再上,并且路由时要特别关注置信度。这一条之所以关键,是因为这套模型的核心卖点恰恰是"概率校准":报 80% 就该真的对八成。而在一个训练不充分、被官方点名"效果不均衡"的语种上,校准本身就会退化,"报得准不准"这件事会先松动。作者给中文场景的处置是三步:先拿 10 到 20 份真实中文招标文件验证准确率;如果中文下置信度普遍偏低,就相应调整阈值;必要时考虑 Laya 这类多语言开源模型作为补充。
五是不做生成。正文内容仍由大模型负责,判断模型碰不了写作。六是对抗性内容。它默认不把输入当作敌对内容,而招标、投标文件里恰恰可能出现"为自己开脱"式的文字,所以边界要在选项里写清,上线前专门测一遍边缘情况。
把这笔账合起来看,落点其实不在"换"这个动作,而在分工的边界。能换的前提是答案有限、可用代码兜底;换不了的地方,比如精确计算、可靠计数、中文细微语义,不是技术不够成熟,而是这类判断本来就不该指望一个"快速直觉"式的工具去扛。作者最后给的原则很清楚:大模型继续管语义理解和内容生成,判断模型接管所有需要有限选项、快速判断、类型化输出的决策点,代码负责阈值门控、人工复核和业务逻辑路由。这句话本身,就是判断一个环节该不该从大模型里拆出来时,最好用的一把尺子。