
免费API平台推荐-书生·端砚
免费API平台推荐-书生·端砚:每月送 10 墨点,"抵 5000 万 token"那句我拆开算了一遍
导语:这个栏目以后一期只讲一个平台,讲透为止,详细每日免费API盘点,关注回复【免费】获取表格,老粉丝应该都收藏链接了。本期是上海人工智能实验室的「书生·端砚,每月送 10 个墨点,页面上写着"1 墨点最多可抵扣 5000 万 tokens"。这句话不算假,但它走的是计费更省的那条路径。我照着计费表把它换成日常用法,数字差了 200 倍,过程写在下面。同一个实验室还有一条更早的免费通道(书生·浦语),8 月 22 日那期讲过,文末关联一下。
数据交代:额度、限流、模型价格都是我注册登录后页面上实际显示的,浦语那条我也实测过。平台还在测试期,规则会调——你打开时如果对不上,以你页面为准。
一、平台速览
| 项目 | 内容 |
|---|---|
| 注册 / 领取 | https://discovery.intern-ai.org.cn (微信扫码登录 → 左侧「科研模型」→ 创建 API Key) |
| 接口地址 | OpenAI 协议:https://discovery-api.intern-ai.org.cn/v1;Anthropic 协议:https://discovery-api.intern-ai.org.cn(不带 /v1) |
| 补全端点 | https://discovery-api.intern-ai.org.cn/v1/chat/completions |
| 文档 | https://discovery.intern-ai.org.cn/token-plan/home?tabIndex=3 |
| 免费额度 | 每月 10 墨点(测试期间) |
| 限流 | RPM 50 次/分钟、TPM 200 万 token/分钟,所有 API Key 共享、合并计算 |
| 身份门槛 | 无,不限科研身份 |
它是谁:不是国企也不是民企,背后是上海人工智能实验室——我国人工智能领域国家层面的新型科研机构。"书生"是它研发的大模型体系,联合商汤、清华、港中文、上交等共同发布,已通过国家备案。
端砚是它今年推的科研全栈平台,在生命科学、关键材料、半导体、核聚变、量子、地球气象六个方向落地,做的是干湿实验闭环那一套;配套的调用额度体系叫「墨点计划」(Token Plan),9 月 13 日浦江创新论坛官宣。算力上走的是国产 + 英伟达双轨,推理主力压在国产芯片这边——昇腾、沐曦两家是核心,自研的 DeepLink 方案还能把昇腾、沐曦、平头哥、壁仞、海光混着调度。
它的本命用户是科研人员,但领额度这件事没有身份限制。
二、"5000 万 token"是怎么算出来的
端砚给 DeepSeek-V4-Flash 的报价是这样的(每百万 token):缓存命中输入0.02 墨点、未命中输入1 墨点、输出4 墨点。
拿 0.02 去除 100 万,正好是 5000 万——宣传里那句话就是这么来的。
但日常调用走的是另外两条路径。同样一个墨点:
| 用法 | 1 墨点可抵 |
|---|---|
| 缓存命中的输入 | 5000 万 token |
| 普通(未命中)输入 | 100 万 token |
| 输出 | 25 万 token |
所以 10 个墨点的实际量级是1000 万普通输入,或者 250 万输出。按一次问答 800 输出 token 估算,三千次上下——查资料、写周报、翻文档,一个月够用;挂在 AI 编程上重度跑,一周见底。
顺带说一个我在对账时发现的巧合:把端砚的墨点价和几家厂商的人民币公开价摆在一起,几乎是一比一对上的(DeepSeek-V4-Flash 0.02 / 1 / 4,GLM-5.3 输出 28,Kimi-K2.6 输出 27)。也就是说1 墨点大致等值 1 元,10 个墨点相当于 10 元钱的购买力。用这个口径反推:10 元 ÷ 4 元每百万 = 250 万输出,和上面算出来的一致。
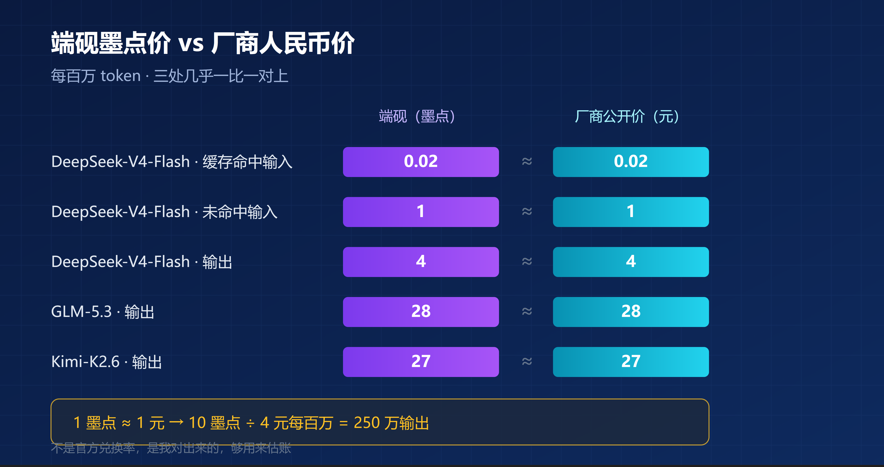
这不是官方宣布的兑换率,是我对出来的,够用来估账。
三、模型怎么挑
平台上架 10 个模型,DeepSeek、GLM、Kimi、MiniMax、Qwen 和实验室自家的都有,其中 DeepSeek 系、GLM-5.3、MiniMax-M3 三个是 1M 上下文(完整清单和墨点价见文末附表)。
我自己的分法是三档:
- 日常主力:三个标着「限时 0 墨点」的自家模型——书生-S2、Atria-Dawn-Preview、Agents-A1,调用不扣额度,也没写截止日期。书生-S2 是科学多模态模型,日常问答和长文分析照样能干,重活我都往这边放。
- 补位:DeepSeek-V4-Flash,同档里更省的那个,10 个墨点主要花在这。
- 少碰:GLM-5.3 和 Kimi-K2.6,输出一百万 token 要 27~28 墨点,比 Flash 贵 7 倍,10 个墨点经不起几轮。
四、三个 0 墨点模型,到底能干什么
这三个才是这份额度里真正值钱的部分,不扣墨点,就没有"用完"这回事(前提是规则不变)。而且它们都不是凑数的。
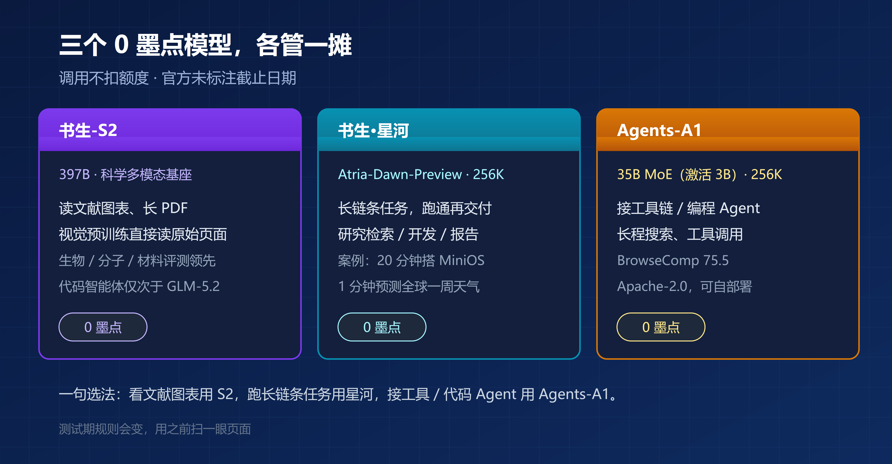
书生-S2(Intern-S2-Preview-397B):397B 的科学多模态基座,权重开源。架构上把"记忆"和"思考"拆开了,接新知识不用重训整个底座;视觉预训练是直接读原始文献页面,不是先转成文字。官方评测口径里,生物序列(Biology-Instructions)、分子(Mol-Instructions)、材料(MP20)这几项领先开闭源旗舰;代码智能体方面,TerminalBench2.1、SWEBench-Pro 上优于 Kimi-2.7-Code 和 DeepSeek-V4-Pro,仅次于 GLM-5.2。→拿它干什么:带图表的论文、长文档、PDF 分析,我基本都丢给它。
Atria-Dawn-Preview(书生·星河):实验室联合复旦、中科院软件所等推出的智能体模型预览版,主打把开放性问题推到"能跑、能验证、能复现",覆盖四类场景:深度研究与检索、软件与应用开发、报告类交付、网络安全分析。上下文 256K,权重开源(有 FP8 版)。→什么水平:官方给的两个例子挺直观——20 分钟搭出一套 MiniOS、1 分钟预测全球未来一周天气。(顺带记一个对不上的地方:官方新闻稿说它基于书生-S2 Preview,魔搭模型卡上写的底座却是 744B MoE 的 GLM-5.2。两处口径不一致,我判断不了,想深究的去看模型卡。)
Agents-A1:35B 的 MoE(激活 3B),Apache-2.0,256K 上下文,专做长程智能体——长程搜索、工程、科研、指令遵循、工具调用。厂商自报的几项成绩:BrowseComp 75.5、长程搜索 Seal-0 56.36、指令遵循 IFBench 80.61。7 月发布,官方称上线 10 天内社区衍生模型超过 70 个。→35B 的体量在三个里不算大,但恰恰适合接进工具链和编程 Agent:轻、上下文长、能调工具。
一句选法:看文献图表用 S2,跑长链条任务用星河,接工具/代码 Agent 用 Agents-A1。
五、限额和几个我记下的细节
- 墨点有两道闸:5 小时 10 墨点、7 天 50 墨点,页面会显示重置时间;用完直接拒绝新调用。
- 所有 API Key 共享账户额度、合并计算,多建几个不会变多。要提额可以发邮件到
tokenplan@pjlab.org.cn。 - "测试期间"这四个字我一直盯着——这是冷启动期的补贴,规则会变,我在工作流里给它留了 fallback。
- 公司代码、用户数据、未公开实验结果,我是不往任何公共平台传的,这条对哪家都一样。
六、关联:同门师兄书生·浦语(8 月 22 日讲过)
同一个实验室还有一条更早的免费通道——书生·浦语(InternLM),8 月 22 日那期专门拆过,这里只回顾不展开:
| 项目 | 内容 |
|---|---|
| 领取页 | https://internlm.intern-ai.org.cn/api/tokens |
| base_url | https://chat.intern-ai.org.cn/api/v1(是 chat 域名,不是 internlm 那个门户域名) |
| 免费额度 | 每月 9000 万 input tokens + 9000 万 output tokens,次月刷新 |
| 免费模型 | intern-latest、internvl3.5-latest |
一个容易打架的口径:8 月那期我写的"每月 1.8 亿 token",今天写的是"9000 万 input + 9000 万 output"——是同一件事,前者是输入输出相加,后者是分开设的两条额度线。看到两种说法别以为额度变了。
两条通道的区别:浦语按 token 计,量大但只有自家模型;端砚按墨点计,量小但能调别家旗舰。
附:模型清单与墨点价格
表一 · 端砚模型与计费(每百万 token,墨点)
| 模型 | 输入(缓存命中) | 输入(未命中) | 输出 | 备注 |
|---|---|---|---|---|
| DeepSeek-V4-Flash | 0.02 | 1 | 4 | 1M 上下文,报价完整,本文按这个算账 |
| GLM-5.3 | — | — | 27~28 | 1M 上下文,输出档位偏高 |
| Kimi-K2.6 | — | — | 27~28 | 同上 |
| MiniMax-M3 | — | — | — | 1M 上下文,以页面显示为准 |
| Qwen 系 | — | — | — | 以页面显示为准 |
| 书生-S2 | 0 | 0 | 0 | 限时 0 墨点;397B 科学多模态基座 |
| Atria-Dawn-Preview | 0 | 0 | 0 | 限时 0 墨点;智能体预览版,256K |
| Agents-A1 | 0 | 0 | 0 | 限时 0 墨点;35B MoE 长程智能体,256K |
("—"是我没逐项记录的档位,不是免费。测试期价格会调整,用之前扫一眼页面。)
表二 · 墨点换算速查
| 1 墨点 | 换到的 token |
|---|---|
| 缓存命中的输入 | 5000 万 |
| 普通输入 | 100 万 |
| 输出 | 25 万 |
| 10 墨点(一个月) | 换到的 token |
|---|---|
| 都走普通输入 | 约 1000 万 |
| 都走输出 | 约 250 万 |
一句话结论
同类的免费额度里,这份我是愿意推荐去领的:零门槛、每月循环发、能调别家旗舰、还有三个不扣额度的自家模型垫底——这四条凑齐的不多。要记住的只有一句,它还在测试期,规则会变。
具体怎么用:真正能长期持有的不是那 10 个墨点,是三个 0 墨点模型 + Anthropic 协议直连——能自定义 Base URL 的客户端(Claude Code、Codex 之类)把地址粘进去就能用,不用改代码。墨点那部分当零花钱花,重活压在 0 墨点的模型上,一个月能过得很宽裕。
📌关注后回复【免费】,获取免费 API 平台整合链接。
下一期换另一个平台。