
AI Agent 不需要记忆,需要的是文档
记忆插件会分析你的对话,生成 1000 个孤立的片段并插入向量数据库。每次你发出提示时,它都会附带相似度最高的 5 个片段;如果代理感到困惑(通常都是如此),它还会手动搜索更多内容。这就是它们所谓的“记忆”产品。
一旦思考你真正要解决的问题,使用这种方法显得颇为怪异。你希望代理理解你的项目,知道某个功能在哪里、为什么构建、你达成了什么共识以及你关注什么。结果,你得到的只是每次提示都注入的一堆 RAG 片段抽奖,祈祷正确的片段能浮出水面。
即便它有时奏效,代理依然无法理解你的项目。整个记忆插件生态都在解决错误的问题。
因为代理不需要记忆,它们需要的是文档。
本质上都是 RAG
市面上所有的记忆插件工作原理都相同:
- 遍历会话记录
- 生成“记忆”片段
- 插入 RAG 数据库
- 每次提示时,检索前 5 条并注入
- 需要更多?给代理一个工具来搜索 RAG 数据库
这就是整套架构。有些工具更花哨,允许代理逐字搜索过往记录;或者实现某种多级记忆系统,区分短期和长期记忆;或者添加一堆后台守护进程来审查、合并或去重记忆。有“做梦者”在夜间重写记忆,还有连续上下文压缩、重排器等,诸如此类。
每个插件都试图通过增加新的消耗 Token 的“功能”来修复底层同一套有缺陷的架构。这就是为什么它们都无法可靠地工作。
召回机制的问题
所有这些记忆插件都存在着一系列共同的痛点。
- 记忆是通过相似度浮出的。 相似度搜索衡量两个片段在嵌入空间中的接近程度,仅此而已。你不知道哪一个是正确的、最新的,或者遗漏了什么。
- 记忆存储时缺乏上下文。 一个 RAG 片段只能包含有限信息。其他一切都会丢失:上下文、动机、教训、环境等等。
- 把过去当作既定事实。这些插件都依赖召回机制,无论是检索聊天记录还是向量数据库。但代码库每天都在变,那些关于认证机制的500段片段,准确率还能有多高?
- 智能体无法检索未知内容。即使你向智能体提供搜索工具,它怎么知道何时该使用?智能体不知道自已不知道什么。
- 存储不可审计。SQLite里存着一万条嵌入向量。哪些记忆存在?哪些已过期?哪些从未被检索过?哪些是错误的且正在暗中影响智能体的行为?
这些只是记忆插件面临的诸多问题中的五个。它们试图修复这些问题却屡屡失败,因为它们都基于同一个假设:
智能体健忘:这才是问题所在。所以解决方案是记住更多。为了记得更好,我们应该捕获更多信息、建立更优索引、实现更智能的检索。
它们的核心论点始终围绕着捕捉和回忆过去。但这并非其他人处理知识的方式。没人会重看三年前的团队会议录像来回忆某个功能的限制条件。人们会把东西写下来,然后使用这些记录。
同理,解决方案并非给智能体一个搜索工具,让它去搜索过去价值千万个Token的对话,拼凑出过往事件的碎片。
真正的解决方案,是基于文档的记忆。
如今,人们利用AI以光速生产产品、功能甚至是低质内容,全程不读也不理解一行代码。在这样的背景下,很容易看出文档正沦为事后补上的内容,尽管它本应比以往任何时候都更重要。
文档优于记忆
人们早就知道智能体需要上下文背景。因此他们发明了AGENTS.md文件:防止智能体盲目地介入代码库。这招很管用。但很多时候,这一个文件就是项目拥有的唯一文档。
单个文件是不够的。智能体需要一个完整的大脑——一个结构化工作区,让它无需指令即可记录指令、规范、决策、调研、索引等任何内容。例如,代码审查流程的说明、记录用户讨论细节的规范、关于外部库或API的可复用调研成果等。
Agent 工作时,可以从大脑里读取文件,获得相关且完整的上下文;工作结束后,趁着全局信息还在上下文里,及时更新过时的内容、补充缺失的文档。这样一来,agentic 循环就从提示 → 构建 → 遗忘变成了提示 → 查阅 → 构建 → 更新。记忆也不再是外挂在 agent 上的 RAG 数据库,而是一个可读、可更新、甚至可以分享的工作区。
实践验证
一年多前刚开始用 AI 写代码时,我就意识到了这个问题。当时我希望 agent 能跨会话记住工作内容,于是建了一个 internal/ 文件夹,让 agent 把所有东西都写进去:规格说明、计划、索引。同时要求它工作前先读相关文档和索引,工作后再更新。
这套简陋的指令慢慢演变成一个正式系统,最终成了一个我一直在所有项目中使用的插件——Operator Memory。
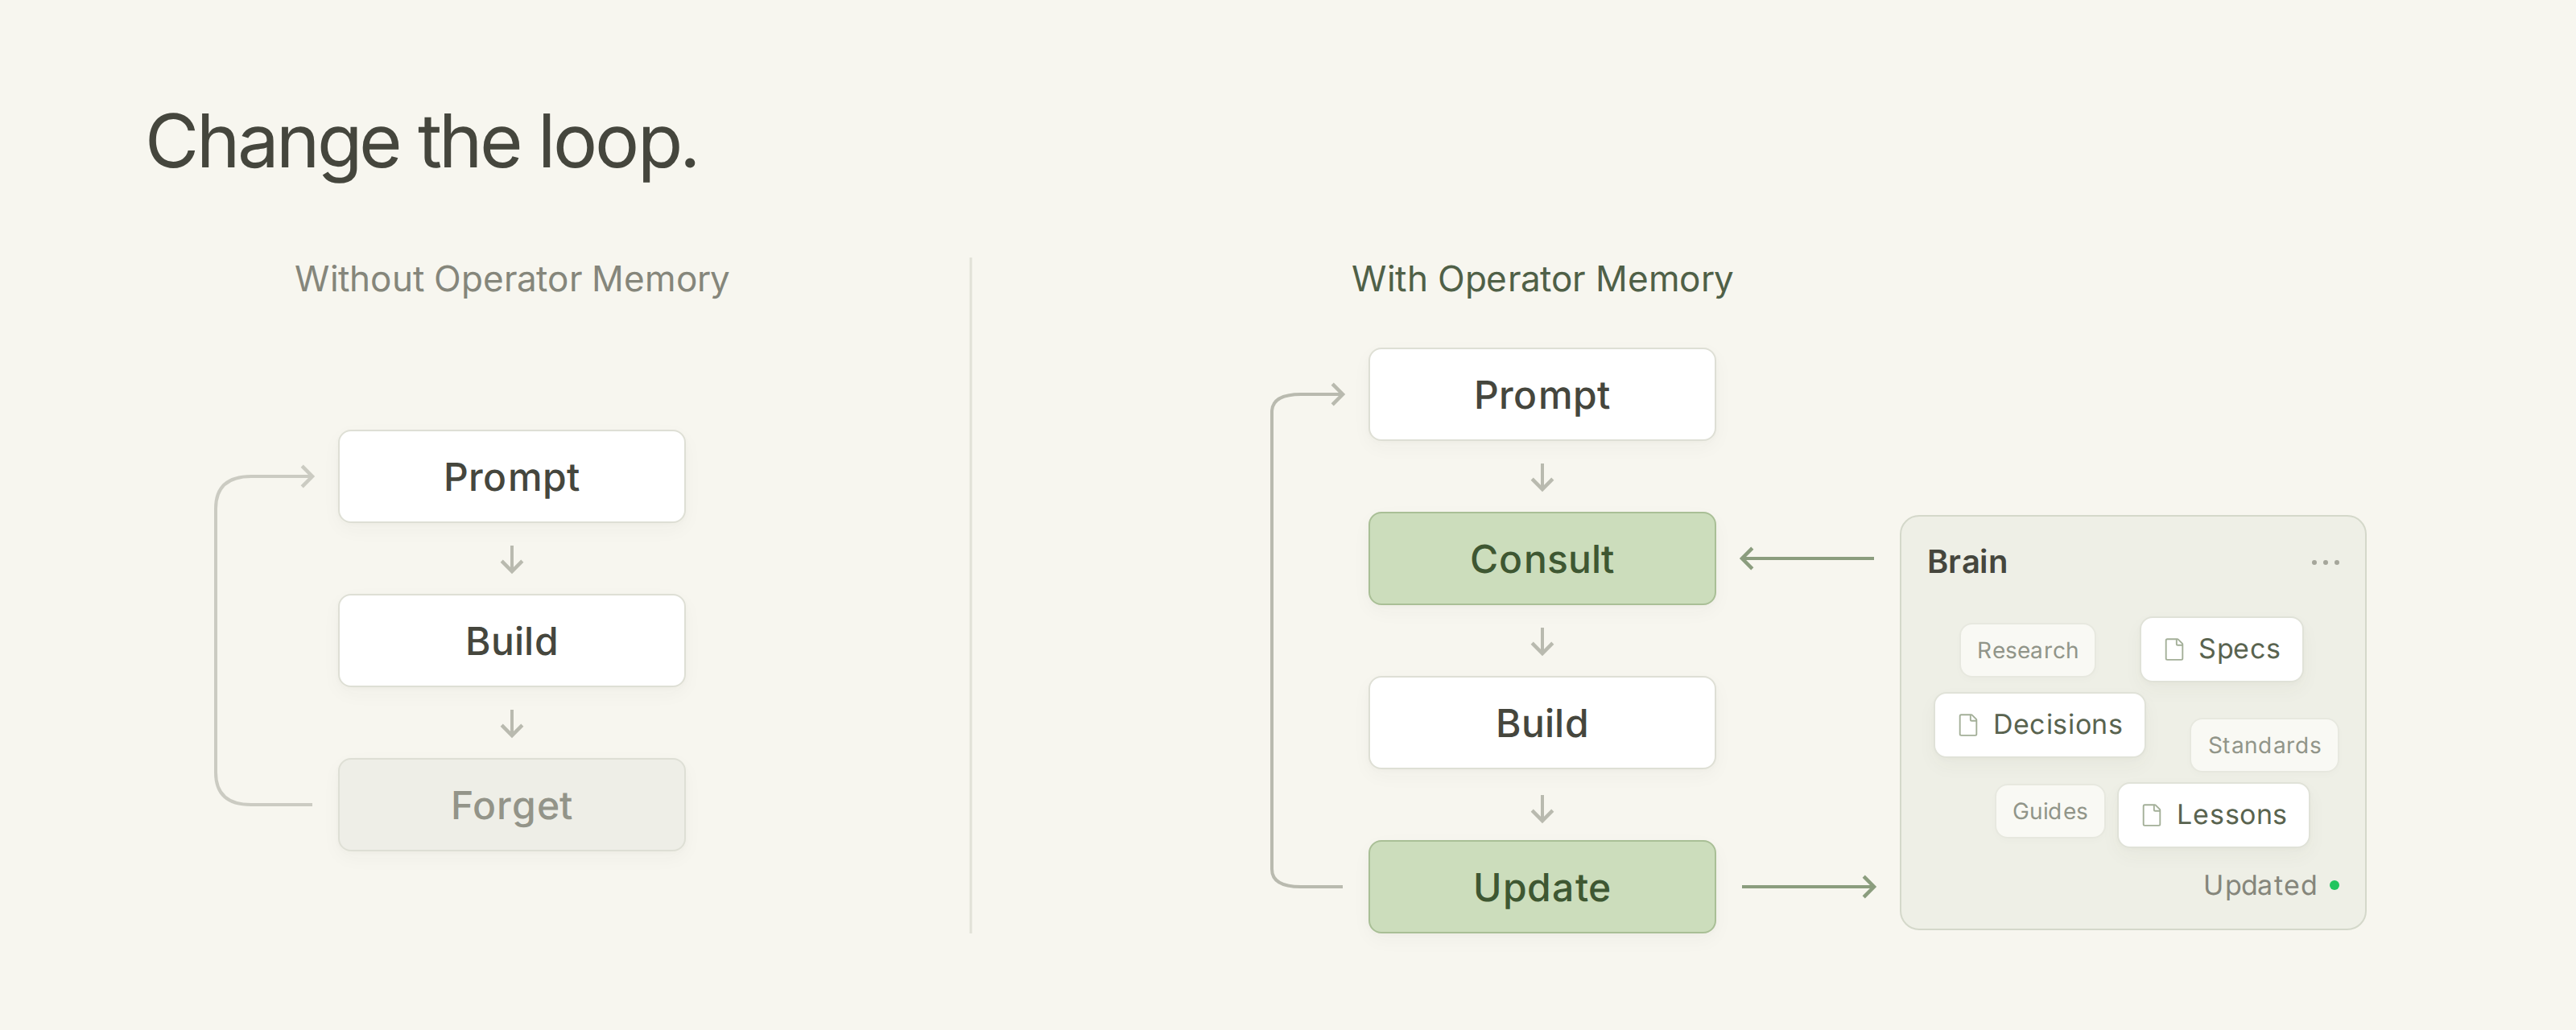
Operator Memory 基于上述模型提供基于文档的记忆能力。它给你的 agent 提供一个 Markdown 大脑,用来持久化重要知识:指令、规格说明、调研笔记、索引。工作前,agent 会先查阅大脑中的相关文档;工作后,agent 会更新大脑——修订过时的文档,补充缺失的文档。
不需要向量数据库,不需要 embeddings,也不需要摘要器、策展器、更新器、做梦器之类的烧 token 后台进程,更没有黑盒检索。
在 Operator 中,一切都是普通的 Markdown 文档,你可以阅读、更新、提交到版本库,还能分享给团队。这套系统我已经用了一年多。想试试的话,它免费开源:https://github.com/aerovato/operator-memory