
最近AIAgent圈子里出现了一个有点“不一样”的模型:Jev
最近 AI Agent 圈子里出现了一个有点“不一样”的模型:Jev。
如果第一次听到 Jev,很多人的第一反应可能是:
“又一个大模型?”
其实不是。
Jev 最有意思的地方,恰恰是它不太想和 GPT、Claude 这类模型做同一件事。
传统大模型擅长的是:
- 写文章
- 写代码
- 总结内容
- 理解复杂问题
- 制定计划
- 和人聊天
而 Jev 更像一个专门负责“判断”的 AI。
比如:
这个请求紧急吗?
这个工具调用安全吗?
这几个工具应该选哪一个?
这次任务应该使用普通模型还是更强的模型?
用户的问题属于哪一种类型?
当前 Agent 是否应该继续执行?
这些事情看起来简单,但在一个真正的 Agent 里,可能会被调用成百上千次。
这也是 Jev 值得关注的地方。
一、先看一个最简单的例子
假设我们正在做一个客服 Agent。
用户说:
“我的订单已经三天没有发货了,明天就是给客户的生日礼物,如果今天还不能发货,我只能退款了。”
传统 Agent 可能这样工作:
问题来了。
每一次“判断”,都让一个大型语言模型来做,真的有必要吗?
例如:
是否紧急?
A. 是
B. 否
或者:
选择处理方式:

A. 普通客服
B. 优先客服
C. 转人工
又或者:
这个工具调用是否存在风险?

A. 安全
B. 有风险
这些事情并不需要模型写一篇小作文。
程序真正需要的可能只是:
{
  "urgent": 0.94
}
或者:
{
  "action": "human_review",
  "confidence": 0.87
}
Jev 就是为这类问题设计的。
TypeSafe 将 Jev 定义为一种面向软件自动化的 “System One Model”,它不是以生成文本为主要目标,而是输出软件可以直接使用的结构化决策。
二、Jev 到底是什么?
一句话理解:
Jev 是一个把“AI 判断”变成程序可以直接使用的结构化结果的模型。
可以把传统 LLM 和 Jev 简单理解成:
| 对比项 | 大语言模型 LLM | Jev |
|---|---|---|
| 核心任务 | 理解、推理、生成 | 判断、分类、选择、评分 |
| 输出 | 文本 | 结构化决策 |
| 擅长 | 开放式问题 | 有边界的问题 |
| 是否写文章 | 可以 | 不是设计目标 |
| 是否写代码 | 可以 | 不是设计目标 |
| 是否做分类 | 可以 | 非常适合 |
| 是否做路由 | 可以 | 非常适合 |
| 是否做风险判断 | 可以 | 非常适合 |
| 是否需要输出长文本 | 经常需要 | 不需要 |
| 程序直接消费 | 通常需要解析 / 校验 | 天生面向结构化结果 |
TypeSafe 的 API 目前提供了三类核心问题形式:
Noul、Choice、Score。
可以简单理解成:
Noul   → 是 / 否
Choice → 从几个选项里选一个
Score  → 给一个程度或分数
官方 API 也允许在一次请求中针对同一份 state 提出多个问题。
三、Noul、Choice、Score,到底是什么?
不用记这些名字。
把它们翻译成程序员最熟悉的东西就很好理解了。
1. Noul:布尔判断
例如:
“这条消息是否紧急?”
程序世界里其实就是:
true / false例如:
{
  "urgent": 0.94
}
可以理解为:
Jev 判断“紧急”这个问题的概率约为 94%。
于是 Harness 可以写:
if urgent > 0.8:
    transfer_to_human()
else:
    continue()
注意一个很重要的地方:
Jev 负责判断,程序负责决定怎么处理这个判断。
这正是它和普通聊天模型非常不同的地方。
2. Choice:从几个选项中选择
例如:
用户:我的订单一直没有发货

请选择处理方式:

A. 普通客服
B. 优先处理
C. 转人工
Jev 返回:
{
  "action": "转人工"
}
程序就可以继续执行。
3. Score:评分
比如我们想判断:
“这个工具调用有多大风险?”
可以让 Jev 给出一个分数:
0 → 几乎没有风险
1 → 风险极高
例如:
{
  "risk": 0.86
}
然后 Harness 再决定:
risk < 0.3
    ↓
自动执行

0.3 ≤ risk < 0.7
    ↓
进一步检查

risk ≥ 0.7
    ↓
人工确认
这时候,Jev 就不再只是一个“模型”。
它开始成为软件控制流程中的一个判断节点。
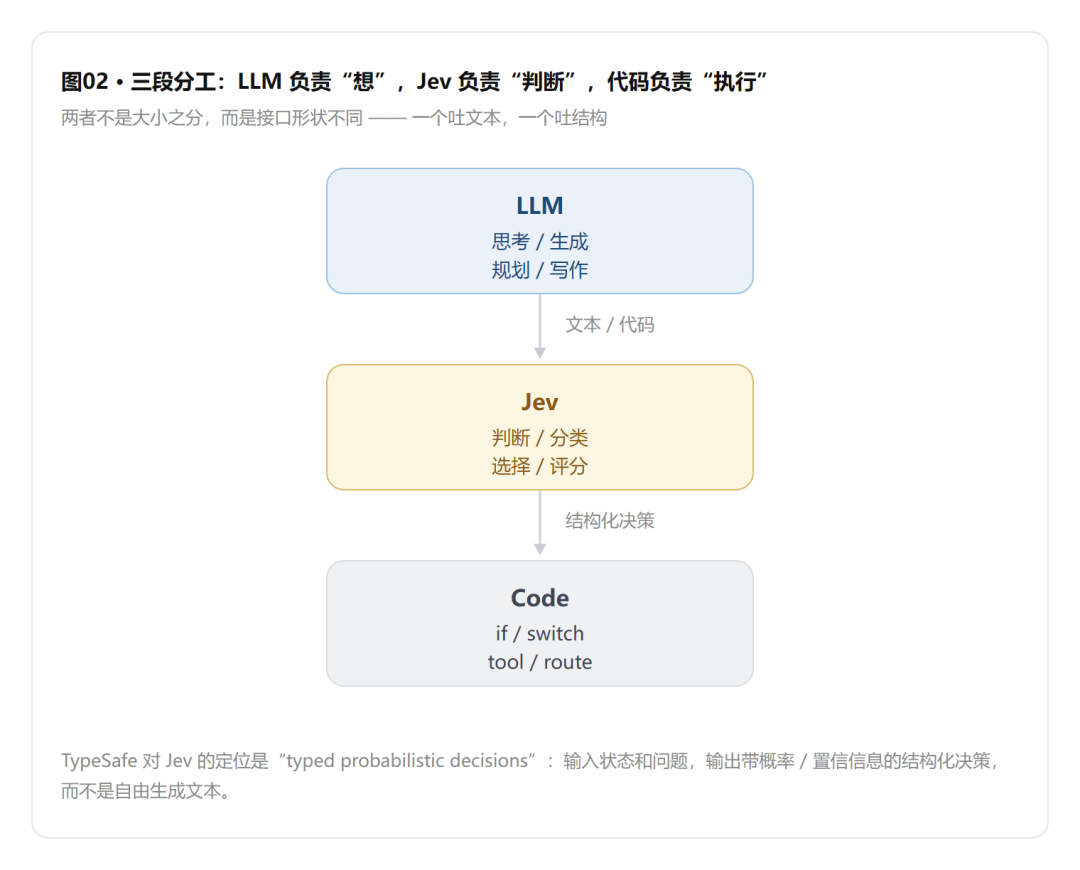
四、Jev 和 GPT、Claude 的真正区别
这里有一个非常容易产生误解的地方。
Jev 并不是:
“一个更小、更便宜的 GPT。”
更准确的理解是:
它们从一开始就在解决不同的问题。
传统 LLM 的核心接口可以理解为:
输入
 ↓
模型
 ↓
文本
而 Jev 更接近:
状态 State
    ↓
问题 Questions
    ↓
结构化 Decision
    ↓
程序
可以画成下面这样:
五、为什么 Agent 特别需要这种模型?
这就要回到我们经常讲的 Harness。
如果把 Agent 简化成:
Agent = Model + Harness
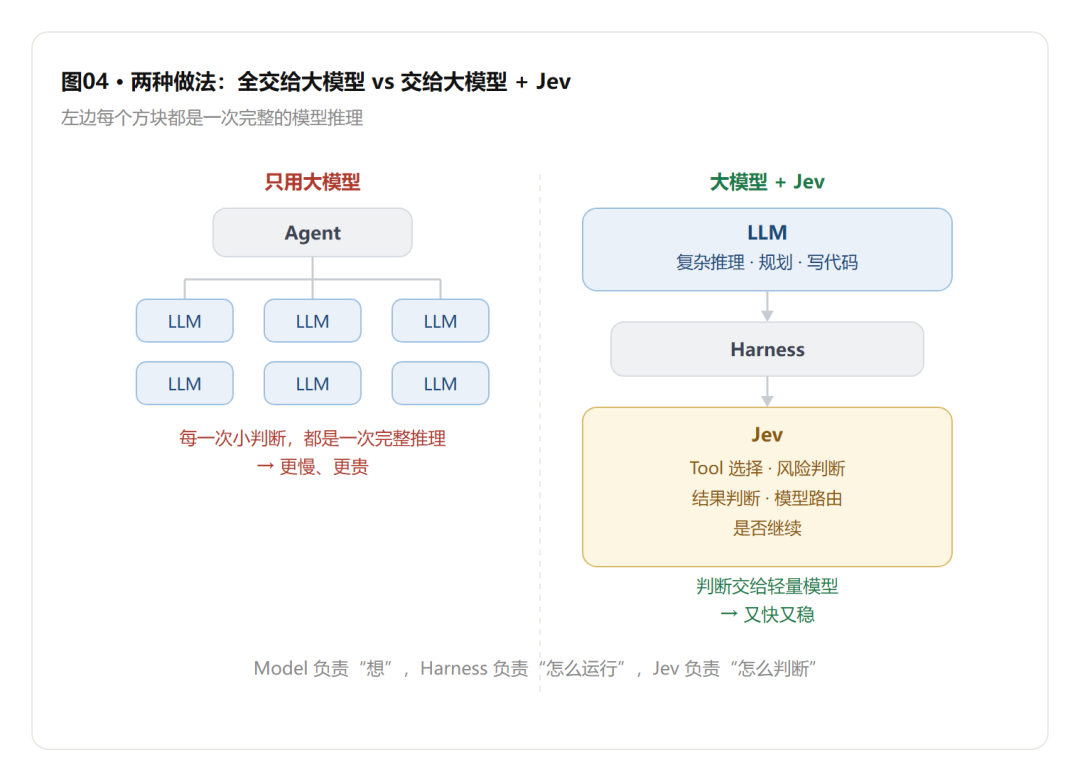
那么 Model 负责“想”,Harness 负责“怎么运行”。
一个真正的 Agent 往往不是:
用户 → LLM → 答案而是:
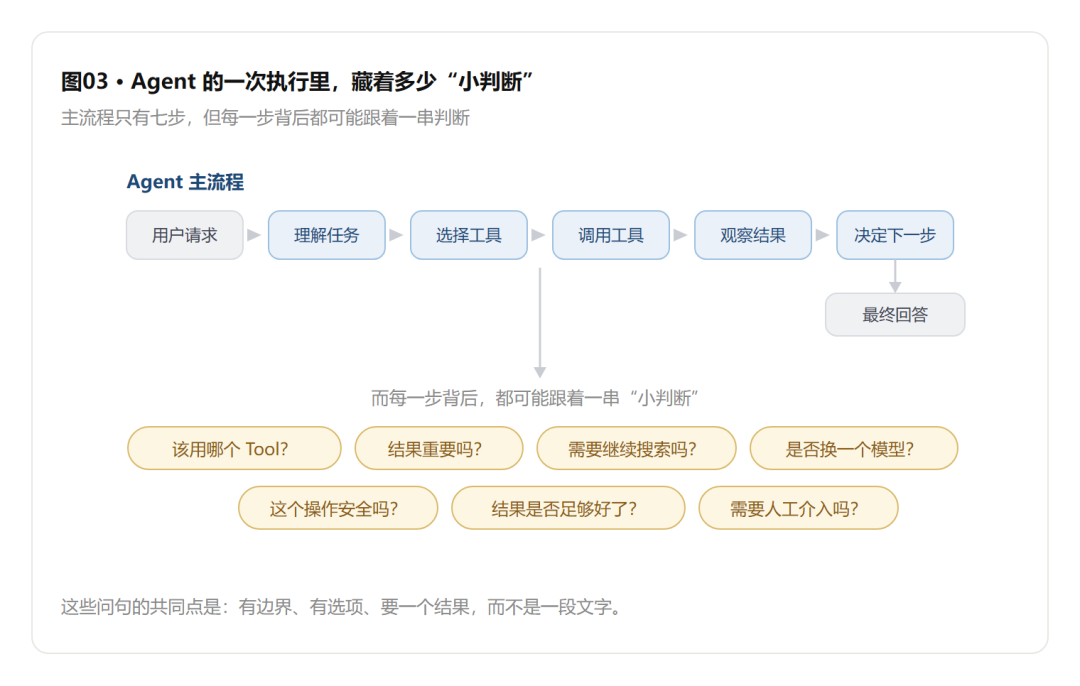
你会发现:
Agent 中其实存在大量“小判断”。
这些判断如果全部交给大型 LLM,整个系统自然会越来越慢、越来越贵。
六、一个真实的 Agent 场景:Coding Agent
我们拿程序员最熟悉的 Coding Agent 来举例。
假设 Agent 想执行:
rm -rf ./temp传统做法可能是:
LLM
 ↓
"我准备删除 temp 目录"
 ↓
执行
但 Harness 可以先让 Jev 判断:
问题:

这个操作是否具有危险性?

操作:
rm -rf ./temp
Jev 返回:
{
  "dangerous": 0.72
}
于是 Harness:
if dangerous > 0.7:
    ask_human_confirmation()
else:
    execute()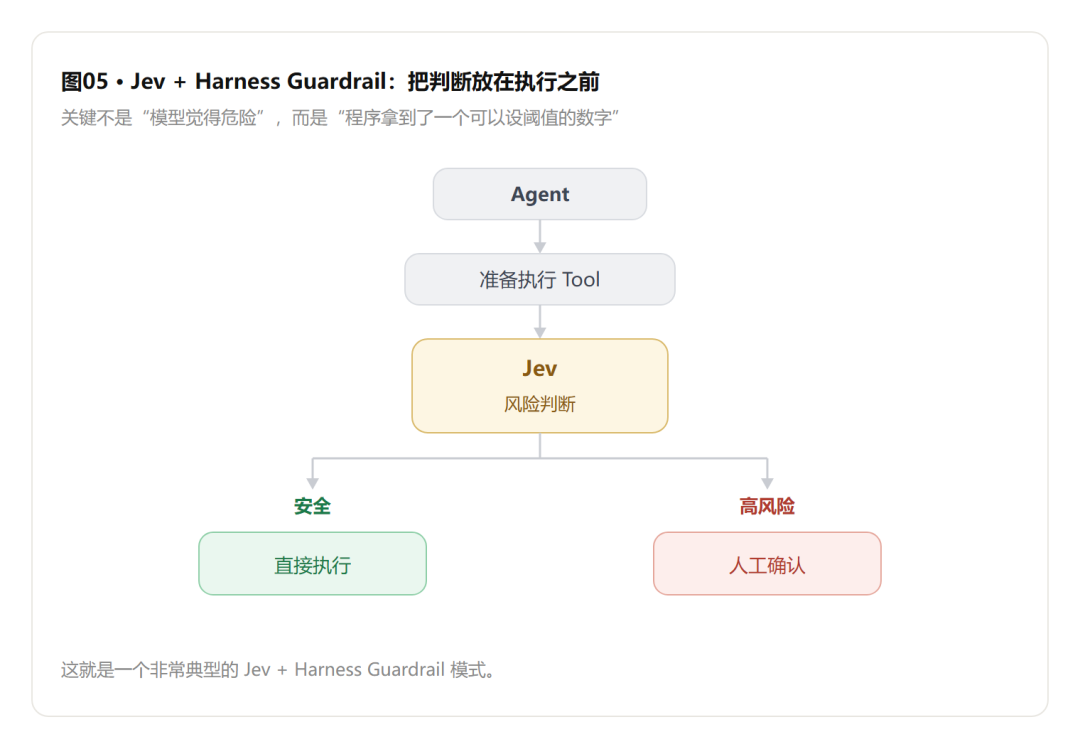
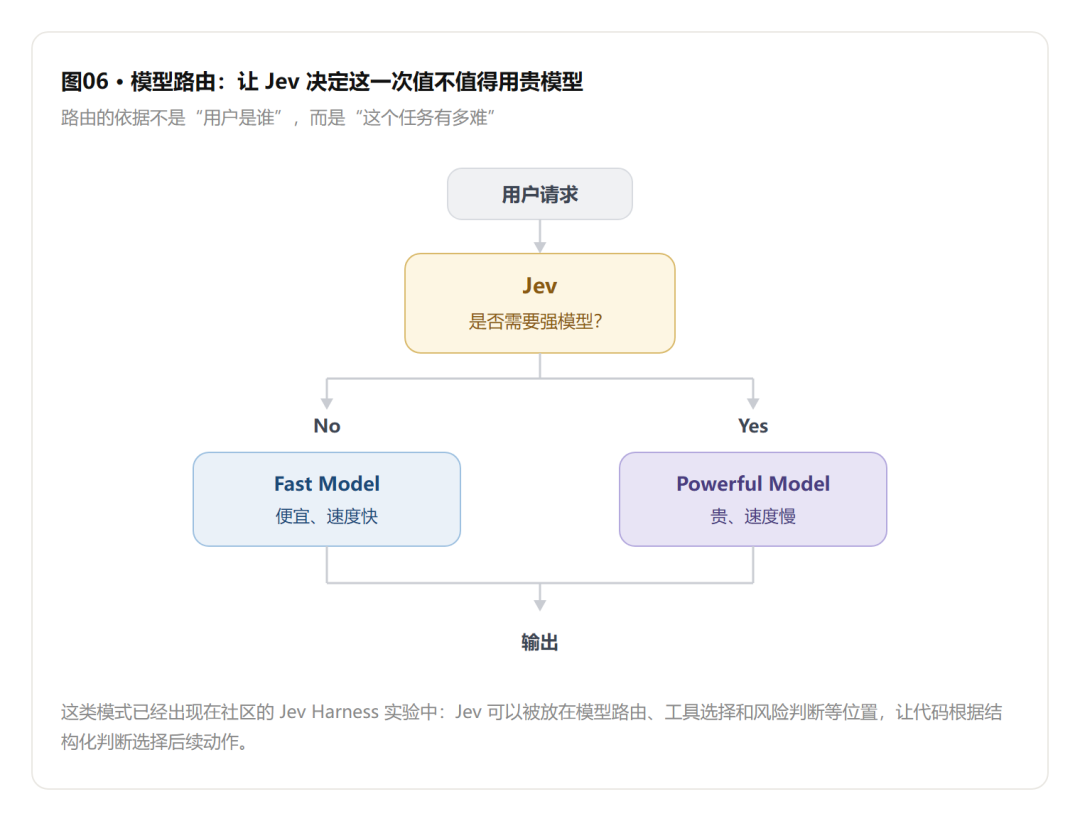
七、再举一个更有意思的例子:模型路由
假设我们做一个企业 Agent。
现在有两个模型:
Fast Model
便宜、速度快

Powerful Model
贵、速度慢
我们不希望所有问题都调用贵模型。
于是可以让 Jev 判断:
“这个任务是否需要强模型?”
例如:
用户:
"帮我把这段文字改成正式一点的邮件。"

Jev:
需要强模型?
0.08
于是:
0.08 < 0.5
 ↓
Fast Model
再比如:
用户:
"分析这个项目为什么连续三次部署失败,并制定解决方案。"

Jev:
需要强模型?
0.91
于是:
0.91 > 0.5
 ↓
Powerful Model
整个流程变成:
八、Jev + Harness,真正值得关注的不是“快”
很多介绍 Jev 的文章会强调:
更快。
更便宜。
这些当然重要。
但从 Agent 工程的角度,我认为更值得关注的是另外一件事:
把 AI 的“判断”变成了 Harness 可以控制的东西。
以前我们可能写:
Prompt:
请判断这个操作是否危险,
如果危险请告诉我。
然后模型返回:
"从目前情况来看,这个操作可能存在一定风险,
建议谨慎处理……"
程序还得继续解析这段话。
而 Jev 的设计更接近:
Question:
Is this operation dangerous?

Output:
0.87
于是 Harness 可以直接:
if risk > threshold:
    ...
这意味着:
AI 不再只是给程序“建议”,而是成为程序控制流中的一个决策节点。
但这里一定要注意:
Jev 的概率并不意味着“绝对正确”。
概率、置信度可以帮助 Harness 做阈值判断和升级处理,但它仍然可能判断错误。因此真正可靠的系统仍然需要规则、测试、日志、人工确认和降级机制。
TypeSafe 自己也强调,Jev 面向的是需要概率和不确定性的自动化场景,而不是意味着 AI 决策天然正确。
九、这时候再理解 Harness,就简单多了
很多初学者第一次听到 Harness,会觉得:
“Harness 不就是工具集合吗?”
其实不是。
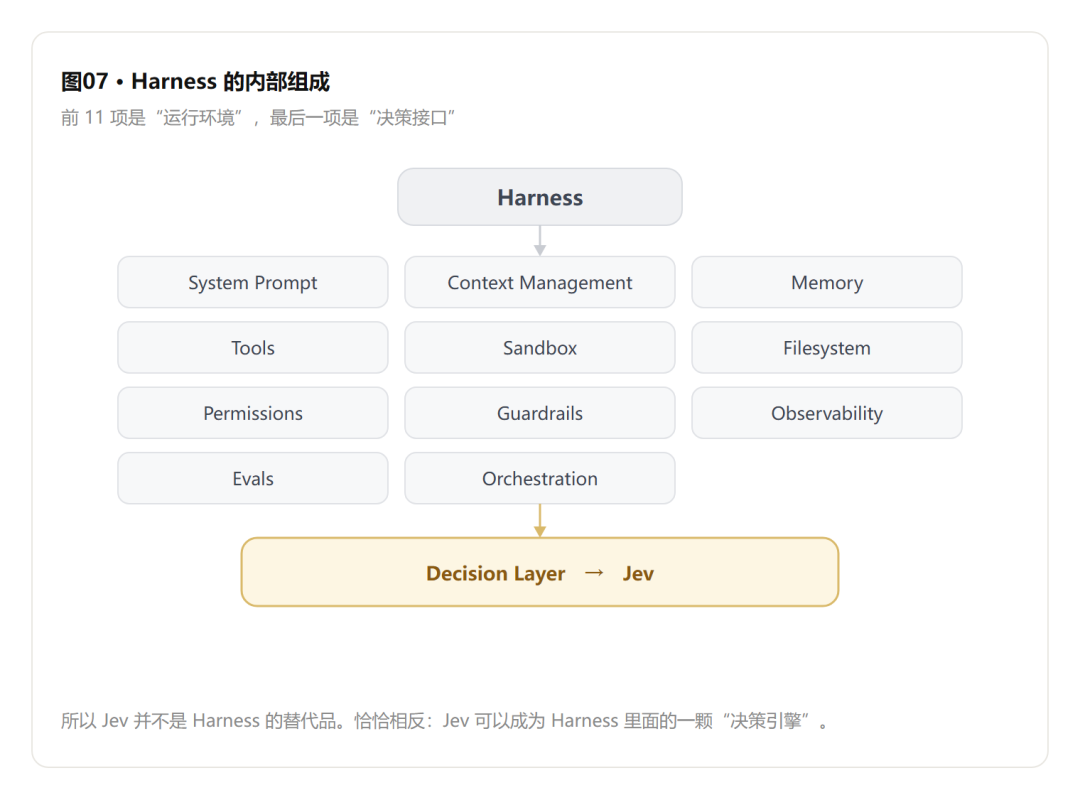
Harness 更像是:
控制 Agent 怎么运行的操作系统。
它里面可能包括:
十、一个完整的 Jev + Harness Agent
假设我们做一个“企业运维 Agent”。
用户说:
“服务器 CPU 持续 95%,帮我看看怎么处理。”
Agent 开始运行。
第一步:LLM 理解问题
LLM:
这是一个服务器故障排查任务。然后决定调用:
get_server_metrics()第二步:Harness 获取数据
服务器返回:
CPU:96%
Memory:63%
Disk:71%

过去 10 分钟:
CPU 持续 > 90%
第三步:Jev 判断
Harness 不一定需要再次调用大模型。
可以问 Jev:
Q1:是否需要立即处理?
Q2:是否属于高风险事件?
Q3:是否需要人工介入?
得到:
立即处理:0.94

高风险:0.82

人工介入:0.76
第四步:Harness 根据结果做决定
高风险 > 0.8
      ↓
暂停自动执行
      ↓
通知管理员
      ↓
等待确认
如果风险只有:
0.12那么:
继续自动诊断
      ↓
查询最近部署
      ↓
查询异常日志
      ↓
继续分析
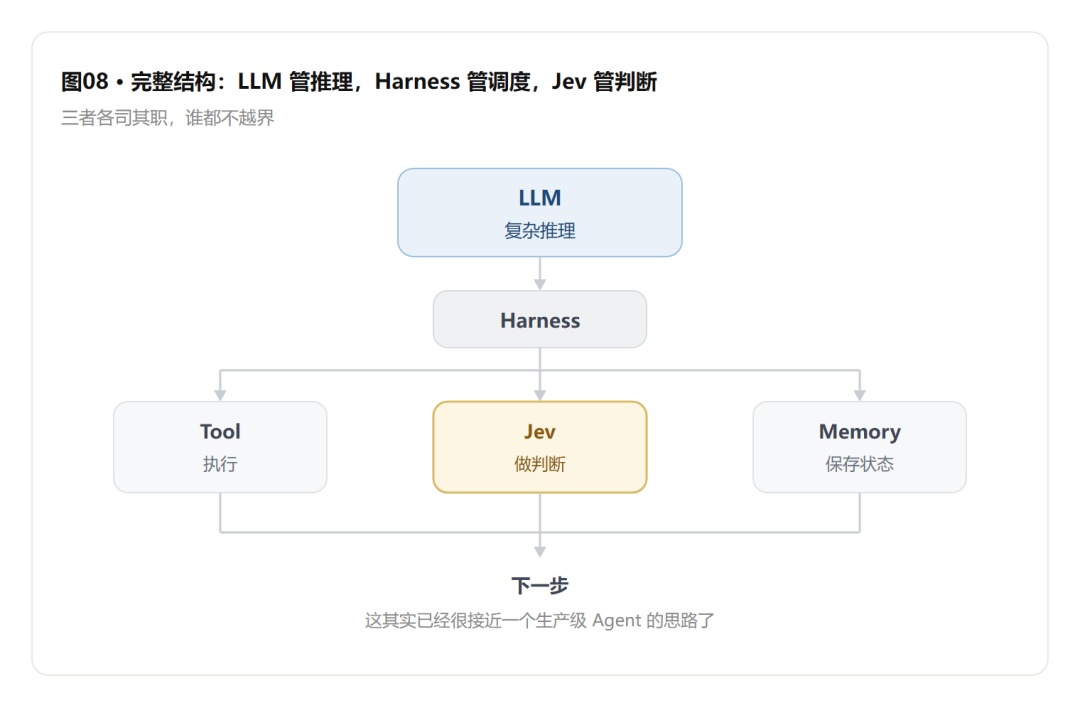
整个 Agent 就形成了:
十一、Jev 最适合什么?
如果把 Agent 中的事情分成三类,会非常容易理解。
| 类型 | 典型问题 | 更适合 |
|---|---|---|
| 开放式任务 | 写代码、写文章、制定方案 | LLM |
| 复杂推理 | 分析问题、规划多步任务 | LLM |
| 高频判断 | 分类、路由、评分、风险判断 | Jev |
| 工具执行 | 查数据库、调用 API | Harness |
| 权限控制 | 是否允许执行 | Harness + Jev |
| 状态管理 | Memory、Context | Harness |
| 最终流程控制 | 是否继续、暂停、升级 | Harness + Jev |
所以最合理的方式并不是:
“以后都用 Jev。”
而是:
不要让大模型承担所有判断。
十二、Jev 不适合什么?
这一点同样重要。
如果用户问:
“帮我设计一个本地生活 Agent 的完整技术架构。”
这显然不是 Jev 最擅长的事情。
因为这是一个开放式、需要长文本推理和生成的任务。
应该:
LLM
 ↓
分析需求
 ↓
设计方案
 ↓
生成架构
而不是:
Jev
 ↓
生成 3000 字技术方案
Jev 的价值在于:
LLM:
"我认为接下来应该调用酒店搜索工具。"

Jev:
"这个工具是否合适?"

Harness:
"如果合适,就执行。"
三者各做自己擅长的事情。
十三、从“Prompt Engineering”走向“Decision Engineering”
这可能是 Jev 最值得 Agent 开发者思考的一点。
以前我们设计 Agent,很多时候是:
Prompt
 ↓
LLM
 ↓
输出
后来逐渐变成:
Prompt
+
Context
+
Tools
+
Memory
+
RAG
再进一步:
Agent
=
Model
+
Harness
而 Jev 出现之后,又可以多一个思路:
Agent
=
Generative Model
+
Decision Model
+
Harness
让模型负责“想什么”,让 Jev 负责“判断怎么走”,让 Harness 负责“真正执行”。
这三个角色一旦分开,Agent 的架构会清晰很多。
十四、最后用一个生活中的比喻
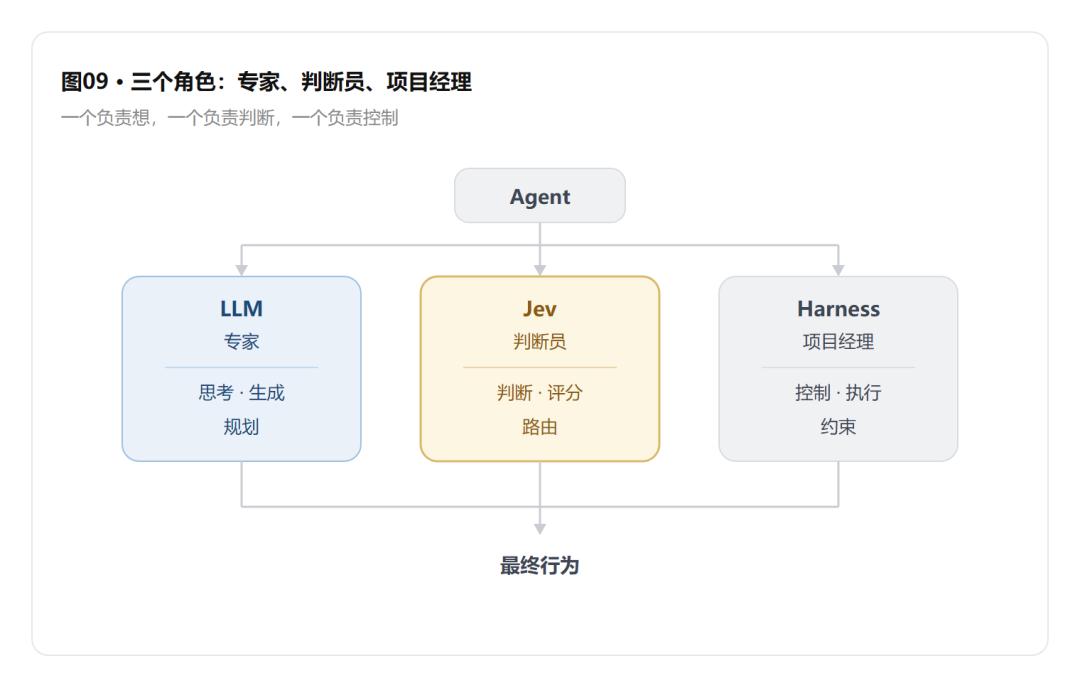
可以把一个 Agent 想象成一个团队。
LLM 是专家
负责:
“这个问题比较复杂,我分析一下。”
“我制定一个解决方案。”
“我写一段代码。”
Jev 是判断员
负责:
“这个事情紧急吗?”
“这个方案风险高不高?”
“应该选择 A 还是 B?”
“这个结果是否值得继续?”
Harness 是项目经理
负责:
“谁来做?”
“什么时候做?”
“能不能做?”
“做完以后检查什么?”
“出了问题怎么办?”
最终形成:
十五、Jev 真正有意思的地方
Jev 刚出现不久,目前仍然处在比较早期的阶段。
TypeSafe 在 2026 年 9 月 15 日正式发布 Jev Early Access,并把它定义为第一款公开的 System One Model。官方同时公布了较低延迟、结构化输出以及概率 / 置信度等设计目标。
所以现在讨论 Jev,还不适合简单地下结论说:
“Jev 将取代大模型。”
更值得关注的问题其实是:
未来的 Agent,会不会不再是“一个超级大模型包打天下”,而是由不同类型的模型共同组成?
可能会变成:
这其实和软件工程一直以来的发展逻辑很像:
不是让一个组件什么都会,而是让不同组件各自负责自己最擅长的事情。
而对于 Agent 开发者来说,Jev 最值得学习的地方可能也不是某一个 API,而是背后的一个工程思想:
能用确定的代码解决,就不要让模型解决;必须依赖智能判断的地方,再把 AI 放进去;需要复杂推理的时候,才调用强大的生成模型。
当我们开始这样设计 Agent,Harness 就不再只是“包在大模型外面的一层代码”。
它真正开始成为:
管理 AI、约束 AI、组合 AI 的运行时。
而 Jev,则提供了其中一种新的“智能判断组件”。
这或许才是它值得 Agent 开发者持续关注的原因。