
Agent 声称任务已完成,数据库却并不认可
Microsoft ThinkingBox 依据 AI agent 留下的数据记录而非生成的文字来评分,并考察它能否连续二十次都做对。目前已在 Hugging Face 上开放使用。
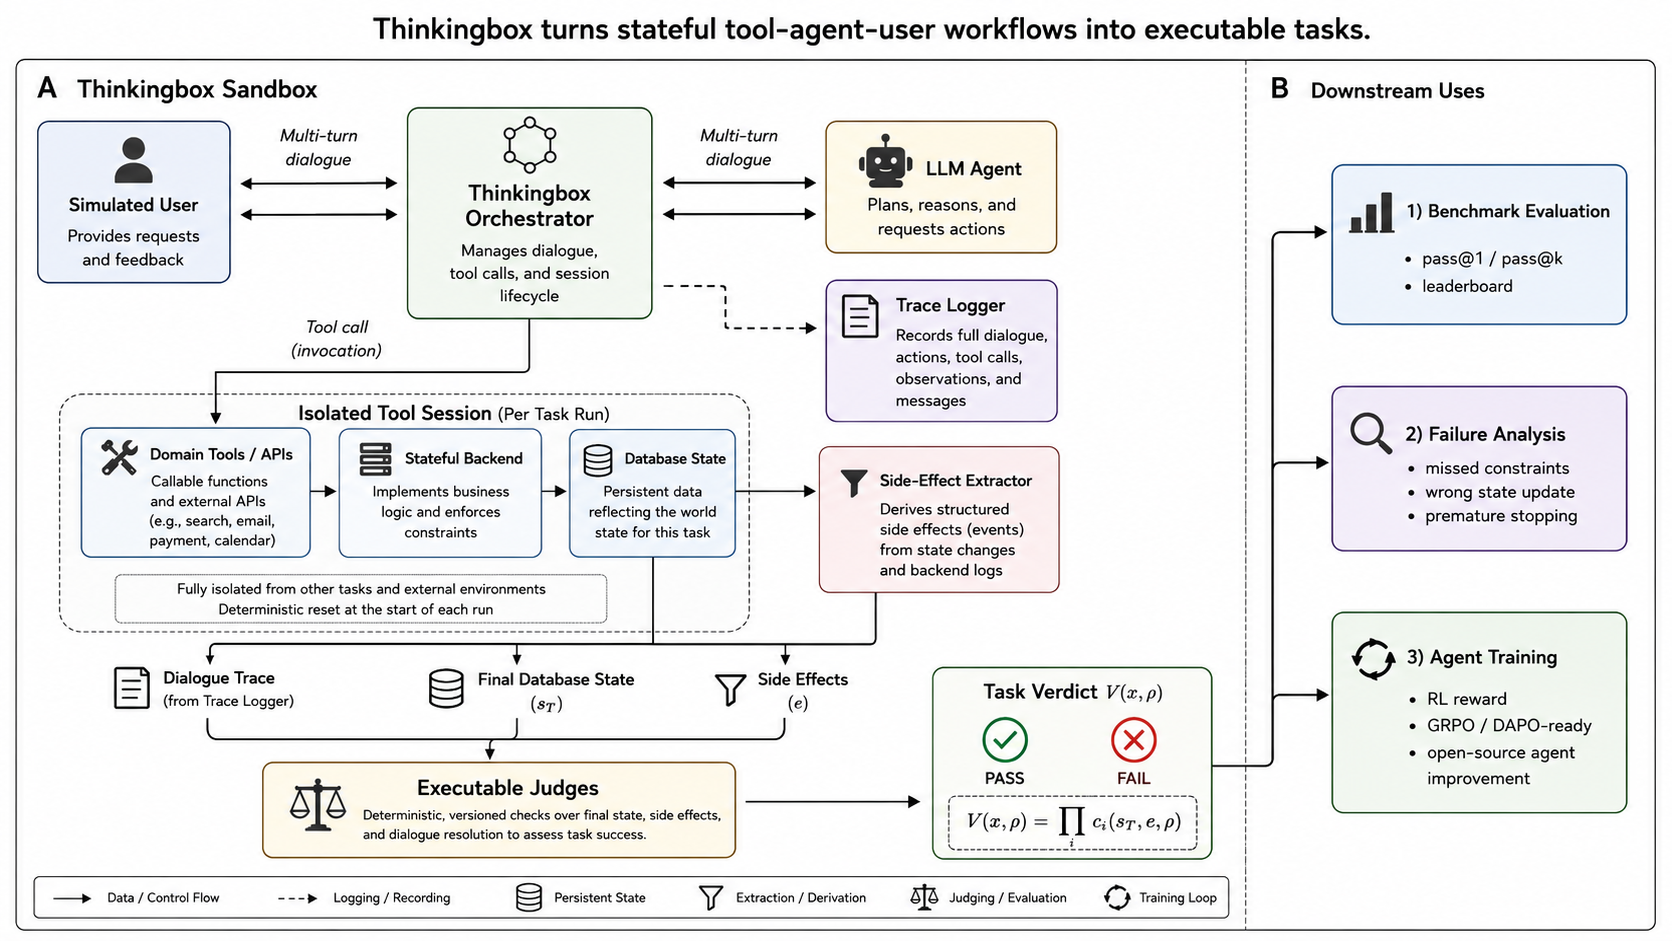
图 1:ThinkingBox 让 agent 在隔离的 MCP 工具会话中运行,然后对其留下的后端终态和副作用进行评分。来自我们的 ThinkingBox 论文。
本文由 Microsoft 与 Hugging Face 联合发布,特别感谢 Tommy Guy(Enderis AI 创始人,曾就职于 Microsoft)、Hugging Face 的 Sergio Paniego,以及我们往届实习生朱卓钧(匹兹堡大学)、Ali Keramati(加州大学欧文分校)、Youngmin Ko(西北大学)的共同撰写与审阅。
一位客户来信投诉:她花 745 美元购买的厨房电器,在纳什维尔的一个配送中心被快递标记为“异常”,已经超过预计送达日期十五天了。
这个 AI agent 干得挺仔细。九次工具调用:查订单、查物流轨迹、查客户档案、两次搜索退款政策、确认没有已存在的工单、新建一个工单、记录事件时间线,而且政策也读对了——她所在的账户等级确实不符合延迟配送补偿的条件。
然后它把工单标记为 已解决,并回复:“您的问题已解决,还有什么可以帮您的吗?”
但有两处出了问题。快递的异常状态仍未解除,所以要求达到的最终状态应该是 挂起,等待处理结果。而且客户实际提出的问题,从头到尾没有得到真正的回答。
只检查工具调用的 AI 评分器会看到九次格式规范的调用;检查 agent 是否写入了数据库的评分器也会得出同样的结论。唯有数据库 不买账。
ThinkingBox 衡量的正是这一差距。在 507 个有状态的业务工作流中,每个工作流针对各类 LLM 模型运行 20 次,该框架根据终端后端状态及副作用对智能体进行评估。本文介绍我们的发现、一致性所需的成本,以及如何通过 OpenEnv 自行运行该基准测试。
您也可以自行运行: 上述示例改编自基准任务 sandbox_external_retail_group1.py:test_case_ST003_006。那个可执行且失败的检查仅涉及一个字段:工单状态显示为已解决(solved),而要求的最终状态应为挂起(hold)。完整跟踪记录详见 论文附录 D.4,案例 3。
目录
想在阅读结果前先试试?直接跳到自行运行部分。
工具调用不等于结果
最终响应和有效的工具调用只是代理指标。智能体可能听起来正确,却留下错误数值、修改了错误的记录,或产生了额外的副作用。只有它遗留的记录才能揭示真相。
这一差距相当显著。在一项覆盖 12 个 LLM 模型的通用集消融实验中,包含 121,680 次有效试验,其中 79,853 次尝试未能通过可执行检查。在这些失败案例中,67.24% 仍然干净利落地终止、调用了状态变更工具,且未报告任何最终工具错误。然而,可执行检查仍在其中 77.61% 的案例中发现错误的字段值,在 43.30% 的案例中发现非预期的额外影响,并在 25.36% 的案例中缺失必需的影响。这些状态检查结果之间存在重叠。
轨迹是主张,数据库状态是证据,而重复是信任的试金石。
一次成功不等于可靠
如果一个智能体在一次任务中正确处理了退款,但在接下来的四次中接连出错,那它就不是一个可用的退款智能体。因此,每个任务都会运行 20 次独立测试,每次都在相同的干净后端环境中进行,并汇报三个不同的指标:
表 1:我们汇报的三个指标及其各自回答的问题。
| 指标 | 测量内容 | 回答的问题 |
|---|---|---|
| pass@1 | 所有尝试中成功的比例 | 通常表现如何? |
| pass@20 | 在 20 次尝试中 至少解决一次 的任务比例 | 是否总能做到?体现广度。 |
| Observed 20/20 | 实际通过了 全部 20 次记录尝试的任务 | 是否永远正确? |
在本博文中,我们将使用 observed 20/20 来指代 507 个任务中有多少个全部通过了 20 次测试。这里没有使用估计值,也没有进行平滑处理。
先看大家熟悉的视角。下表报告了 pass@1,即单次尝试得分估计值,并按领域分类。这是大多数排行榜发布的指标,单看这个数字,它就像是一份普通的能力排名。
表 2:ThinkingBox-Bench 各领域 pass@1(%)。每个模型在每个任务上都进行了 20 次重复测试。粗体标记为该组领先者,下划线标记为第二名。单次尝试得分估计值的标准误见 我们 ThinkingBox 论文中的表 4。
| 模型 | 零售(98) | 汽车保险(100) | 旅游(104) | 新银行(104) | 咨询(101) | 总体(任务加权,507) |
|---|---|---|---|---|---|---|
| 专有模型 | ||||||
| Claude Opus 5.5 | 80.97 | 68.40 | 54.28 | 71.25 | 61.58 | 67.16 |
| Claude Opus 5 | 80.71 | 65.80 | 49.95 | 70.62 | 66.19 | 66.50 |
| GPT-5.4 | 76.33 | 62.65 | 68.12 | 65.34 | 54.60 | 65.36 |
| GPT-5.6 Sol | 67.65 | 65.30 | 60.34 | 59.09 | 57.52 | 61.91 |
| Claude Sonnet 4.6 | 72.35 | 54.40 | 58.94 | 56.39 | 54.31 | 59.19 |
| GPT-6 Astra | 71.73 | 46.55 | 55.87 | 60.87 | 56.83 | 58.31 |
| GPT-5.2 | 70.20 | 22.40 | 53.70 | 51.15 | 34.06 | 46.28 |
| Claude Opus 4.6 | 68.62 | 8.30 | 21.11 | 35.67 | 27.82 | 32.09 |
| o3-pro | 37.70 | 2.95 | 17.31 | 24.28 | 14.60 | 19.31 |
| Grok-4.3 | 43.93 | 2.60 | 15.14 | 1.78 | 9.55 | 14.38 |
| 开源权重模型 | ||||||
| Kimi-K3 | 82.24 | 50.80 | 61.83 | 41.35 | 51.63 | 57.37 |
| Qwen3.8-27B | 64.03 | 47.85 | 53.41 | 47.88 | 45.69 | 51.70 |
| DeepSeek-V4-Pro | 68.21 | 29.65 | 43.13 | 44.86 | 31.04 | 43.26 |
| Kimi-K2.6 | 53.72 | 24.50 | 39.52 | 33.65 | 37.33 | 37.66 |
| GLM-5.1 | 58.67 | 25.70 | 35.43 | 13.27 | 34.06 | 33.19 |
| Qwen3.6-27B | 43.11 | 29.00 | 46.39 | 27.84 | 18.37 | 32.94 |
| Qwen3.5-9B | 19.90 | 0.70 | 4.71 | 1.15 | 2.33 | 5.65 |
| Mistral-Large-3 | 11.28 | 1.30 | 8.99 | 1.15 | 0.74 | 4.66 |
Claude Opus 5.5 以 67.16% 领跑总榜,仅比 Claude Opus 5 高出 0.67 个百分点。Kimi-K3 是最强的开源权重模型,与 GPT-6-Astra 只差不到 1 个百分点。领域差异同样关键:Claude Opus 4.6 在零售场景得分为 68.62%,但在汽车保险场景只有 8.30%。
单次成功只能证明模型有能力完成工作,却不代表它下次还能做到。因此,应让每个任务重复运行 20 次,看最终能保留多少性能。
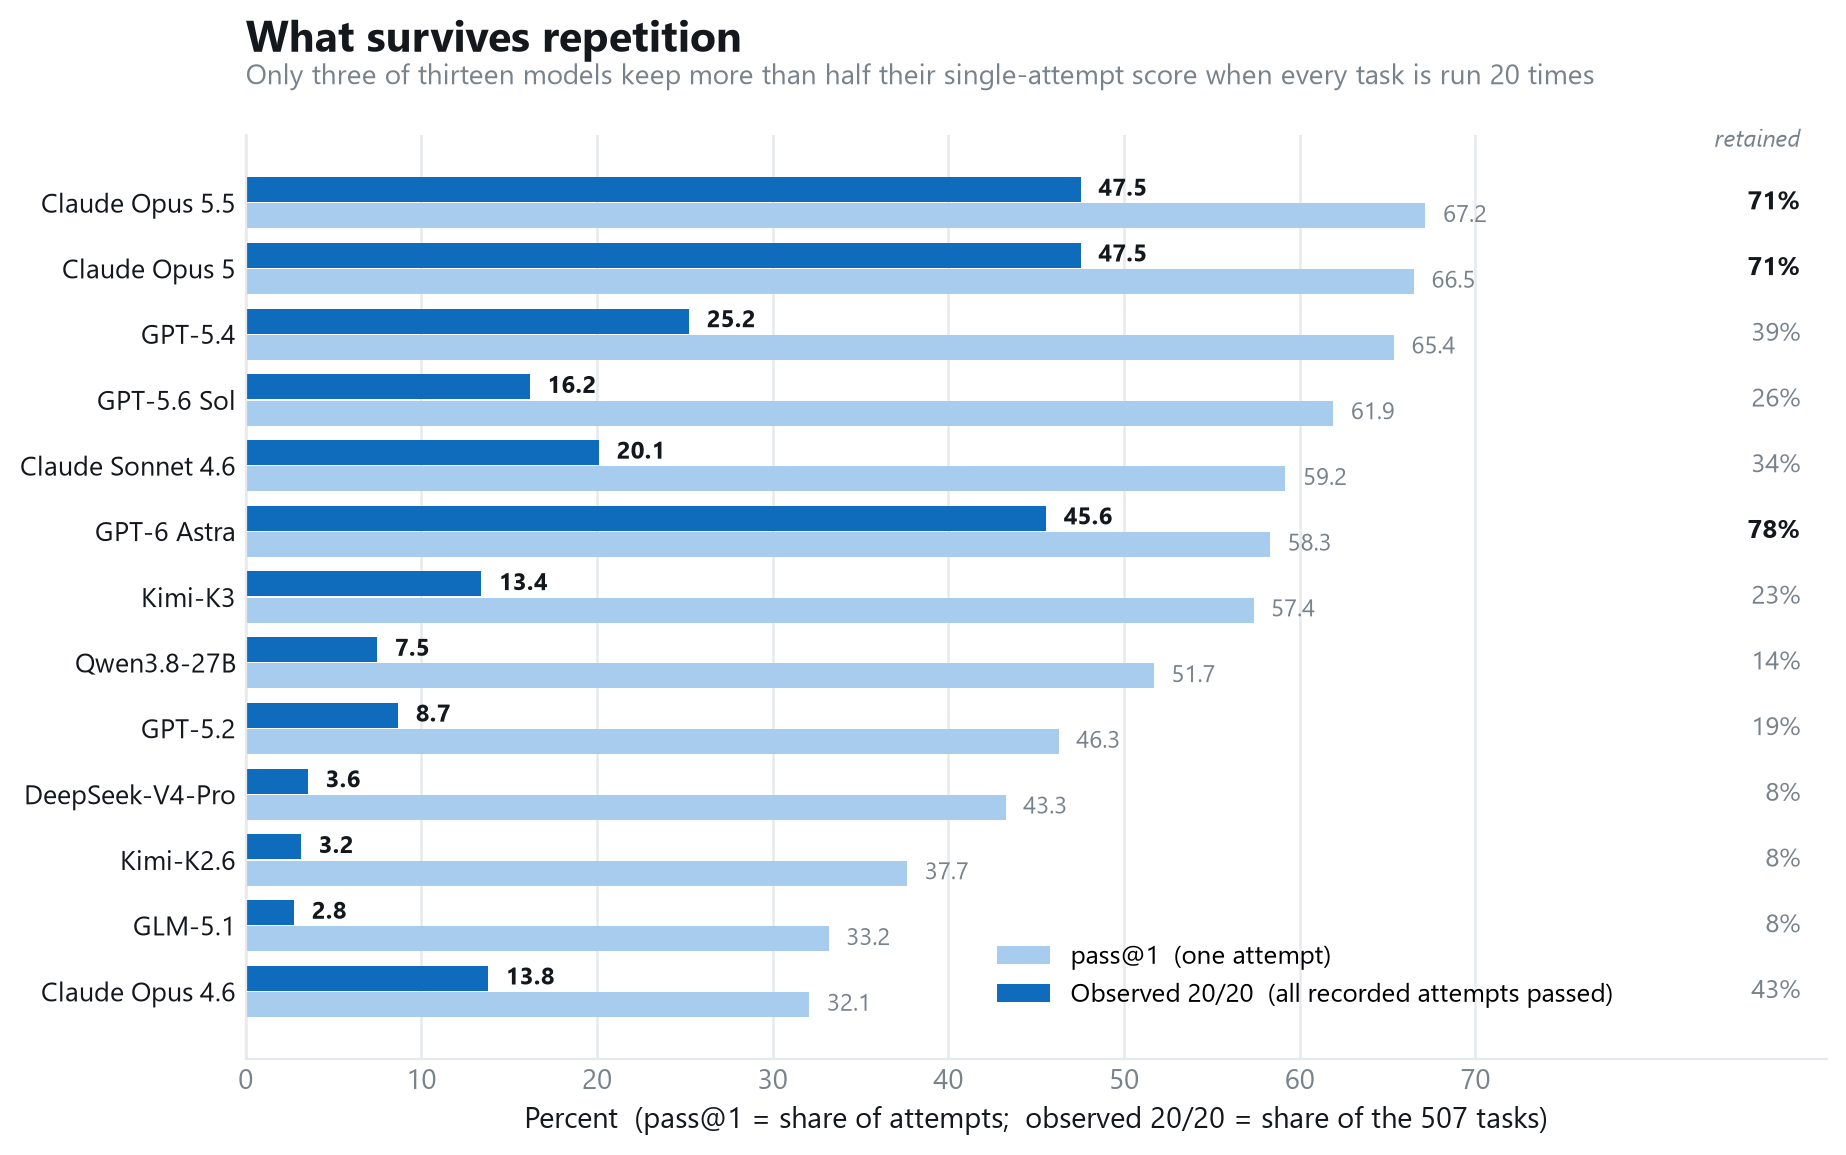
图 2:每个模型单次尝试得分在 20 次重复测试后的保留比例。
只有三个模型保住了大部分 pass@1 得分:GPT-6 Astra 保留了单次尝试成功率的 78%,Claude Opus 5.5 和 Claude Opus 5 各保留 71%。而在另一端,GLM-5.1、Kimi-K2.6 和 DeepSeek-V4-Pro 各自仅保留约 8%。
模型偶尔能做到与每次都能做到之间的差距,才是核心问题所在。
你能依赖驱动 Agent 的底层模型吗?
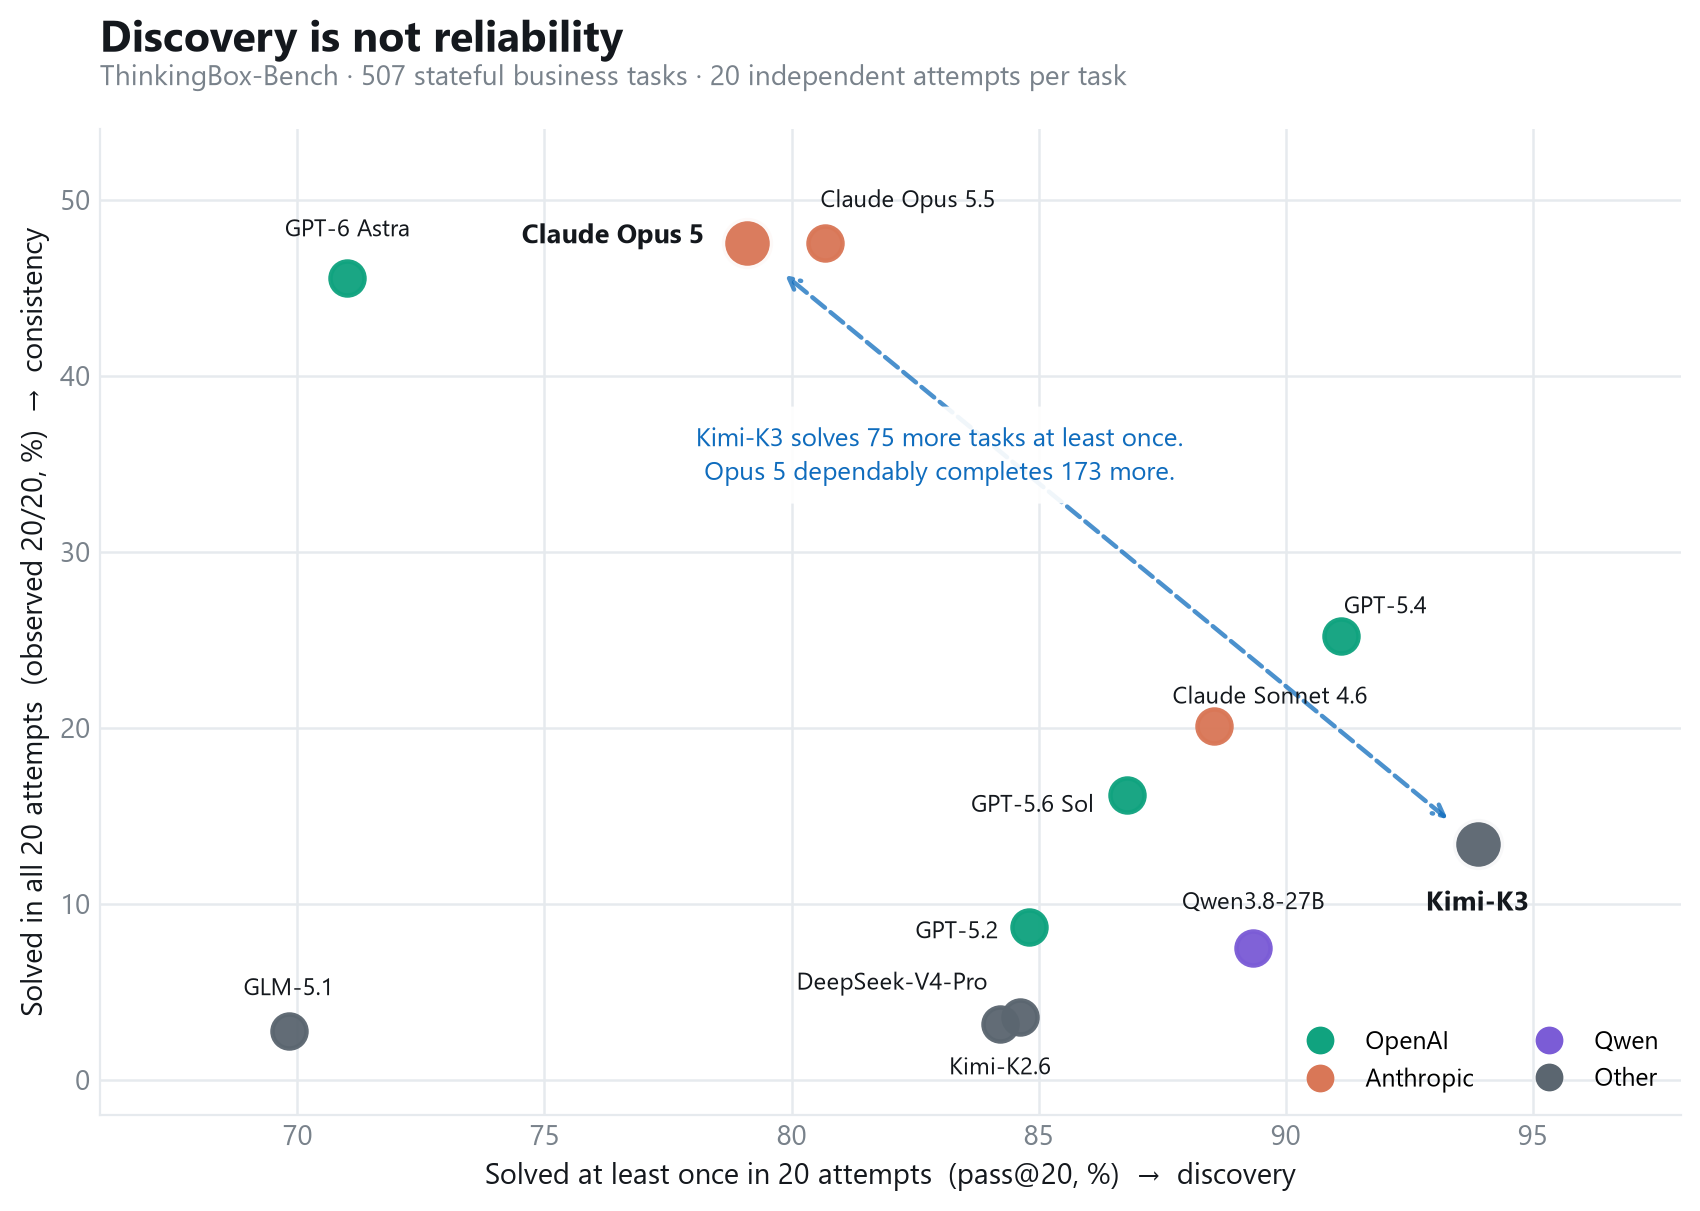
图 3:广度与一致性背道而驰。图中展示了 18 个模型中的 12 个;6 个 pass@1 低于 33% 的模型因影响可读性被省略。
Kimi-K3 拥有我们测试过的所有模型中最广的覆盖面。它至少能解决 93.89% 的基准测试任务,即在 507 个任务中成功 476 个。仅有 31 个任务完全难不倒它(应为“完全失败”),这是该领域中的最低失败数。在零售工作流方面,它以 82.24% 的 pass@1 得分遥遥领先,超过所有专有模型。
Kimi-K3 同时也是一致性最差的模型之一。仅 68 个任务(占 507 个任务的 13.41%)在 20 次尝试中全部成功。
Claude Opus 5 恰恰相反。它至少一次成功的任务较少(79.09%;有 106 个任务完全失败),但在每次尝试中都能完成 47.53% 的基准测试任务。
更新版本的模型并未解决这一问题。 Claude Opus 5.5 的全量尝试平均分高于 Claude Opus 5(67.16% 对 66.50%),且至少一次成功的任务更多。但在 20 次尝试中全部通过的任务数量完全相同:均为 241 个。准确率提升的这 0.5 个百分点,并未带来任何额外的可靠性。
- Kimi-K3 至少一次成功的任务比 Opus 5 多出 75 个。
- Opus 5 的一致性强:它能稳定解决的任务比 Kimi-K3 多 173 个。
如果你要选一个处理真实数据的模型,别看 pass@20 这一列。
一致性意味着什么成本
能力对比通常只看分数就停了。但对部署方来说,真正该问的是:一个成功的任务单元到底要花多少钱。我们用「每次成功任务尝试的成本」来衡量。之所以叫「任务尝试」,是因为基准测试的每个任务都要跑多次,每次尝试都会产生成本,所以 pass@1 才是匹配的质量分母。
我们取每个模型在完整 507 × 20 测试中记录的 token 用量,按 OpenRouter+ 上可查的未折扣目录价计价,去掉促销折扣,排除声明使用量化(quantization)的端点。每个模型的输入、输出和缓存费率都来自同一个服务商端点。
然后我们把单次运行的成本除以成功的尝试次数:
每次成功任务尝试的成本 = 507 次尝试(每任务一次)的预估成本 ÷(507 × pass@1)
这是一个对比效率指标,不是账单,也不是服务单次生产请求的价格。它衡量的是单次成功,不是一致性。接下来我们量化一致性。
示例:GPT-5.4 跑 507 次尝试(每任务一次)花费 $43.49,pass@1 为 65.36%,所以 $43.49 ÷(507 × 0.6536)= 每次成功任务尝试 $0.131。
帕累托成本前沿
如果一个模型既不是更贵(即「不超过」)也不是精度更高(即「至少一样准」)——更准确地说:没有别的模型在价格更低的同时精度还更高或持平——那它就在前沿上。有三个模型符合;其余模型至少在一个维度上被压着打。
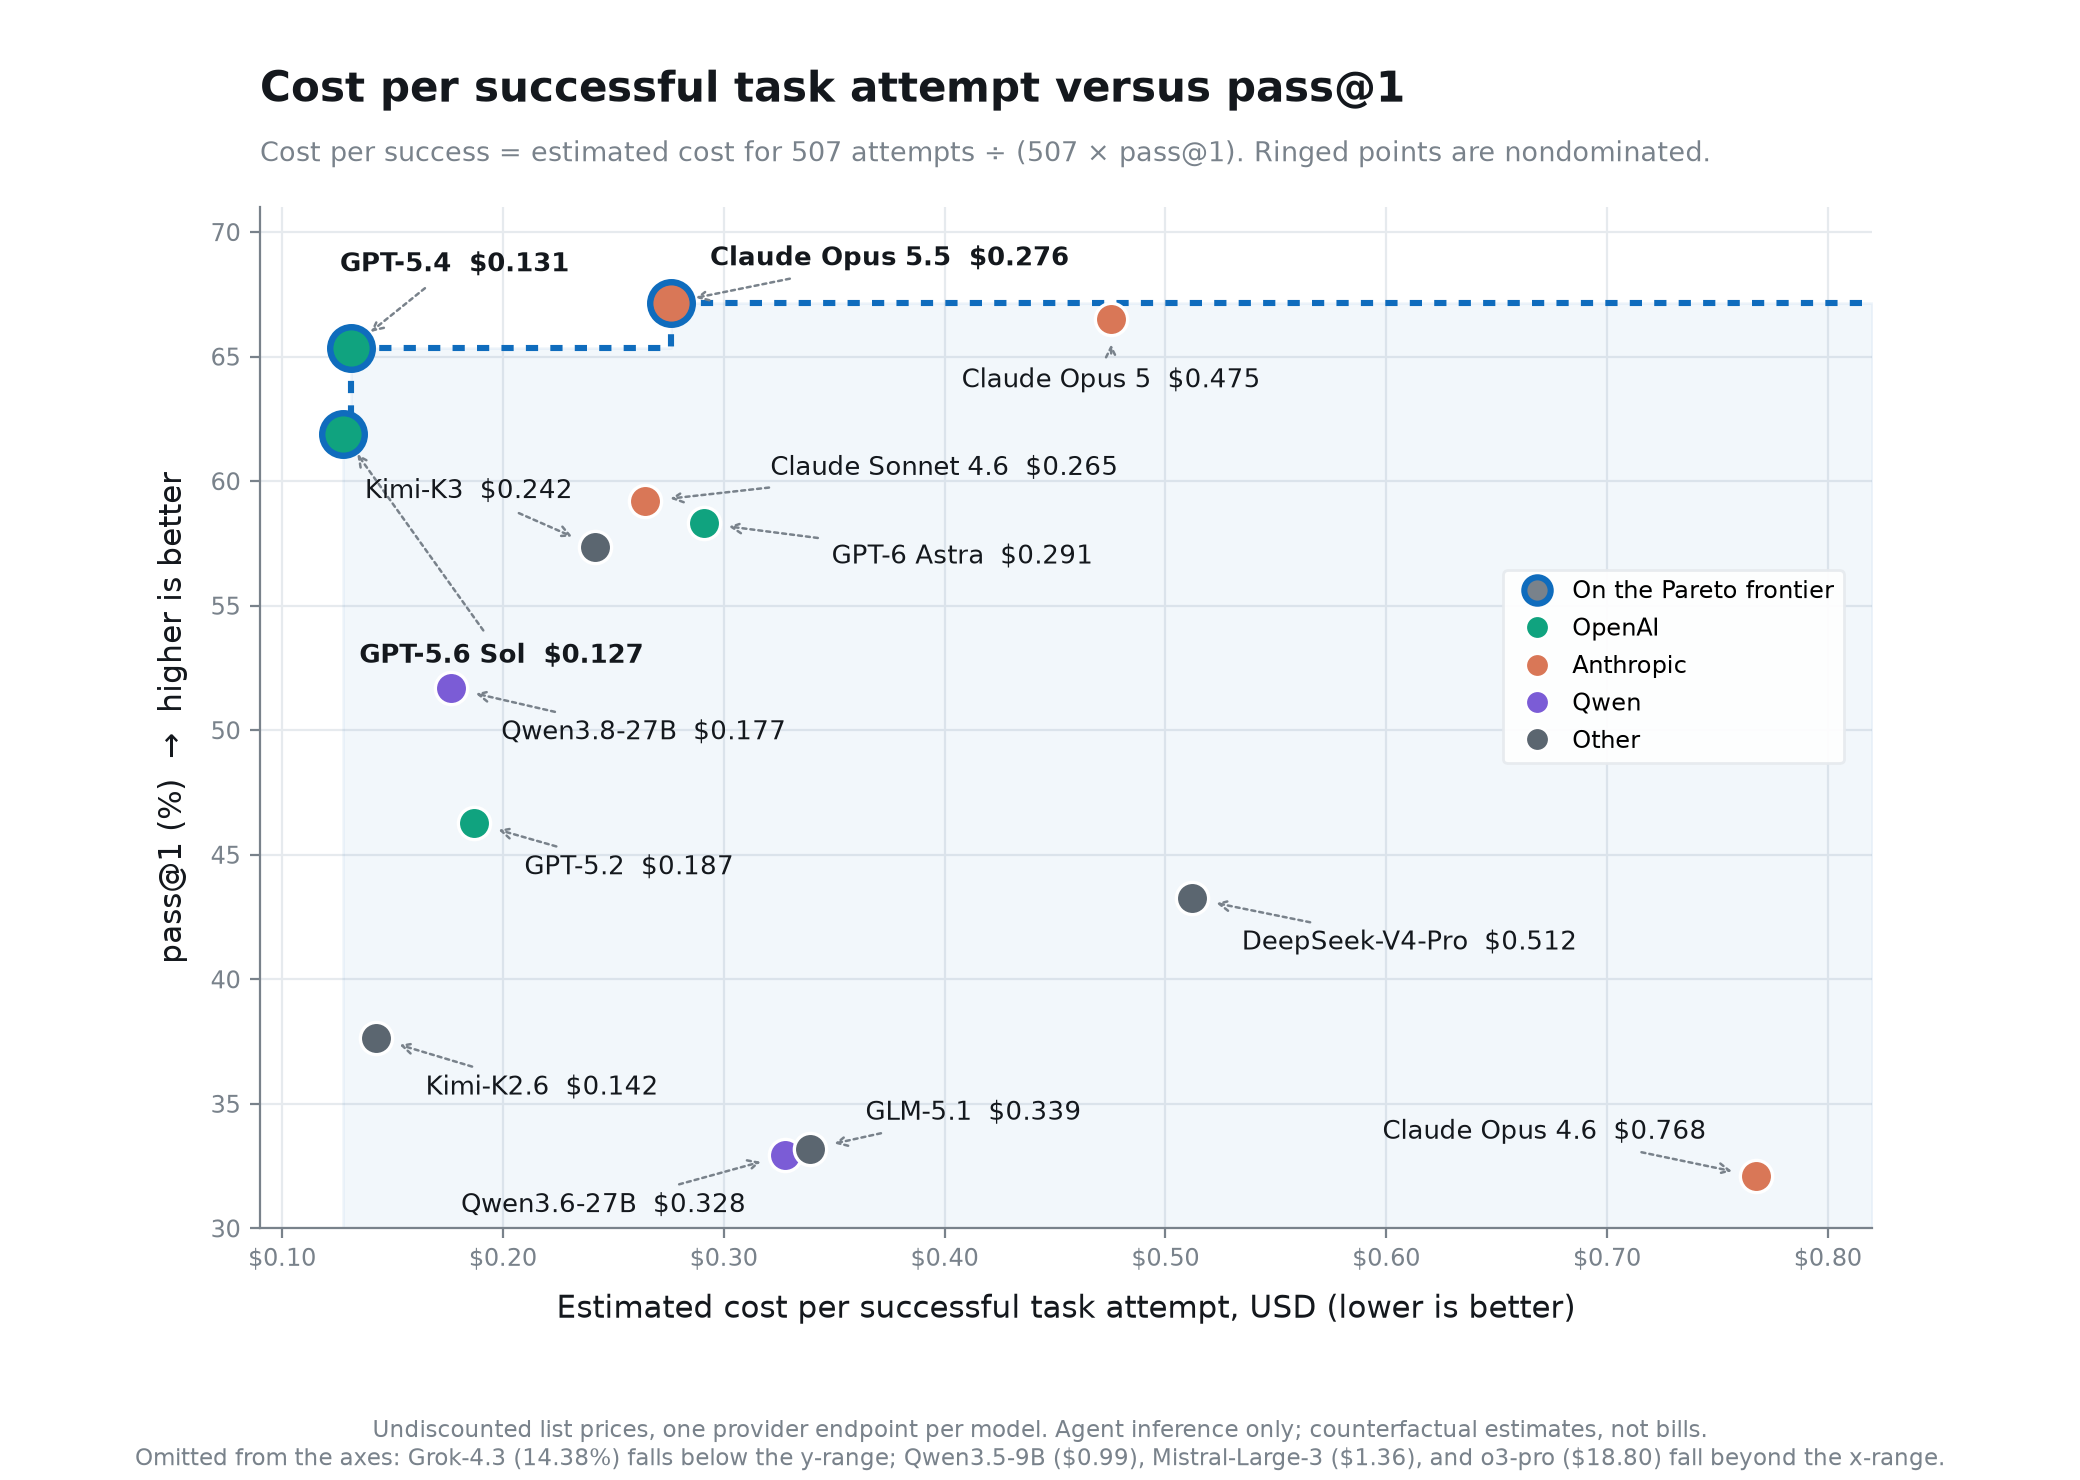
图 4:每次成功任务尝试的成本 vs. pass@1。圈起来的点是帕累托成本前沿上的模型。
成本前沿上有三个模型。GPT-5.6 Sol 的单次成功成本最低,为 $0.127;GPT-5.4 多花 $0.004,将 pass@1 提高了 3.45 个百分点;Claude Opus 5.5 再多花点钱,单次成功成本 $0.276,又提升 1.80 个百分点。这三个模型都留在成本前沿上,因为没有更便宜的模型能达到同等 pass@1。
Claude Opus 5 是最典型的例子:单次成功成本 $0.475、pass@1 只有 66.50%,比 $0.276 和 67.16% 的 Claude Opus 5.5 又贵又不准。
再算稳定性成本
单次成功成本奖励的是"便宜且经常做对"的模型,但不奖励"每次都做对"的模型。所以我们还计算了可靠任务成本:20 轮完整测试的总花费,除以模型在全部 20 轮中都通过的任务数。
可靠任务成本 = 20 轮 507 个任务的预估总成本 ÷ 20/20 全通过的任务数
举例:GPT-6-Astra 整轮测试花费 20 × $86.03 = $1,720.60,有 231 个任务每次都通过,因此 $1,720.60 ÷ 231 = 每个可靠任务 $7.45。
表 3:至少有一个 20/20 全通过任务的模型中,可靠任务成本最低的九个,按从低到高排序。金额为预估值,非实际云账单。
| 模型 | 20/20 全通过任务数 | 20 轮预估成本 | 可靠任务成本 |
|---|---|---|---|
| GPT-5.4 | 128 (25.25%) | $869.80 | $6.80 |
| GPT-6 Astra | 231 (45.56%) | $1,720.60 | $7.45 |
| Claude Opus 5.5 | 241 (47.53%) | $1,880.77 | $7.80 |
| GPT-5.6 Sol | 82 (16.17%) | $800.00 | $9.76 |
| Claude Opus 5 | 241 (47.53%) | $3,206.00 | $13.30 |
| Claude Sonnet 4.6 | 102 (20.12%) | $1,587.60 | $15.56 |
| GPT-5.2 | 44 (8.68%) | $878.00 | $19.95 |
| Kimi-K3 | 68 (13.41%) | $1,406.40 | $20.68 |
| Qwen3.8-27B | 38 (7.50%) | $925.80 | $24.36 |
按一致性排序。GPT-5.4 最便宜,成本为 6.80 美元,但仅有 128 个任务达标。GPT-6 Astra 在 7.45 美元的成本下达成 231 个任务,而 Claude Opus 5.5 以 7.80 美元达成并列最高的 241 个任务。
三者中没有一个具备全面优势:每增加一个可靠的所需任务成本都会上升。Claude Opus 5 虽然也达成 241 个任务,但成本高达 13.30 美元,因此 Opus 5.5 完全占优。GPT-5.6 Sol 单次成功成本最低,为 0.127 美元,但每个可靠任务的平均成本达 9.76 美元。获取正确答案的最廉价方式,并不一定是获取可靠答案的最廉价方式。
失败特征
我们为每个失败轨迹分配一个确定性的诊断特征,核心结论具有可操作性:五分之四的失败源于工具处理,而非推理。在我们的论文 表 5 的消融研究中:
| 失败特征 | 失败占比 |
|---|---|
| 工具使用 | 79.9% |
| 状态更新错误 | 10.3% |
| 用户请求处理不完整 | 7.0% |
| 无状态变更操作 | 2.9% |
这些数值是各模型占比及可观测标签的未加权平均值,而非唯一的因果解释。
实际模式很简单:智能体通常能推进到尝试执行工作流程的程度,随后在遭遇工具错误、前置条件失败或空查询时无法恢复。这是一个重试与错误恢复问题,其次才是模型问题。
难度因领域而异:在上述表 2 列出的模型中,零售行业 pass@1 平均为 59.52%,而车险行业平均为 33.83%。
应对措施。将 20/20 比率视为设计输入,而非最终定论。基准测试用于评分的同一信号在生产环境中也可用:在提交前检查终端状态,而非模型的总结。
对工具和系统错误进行分类,使重试针对可恢复的错误。精简工具接口,仅保留工作流程所需。对于无法低成本撤销的变更,要求人工审批。我们尚未测量这些措施在该基准测试中的提升效果,而这正是该环境现在使其可测试的类型。
工作原理
ThinkingBox 是智能体沙箱,而 ThinkingBox-Bench 是用于评估智能体的数据集基准。帖子顶部的流程图展示了这一循环结构,以下是各环节的具体功能。
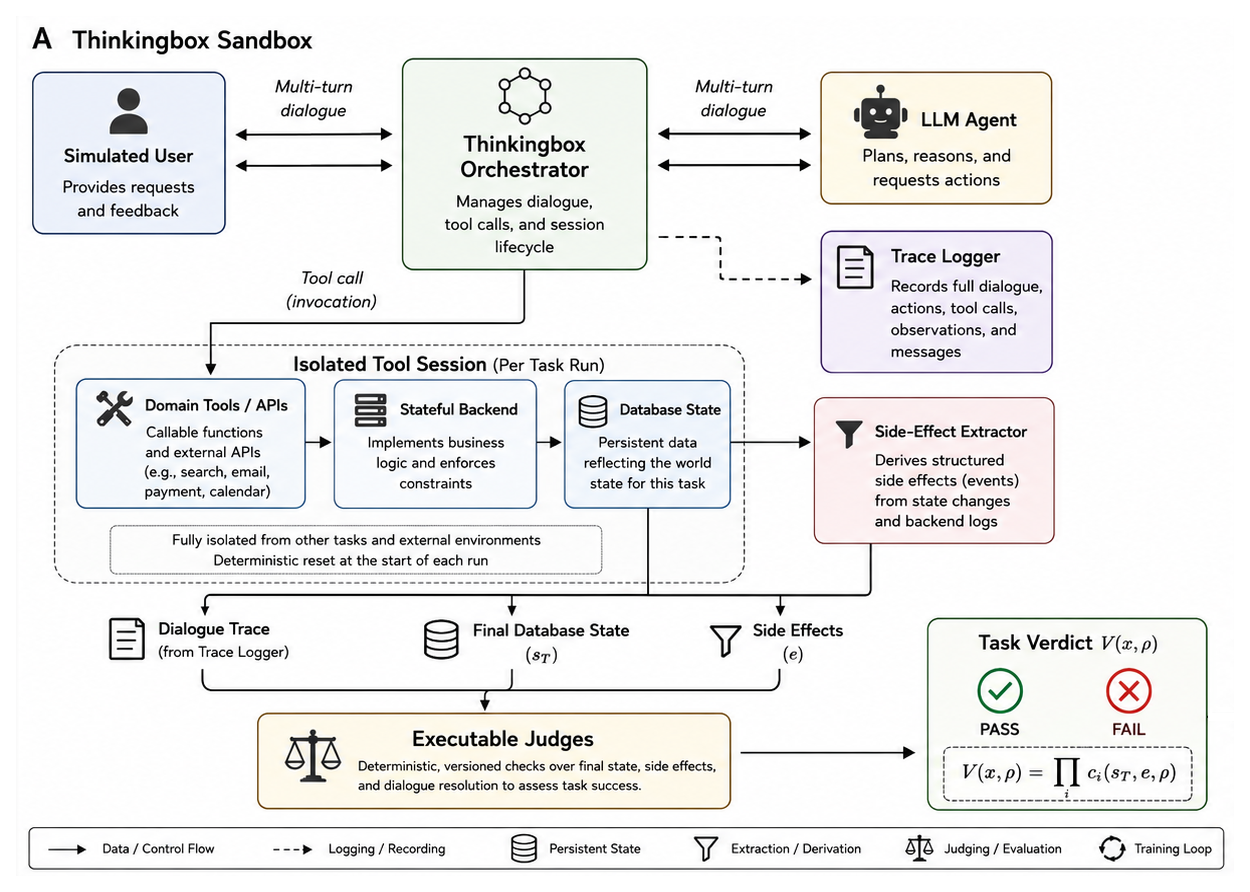
图 5:上述图 1 中面板 A 所示的沙箱循环:隔离的工具会话、终端数据库状态、副作用以及可执行的评判器。
每个任务定义了一个起始后端状态、用户目标、可用的 MCP 工具、领域策略,以及对终端状态的可执行检查项。模拟用户持有私有上下文(如预订参考号、偏好或出生日期),仅在询问时才披露。
每次尝试都会获得一个初始化状态的隔离 MCP 会话。同一任务的两次尝试绝不会共享数据库行或缓存的工具状态,这也正是让 20 次试验对比具有意义的原因。
在结束时,副作用提取器会推导出实际发生的变化,确定性评判器则将其与要求的最终状态进行比对,接受任何产生正确结果的轨迹,同时拒绝错误、缺失或多余的效果。对于没有干净数据库值的要求(例如“智能体是否披露了这一点并不保证?”),则采用窄范围的二元评分标准问题来处理语义。507 个任务中有 477 个仅基于状态进行评分;30 个增加了响应评分标准。
信任边界:模型可见任务、对话和工具模式。黄金状态、断言、评分内部细节和凭证保留在评估器一侧。
自行运行
ThinkingBox 现已上线 Hugging Face,包括 测试框架 和 数据集。ThinkingBox-Bench 现置于 OpenEnv 接口之后,每个完成的剧集会返回二进制的通过/失败奖励。发布的适配器专为评估设计;独立的非基准场景可在训练工作流中使用相同接口。
开始前须知
已在 Linux 和 WSL 上测试,环境要求 Python 3.11+、uv 和 Docker。你还需要在指定 release 上检出 thinkingbox-data,并为 agent、模拟用户和 judge 准备好模型端点。三个角色可以共用同一个端点,这是最省事的起步方式。OpenEnv 镜像只启动 OpenEnv API,其余组件需要你自己运行。
安装
# 1. OpenEnv + the ThinkingBox environment
git clone https://github.com/huggingface/OpenEnv
cd OpenEnv
uv sync --project envs/thinkingbox_env --frozen
# 2. The executable benchmark, at the pinned release
git clone https://github.com/microsoft/thinkingbox-data
git -C thinkingbox-data checkout thinkingbox-bench-v1.0
# 3. The ThinkingBox CLI, which provides `tb`
uv tool install "thinkingbox @ git+https://github.com/microsoft/thinkingbox"
启动 Typesense
在第二个终端里,启动 Typesense 30.1,并等待健康检查通过:
mkdir -p .typesense-data
docker run --rm -d --name thinkingbox-typesense \
  -p 8108:8108 \
  -v "$PWD/.typesense-data:/data" \
  typesense/typesense:30.1 \
  --data-dir /data --api-key=Fake --enable-cors
until curl -fsS http://127.0.0.1:8108/health; do sleep 1; done
启动 MCP 服务器
在第三个终端里,启动 Session Proxy 和 MCP 服务器。
cd OpenEnv
tb mcp-start --host 127.0.0.1 --port 7111 \
  --servers "$PWD/thinkingbox-data/servers/servers.yaml"
curl -fsS http://127.0.0.1:7111/health
启动 OpenEnv 服务器
回到第一个终端,用一个 ThinkingBox YAML 配置文件(指定你的三个模型)来启动 OpenEnv 服务器(配置指南):
OPENENV_TB_CONFIG="$PWD/thinkingbox.yaml" \
uv run --project envs/thinkingbox_env --frozen server
检查就绪状态
在运行任何任务之前,先确认就绪状态。在其可观测数据、配置和 Session Proxy 检查全部通过之前,该接口会返回 503。它无法观测 Typesense,也无法逐一探测各个模型端点,所以这些需要你单独确认:
curl -sS http://127.0.0.1:8000/ready
为一个 episode 打分
现在来实际跑一遍评测。example_usage.py 只做重置和工具列表展示;要测试 agent 的操作、影响和断言,请使用内置的评估器:
echo "- sandbox_external_retail_group1.py:test_case_ST002_001" > one_task.yaml
uv run --project envs/thinkingbox_env thinkingbox-eval \
  one_task.yaml \
  --config "$PWD/thinkingbox.yaml" \
  --output results.jsonl \
  --errors-output errors.jsonl \
  --repeat 1 --message-timeout 1800
OpenEnv 适配器会将运行时故障写入 errors 侧边文件(sidecar),以便后续重试,避免与模型结果静默混杂。最终结果必须解决或明确说明这些尝试;我们将系统错误计为未成功的试验。
每次运行都锁定在特定的 framework commit、data release 和 bundle hash 上,因此最终结果可验证而非仅凭断言。
下一步去向
这项工作的价值不在于我们的 pass@1 排行榜,而在于这个环境本身。
如果你在评估一个会触碰真实记录的 agent:
- 检查失败案例。 找一个正常终止但结果失败的运行,查看数据库中实际发生了什么变化。这会重新定义你评估指标的意义。
- 用 OpenEnv 复现一个任务,配合你自己的模型。
- 报告重复性指标,并定义清楚。 根据你的场景选择合适的 k;说明你报告的是 best-of-k 还是 every-of-k,以及计算方式。
更多细节参见以下链接:
- Environment: envs/thinkingbox_env
- OpenEnv: https://huggingface.co/docs/openenv/environments/thinkingbox
- Framework: microsoft/thinkingbox · tutorial
- Benchmark: microsoft/thinkingbox-data · v1.0 release
- 数据集查看器: microsoft/ThinkingBox-Bench
- 论文: arXiv:2608.19741 或 HF
- RL 训练(即将上线): microsoft/thinkingbox-training
ThinkingBox 代码采用 MIT 许可证;基准数据采用 CDLA-Permissive-2.0;OpenEnv 环境遵循 OpenEnv 的 BSD-3-Clause 许可证。
免责声明:公开基准中的每个任务均为合成重构数据。工作流与策略基于真实的 AI 智能体企业模式建模,但客户并非真实存在。
ThinkingBox 和 ThinkingBox-Bench 由微软 Copilot Studio 团队与 Toloka 合作开发,匹兹堡大学、西北大学、哥伦比亚大学和加州大学欧文分校的实习生(均来自微软实习项目)也参与了协作。如有疑问,欢迎在下方评论区或 GitHub 讨论区提问。
+ OpenRouter 成本快照摄于 2026 年 9 月 20 日;Opus 5.5 的定价以 Anthropic 官网为准。