
万分之一——大模型后训练中的极端稀疏监督
论文标题:Extremely Sparse Supervision Incentivizes Reasoning Ability
论文链接:https://arxiv.org/abs/2609.04565
X Post:https://x.com/iampanxu/status/2099151119658475880?s=20
image
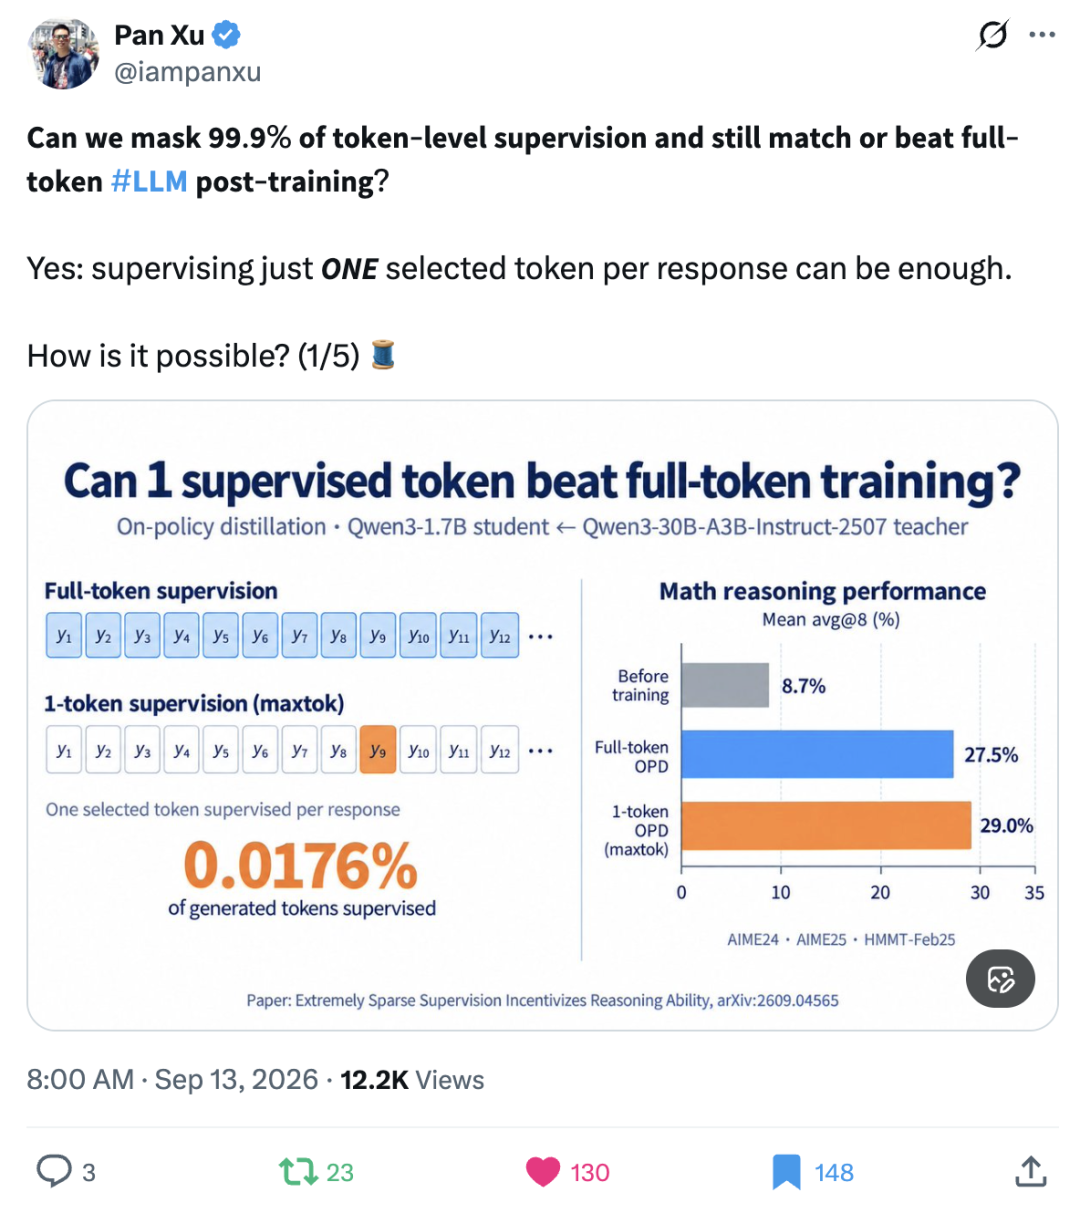
后训练是提高大模型推理能力的关键一环,一次后训练至少包含了上亿个 token 的梯度信号。以数学推理为例,大模型的一条 rollout 通常包含几千个 token,如果只保留其中一个 token 处的梯度信号做参数更新,训练会崩溃吗?
亚马逊公司和杜克大学的一项最新研究表明,在这种极端稀疏的梯度信号下,训练不但没有失败,反而取得了更好的推理性能。这项研究对一个被默认且普遍接受的假设提出了挑战:大模型后训练中密集的 token-level 信号真的是必要的吗?
一个 token 所包含的丰富信息
On-Policy Distillation(OPD,在线策略蒸馏)是近期在业界和学术界中备受关注的后训练范式,在前沿大模型训练中已成为提升模型能力和实现高效能力迁移的重要技术路径。OPD 天然具有密集的 token-level 监督信号:学生模型生成推理轨迹,教师模型对轨迹中的每一个 token 提供反馈。这种密集的 token-level 监督信号一直以来被认为是 OPD 取得成功的重要特点,但也增加了理解 OPD 内在机制的难度。
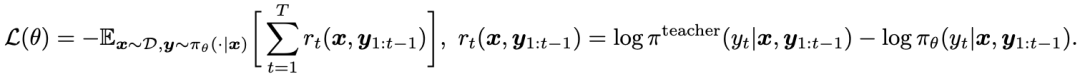
研究团队以 OPD 和数学推理为起始研究场景,做了一个极端的实验:对于学生模型生成的每一条 rollout,仅随机保留一个 token 处的梯度,使其参与参数更新,同时 mask 掉其他所有 token 处的信号。换句话说,如果一条 rollout 包含了 4000 个 token,那么只有 0.025% 的 token 得到了教师模型的监督信号。实验结果出人意料:在如此极端的稀疏信号下,学生模型的推理能力依然得到显著提升。
研究团队基于 Qwen3 系列构造了9 组不同的教师—学生配置,涵盖:
1)小参数量学生模型蒸馏大参数量教师模型;
2)同等规模的教师模型和学生模型;
3)大参数量学生模型蒸馏小参数量教师模型。
不同的设置代表了教师模型与学生模型之间不同程度的表征差异。在所有组合中,随机监督一个 token,都能一致地观察到学生模型推理性能的提升。
极端稀疏的监督信号,胜过密集监督
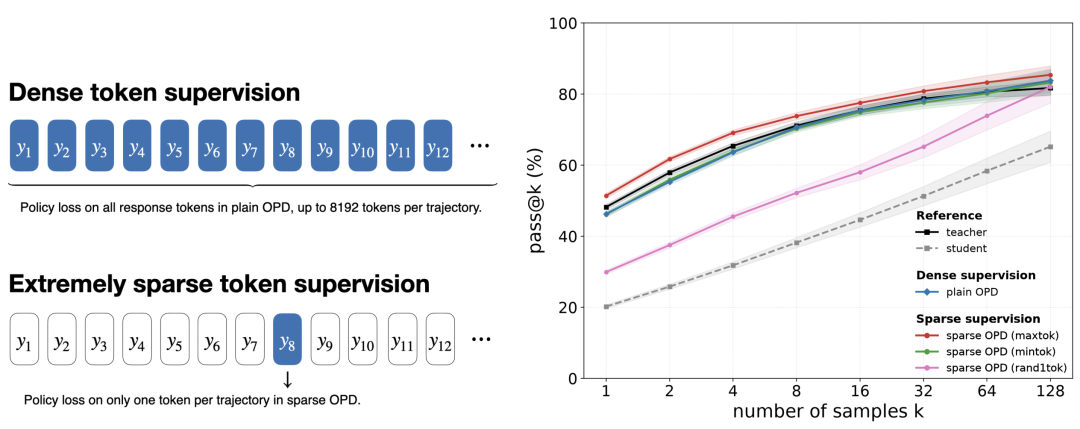
在这种极端稀疏监督的训练模式下,学生模型推理能力的提升能否进一步扩大?这涉及监督信号的选择。在 OPD 中,每一个 token 的监督信号代表了教师模型和学生模型在该 token 处的分歧度,研究团队选择保留每一条 rollout 中分歧最大的 token。实验结果表明,仅仅一到两个 token 的监督信号可以匹配甚至超过全信号训练。
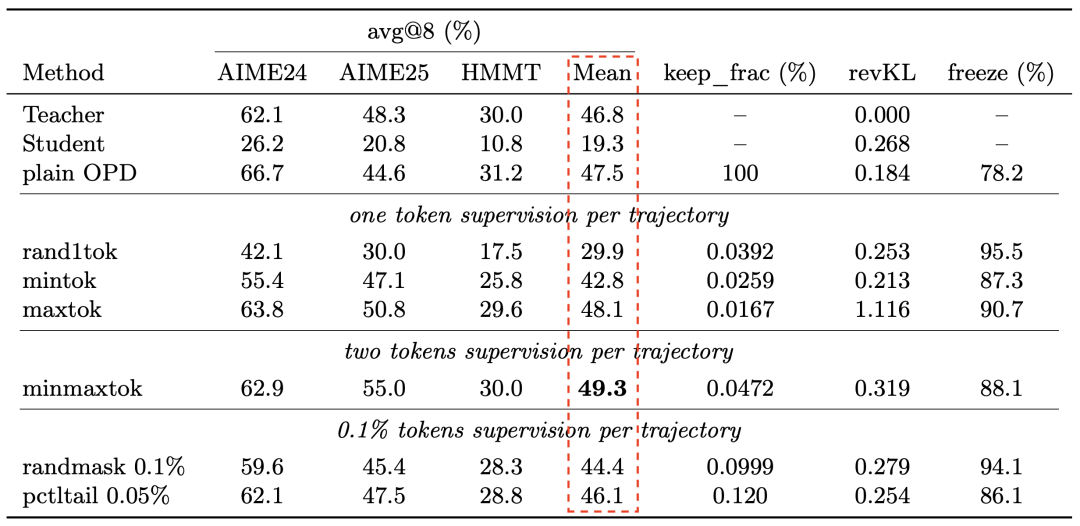
Math Reasoning OPD: Qwen3-8B student ← Qwen3-4B-Instruct-2507 teacher
如上的实验结果更是显示,监督一个或者两个 token 所得到的学生模型不仅比全信号训练得到的学生模型好,更是超过了教师模型本身。另一个有趣的观察是,尽管标准 OPD 的目标是缩小学生模型与教师模型输出分布之间的差异,但在极端稀疏监督下,推理性能最强的学生模型,其输出分布与教师模型之间的差异不仅没有缩小,反而可能进一步增大。这暗示了在极端稀疏监督的训练范式下,学生并非单纯通过模仿教师模型获得推理性能的提升。
为了进一步研究这一现象的泛化性,研究团队进行了跨任务、跨模型系列和跨后训练范式的验证,将实验拓展到了:1)代码推理任务;2)Llama 系列模型;以及 3)基于 Proximal Policy Optimization(PPO)的 Reinforcement Learning with Verifiable Reward(RLVR)。不出意料地,在这些场景下的实验结果均展现了同样的现象:极端稀疏的监督信号足以非常有效地提升模型的推理能力。
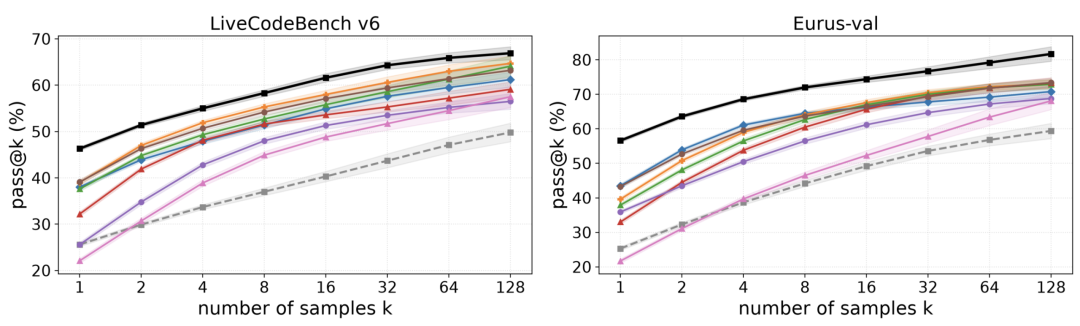
Coding Reasoning OPD: Qwen3-4B student ← Qwen3-30B-A3B-Instruct-2507 teacher
剖析极端稀疏监督背后的机制
这项工作给出了一个值得关注的数据点:一次成功的后训练,可能只需要利用几千个 token 处的梯度。在这一尺度下,研究者可以直接观察被激活 token 所承载的语义信息,以及它们对学习动力学的影响。下表展示了一些被激活且获得正奖励(教师模型希望其概率增大)的 token。
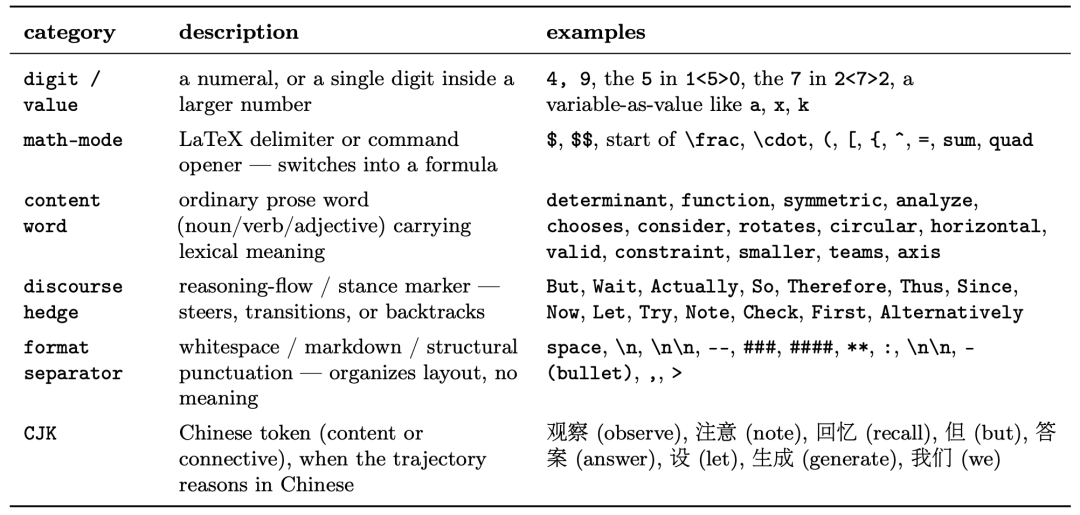
此外,研究团队利用消融试验得到了一些有趣的结论:
1)模型推理性能的提升与监督信号的稠密程度并非单调关系:随着受监督 token 的数量逐渐减少,模型推理性能起初会有所下降,但随后又会恢复;当监督变得极端稀疏时,性能甚至可以超过全信号训练。然而,当监督进一步稀疏到一定程度后,学习信号最终会变得不足,无法再带来有意义的推理性能提升。
2)OPD 实验中,当学生模型具有足够的表征能力,带正奖励的 token 可以更好地激发学生的推理能力;而当学生模型表征能力弱于教师模型时,带负奖励的 token 取得更好的训练效果。
3)极端稀疏监督也带来了更加稀疏的神经网络参数更新,万分之一的监督信号仅仅更新了 10% 的网络参数,即可取得大幅的推理性能提升。
最后,为什么一个 token 的监督信号就能如此有效?这仍然是一个开放的问题。研究团队给出了一个类比:极端稀疏监督更像是人类的自然学习过程。当人们带着一定先验知识和基础能力去学习一项复杂任务时,往往并不需要细粒度的反馈,少量但关键的纠正信号就可能显著改变后续的行为与策略。类似地,一个经过预训练、SFT 和 RL 的大模型本身已经具备了一定的推理能力;当进一步对其进行后训练时,可能并不需要覆盖每一个 token 的密集监督,少量但关键的学习信号便足以引导模型进一步调整,并带来显著的推理性能提升。
作者简介: Zhishuai Liu 是杜克大学(Duke University)的博士生,导师为 Prof. Pan Xu。本文宣传的工作是其在亚马逊(Amazon)公司实习期间完成。Dr. Xingzi Xu 和 Dr. Mehmet Saygin Seyfioglu 是亚马逊公司的 Applied Scientist,Dr. Karim Bouyarmane 是亚马逊公司的 Senior Manager。