
基于 Next.js、AWS 和沙箱环境打造 Lovable 风格 AI 应用构建器
Lovable、Bolt 和 v0 这类工具,初次使用时总带点魔力。说实话,我第一次看到类似功能时都惊呆了……明明只是在聊天窗口里操作,就能搞定这一切。当时真是让我大开眼界,甚至第一次尝试 Lovable 时还引发了些许“存在主义危机”。
但你有没有想过,幕后到底发生了什么?一个应用是如何让另一个应用具备即时的测试、分享和下载能力的?
某处肯定有个 AI 模型在写代码,这点很明确。但具体怎么实现呢?这些代码还得被安装、构建并运行。让我有些将信将疑的是,如今似乎没人在运行前仔细审查这些代码了。它们可能充满 bug,运行缓慢,甚至试图做不该做的事,比如用 rm -rf 摧毁整个系统。AI 确实干过类似的事,所以我们无法百分之百放心。
这篇文章正是为了解决这个问题。
在这篇文章中,你将构建一个 Lovable 风格的 AI 应用生成器。这不是简单的克隆,而是深入剖析 Lovable 背后的逻辑,看看它究竟如何运作。我们将保持用户界面简洁基础。
在这个项目中,用户可以用通俗的英语描述应用需求,AI 智能体将在隔离的云沙箱中编写代码。AI 会自动修复自身错误,随后展示实时预览。之后,用户可以通过聊天继续迭代,回滚到任意版本,并一键发布最终应用。
本文将涵盖:
在本教程中,你将从零开始构建整套系统。在这个过程中,你将学到:
为什么 AI 生成的代码需要沙箱环境
如何利用内存快照,将沙箱准备时间从 30 多秒缩短至约 4 秒
如何构建智能体循环,使其能够编写代码、自查工作并修复错误
如何实时流式传输智能体的操作至浏览器(且在页面刷新时不丢失状态)
如何通过自定义网关展示支持热重载的实时预览
如何使用 Git 为每次更改版本化,同时确保令牌不会进入沙箱内部
如何让空闲沙箱休眠,在需要时唤醒,并发布最终应用
这部分会涉及一些进阶概念,但跟着读下来,你会学到不少。我自己开发的时候就深有体会。😉
目录
计划与架构
在深入代码之前,先理解整体架构很有帮助,因为其中有不少概念值得提前掌握。
应用拆分为三个进程和若干基础设施组件。我从一开始就坚持一条原则:Web 应用绝不直接运行 AI agent,agent 也绝不在沙箱内运行。稍后你就会明白这样设计的重要性。
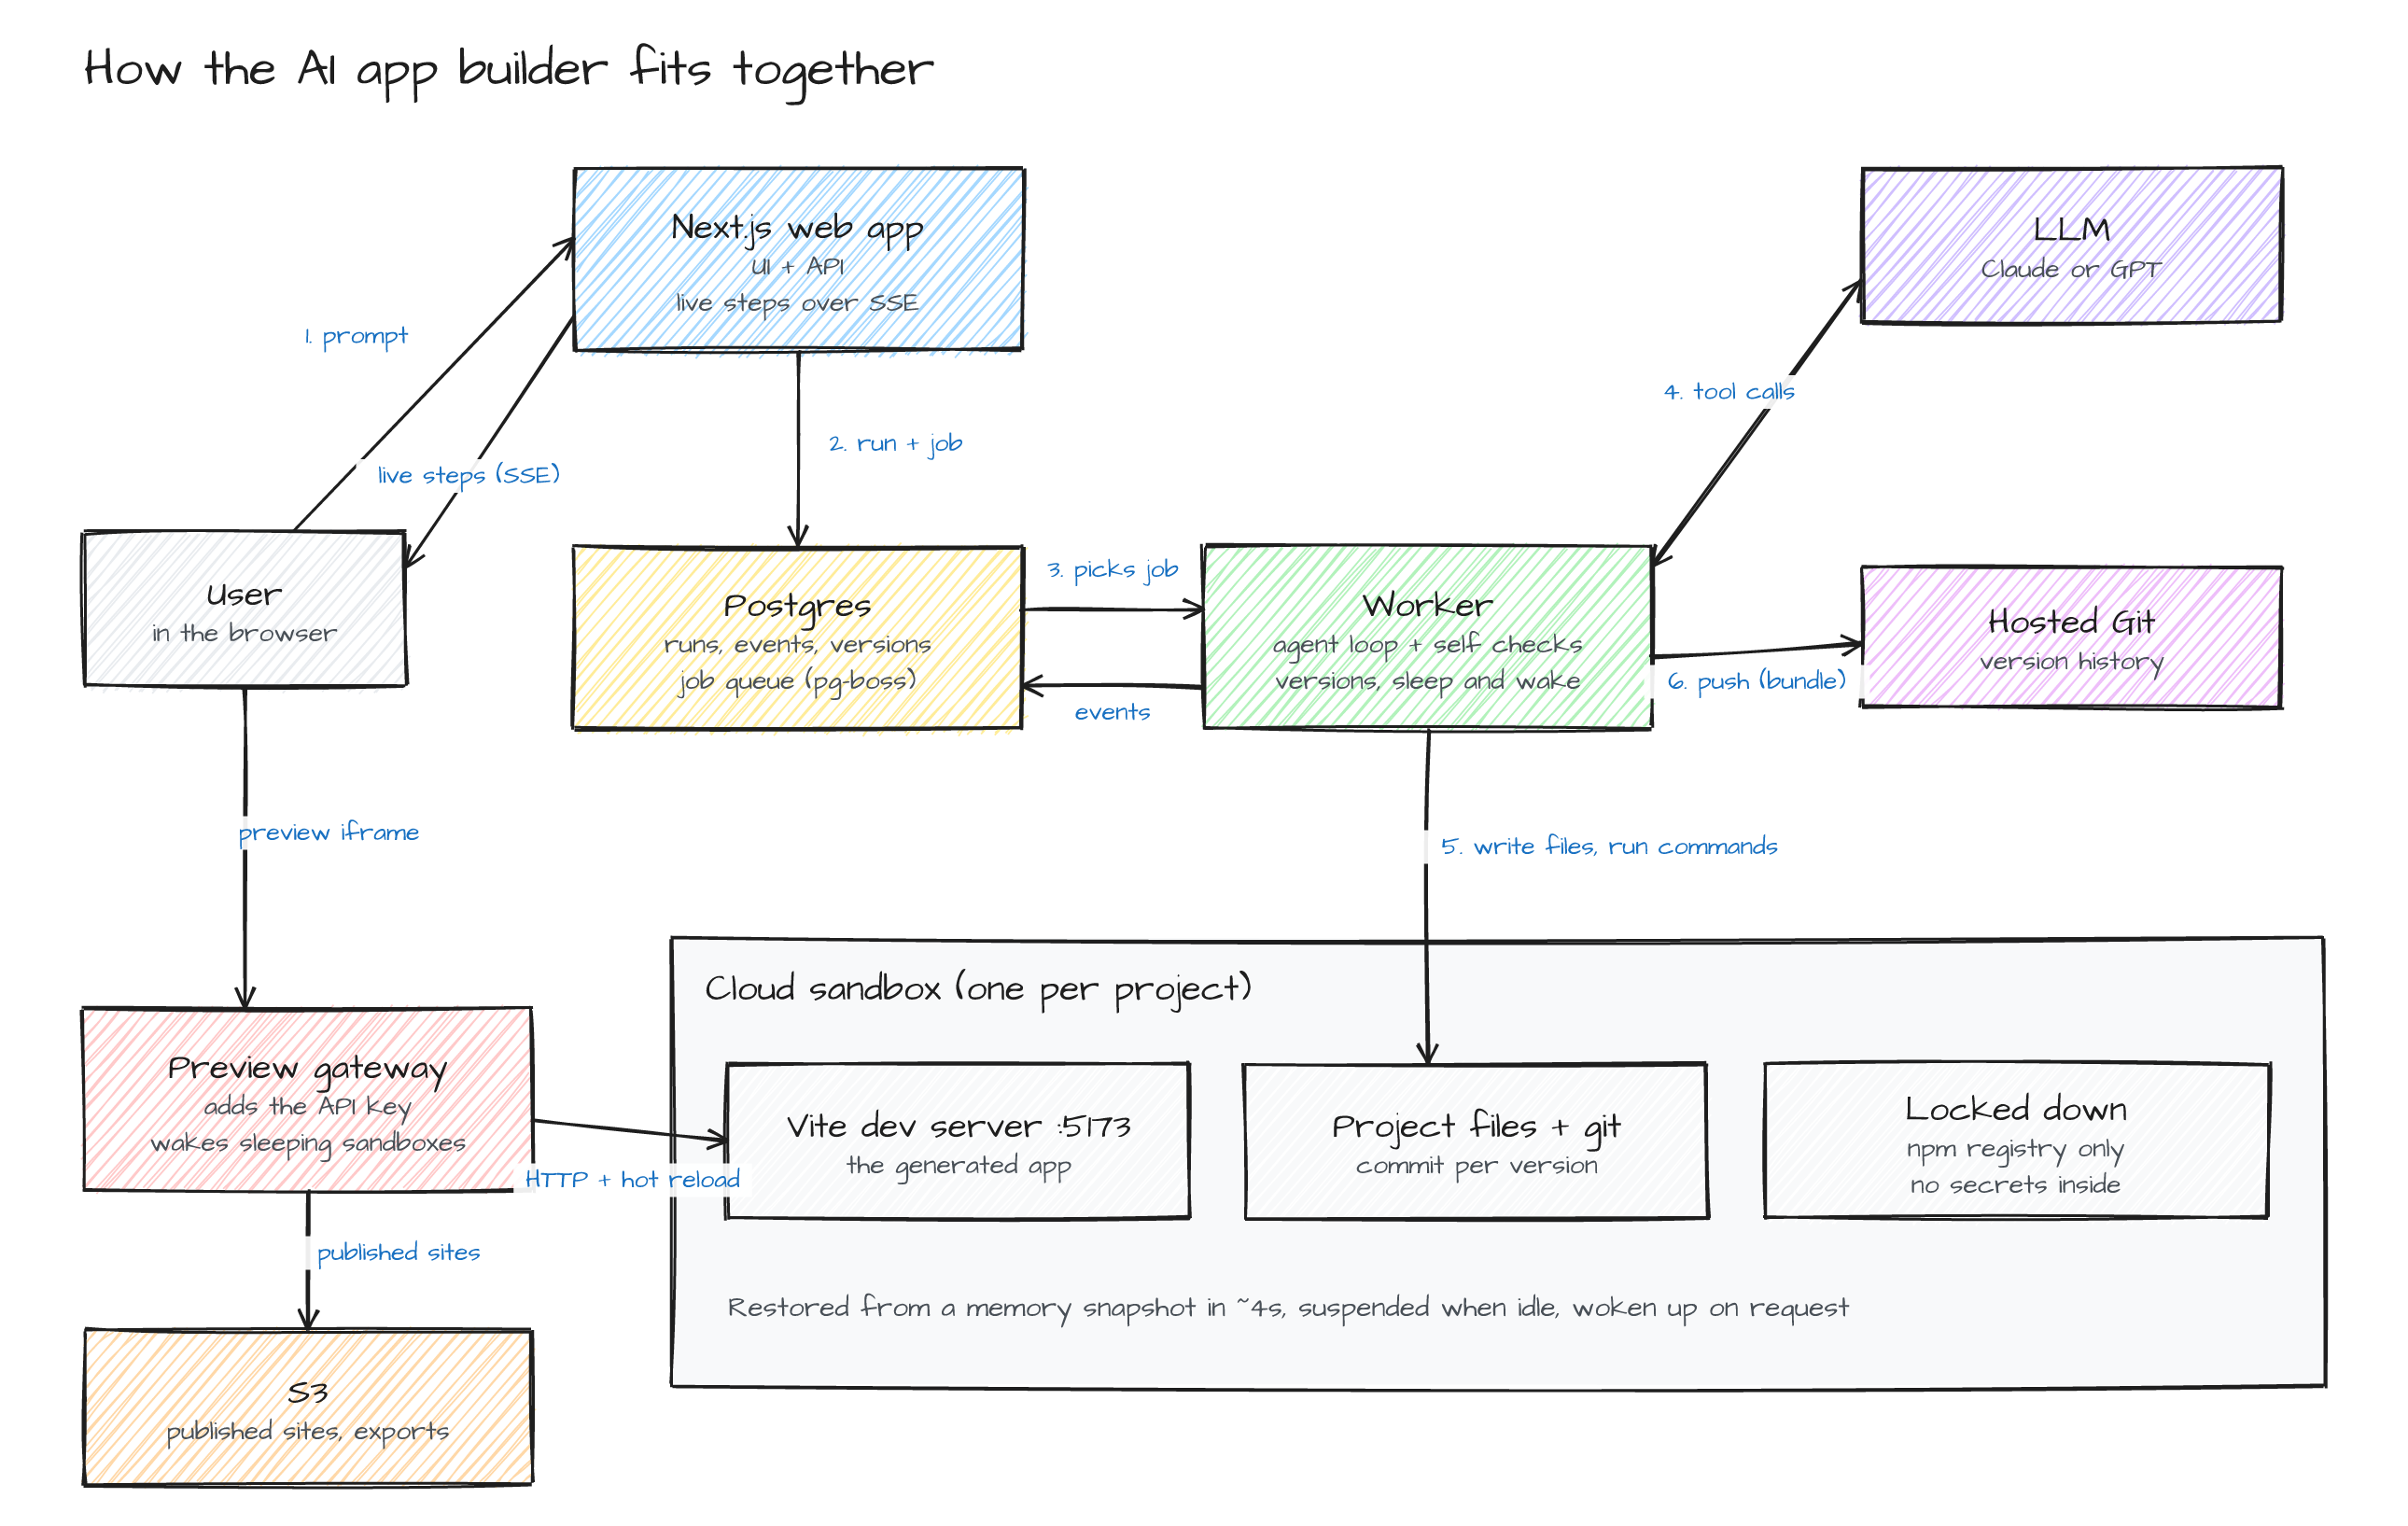
以下是完整流程:
发送提示词
用户输入提示词后,Web 应用(Next.js)将其保存,在 Postgres 中创建一个“run”,将任务推入队列,然后立即返回。这样用户就不用干等着 HTTP 请求,让 agent 慢慢执行了。
运行 Agent
worker 进程领取这个任务后,先确保项目有一个正在运行的 sandbox,然后启动 agent 循环。LLM 决定要做什么,而它发出的每一次工具调用(写文件、运行命令、安装依赖包等)都实际发生在 sandbox 里。
每一步操作还会作为事件保存到数据库,浏览器正是通过这个方式实时获取进度的。
展示预览
生成的应用在 sandbox 里运行自己的 Vite dev server。我们有一个小型 gateway 服务,把 http://<project-id>.preview.localhost:4000 代理到这个 dev server,包括 Vite 热更新用的 WebSocket。
所以当 agent 修改文件时,预览会自动刷新,说实话每次看到这一幕我还是觉得很酷。
保存与发布
agent 完成任务后,worker 会把改动提交为一个新版本。当用户点击 Publish 时,应用会被构建,静态文件上传到 S3,这样即使 sandbox 休眠了,已发布的站点也能正常访问。
这基本上就是我们应用的整体架构了。简单来说:
Next.js:UI 和 API 层
Worker(Node.js +
pg-boss):Agent 层Gateway(Node.js 代理):预览层
Postgres:状态和任务队列层
Cloud sandbox:执行层
S3(本地用 MinIO):存储层
任意 LLM(我们用的是 Claude 或 GPT):推理层
为什么需要 Sandbox?
仔细想想,这个产品的本质就是"运行没人审查过的代码"。agent 写出的代码、npm install 拉取的依赖包(其安装脚本几乎可以执行任何操作)、然后 dev server 又把这一切跑起来。这种代码我可不敢在自己服务器上运行,你也别这么做。
所以每个项目都有自己的隔离 sandbox,本质上就是云上的一个小型 VM。我在挑选 sandbox 服务商时,真正在意的是这几点:
挂起与恢复:大部分项目大多数时间都是闲置的。我希望能把它们休眠掉,并在几秒内带着完整的内存状态重新唤醒。
文件、命令与终端:智能体需要读写文件并执行命令,同时为用户提供真实的 shell 终端体验更佳。
💁 在生产环境中使用此类工具时有许多事项需要考量,但这几点是我设定的硬性要求。
这里我选用 Tensorlake 沙箱。需要说明的是,选择它并没有特定原因。E2B、Daytona、Modal,甚至你自建的 Firecracker 环境都能胜任,你可以自由选用任何心仪的方案。我此前已在多个项目中使用过该服务,对于沙箱功能而言,它表现完美,尤其契合我们的使用场景。
注意:所有沙箱相关代码都封装在一个包里(packages/sandbox)。因此,如果你想更换服务商,这里几乎是你唯一需要修改的地方。应用的其他部分甚至感知不到底层调用的是哪家服务商。
项目设置指南
开始前,请确保已安装以下环境:
Node.js 22 或更高版本
pnpm
Docker(如果你计划先在本地测试,需用于 Postgres 和 MinIO)
此外,你还需要沙箱服务商和 LLM(Anthropic 或 OpenAI,任选其一)的 API 密钥。
首先克隆代码仓库并安装依赖:
git clone https://github.com/shricodev/lovable-build-tensorlake-aws.git
cd lovable-build-tensorlake-aws
pnpm install
接着,创建环境配置文件并填入密钥:
cp .env.example .env
# 添加沙箱和 LLM 密钥,并通过以下命令生成 AUTH_SECRET:
openssl rand -base64 32
然后启动本地基础设施,创建数据库表并配置存储桶:
# 启动 Postgres 和 MinIO
pnpm infra:up

# 创建数据库表
pnpm db:migrate

# 创建存储桶并配置权限
pnpm s3:setup
构建每个新项目的基础快照(稍后会有详细解释)。耗时约 45 秒:
pnpm sandbox:build-base
最后,启动所有服务:
# web 运行在 :3000,预览网关运行在 :4000
pnpm dev
打开 http://localhost:3000,登录并描述你的应用。搞定! 🎉
注意:该应用支持通过 GitHub 登录,同时也提供了一个简单的开发者登录入口,方便你在创建 GitHub OAuth 应用之前先试用。别担心,开发者登录在生产环境中始终是禁用的。
应用核心组件
这个项目的体量很大。如果逐行讲解,这篇文章就会变成一篇耗时几小时才能读完的长篇。因此,我将重点介绍真正驱动系统运行的核心组件。仪表盘、登录和代码编辑器等都是相当标准的功能,所以就不再赘述了。
注意:这意味着下方的代码片段只保留了关键部分。完整代码可以在仓库中找到。
快速启动沙箱
每个生成的应用都基于相同的模板:Vite、React、TypeScript、Tailwind 以及几个常用库。对于每个新项目,一种直观的方式(或者说比较原始的做法)是这样的:
创建一个全新的沙箱
上传模板
运行
npm install启动开发服务器
这样确实能跑起来,但在我测试中,预览在33.4 秒后才真正可访问。其中大部分时间(约 23 秒)都花在了单核 vCPU 上运行 npm install 这件事上。我不知道大家如何,但我可不想每次启动新项目时都盯着加载图标转那么久。
解决方案是只执行一次上述所有步骤,并将结果保存为内存快照。内存快照会捕获文件、RAM 以及正在运行的进程。因此,当你恢复快照时,开发服务器已经在运行了,无需再次启动。
这是基础快照构建器的核心逻辑:
export async function buildBaseSnapshot(log: Logger) {
  // 冷路径,只执行一次:创建沙箱,上传模板,npm install,git init,
  // 验证构建通过,启动开发服务器并预热 Vite 缓存。
  const { ps } = await coldCreateFromTemplate({
    name: `base-${Date.now()}`,
    log,
    verify: true,
  });

  try {
    // 内存检查点:文件 + RAM + 运行中的进程。
    const snapshotId = await ps.checkpoint();
    writeBaseSnapshot({ snapshotId, createdAt: new Date().toISOString() });
  } finally {
    await ps.terminate();
  }
}
有了这套机制,为新项目创建沙箱就只是恢复一个快照,然后我们对其进行加固:
static async createFromSnapshot(opts: { snapshotId: string; name: string; log: Logger }) {
  const sb = await Sandbox.create({ snapshotId: opts.snapshotId, name: opts.name, timeoutSecs: 600 });
  const ps = new ProjectSandbox(sb, opts.log);

  await sb.update({
    exposedPorts: [5173],              // the Vite dev server, reachable through the proxy
    allowUnauthenticatedAccess: false, // the port URL is never public
    network: {
      allowInternetAccess: true,
      allowOut: ["registry.npmjs.org"], // npm and nothing else
      denyOut: [],
    },
  });
  return ps;
}
这里有几处值得注意:
exposedPorts让开发服务器可以通过服务提供商的代理访问,但前提是你持有我们的 API key,稍后会在网关里用到这一点。network配置是一个白名单。只要allowOut里有条目,其余所有访问都会被拦截。💁 我实际用
example.com、github.com和云元数据 IP 测试过,这些全都被拦截了,而 npm 依然正常工作。沙箱环境里完全没有任何密钥:没有 LLM key、没有数据库连接串、没有 AWS 密钥,什么都没有。所以即便生成的应用或某次提示注入想窃取点什么,里面也根本没有东西可偷。
以下是我实测的数据,统计到预览页面真正加载完成为止:
| 路径 | 耗时 |
|---|---|
| 冷启动(创建、安装依赖、启动 dev server) | 33.4s |
| 从内存快照恢复 | 4.0s |
| 唤醒休眠中的沙箱 | 2.4s |
差不多快了 8 倍,是不是很酷?😎
Agent 循环
Agent 循环是整个系统的大脑。用户每发送一次提示词,都会执行这个循环。
思路很简单,虽然实现不简单:给 LLM 一个目标和一些工具,让它调用工具,把结果反馈给它,如此往复直到任务完成。
Agent 可以使用的工具包括:
list_files、read_file、write_file、edit_file和delete_filerun_command,用于执行快速检查,比如npx tsc --noEmitinstall_packages,用于安装 npm 包get_dev_server_logs和get_browser_errors,用于调试finish,Agent 自认为任务完成时调用
每个工具其实就是一个包含 Zod schema 和 run 函数的小文件。以 edit_file 为例:
export const editFile = defineTool({
  name: "edit_file",
  description:
    "Replace one exact snippet in a file. `search` must match exactly and occur exactly once.",
  schema: z.object({
    path: z.string(),
    search: z.string().min(1),
    replace: z.string(),
  }),
  async run({ path, search, replace }, { sandbox }) {
    const text = await sandbox.readFile(path);
    const count = text.split(search).length - 1;
    if (count !== 1) {
      return {
        isError: true,
        content: `search text occurs ${count} times in ${path}`,
      };
    }
    await sandbox.writeFile(
      path,
      text.replace(search, () => replace),
    );
    return { content: `Edited ${path}`, changedFiles: [path] };
  },
});
这里的 Zod schema 承担了双重职责。它会被转换为 JSON Schema 供 LLM 使用(通过 z.toJSONSchema),同时也在模型返回内容后、任何操作触及沙箱前进行校验。如果输入无效,错误会直接回传给模型,而不会导致整个运行崩溃。
随后,实际的循环开始运行:
while (true) {
  if (signal.aborted) return result("cancelled");

  const res = await llm.chat({
    system: SYSTEM_PROMPT,
    messages,
    tools,
    signal,
    onText,
  });
  messages.push(res.message);

  const results = [];
  for (const call of res.message.toolCalls) {
    const out = await executeTool(call.name, call.input, ctx); // validate + run
    results.push({
      type: "tool_result",
      toolCallId: call.id,
      content: out.content,
      isError: out.isError,
    });
    if (out.finish) finishCalled = true;
  }

  if (!finishCalled) {
    messages.push({ role: "user", content: results });
    continue;
  }

  // The agent says it's done. Now we check. (next section)
}
这里的 llm.chat 调用是我写的一个小封装,它以统一接口同时支持 Anthropic 和 OpenAI,这样你就可以在 UI 的下拉框中轻松切换模型。
在 Anthropic 这边,我们开启了 prompt caching(提示词缓存)。说实话,成本大头基本都是它扛的。通常一轮交互会读取超过 120K 个 token,其中绝大部分直接命中了缓存。
保障文件路径安全
这个问题有点隐蔽,要不是我到处翻查,还真发现不了。沙箱的文件 API 虽然会拦截包含 .. 的路径,却会老老实实地跟随符号链接。也就是说,如果生成的代码创建了一个指向 /etc/passwd 的 leak.txt,读取 leak.txt 时拿到的就是密码文件。这可不是好兆头。
因此,每个文件工具在处理任何操作前,都会在沙箱内解析出真实路径:
async safePath(relPath: string) {
  const abs = resolveProjectPath(relPath); // rejects "..", absolute paths, NUL bytes
  const r = await this.sb.run("realpath", { args: ["-m", "--", abs] });
  const real = r.stdout.trim();
  if (!isInsideApp(real)) throw new SandboxPathError(relPath, "resolves outside the project");
  return real;
}
realpath -m 会跟随所有符号链接,告诉你路径最终实际指向哪里。如果结果落在项目文件夹之外,这次调用就会直接失败。
控制上下文体积
不要因为在每轮新提示词里都重放之前的所有工具调用。相反,每一轮都以全新的对话开始,内容只包含:
对之前每一轮的简短总结(用户问了什么,agent 做了什么)
文件树和已安装的包列表
当前的
src/App.tsx
agent 需要任何其他内容时,会自己用工具去读取。这样一来,即使项目已经历了 20 轮提示词,单轮的成本依然基本保持平稳。
让 agent 检查自己的工作
LLM 往往非常自信。哪怕构建已经一团糟,它也会轻描淡写地告诉你“一切正常”。因此,当 agent 调用 finish 时,我们不会盲信它说的话,而是在沙箱内运行三项检查:
export async function runChecks(sandbox: ProjectSandbox) {
  const tsc = await sandbox.exec("npx tsc --noEmit -p . 2>&1", {
    timeoutSecs: 120,
  });
  const build = await sandbox.exec(
    "npx vite build --outDir /tmp/build --emptyOutDir --logLevel error 2>&1",
    { timeoutSecs: 180 },
  );
  const render = await renderCheck(sandbox); // 在假 DOM 里把应用渲染一次

  return {
    ok: tsc.exitCode === 0 && build.exitCode === 0 && render.ok,
    typecheck: { ok: tsc.exitCode === 0, output: tsc.stdout },
    build: { ok: build.exitCode === 0, output: build.stdout },
    render,
  };
}
前两项很好理解,第三项才是有意思的地方。很多 bug 只在运行时才会暴露,比如 Cannot read properties of undefined (reading 'map') 这类错误。常规做法是用 headless 浏览器,但它在小型 sandbox 里又重又慢,我不想走这条路。
所以模板里内置了一个小脚本,用 happy-dom(Node.js 的假 DOM)加上 Vite 的 ssrLoadModule 把应用渲染一次:
GlobalRegistrator.register({ url: "http://localhost:5173/" });
document.body.innerHTML = '<div id="root"></div>';
console.error = (...args) => errors.push(args.join(" "));

await server.ssrLoadModule("/src/main.tsx"); // 运行真正的应用入口
await new Promise((r) => setTimeout(r, 1500)); // 等 React 渲染完成

const rendered = document.getElementById("root").innerHTML.trim().length > 0;
console.log(
  JSON.stringify({ ok: rendered && errors.length === 0, rendered, errors }),
);
整个过程大约 2 秒,不仅抓到了 undefined.map 的崩溃,还精确定位到了 App.tsx 中的具体行号。非常 Nice!
只要任何一项检查失败,错误信息就会作为新消息直接回传给 agent,让它再修一轮:
lastCheck = await runChecks(sandbox);
if (lastCheck.ok) return result("succeeded");
if (healRounds >= maxHeal)
  return result("failed", { error: describeFailures(lastCheck) });

healRounds++;
messages.push({
  role: "user",
  content: [
    ...results,
    {
      type: "text",
      text: `Verification failed. Fix these problems, then call finish again.\n\n${describeFailures(lastCheck)}`,
    },
  ],
});
默认情况下,系统运行三轮后即停止。若此时问题仍未解决,用户会收到一条诚实的反馈:“我无法完成这次任务”,并附上具体的错误信息。
向浏览器推送进度
Agent 运行在 Worker 中,而用户正盯着浏览器。因此,无论是哪一步(“已写入 src/App.tsx”、“执行了 npx tsc --noEmit”、“检查通过”等),都必须实时从 Worker 同步到浏览器。
Worker 将每一步作为一行记录写入 run_events 表,随后触发 Postgres 的 NOTIFY 通知:
export async function appendEvent(
  db: Db,
  e: { projectId: string; runId?: string; type: string; payload: unknown },
) {
  const [row] = await db
    .insert(runEvents)
    .values(e)
    .returning({ id: runEvents.id });
  await db.$client.notify(
    "events",
    JSON.stringify({ projectId: e.projectId, id: row.id }),
  );
  return row.id;
}
在 Web 端,Next.js 路由处理器通过 Server Sent Events(SSE)将这些事件流式传输至浏览器。当浏览器连接时,它会先重放当前运行实例的历史记录,然后持续监听新产生的数据行:
const pump = async () => {
  const rows = await db
    .select()
    .from(runEvents)
    .where(and(eq(runEvents.projectId, project.id), gt(runEvents.id, cursor)))
    .orderBy(asc(runEvents.id));

  for (const r of rows) {
    cursor = r.id;
    send(`id: ${r.id}\ndata: ${JSON.stringify(r)}\n\n`);
  }
};

bus.on(project.id, pump); // fired by a single LISTEN connection per process
pump(); // replay first
由于所有事件都存储在数据库中,即使在中途刷新页面也不会丢失任何信息。浏览器重新连接后,会重放当前运行实例的状态,并从断点处继续。停止按钮的工作原理相同,只是方向相反:Web 应用发送带有运行 ID 的 NOTIFY,持有该运行的 Worker 收到后随即中断执行。
注: LLM 输出的流式文本以 token 为单位逐步到达。若保存每个 token,单次交互将产生数百行数据。因此,Worker 采用缓冲机制,每隔 250ms 写入一行。这里还遇到过一个小 bug:由于每次写入都是独立的 promise,导致事件顺序错乱。将每次写入都放入同一个 promise 链中后,问题得以解决。
实时预览网关
生成的应用开发服务器在沙箱内的 5173 端口运行,提供商会将其暴露为类似 https://5173-<sandbox-id>.sandbox.example 的 URL。你当然可以直接把这个 URL 塞进 iframe 了事,但这么做有两个问题:
加载页面时浏览器需要我们的沙箱 API 密钥。这显然行不通。
如果直接公开该 URL,任何人只要猜对了地址就能打开页面,我们将完全丧失对可见性的控制。
因此我们在其前面加了一个轻量级网关。它将 <project-id>.preview.localhost:4000 映射到对应的沙箱,并在服务端自动附加 API 密钥:
const proxy = createProxyServer({ changeOrigin: true, secure: true, ws: true });

const server = http.createServer(async (req, res) => {
  const projectId = HOST_RE.exec(req.headers.host ?? "")?.[1];
  const target = await resolve(projectId); // project -> sandbox, cached for a few seconds
  if (!target.sandboxId) return send(res, noPreviewPage());

  delete req.headers.cookie; // never forward the visitor's credentials
  delete req.headers.authorization;
  proxy.web(req, res, {
    target: previewUrlFor(target.sandboxId),
    headers: { authorization: `Bearer ${API_KEY}` },
  });
});

// Vite's hot reload runs over a WebSocket, so upgrades get proxied too.
server.on("upgrade", async (req, socket, head) => {
  const target = await resolve(HOST_RE.exec(req.headers.host ?? "")?.[1]);
  proxy.ws(req, socket, head, {
    target: previewUrlFor(target.sandboxId).replace(/^https/, "wss"),
    headers: { authorization: `Bearer ${API_KEY}` },
  });
});
正是这个 upgrade 处理器让预览体验如此灵动。每当 agent 修改文件时,Vite 会通过 WebSocket 推送变更,预览界面无需刷新即可实时更新。
设置网关还有一个容易被忽视的好处。预览页面运行在不同的源(*.preview.localhost)上,而主应用运行在 localhost:3000。因此,生成的应用永远无法读取主应用的 cookie,也无法以当前登录用户的身份调用其 API。由于现代浏览器中 *.localhost 解析为 127.0.0.1,你甚至无需修改 hosts 文件即可实现这一点。
注意:模板还会向预览注入一个很小的脚本,监听 window.onerror 并把错误发送给父窗口。工作区再将这些错误转发给后端,agent 的 get_browser_errors 工具就是从这里拿到真实的运行时错误。
基于 Git 的版本管理
每完成一次 prompt 就会生成一个版本。用户可以回退到某个特定的 "prompt",效果类似 git reset。
实现上,沙箱里一个普通的 Git 就完全够用了。基础快照中已经有一个仓库,模板作为首次提交,每次成功的对话轮次结束后,worker 会提交所有改动:
export async function commitAll(ps: ProjectSandbox, message: string) {
  const out = await git(
    ps,
    `git add -A
if git diff --cached --quiet; then
  echo NOCHANGE
else
  git commit -q -m "$MSG"
  git rev-parse HEAD
  git show --name-only --format= HEAD
fi`,
    { MSG: message },
  );
  if (out.trim() === "NOCHANGE") return null;
  const [sha, ...files] = out.trim().split("\n");
  return { sha, files };
}
注意:你可能好奇为什么这里没有 exit 0。命令是通过 bash -l 执行的,在 login shell 里显式调用 exit 会触发 ~/.bash_logout,而这个镜像里它的最后一条命令会失败,导致我的退出码变成失败状态。这个问题真的折腾了我很久。😭
版本恢复永远不会改写历史。它只是让文件完全回到旧提交的状态,然后在这个基础上作为一个全新的版本提交。也就是说,"恢复到版本 1" 会生成版本 5,而你随时还能回到版本 4。不会丢失任何东西。
让历史记录持久化(不在沙箱里放 Token)
沙箱内的 Git 很好用,但它的生命周期和沙箱一样短。所以每生成一个版本后,历史记录还会推送到一个托管的 Git 仓库。
最直接的做法是给沙箱一个 Git token,直接跑 git push。但我能拿到的 token 权限范围是整个项目,而不是单个仓库。把这种 token 放进一个满是不可信代码的沙箱里?算了吧,谢了。
所以沙箱自己从不执行推送。它生成一个 git bundle(本质上是把整个仓库打包成一个文件),worker 读取这个文件,然后由 worker 自己来完成推送:
export async function pushToHostedGit(
  ps: ProjectSandbox,
  repo: string,
  dataDir: string,
) {
  await git(ps, "git bundle create -q /tmp/repo.bundle main");
  const bundle = await ps.sb.readFile("/tmp/repo.bundle");

  const mirror = join(dataDir, "git", `${repo}.git`); // worker 上的裸仓库
  writeFileSync(join(mirror, "incoming.bundle"), bundle);
  await run("git", [
    "-C",
    mirror,
    "fetch",
    "-q",
    "--force",
    "incoming.bundle",
    "+refs/heads/main:refs/heads/main",
  ]);

  const cred = await repos.credential(repo); // 短时效 token,仅在 worker 上生成
  await run("git", [
    "-C",
    mirror,
    "-c",
    `http.extraHeader=Authorization: Basic ${basic(cred)}`,
    "push",
    "-q",
    "--force",
    url,
    "main",
  ]);
}
还有一个好处是,这一机制也能支撑 remix 功能。当用户复制共享项目时,worker 会从托管仓库加载源项目的 bundle 到一个全新的 sandbox 中,原始 sandbox 甚至无需唤醒即可完成任务。
沙箱的休眠、唤醒与共享
即使没人操作,运行中的 sandbox 也会产生成本。因此,有一个每分钟运行的小型任务,会挂起任何 10 分钟内没有 Agent 活动的 sandbox。挂起操作会保留内存,因此开发服务器能完全恢复到挂起前的状态。
唤醒操作在网关层完成。如果有人打开一个休眠项目的预览,网关会显示一个持续自动刷新的“正在唤醒你的应用...”页面,并在后台恢复该 sandbox:
if (isPage && target.status === "suspended") {
  const outcome = wake(projectId, target, log); // 按项目去重
  const done = await Promise.race([outcome, timeout(4000, "pending")]);
  if (done === "busy") return send(res, busyPage());
  if (done !== "running") return send(res, wakingPage()); // 自动刷新
}
在我的测试中,休眠的 sandbox 大约 3 秒就能唤醒,应用随即加载完成。🎊
共享有限数量的沙箱
大多数 sandbox 提供商会限制同时运行的 sandbox 数量,免费套餐尤其如此。所以我添加了一个简单的并发检查器,所有操作都在 Postgres 中通过咨询锁(advisory lock)完成,确保两个 worker 不会在同一时刻做出相同的决策:
async function decide(db: Db, projectId: string) {
  return db.transaction(async (tx) => {
    await tx.execute(sql`select pg_advisory_xact_lock(${LOCK_KEY})`);

    const live = await runningSandboxesOldestFirst(tx);
    if (live.some((s) => s.projectId === projectId)) return { kind: "ok" };
    if (live.length < concurrencyLimit()) return { kind: "ok" };

    // Full. Free a slot by suspending the least recently used idle sandbox.
    const victim = live.find((s) => !busyProjects.has(s.projectId));
    if (victim) return { kind: "evict", sandboxId: victim.sandboxId };

    return { kind: "wait", position }; // everything is busy, just wait...
  });
}
为了验证这个逻辑,我把限制设为 1,在一个项目的沙箱处于空闲状态时,向另一个项目发送了提示词。结果空闲的那个进入了睡眠状态,新任务占用了它的资源。接着,我在第二个项目还在运行时,又向第一个项目发送了提示词,界面显示“正在等待空闲沙箱,队列第 1 位”,直到有资源释放为止。如果你处于更高档的套餐,只需在 .env 中提高限制值即可,其他配置无需改动。
发布应用
在开发阶段,预览功能非常好用,但你并不希望正式发布的应用依赖一个每 10 分钟就会休眠的沙箱。
因此,发布流程会将应用构建一次,并转换为纯静态文件:
export async function publish(project: Project) {
  const ps = await projectSandbox(project.id); // wakes it if needed
  const build = await ps.exec(
    "rm -rf dist && npx vite build --outDir dist --emptyOutDir 2>&1",
    { timeoutSecs: 180 },
  );
  if (build.exitCode !== 0)
    throw new HttpError(422, `The build failed:\n${build.stdout.slice(-1500)}`);

  const files = await listFiles(ps, "dist");
  const prefix = `published/${slug}/${versionId}/`;

  for (const f of files) {
    const bytes = await ps.readBytes(`dist/${f}`);
    await storage.put(prefix + f, bytes, contentTypeFor(f), cacheControlFor(f));
  }

  await savePublishedSite({ projectId: project.id, slug, s3Prefix: prefix });
  return { url: publishedUrl(slug) };
}
然后网关从 S3 为这些文件提供服务,地址是 http://<slug>.app.localhost:4000。Vite 带哈希的文件(比如 assets/index-CScgwd68.js)会被永久缓存,而 index.html 始终会重新校验,所以更新能立刻生效。没有文件扩展名的路径都会回退到 index.html,因此客户端路由也能正常工作。
发布后的站点特意使用独立子域名。如果它们放在主应用域名下,已发布应用的 JavaScript 就能带着浏览者自己的 cookie 调用你的 API——这可不是你想看到的。😺
在我的测试中,发布大约耗时 6 秒,已发布的站点加载只用了 4ms,此时沙箱还在休眠,因为整个过程完全不碰沙箱。
App Builder 实测
下面是 app builder 的快速演示:
出于好奇,我还做了一次小规模评测:把同样的三个提示词(习惯打卡、看板、带图表的支出面板)分别发给两个不同的模型,每个都在全新沙箱中运行:
| 模型 | 通过(构建 + 渲染) | 平均耗时 |
|---|---|---|
| Claude Sonnet 5 | 3/3 | 135 秒 |
| GPT 5.5 | 3/3 | 92 秒 |
六个应用全部一次通过构建和渲染,没有需要修复的轮次,说实话有点出乎我的意料。在 Claude 上,每个应用的成本大约在 $0.15 到 $0.20 之间。
结语
你觉得这个项目怎么样?自从 AI 取代了原始编码之后,这是我近期做过最有趣的项目之一。🤦♂️
用 Lovable 这类工具时,很容易以为关键全在提示词和模型上。但自己动手做一个之后你会发现,大部分工作其实都在模型之外——比如代码在哪里运行、启动有多快、怎么展示给用户、以及如何防止它做不该做的事。
如果只让你记住一点,那就是沙箱部分。把 AI 生成的代码当作不可信代码对待,给它一台独立的小机器,不存放任何密钥、几乎没有网络访问权限。至于速度和成本,交给内存快照和挂起/恢复机制就够了。
这里的扩展空间还很大。你可以给模板加上简单的后端(比如 Hono 和 SQLite),让用户构建全栈应用;或者让用户在预览中点击某个元素,从而精确编辑对应的组件;甚至可以将同一提示词生成的几种设计变体并排展示。我现在实在太累了,就不去实现了,留个机会给你。✌️
基础架构已经就绪,剩下的只是在其上继续搭建。
完整源代码可以在这里找到:shricodev/lovable-build-tensorlake-aws
文章到这里就结束了。非常感谢你的阅读,下次见。🫡