
用 GLM 5.3 Flash 编程一个月的体验复盘
当初给自己定了个挑战:整个九月只用一个高效的开放模型。听起来挺美,实际做起来并不是那么回事。烧掉 20 亿 token 之后,来聊聊这段经历。
这个月的 token 都花在哪儿了
下面是根据 AgentsView 统计的 token 分布。AgentsView 是我们Agentic 工程建议中用来追踪 AI 用量的工具之一:
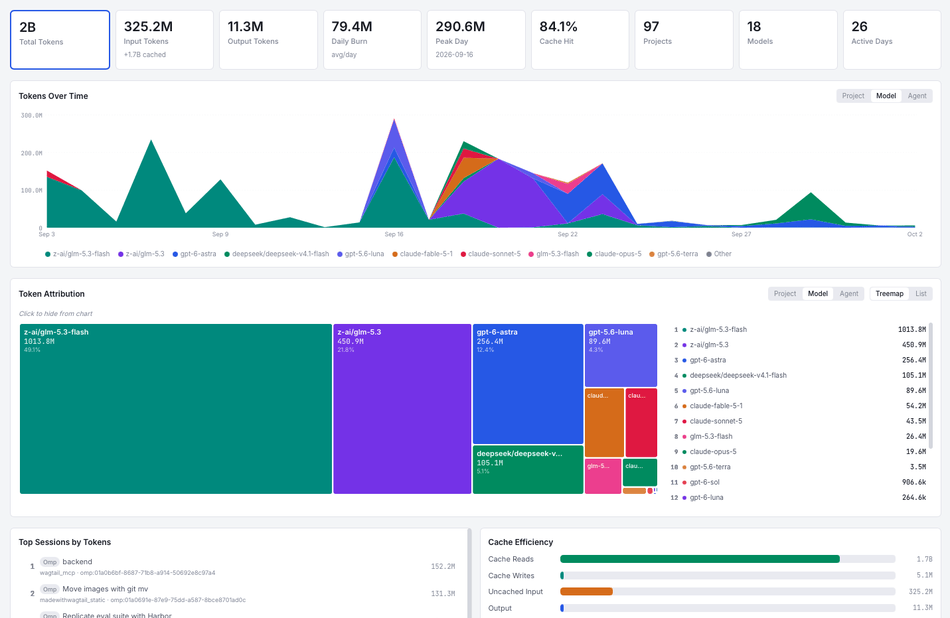
再细看模型的分布:
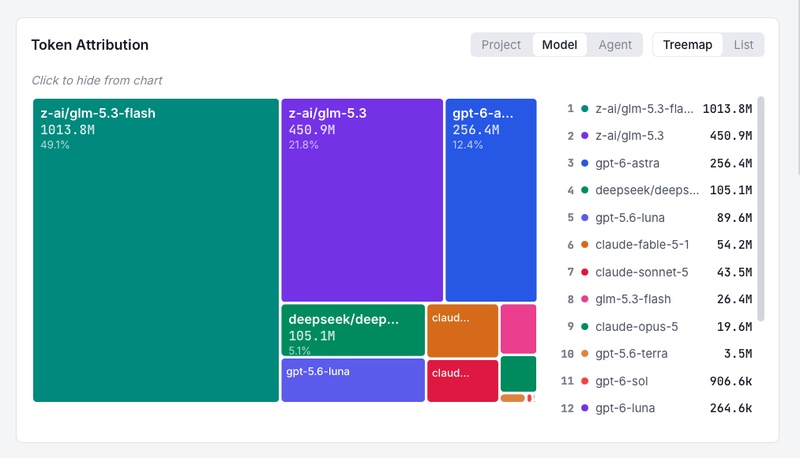
目标本来是整个月都用图中青色的 GLM 5.3 Flash。做得好的地方:
- 上半月确实只用这一个模型。
- 该模型的用量也完全在预算之内(68 美元,约合 4 千瓦时能耗 / 365 克碳排放)。
但下半月就不太顺利了,有 10 亿 token 花在了其他模型上。
意料之外的坑
先说好,这些坑其实本可以预见!但愿如此。
Vibe coding 的代价
我们一直很坦率地承认,实验性的 Wagtail MCP server 是一个 vibe coding 出来的原型。Vibe coding 平时不是我们追求的开发方式,但做原型正合适。问题在于它依然有代价。我为这个原型选了"错误"的模型,几乎一夜之间就烧掉了 4.5 亿 token / 150 美元 / 5 千瓦时能耗。好在 MCP server 本身运行良好,我们也因此有了一个展示其能力的出色 demo,所以也不算白烧:
尽管如此,这件事还是提醒我们:选模型和用 agentic 模式时都要谨慎。多花一点功夫,大概率能用五分之一的成本拿到差不多的结果。教训记下了!以后要为此做预算,也要更小心。本来能预见的坑,现在算是亲身踩过了。
基础设施的麻烦
另一个始料未及的障碍是基础设施的可用性问题。我们此前曾详细讨论过各家推理服务商的对比。通常情况下,我们的选型都能正常工作,但这些服务商非常热门,算力资源远不如那些囤积了大量 GPU 的大实验室充裕。我们注意到 GLM 5.3 Flash 的性能出现了波动,这很可能是因为该模型在我们工作相关的模型集里,正处帕累托前沿的最顶端。
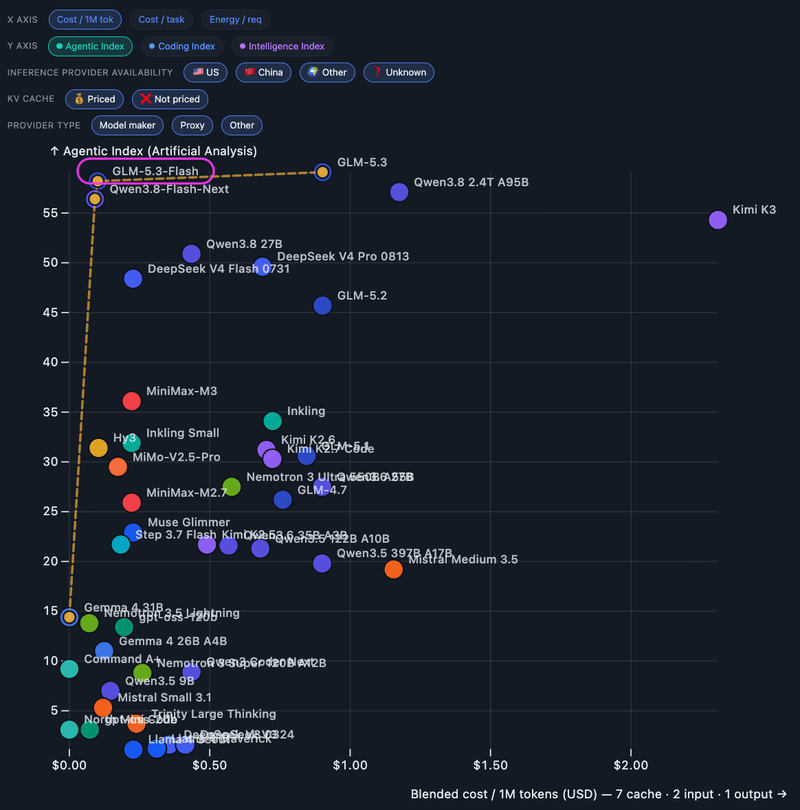
因此,我们不得不切换到其他类似的模型(如 DeepSeek V4.1 Flash、Qwen 3.8 Flash)。虽然切换本身很简单,但确实出人意料。
实验与研发的成本
实验与研发的成本
最后但同样重要的是,除了用单一模型处理日常工程工作外,不断尝试各种模型、紧跟各服务商的发布节奏也至关重要。特别是当我们开始对模型在 Wagtail 任务上的表现进行基准测试时,需要覆盖大量模型的数据。以下是我们基准测试的抢先看:
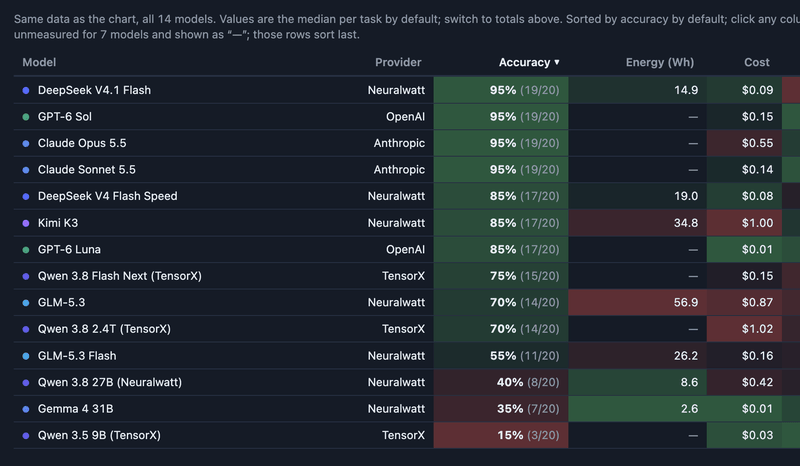
有了这类具体数据,引导大家选择更精简的选项就容易得多。同时,借助智能体技能或我们的新 CLI 原型(专为适配智能体设计),我们还能让这些选项变得更加可行。
顺利之处
当然也有不错的地方。我确实希望继续这项挑战,但仅限于 50% 以上的常规“生产”工作,不包括研发。GLM 5.3 Flash 本身表现优异!值得重申一下,根据我们的模型对比,它之所以特别适合此类挑战,在于以下特点:
- 拥有 1M 上下文窗口,因此可以执行任意复杂的编码任务。
我已经在 Wagtail 本身以及使用它构建的网站上跑通了。涵盖 UI 任务、AI 研发,还写了一些文档。做了大量的 evals。真的多才多艺。
要点及下一步计划
从技术角度来看,这次挑战失败了。目标模型的使用率仅 50%,消耗了 1B tokens 而非预期的 2B。耗电量约为 35 kWh,而非 10。但我们学到了很多,这对当下至关重要。复盘十月期间的情况,以下做法才会奏效:
- 持续进行本地使用情况的测量与报告。不仅关注 tokens,还要关注能耗和支出,理想情况下要评估这些如何带来具体的积极成果。
- 为实验设定预算,而不仅仅是日常任务。对哪些原型值得构建、以及如何构建做出更审慎的决策。
- 更优的提示词选择和多智能体技术。包括 Orchestrator、scout、implementer 和 reviewer 角色。设定有边界的目标。这并非天书,但确实是一项需要学习的技能。
- 持续推动更高效的技术和模型。Jev 风格的 decision diffusion models 如果能如此高效运行,看起来非常有前景。最新的旗舰模型在这方面也朝着正确的方向迈进。
对于日常开发工作,专注于使用一两个 flash 级别的廉价模型是完全可行的。一个可行的目标是:大部分 AI 推理工作应使用这类高效模型完成,并以成本或能耗(而非无意义的 tokens)来衡量。这就是十月的目标!你也应该试试,过程中会收获颇丰。
十一月来 Wagtail Space 2026 打个招呼,看看所有这些最终会演变成什么样子!