
GLM-5.3在ExploitBench的成绩对网络安全是利好
各位朋友:
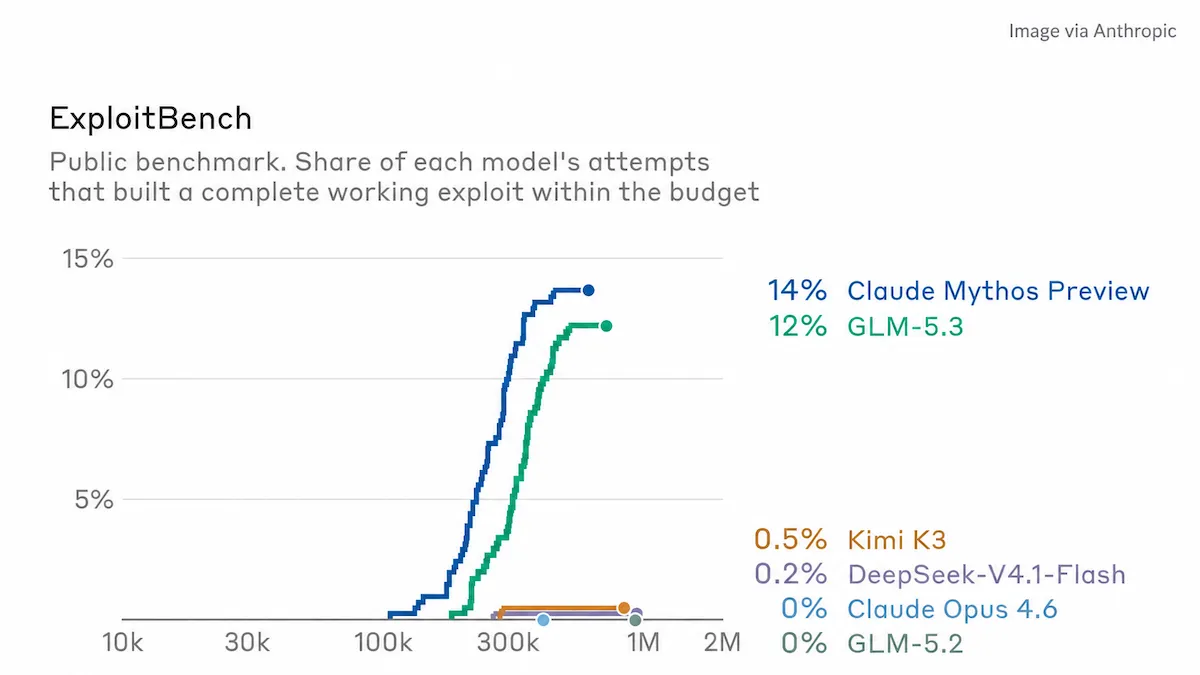
Anthropic 最近发布了一份令人振奋的分析报告,评估了开源权重模型 GLM-5.3 的网络攻防能力。研究显示,GLM-5.3 的网络能力已接近 Claude 闭源权重模型 Mythos。例如,下图表明,在消耗相近 token 数量的情况下,GLM-5.3 在 ExploitBench 任务子集上的漏洞利用成功率为 12%,而 Mythos 为 14%。(有意思的是,在 GLM-5.3 开发者自己发布的完整基准测试报告中,这一差距更小:54.4% 对 Mythos 的 78.0%。)这意味着,即使是无法使用 Mythos 的网络防御者,也能借助一个高能力模型来保护自己。既然攻击者也能获得类似的工具,加快构建防御体系的紧迫性就更加突出了。
此外,发现漏洞并据此构造攻击(也就是针对已识别漏洞构造 payload)的成本正在下降。Anthropic 发现,只花 20.40 美元购买 GLM-5.3-Flash 的 token,就足以找到 Google Chrome 一个近期披露的漏洞。这些结果是用未经修改的 GLM-5.3 得出的。而那些被削弱了安全护栏的前沿开源权重模型,也很容易获取,它们在网络安全防御(或攻击)上的效果会更强。
很多 AI 风险——包括网络漏洞和如何约束 agent——本质上是待解决的工程问题。当然,这些都是很难的工程问题!但我发现,很多渲染恐慌的情景,都隐含着一个假设:我们在这些问题上几乎不会有任何进展。
打个比方,想想航空业。根据美国国家邮政博物馆的资料,1919 年时,大约每飞行 11.5 万英里就有 1 人死亡。如今,航空公司每年的旅客飞行里程约为 6 万亿英里。按这个比例,飞机每年会“杀死”6 万亿除以 11.5 万 = 约 5200 万人,对吧?但由于我们通过工程手段让飞机安全得多,现在大约每 300 亿旅客英里才发生 1 例死亡。
同理,尽管媒体将 OpenAI 与 Hugging Face 的安全事件描述为自主智能体“失控”,但这一事件正促使各地团队着手优化沙箱机制与监控体系——这些关键改进正在让 AI 变得更安全。(在 OpenWorker 上,我们的这款支持安全工作流的智能体框架正由 Rohit Prasad、Devika Verma 和我基于 Nvidia 新的安全框架进行开发,以增强沙箱隔离能力。)
无论是航空业还是软件领域,我们通过反复发现问题、修复问题并进一步挖掘和解决根本原因,来提升安全性,从而降低未来风险发生的概率。前沿模型正在加速这一过程。
开放权重模型的强大网络安全能力确实为攻击者提供了可乘之机。但从长远来看,防御方占据优势,因为他们掌握更多信息,能够更有效地发现并缓解漏洞。关键在于尽快完成这项重要且困难的工程工作,让我们所有人最终都能拥有更安全、更健壮的软件系统。
继续构建!
Andrew
来自 DEEPLEARNING.AI 的信息
数据工程专业证书课程现已上线 DeepLearning.AI。通过四门课程,您将学习设计并构建数据生成、摄入、存储、转换及服务的系统,涵盖 AWS 及开源工具上的批处理与流式管道。课程由《数据工程基础》合著者 Joe Reis 授课。免费报名
新闻
出人意料的开放权重领先者
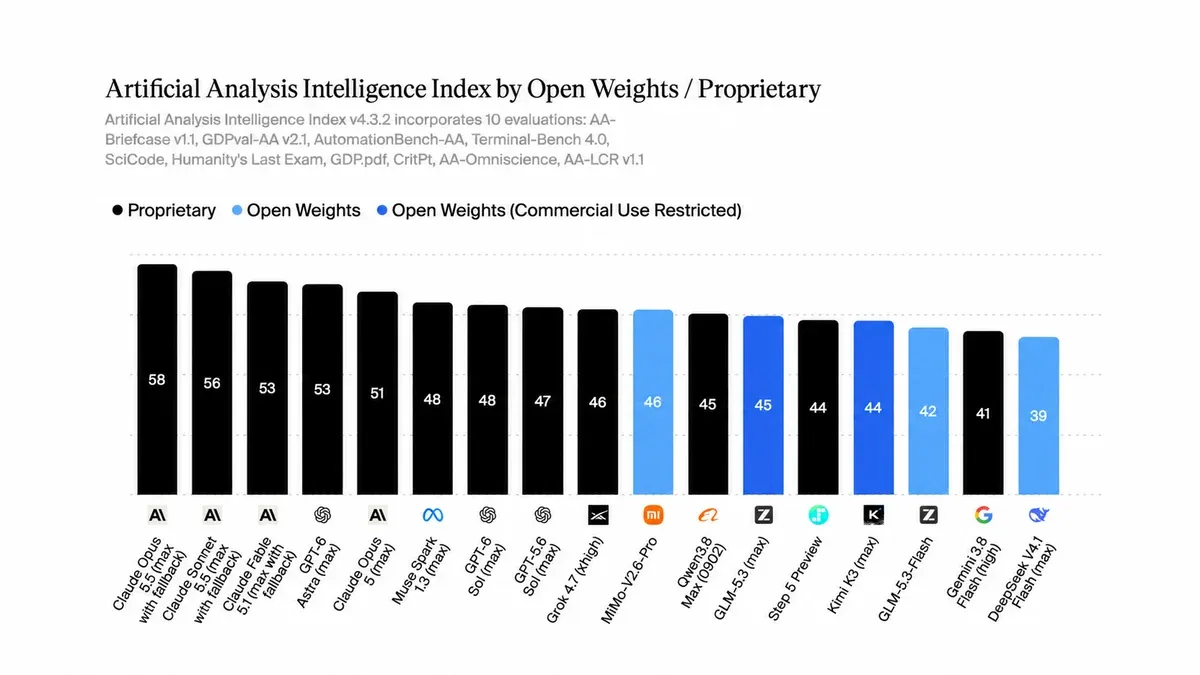
以智能手机和电动汽车闻名的企业小米,发布了在 Artificial Analysis 智能指数上得分最高的开放权重模型。其表现与 GPT-6 Sol 相当,但单次任务成本更低。
更新: 除 MiMo-V2.6-Pro-RL 及其更小的分支 MiMo-V2.6-Flash 外,小米还发布了 MiMo-V2.6-Distill-Qwen-9B(这是阿里 Qwen3.5-9B 基于 MiMo 输出数据微调后的版本)。小米还发布了 7,000 多个强化学习(RL)任务环境,以及用于训练这些环境的代码。
- 输入/输出: 支持文本、图像、视频、音频输入(最多 100 万 token);输出文本(最多 12.8 万 token,速度 44.4 token/秒)
- 架构: 专家混合(Mixture-of-Experts)Transformer;MiMo-V2.6-Pro-RL 有 1.02 万亿参数,每个 token 激活 420 亿;MiMo-V2.6-Flash 有 3090 亿参数,每个 token 激活 150 亿
- 功能: 可选的推理模式(默认开启)、工具调用、可选的 UltraSpeed 模式(生成速度提升 20 倍,但每个 token 的成本增加 10 倍)
- 性能: MiMo-V2.6-Pro-RL 在 Artificial Analysis 智能指数上以 46 分位居开源模型第一;MiMo-V2.6-Flash(59.58%)在 Vals Index 上位居开源模型第一,而 MiMo-V2.6-Pro-RL(59.47%)紧随其后,两者在误差范围内
- 可用性与价格: 每月订阅费 6 至 100 美元;MiMo-V2.6-Pro API 每百万输入/缓存/输出 token 价格分别为 0.435/0.0036/0.87 美元,UltraSpeed 模式分别为 4.35/0.036/8.70 美元;MiMo-V2.6-Flash API 每百万输入/缓存/输出 token 价格分别为 0.14/0.0028/0.28 美元;批量处理价格减半
- 权重/许可: 三款模型均可下载,采用 MIT 许可,支持商用和非商用
- 未公开: 知识截止日期和特定训练数据集
工作原理:MiMo-V2.6-Pro 通过独立的编码器分别处理图像、视频和音频,再将其输入语言模型。根据小米的技术报告,训练方案融合了此前多项工作的方法,其中不少来自小米自己。核心创新在于:对编程尝试按质量给予奖励,而不仅仅是看能否通过任务。
- 小米首先用来自网页、书籍、学术论文、代码和 STEM 材料的 27 万亿 token 文本对模型做预训练,随后再用文本、图像、视频和音频共 3 万亿 token 训练多模态能力。在中期训练阶段,小米继续用 agent 执行编程、视觉和科研任务的记录训练模型,并将输入上下文扩展到 100 万 token。
- 经过简短一轮监督微调后,小米把所有任务类型混合在一次 RL 训练中对模型微调,而不是分别训练多个专项模型。其中编程任务占 68%,网站及其他视觉作品(游戏、3D 场景、幻灯片、SVG)的设计占 13%,工具使用占 12%,网络安全占 4%,指令遵循占 3%。这次 RL 训练采用 Group Relative Policy Optimization:对每个 prompt 生成多个尝试,再让它们相互比较打分。每个训练步抽取 1,568 个 prompt、每个生成 16 次尝试,总计约 25,000 次。模型在一个极简 agent 框架的多种变体中执行任务,针对通用、编程、视觉和网络安全任务采用不同配置,从而确保成功不依赖于特定框架。整个 RL 训练共 30 步,耗时仅 123 小时多一点。
- 训练阶段使用的自动化测试只能判断代码是否能运行,无法评估其质量。为此,小米额外引入了 AI 模型对通过测试的代码进行质量评分。对于模型经常能通过测试的编码任务,系统会派遣一个代理复盘早期的尝试记录,并针对该任务制定一套评估方法质量的检查清单。训练时,每次尝试获得的奖励等于其测试结果(1 或 0)与两项检查清单得分的乘积。对于模型很难通过测试的编码任务,则采用另一种策略:一个评分模型会综合审查该任务下所有的 16 次尝试,检查代码仓库,并视情况运行测试。它根据方案的适用性、改动幅度以及与现有代码库规范的契合度等标准对通过测试的尝试进行排名。训练过程会对排名较高的尝试给予更强的强化,而对排名较低的尝试则给予较弱的强化。
- 为防范奖励作弊(例如直接下载已有的公开解决方案而非自行编写新代码),团队清除了任务环境中残留的答案,屏蔽了网络访问权限,并运行一个代理持续搜索漏洞直至确认无懈可击。一旦确认某次尝试使用了泄露的答案,其奖励将直接计为 0,等同于测试失败。在整个训练过程中,此类作弊尝试的比例始终控制在 2% 以内。
- 针对结果难以自动验证的任务(如游戏开发、科学研究及具身智能——即控制机器人等物理系统),公司训练了独立的教师模型。随后,通过在线策略蒸馏(on-policy distillation)训练 MiMo-V2.6-Pro 去模仿这些教师模型。在此过程中,学生模型学习如何调整自身输出,使其与教师模型对下一个 token 的预测保持一致。
性能表现:在两项独立的综合评估中,MiMo-V2.6-Pro 超越了所有开源权重模型,相比前代产品有显著提升。其单任务成本仅为部分专有模型的一小部分,性能即可比肩后者,但整体仍落后于头部模型,且生成速度较慢。
- 在 Artificial Analysis 的 Intelligence Index v4.3.2 中,该指数综合了数学、科学、编程和推理等领域的 10 项评估(加权平均),开启推理模式的 MiMo-V2.6-Pro(46 分,每任务 0.13 美元,耗时 19.5 分钟)领跑开源权重模型,优于开启最大推理模式的 GLM-5.3(45 分,每任务 2.01 美元,耗时 10.7 分钟)和 Kimi K3(44 分,每任务 2.00 美元)。其前身 MiMo-V2.5-Pro 得分仅为 26 分。在专有模型中,MiMo-V2.6-Pro 与开启高推理模式的 Grok 4.7(46 分,每任务 2.73 美元,耗时 14.2 分钟)持平,但落后于 Anthropic、Meta 和 OpenAI 的多款模型。
- 在 Vals Index 中,该指数根据金融、编程和法律领域在美国 GDP 中的占比,对 7 项智能体基准测试进行加权,开启推理模式的小模型 MiMo-V2.6-Flash(准确率 59.58%,每测试 0.20 美元,耗时 45.03 分钟)和 MiMo-V2.6-Pro(准确率 59.47%,每测试 0.39 美元,耗时 52.33 分钟)表现优于所有其他开源权重模型。两者均落后于 15 款专有模型,其中开启最大推理模式的 Claude Opus 5.5 表现最佳(准确率 69.69%,每测试 22.30 美元,耗时 72 分钟)。
- 在 Vals 的 CyberBench v1.1 中,该基准测试智能体能否复现并修补开源软件中的漏洞,开启推理模式的 MiMo-V2.6-Flash(准确率 75.36%,每测试 0.05 美元,耗时 32.48 分钟)在 9 款模型中排名第一,而 MiMo-V2.6-Pro(准确率 72.86%,每测试 0.09 美元,耗时 31.73 分钟)排名第三,领先于 Muse Spark 1.3 Max(准确率 72.74%,每测试 3.34 美元,耗时 19.75 分钟)和 Claude Fable 5.1(准确率 70.42%,每测试 4.03 美元,耗时 22.12 分钟)。
新闻背后: 近期,Anthropic 指控称,在 2026 年 3 月和 4 月之间的 20 天里,小米通过 OpenClaw 和 OpenCode 编程工具,将 MiMo 用户的对话和编程会话路由至 Claude,生成了超过 400,000 次交互用作训练数据。截至目前,小米尚未就 Anthropic 的指控作出公开回应。
为什么重要:能通过测试的代码不一定是好代码。小米发现,未使用代码质量评分器训练的模型版本养成了一些坏习惯,让软件更难维护:模型会添加任务不需要的代码、悄悄放过错误、对输入数据的校验也敷衍了事,只求测试通过。而使用代码质量评分器训练后,模型的改动更小、更有针对性。奖励“人类审查者会认可的代码”和奖励“能跑起来的代码”同样重要。
我们的看法:开源权重很好,开源配方更好。小米公开了强化学习任务、运行任务的软件和训练代码,让其他人可以复现其模型大部分性能提升的步骤。它还披露了成本:MiMo-V2.6-Pro 花费 260 万美元,MiMo-V2.6-Flash 花费 90 万美元。计划训练智能体的团队由此获得一套现成的任务,以及这一规模下强化学习的大致价格。希望其他实验室能复现并拓展小米训练这些模型的经验。
语音、视频与推理三合一
Google 发布了两款新的语音到语音模型,加入这个突然变得拥挤的语音智能体模型赛道。
最新动态:Google 推出了 Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking 两款语音到语音模型,可充当实时语音智能体。Gemini 3.8 Live 主打规模化和成本效益,而 3.8 Live Extended Thinking 面向高复杂度任务。两款模型都旨在降低实时对话的响应延迟。
工作原理: 谷歌未公开模型架构和训练数据的详细信息,但确认这些模型基于 Gemini 3 Pro 构建。Gemini 3.8 Live 支持图像和视频输入,涵盖 97 种语言,并能在后台执行工具和 API 调用的同时继续对话。Live Extended Thinking 还能同步进行推理和思考。这些模型的知识截止时间为 2025 年 1 月。
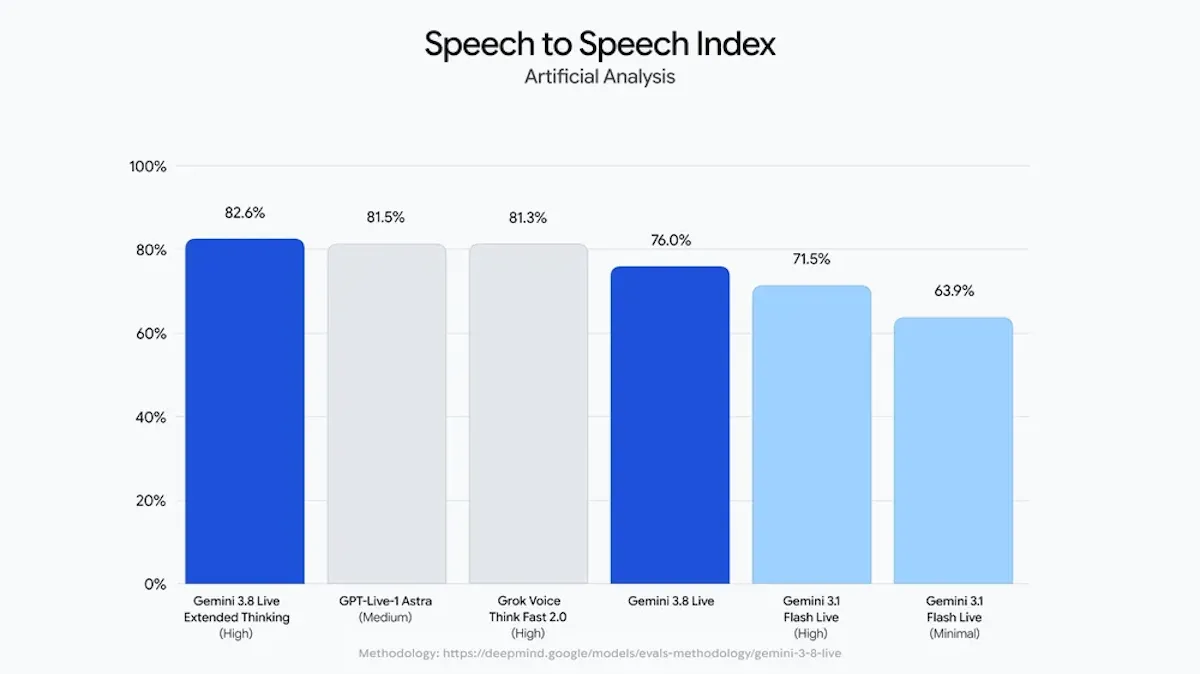
- 在 Artificial Analysis(一家 AI 模型评估机构)发布的语音到语音基准测试中,Gemini 3.8 Live Extended Thinking 在多项测试中的表现通常优于其性能较弱的“兄弟”模型 3.8 Live,但部分任务用户更偏爱 3.8 Live。Live Extended Thinking 在Speech to Speech Index 基准测试中位列第一,得分为 82.6%。在 AA 的语音推理基准测试(评估语音模型回答基于推理问题的能力)中,它排在第四位,落后于 StepAudio 3 Realtime 和两个 Qwen 模型。它在 Tau Voice 基准测试中同样位居榜首,得分为 68.6%。相比之下,Gemini 3.8 Live 在 Speech to Speech Index 中的表现稍低,得分 76%,位列第五;在 Agentic Performance Benchmark 中则显著落后,得分仅为 30.1%。然而,3.8 Live 在 Speech Agent Arena Leaderboard 中排名第二。在该排行榜中,用户进行盲测实时语音对话,并从中挑选在预约牙医等任务中更令人满意的模型。在衡量对话动态及任务正确完成率的某些基准测试中,3.8 Live 的表现也优于 Live Extended Thinking。
- 开发者可通过 Gemini API 和应用、Google Cloud Vertex / Vertex AI 以及 Google AI Studio 获取这些模型。Gemini 3.8 Live 也用于 Search Live,而 Gemini 3.8 Live Extended Thinking 则支撑 Gemini 应用及包括 Docs 和 Gmail 在内的 Google Workspace 产品中的语音体验。
- 谷歌表示,其 AI 产品生成的所有音频都带有 SynthID 水印,这是一种用于检测 AI 生成内容技术。
- 两款模型均可免费使用,但部分功能存在限制,适用于 Gemini App、Google Search 及 Gemini API 等特定产品。付费层级的查询不会用于改进模型,而免费层级则会。付费层级按百万个 token 计价:文本输入费为 $0.75,音频为 $3.00(或每分钟 $0.005),图像或视频为 $1.00(或每分钟 $0.002)。输出方面,每百万文本 token 收费 $4.50,音频为 $12.00 或每分钟 $0.018。Artificial Analysis 发现,Gemini 3.8 Live 每小时的输入音频成本为 $0.84,是指数中最便宜的模型,且远低于 Live Extended Thinking 的每小时 $3.50。
幕后背景:传统语音智能体依赖于一条 流水线:将 语音转换为文本,发送给推理模型,再将响应转换回语音。由于 LLM 通常基于文本进行推理,这种方法传统上被认为更准确,且更容易让开发者掌控。然而,每个步骤都可能增加延迟,从而降低用户体验。OpenAI 近期发布了一款名为 GPT-Live-1 的语音到语音模型,开发者可将其用于构建具备语音功能的应用。该模型能同时听和说,因此可以处理打断并做出更自然的回应,而单独的推理模型则在后台运行。
为何重要:称 Gemini 3.8 Live 为语音模型是准确的,因为其主要的语言输入是语音而非文本,但其对图像和视频输入的理解与推理能力使其更加通用。将语音和视频输入结合起来,对于帮助用户在实时场景下处理屏幕上的任何内容(如网页界面、游戏、多应用工作流等)尤其强大。这使得它区别于 GPT-Live-1 及仅支持语音和音频的其他模型。
我们的思考:语音驱动的智能体对开发者来说格外有吸引力,因为它为构建应用提供了一种全新的实时交互界面。语音是最自然的输入方式,无论用户对电脑熟悉与否都能轻松使用。在文字输入不太方便的场景下(比如手机和车载系统),语音的价值尤为突出。如何让更多普通用户便捷地用上 AI,就看开发者们的了。
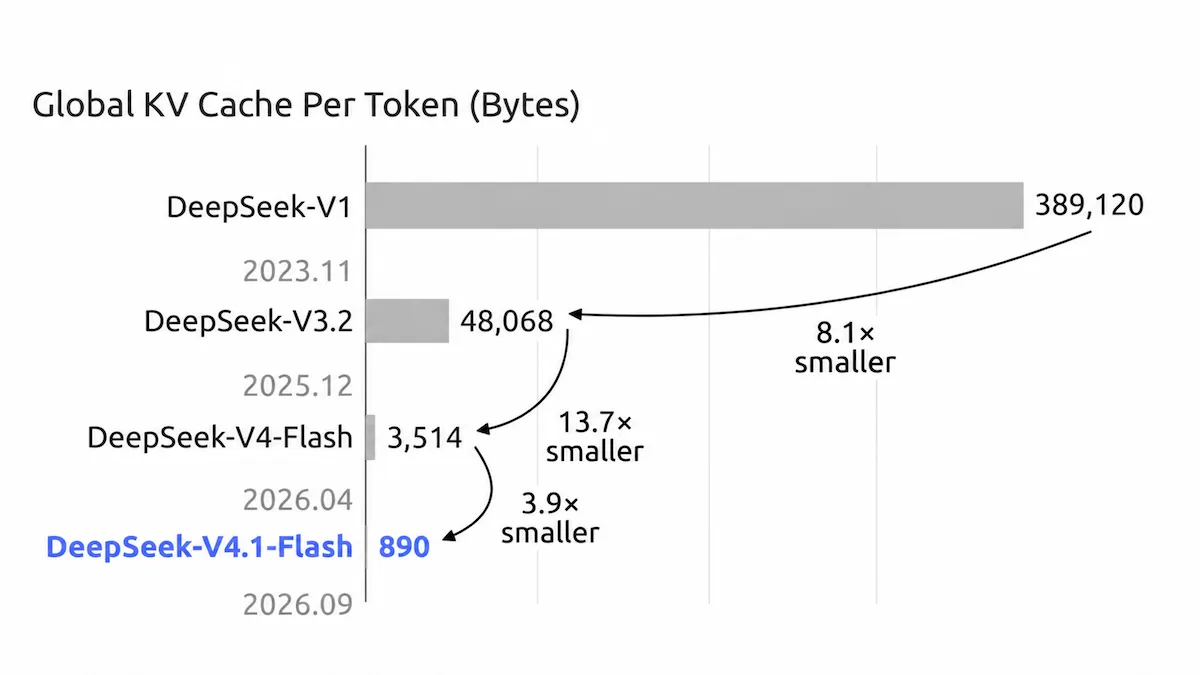
DeepSeek 的 Flash 再次超越 Pro
智能体每次调用工具时,都会把同样的上下文重新传一遍给模型。DeepSeek 认为,相比模型生成输出所需的计算,存储和传输这些上下文已经成为压低推理成本的更大瓶颈。而它的新架构正是绕开了这个瓶颈。
最新动态:DeepSeek 发布了 DeepSeek-V4.1-Flash,这是其首个采用全新架构、每 token 上下文内存占用大幅降低的模型。API 价格也同步下调。这也是 DeepSeek V4 系列中首个在非实验预览阶段就支持图像输入的模型,而且速度极快,每秒生成 token 数仅次于 Gemini 3.8 Flash。
- 输入/输出:支持文本和图像输入(最多 100 万 token),文本输出(最多 38.4 万 token,每秒 225.6 token)
- 架构:编码器-解码器混合专家 Transformer,配备基于 Transformer 的视觉编码器;主干参数 5520 亿,另有 1960 亿参数的记忆模块;读取输入时每 token 激活 80 亿参数,生成输出时激活 160 亿
- 功能:推理模式(通过 API 可选 none、low、high、max;开源权重中支持 1 到 100 任意整数)、工具调用、上下文缓存
- 性能:在 Artificial Analysis 智能指数上得 39 分;发布时是 Vals AI 指数上排名最高的开源权重模型(目前第四,51.32%)
- 可用性/价格:可通过 DeepSeek 应用和官网使用;API 定价为每百万输入/缓存/输出 token $0.30/$0.006/$1.20(高峰时段),其余时间半价
- 权重与授权:免费,允许在商业和非商业场景下使用,采用 MIT 许可证
- 未公开信息:知识截止日期、训练数据
工作原理:一篇论文详细阐述了 DeepSeek 如何重构其 V4 架构。作者缩减了 key-value cache(Transformer 为每个已读取的 token 存储的键和值,以避免重复计算)以及读取输入时消耗的计算量。
- 模型共有 40 层,其中一半负责读取,另一半负责写入。每个 decoder layer 不再针对完整输入独立计算自身的键和值,而是从 encoder 的最后一层派生这些数据,因此提示词的大部分仅需通过 encoder 处理。DeepSeek 表示,这使 prefill 计算量(生成回复前读取提示词的过程)近乎减半。
- 大多数层会借用其他层的 cache。在 DeepSeek-V4.1-Flash 中,每一层采用三种模式之一:Full layer 计算键和值,并选择 512 条最相关的条目进行关注;Reindex layer 借用前一个 full layer 的 cache,但自行选择要关注的 512 条条目;Reuse layer 则直接借用更早层级的 cache 及其已选出的 512 条条目。在 40 层中,仅有 4 层计算完整输入 cache,即 encoder 中的 3 层和 decoder 中的 1 层。每一层都保留属于自身的、针对最近 128 个 token 的非压缩 cache(基于该层对文本的独立视角计算),从而能完整关注近期 token,而共享 cache 则提供源自整个输入的 512 条最相关条目。
- DeepSeek-V4.1-Flash 的完整输入 cache 采用 4-bit 而非 8-bit 存储。每 16 个数值共用一个 8-bit 乘数来恢复该组数的 scale,并通过微调训练让模型容忍舍入误差,以维持精度。跨层共享 cache 加上 4-bit 存储,使整个输入 cache 降至每 token 890 字节,约为 DeepSeek-V4-Flash 的四分之一,仅为 DeepSeek-V1 的四百三十七分之一。综合这些改进后,当输入长度从 4,000 个 token 增加到 100 万个 token 时,生成每个输出 token 所需的计算量仅上升 25%。 * DeepSeek 的服务器会为每个提示词保留至少 72 小时的全输入缓存,因此重复的前缀无需重新计算。相比之下,DeepSeek-V4.1-Flash 仅在服务器内存中保留这些缓存几分钟。如果请求到来时缓存已过期,系统会重新读取提示词的最后 128 个 token 来重建近似版本。由于每一层的短程缓存都依赖于其前一层,要实现精确重建,需要对 40 层中的每一层都重新读取 128 个 token(总计 5,120 个 token)。DeepSeek 表示,这种近似方法对输出质量的影响微乎其微,并且将缓存需求降低至 DeepSeek-V4 的八分之一。 * DeepSeek 使用 45 万亿个文本和图片 token 对模型进行了预训练。随后按照 DeepSeek-V4 的流程进行微调:先是有监督学习,接着是强化学习,最后是在线策略蒸馏。在此过程中,模型被微调以匹配 40 多个专家模型会生成的内容。这些“教师”模型来自 DeepSeek 不同训练阶段和领域的自身检查点。 * DeepSeek 声称没有更改其训练算法;作者将性能超越 DeepSeek-V4 归功于能够自动生成训练任务和智能体环境的自动化流水线。 独立评估者发现,DeepSeek-V4.1-Flash 的性能优于其前代产品及更大的 DeepSeek-V4-Pro-0813。它在每个任务上的成本不到后者的一半,且生成速度快两倍有余。它曾短暂占据 Vals.ai 指数上开源权重模型的首位(在 MiMo v2.6 Pro 发布之前),并在一个针对商业软件智能体的独立测试中位列所有模型之首。 * 在 Artificial Analysis 的智能指数 v4.3.2 中(该指数综合了数学、科学、编码和推理领域的 10 项智能体评估),DeepSeek-V4.1-Flash 在最大推理设置下(每任务 39 分,0.27 美元,耗时 4.9 分钟)的表现优于同样处于最大推理设置的 DeepSeek-V4-Pro-0813(每任务 36 分,0.67 美元,耗时 8.7 分钟)。在开源权重模型中,其表现略逊于 MiMo v2.6 Pro(46 分,每任务 0.13 美元)、GLM-5.3(45 分,每任务 2.01 美元)和 GLM-5.3-Flash(42 分,每任务 0.25 美元,耗时 11.1 分钟)。 * 在 AutomationBench-AA 测试中(该测试衡量智能体在模拟应用环境如 Gmail、Salesforce 和 Jira 中完成业务工作流的能力),DeepSeek-V4.1-Flash 在最大推理设置下的得分(68.9%)领先于所有受测模型,包括处于最大推理设置的 GPT-6 Astra(68.5%)和处于 xhigh 推理设置的 Grok 4.6(67%)。
- 2024 年 5 月,DeepSeek-V2 引入 multi-head latent attention,把 key 和 value 压缩成小向量,使 key-value 缓存相比 DeepSeek 67B 减少了 93.3%。三个月后,DeepSeek 开始把缓存存到硬盘上,并对缓存中已有的输入按十分之一的价格收费。
- DeepSeek-V4.1-Flash 的设计基于 YOCO——微软与清华大学 2024 年提出的架构,其中 Transformer 上半部分层复用下半部分生成的缓存。
- 此次发布正值 Anthropic 指责 DeepSeek 及其他六家中国开发者通过蒸馏 Claude 模型来改进自家模型、并把 Claude 的输出提供给用户几天之后。DeepSeek 的论文称其模型是从自家 40 多个不同训练阶段的 checkpoint 蒸馏而来,未提及使用外部模型。
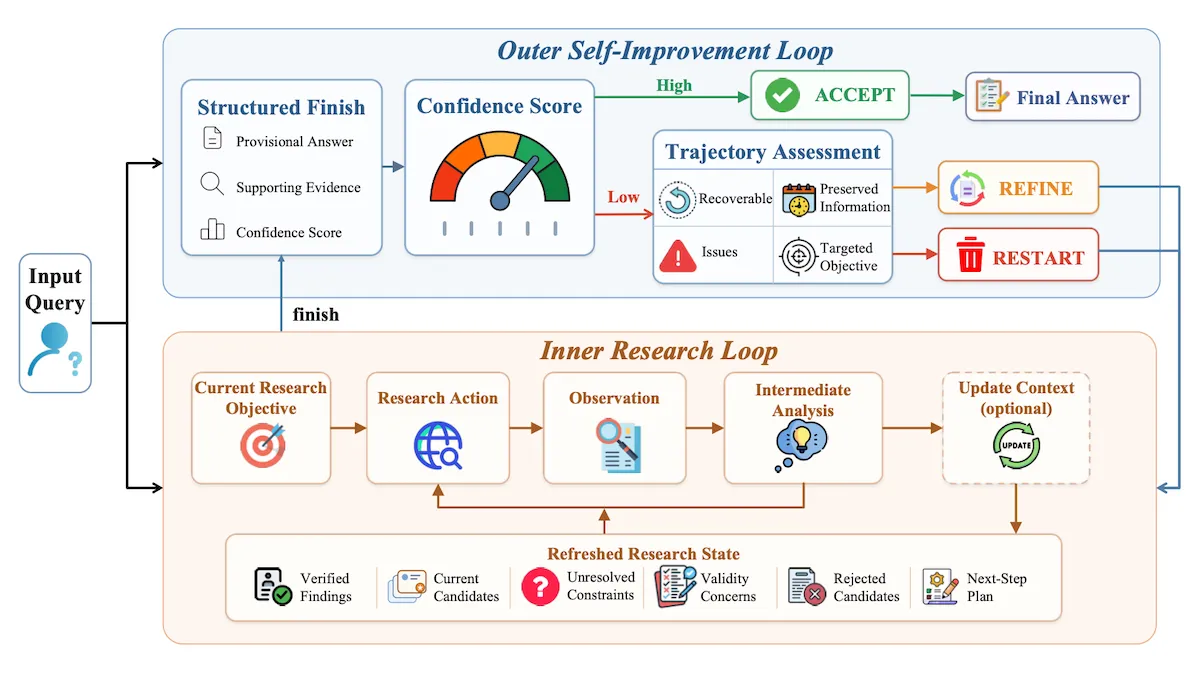
- 他们设计该框架,让智能体先执行典型的研究动作:搜索网络、阅读网页并构建临时答案。过程中,智能体可随时调用工具,将追踪记录压缩为简要的研究状态,记录已验证的事实、已考虑并排除的假设、未决疑点以及下一步计划。
- 当智能体判断进一步研究难以提升答案质量时,它会生成一个附带 0 到 100 置信分的答案。如果分数超过作者设定的阈值,智能体便接受该答案;若未达标,智能体要么精修现有工作(保留有用证据,聚焦剩余缺口),要么从头开始。
- 为了构建数据集,作者为研究问题创建了模板提示词,这些问题需要综合多个来源、进行多步规划或推理,或整合学术论文。他们使用这些模板和一个未指明的模型生成问题,然后将 harness 与未指明的模型配对,让模型回答问题并记录其执行轨迹。
- 他们使用监督微调训练两个 Qwen3.5 模型以复现这些轨迹。随后,应用强化学习训练模型生成答案。由于长轨迹包含许多常规步骤,而决定性步骤很少,他们使用手写规则来标记最重要的时刻,例如模型发现关键证据、放弃错误假设或浓缩研究状态时。在监督微调和强化学习期间,他们将训练信号集中到这些被标记的决策点上。
- 在测试多步网络搜索的 BrowseComp 上,基于微调后 Qwen3.5-122B-A10B 的 AREX 系统达到了 82.5% 的准确率。这一结果略低于表现最佳的竞争者——作者将 harness 与 Gemini Pro 3.1(据推测是更大的模型)配对——后者达到了 85.9%。
- 在评估从多个检索来源综合输出的 WideSearch-en 上,基于微调后 Qwen3.5-122B-A10B 的 AREX 系统达到了 82.0% 的 F1 分数。这一结果超越了表现次佳的系统——作者将 harness 与 Kimi-K2.6 配对——后者达到了 80.8% 的 F1 分数。
- 与仅执行研究代理典型步骤的、配对相同模型的 harness 相比,作者使用微调后 Qwen3.5-122B-A10B 的 harness 将性能提高了最多 10 个百分点(在 BrowseComp 上)。
- 同样,微调显著提升了系统性能。在 BrowseComp 和 WideSearch-en 上,未经微调的类似系统性能下降了多达 20 个百分点。在六个基准测试中的五个上,基于相对较小的微调版 Qwen3.5-4B 的 AREX 系统,表现超过了基于大得多的未微调 Qwen3.5-35B 的系统。
背景:压缩 key-value 缓存是 DeepSeek 从第二代模型延续至今的一贯思路。各家竞品也在借鉴 DeepSeek 的技术并自研方案,在缓存大小上一较高下。
为何重要:Agent 读取的内容通常远多于写入。由于每次工具调用都要把不断增长的对话记录重新送入模型,存储和反复读取上下文的成本可能超过生成输出的成本。DeepSeek 的降价恰好落在长时运行 Agent 消耗 token 最多的地方:缓存命中的输入成本下降了 57%,而输出成本仅下降 9%。
我们的看法:一年前,各家模型厂商还在竞相拉长上下文窗口。DeepSeek-V4.1-Flash 保留了前代的 100 万 token 上下文,转而让维护上下文的成本更低:每 token 仅需 890 字节缓存,比 DeepSeek-V1 小 437 倍,比 DeepSeek-V4-Flash 小 4 倍。如果其他厂商跟进,今后的发布或许会把每 token 缓存大小与上下文窗口、每 token 价格并列宣传。
能逐项自查的 Agent
当遇到需要深度推理或调用工具才能解答的问题时,智能体往往搜了个寂寞,或者反复使用无效策略,甚至草草接受未经充分验证的答案。通过迭代方式构建答案,可以有效弥补这些短板。
最新动态: 北京智源研究院的研究人员开发了 AREX,这是一款研究型智能体,通过不断循环获取证据、反思临时答案并发起针对性后续搜索来打磨其表现。这种“迭代框架 + 微调模型”的组合,性能优于其他竞争性方案。
核心洞察: 早期的一些 智能体 会将候选答案与问题要求逐一比对,然后决定接受或拒绝。然而,校验过程可以做得更多。如果临时答案未满足所有要求,逐项检查能揭示哪些条件仍缺乏支撑,以及现有证据中哪里存在冲突。智能体不必直接丢弃答案,而是保留已确认的部分,将未满足的要求作为下一次探索的起点。这将原本非黑即白的通过/失败判断,转化为推动持续改进的循环。
工作原理: 作者构建了一个智能体框架(harness)来解答高难度研究问题。他们利用该框架构建数据集,并微调了两个模型以提升配合效率:一个是较小的 Qwen3.5-4B,另一个是参数规模大得多的混合专家模型 Qwen3.5-122B-A10B。
结果:在六个 agentic 基准测试中,基于微调后 Qwen3.5 模型的 AREX 系统,表现优于使用相同 harness 和类似规模模型的配置,也优于未经微调的 Qwen3.5 模型。
为什么重要:研究型 Agent 通过微调和反复改进输出都能获得更好的表现。这种识别并放大信息量最大的决策点的训练策略,为改进 Agent 行为提供了一个实用经验:长轨迹中的每一步并非同等重要。把训练聚焦在关键决策点上,比一视同仁地对待每个动作效果更好。
我们的看法:作者使用手写规则而非学习得到的模型来检测并筛选训练样本。这些规则让模型学会了如何把长轨迹压缩成更有价值的决策点。这个组合表明,当要检测的目标定义清晰时,简单明确的启发式规则可以胜过复杂的方案。