
交通AI前沿|六篇论文看懂大模型如何进入交通研究
一
本期导读
搭建交通仿真、模拟出行选择、查找事件处置依据,再到比较公共交通政策,六篇期刊论文给出了具体尝试。把它们放在一起看,更容易分清大模型承担了什么工作,以及哪些判断仍需要真实数据来验证。
说到交通大模型,我们很容易把几种不同的工作混在一起:让模型调用SUMO,是在帮助研究者做仿真;让模型扮演出行者,是在模拟人的选择;让模型读取运营手册,则是在为工作人员查找处置依据。它们都使用自然语言,评价标准却不相同。
本期选取TR-C、Transportation Science和TR-A的六篇论文,分别看看这些应用是怎样实现的。介绍依据期刊公开摘要与Highlights整理;涉及模型比较时,保留原文的实验范围,不把模拟结果当作实际运营成效。期刊卷期月份不等同于首次上线时间。
二
论文目录
1. ChatSUMO Agent让自然语言接入SUMO工作流程: ChatSUMO Agent: An LLM-Based Agent for Conversational Traffic Simulation in SUMO
2. 从真实选择中学习出行者画像: Aligning LLM with Humans for Travel Choices: A Persona-Based Embedding Learning Approach
3. MoBLLM学习能够跨数据集使用的移动规律: A foundational individual mobility prediction model based on open-source large language models
4. ELSSA把运营手册与历史事件放在一起检索 ELSSA: Explainable large language model-based decision support for public transit incident management
5. 让不同社区的智能体比较公共交通政策: Addressing the alignment problem in transportation policy making: an LLM approach
6. 先了解公众担忧,再生成eVTOL政策建议: How can public concerns shape eVTOL policy design? A knowledge graph-enhanced large language model (LLM) framework
三
论文摘要
1
让大模型动手搭建交通仿真
一套交通仿真要经过建路网、设置需求、生成路径、运行和检查结果。大模型在这里承担的工作,是把文字要求转成可执行操作,并根据仿真反馈继续修改。
1. ChatSUMO Agent让自然语言接入SUMO工作流程
ChatSUMO Agent: An LLM-Based Agent for Conversational Traffic Simulation in SUMO
作者:Shuyang Li、Meng Ma、Talha Azfar、Ruimin Ke
期刊与卷期:Transportation Research Part C: Emerging Technologies,Volume 190,2026年9月。
摘要:这项研究把路网生成、场景设置、仿真运行和迭代调整接入同一个智能体。用户提出需求后,模型规划操作步骤,调用路网构建、路径生成、标定和结果分析等工具,再利用返回结果更新后续操作。几何布局、控制参数和交通需求都可以成为调整对象。 作者测试了基于OpenStreetMap的路网提取、合成路网、环岛构建、信号优化和扰动安全分析等任务。摘要报告,人工配置工作量减少超过80%。这一数字衡量的是所测试流程中的配置工作,并不表示所有交通仿真项目的总研究时间都会减少同样比例。
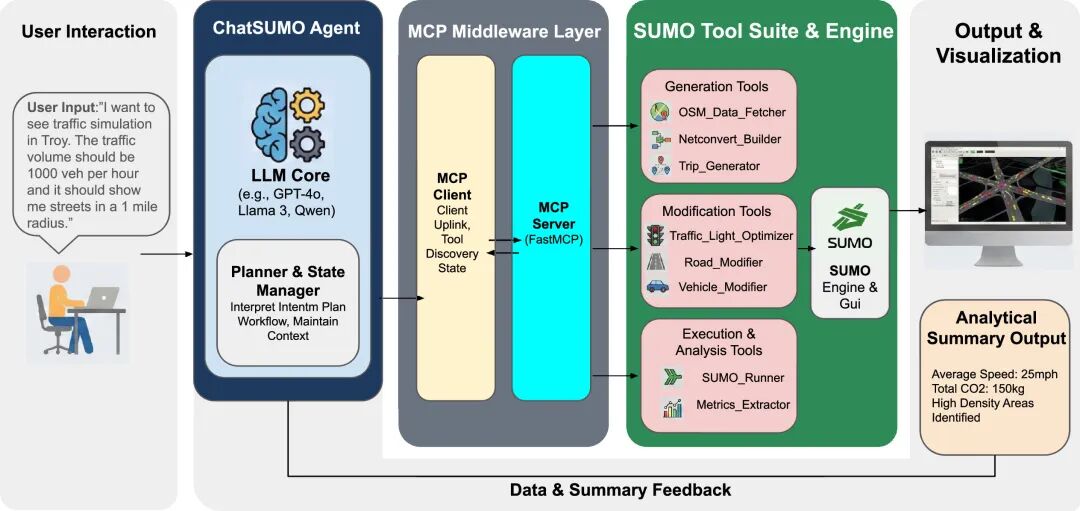
图1|ChatSUMO-Agent的交互式仿真流程
用户以自然语言提出任务后,智能体通过MCP中间层调用路网、需求、修改、仿真和指标分析工具,并把运行结果反馈给下一轮调整。
研究总结:这项工作的实际价值,不只是让研究者少写几段配置代码,而是把建网、设定需求、运行仿真、读取指标和再次修改连成一条可追踪的工作流程。对于需要反复比较路网设计、信号方案或扰动情景的研究,交互式修改可以明显降低试验门槛。不过,论文所说的“可运行”与“行为合理”仍是两层要求:工具调用失败后能否恢复、生成的交通需求是否符合现实、参数标定是否充分,都需要专业人员复核。超过80%的工作量下降也只对应作者测试的配置任务,不能直接理解为所有仿真研究都能缩短同样时间。
DOI:10.1016/j.trc.2026.105759
2
让模型更接近真实出行者
模拟出行行为时,难点变成了模型的选择是否像人。下面两篇分别处理个体偏好的校准和移动规律的迁移,不能只用同一个预测分数评价。
2. 从真实选择中学习出行者画像
Aligning LLM with Humans for Travel Choices: A Persona-Based Embedding Learning Approach
作者:Tianming Liu、Manzi Li、Yafeng Yin
期刊与卷期:Transportation Science,在线优先发表;2026年6月16日在线发表。
摘要:让大模型扮演一位居民,并不意味着它会作出与这位居民相同的交通选择。论文把行为不一致和调查样本稀疏作为出发点:先从经验数据中推断一组出行者画像,再学习一个画像分配函数,根据个人社会人口特征选择合适的画像。 作者在Swissmetro交通方式选择数据上验证方法,报告其在总体选择结果和个体选择预测上优于所比较的基准。这里的画像经过数据学习,而不是由提示词随意设定。公开摘要没有给出统一的提升百分比,因此本文不额外补写数值。
研究总结:这篇论文把“让大模型扮演某类出行者”推进了一步:画像不是研究者凭经验写进提示词,而是从真实选择数据中推断,再根据个人社会人口特征进行匹配。这样做更适合样本有限、又希望保留人群异质性的出行行为模拟。评价时仍要把两个目标分开:总体方式分担率接近观测值,不等于每名受访者的选择都预测正确;反过来,个体准确率提高也未必保证汇总后的政策响应合理。目前验证基于Swissmetro数据,换到其他城市、交通方式或长期行为变化时,还需要重新检验画像是否仍然成立。
DOI:10.1287/trsc.2025.0330
3. MoBLLM学习能够跨数据集使用的移动规律
A foundational individual mobility prediction model based on open-source large language models
作者:Zhenlin Qin、Leizhen Wang、Yancheng Ling、Francisco Camara Pereira、Zhenliang Ma
期刊与卷期:Transportation Research Part C: Emerging Technologies,Volume 185,2026年4月。
摘要:不少移动预测模型在一个数据集上训练后,更换城市、年份或出行情境就需要重新适配。MoBLLM利用轻量开源大语言模型和参数高效微调,尝试从异构移动数据中学习可共享的行为表示,同时控制训练成本。 研究在六个真实移动数据集上检验预测精度、稳健性和迁移能力,覆盖不同时间、空间和情境条件。摘要报告,模型在所测试数据集的F1和准确率上优于比较的深度学习模型,并进一步考察了路网变化、政策干预、特殊活动和事件条件下的表现。
图2|MoBLLM处理的个体移动预测序列
图中展示了位置停留序列以及由进站、出站和行程组成的移动记录,说明不同数据来源下预测目标和序列结构并不相同。
研究总结:MoBLLM关注的不是单一城市内再提高一点精度,而是同一套表示能否适应不同数据来源、时间尺度和空间尺度。对交通预测实践而言,这关系到模型从一个城市迁往另一个城市时,是否必须重新搭建完整训练流程。六个真实数据集上的结果说明这种共享表示具有潜力,作者还专门检查了路网变化、政策干预、特殊活动和事件情景。不过,“跨数据集”不等于可以忽略数据差异:位置编码、采样频率、空间单元和预测目标只要发生变化,都可能改变任务含义,因此迁移前仍要核对数据定义及分布偏移。
DOI:10.1016/j.trc.2026.105562
3
从预测事件转向查找处置依据
除了故障持续多久之外,运营人员还要面对另一个问题:眼前这种情况应该参照哪条规定,有没有相似事件可以借鉴?ELSSA讨论的是后一步。
4. ELSSA把运营手册与历史事件放在一起检索
ELSSA: Explainable large language model-based decision support for public transit incident management
作者:Jiahao Wang、Amer Shalaby
期刊与卷期:Transportation Research Part C: Emerging Technologies,Volume 193,2026年12月。
摘要:公共交通事件处置既要遵循标准操作程序,也常常需要参考过去的处理经验。普通检索增强生成容易把手册切成零散片段,历史控制记录中的经验也未必能被充分利用。ELSSA因此分别处理规则和案例:一条检索路径保留手册层级,另一条把事件报告组织成知识图谱。 作者使用多伦多交通委员会主管培训资料和29路服务事件报告开展实验,比较操作规程问答及不同表述方式下的处置建议,并用时间上分离的2023年资料进行初步泛化测试。系统强调建议与证据相连、可审查和由人监督;论文没有把它描述为能够自主接管现场处置的系统。
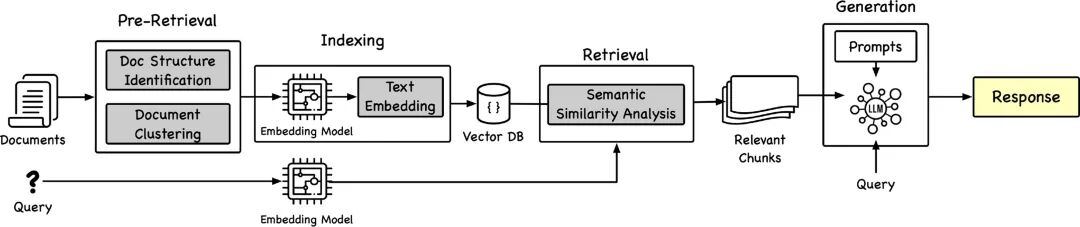
图3|常规检索增强生成的基本流程
文档被切分、编码并存入向量库,系统按问题检索相关片段后生成回答。ELSSA正是在这一基础上进一步保留手册层级,并引入历史事件知识图谱。
研究总结:ELSSA的意义在于把两类运营知识分开处理:标准操作程序回答“必须遵守什么”,历史事件记录则帮助寻找“类似情况曾怎样处置”。这比把所有材料切碎后一次检索,更有利于保留手册层级和事件之间的结构联系,也让主管能够回查建议依据。它适合作为事件研判、人员培训和方案复核的辅助工具,而不是自动下达调度命令。现有实验来自多伦多交通委员会的培训材料和29路事件记录,时间外测试也只是初步验证;当线路、规章或机构发生变化时,知识库更新、检索遗漏和错误建议仍需持续监测。
DOI:10.1016/j.trc.2026.105923
4
用真实偏好约束政策建议
政策方案涉及不同人群的利益。让大模型参与这类分析时,要区分它是在模拟居民偏好,还是在整理调查和文献证据,两种做法能支持的结论并不一样。
5. 让不同社区的智能体比较公共交通政策
Addressing the alignment problem in transportation policy making: an LLM approach
作者:Xiaoyu Yan、Tianxing Dai、Yu (Marco) Nie
期刊与卷期:Transportation Research Part C: Emerging Technologies,Volume 188,2026年7月。
摘要:传统交通模型给出的方案,可能与公众愿意支持的方案不同。作者让大语言模型智能体代表城市内不同社区,对公共交通政策形成排序或赞成偏好,再通过投票机制汇总。政策设置涉及公共交通专项销售税、票价及驾驶者费用等。 研究用GPT-4o和Claude-3.5-Sonnet在芝加哥、休斯敦进行比较。模型能够生成一定程度上合理、且随地方背景变化的集体偏好,但与优化模型基准存在偏离,也表现出与基础模型有关的行为偏差。模拟投票可以帮助研究方案分歧,却不能直接代表真实居民的表决结果。
图4|公共交通政策变量与出行选择的关系
研究把票价、专项税和驾驶者费用与公共交通预算、服务、可达性、客流及道路交通联系起来,为智能体比较不同政策组合提供模型基准。
研究总结:这项研究把大模型放在政策形成的前端,用社区智能体和不同投票规则观察方案排序如何变化。它的用途更接近低成本的情景探索:在正式调查或公众参与之前,帮助研究者发现税费、票价和驾驶者收费可能引发的分歧,并比较芝加哥与休斯敦的地方差异。论文同时给出了重要提醒——基础模型会影响投票语气和选择,智能体对税收的态度也可能偏离优化模型。因而,模拟出来的“集体偏好”不能代替真实居民意见;社区画像如何设定、换模型后结论是否稳定,以及结果能否与问卷和听证数据对应,都是应用前必须补做的检验。
DOI:10.1016/j.trc.2026.105686
6. 先了解公众担忧,再生成eVTOL政策建议
How can public concerns shape eVTOL policy design? A knowledge graph-enhanced large language model (LLM) framework
作者:Tianlin Liu、Cheng Yang、Hyungchul Chung、Manman Zhu、Ke Han、Hongliang Ding
期刊与卷期:Transportation Research Part A: Policy and Practice,Volume 212,2026年10月。
摘要:电动垂直起降航空器能否被接受,与价格、等待、地面接驳和个人态度都有关系。论文使用中国六座低空出行试点城市的陈述偏好调查,先分析个人特征、心理态度和出行情境与方式选择之间的关系,再将行为分析和文献知识接入知识图谱增强的大模型。 与独立大模型相比,增强后的系统在论文的比较实验中给出了证据可靠性、情境相关性和逻辑连贯性更好的建议。这里检验的是建议生成质量,不能据此推断这些政策实施后一定提高客流。它与模拟投票的不同之处,在于把公众调查作为政策讨论的输入。
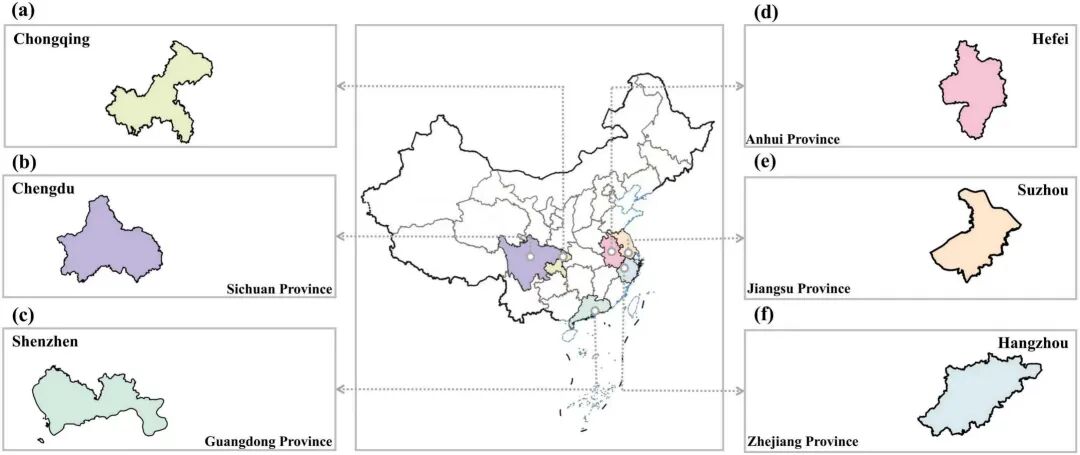
图5|eVTOL调查覆盖的六座低空出行试点城市
研究使用成都、深圳、重庆、合肥、苏州和杭州的陈述偏好调查,比较不同城市与出行情境下公众对eVTOL的接受条件。
研究总结:对尚未形成成熟市场的eVTOL,政策讨论容易停留在安全、价格或效率等宽泛概念上。作者先用六座试点城市的陈述偏好调查识别成本、等待时间、接驳距离、便利性感知和收入等具体因素,再让知识图谱把这些行为证据与既有政策知识连接起来。这样生成的建议能够说明它回应了哪类担忧,适合用于早期方案梳理和人群差异分析。边界也很清楚:比较实验评价的是建议的证据可靠性和情境相关性,不是政策实施后的真实效果;受访者对尚未体验的服务作出的选择,也可能与未来实际乘坐行为不同。
DOI:10.1016/j.tra.2026.105185
四
阅读小结
六篇论文中的大模型承担着不同任务。ChatSUMO调用仿真工具;画像方法用数据校准行为;MoBLLM学习跨数据的移动规律;ELSSA检索规则与案例;两篇政策论文则分别模拟偏好、组织调查证据。读论文时,先看模型具体改变了哪个步骤,再看作者如何验证它,比只比较模型名称更有用。
如果要把这些方法带进自己的研究,可以先问三个具体问题:有没有独立数据可作对照?模型回答能否追溯到输入或证据?换一个城市、基础模型或表达方式后,结果还是否成立?这些问题决定了方法能走到哪一步。