
生物医学基础模型越来越强,但我们真的知道它学会了什么吗?
编辑丨&
生物医学近年来最热闹的场景之一,便是那些不断涌现的全新大模型。有人用它预测蛋白质结构,有人让它理解基因组序列,也有人试图把单细胞数据塞进一个能够处理各种生物学任务的基础模型里。模型越来越大,任务越来越多,榜单上的数字也越来越漂亮。
但很少有人回答,一个基础模型在某个 Benchmark 上拿到高分,究竟意味着什么?
2026 年 9 月 4 日,德国海森堡大学、美国纽约大学等团队在《Nature Methods》上发表了「Benchmarking biomedical foundation models」专门讨论了生物医学基础模型的评估困境。
文章认为,传统的「选几个任务、算几个指标、排一个排行榜」的方式,对于基础模型这样具有广泛适应能力的系统来说,可能已经远远不够。对模型价值的探讨可能不只是在排行榜上,更是要讨论怎样的测试,才能真正测出模型有没有学到可以泛化的生物学知识。
论文链接:https://www.nature.com/articles/s41592-026-03182-y
如何了解一个模型
传统机器学习的评估逻辑相对直接。准备训练集,让模型学习;再拿一份没有见过的测试集,看看预测得准不准。生物医学领域也已经积累了大量这样的「考试」。
例如,蛋白质结构预测领域有著名的 CASP,基因调控与系统生物学领域有 DREAM 等挑战赛。经过多年发展,从蛋白质结构、药物发现到医学影像和基因组学,各个方向都形成了自己的竞赛和基准体系。甚至在今天,全球已经存在数百个不同的生物医学挑战项目。
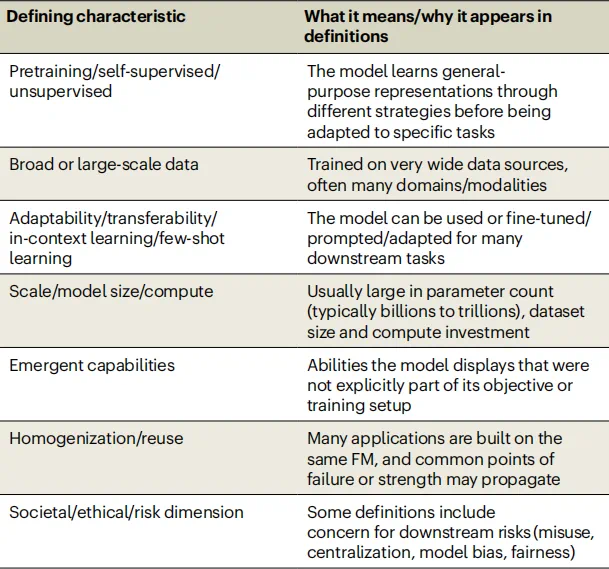
图 1:基础模型的独特特征。
但倘若只挑几个就像拿地图上的几个城市去代表整个大陆。模型可能恰好特别适合某一道题,但这并不意味着它具备跨任务、跨数据集、跨生物学场景的泛化能力。所以基础模型现阶段体现得更多的是某方面的适配度,它也许还有更多尚未开发的能力。
深度剖析
为了具体说明问题,论文把重点放在了单细胞基础模型(scFMs)上。
这类模型试图从海量单细胞组学数据中学习细胞状态和基因之间的通用表示,再将这些表示用于不同任务。理论上,它们可以服务于跨物种比较、数据整合、缺失模态推断,以及基因或药物扰动后的细胞响应预测等多个方向。不同模型在训练数据、架构、数据预处理方式和预训练目标上又各不相同,因此自然也需要更加复杂的评估体系。
论文强调,scFM 的评估应该尽可能覆盖不同技术平台、物种、器官、疾病环境以及不同类型的扰动条件。因为单细胞技术本身就存在系统性偏差,同一生物过程在不同实验条件下可能呈现不同的数据特征。
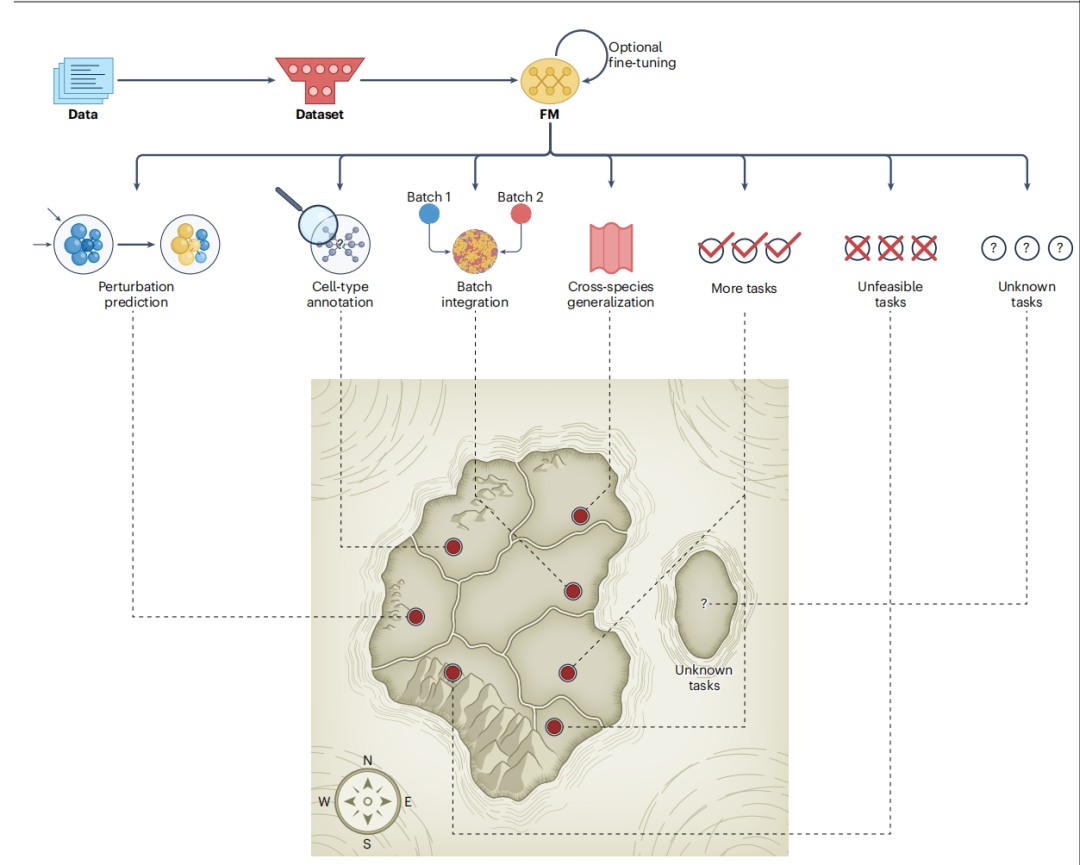
图 2:用标准任务对基础模型进行基准测试的局限性。
所以这也就是为什么论文中认为扰动具有其独特的价值。如果模型能够根据一个此前没有见过的基因或药物扰动,预测细胞随后会发生什么变化,那么它测试的就不只是「细胞长什么样」,而是在一定程度上触及了基因调控和细胞响应背后的机制。
除开模型本身之外,研究者选择的调参方案与训练方案也在影响分数的不同。某个案例中,在预训练的 scGPT 上嵌套随机森林模型,扰动探测反而要优于微调 scGPT(下游模型充当在冻结嵌入上训练的探测模型)。模型越大、直接微调效果越好并不是评估时可以默认的前提。
不推荐唯分数论
当下 scFM 已经被用于批次效应校正、细胞类型注释、数据整合、缺失值推断、多组学对齐和扰动响应预测等任务。这些任务中,达到某项指标也并不意味着在其他指标上表现就良好,更何况某些指标也并非可靠。
扰动预测中,目前还没有形成大家都认可的、既稳健又具有生物学意义的统一指标,因此不同研究甚至可能得出相反结论:有的认为简单模型优于 scFM,有的则得到相反结果。
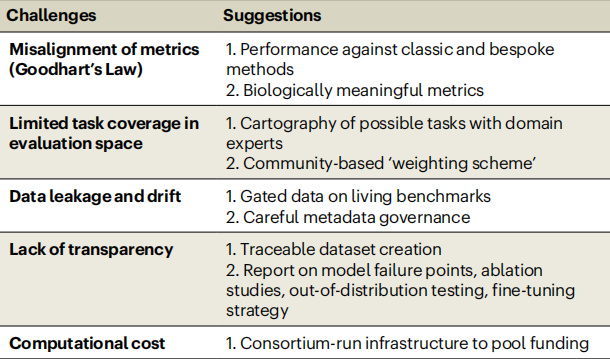
图 3:基准测试基础模型面临的特定挑战及对应的解决方案。
论文建议 benchmark 不应只给出一个数字,还应该加入简单基线、null model,以及反映技术和生物学不可约变异的 upper-bound reference;同时通过 ablation 检验模型究竟依赖哪些数据和组件获得性能。
基础模型的另一个变化体现在数据类型上。这当然意味着模型可能拥有更广泛的能力,但对 benchmark 来说却是另一场麻烦。对此,论文特意讨论了 agentic systems。这类系统通常由大语言模型嵌入多步骤工作流,负责规划、推理、调用工具并执行操作。
在这些架构上,传统的成败评分可能也不够,需要考虑对中间步骤给予部分得分。考察内容不仅体现在准确率上,还得考量可信度、协作能力和 alignment——例如模型有没有通过某些方式绕过测试规则。
榜单需要做出改变
模型测评的最终结果不应是一个超大榜单,研究者更倾向于建立一个由不同科学领域共同参与的、持续更新的 Benchmark 生态。
研究者介绍了刚刚启动的 BEACON(Benchmarking, Evaluation and assessment CONsortium),它试图把不同领域已经积累的评测经验连接起来,并建立更加标准化、可复现的基础模型评价框架。
科学模型的下一步不应在模仿训练数据成为一个提示器。它们需要更严格、更全面的评估体系,这样真正才能找到它们的可泛化能力边界。