
用 C++ 与 NVIDIA TensorRT RTX 示例构建本地 AI 应用
在本地应用中加入 AI 模型,需要可移植的模型格式、可靠的运行时,以及能在各类目标系统上生效的加速方案。
Do Inference Now (DIN) Deploy 是一组开源的实用 C++ 示例,正好填补了这一空缺。它将 ONNX Runtime 与 NVIDIA TensorRT RTX execution provider 结合,帮助开发者从模型 checkpoint 一路走到 Windows 和 Linux 上的原生硬件加速应用。同样的 ONNX Runtime API 也可以通过 WinML 2.0 访问。
从 ONNX 导出到 C++ 实现
每个 DIN Deploy 示例都从一个 Python 导出脚本开始:从 Hugging Face 下载模型 checkpoint 并转换成 ONNX 产物。应用侧则是基于 ONNX Runtime (ORT) 构建的原生 C++ CLI。这种分工把模型转换和部署逻辑解耦,开发者可以直接把导出的模型集成到本地应用中,无需依赖特定模型的运行时。
大部分示例代码使用 ONNX Runtime 的 C++ session 和 tensor API。CUDA API 和 kernel 等厂商专属代码只出现在可选的加速路径中。只要 execution provider 支持所需的 ONNX Runtime tensor API,就能运行这些共享代码。
ORT 的 copy tensor API 让共享代码无需调用专门的厂商 API 也能轻松管理数据局部性。
在导出模型的推理前后处理方面,FLUX.2 示例使用了 ONNX Runtime 在 1.25 版本中引入的 graphics interop 能力,并配合 Vulkan 和 DirectX 进行采样。
仓库为 Windows 和 Linux(含 Arm64 变体)提供了 CMake presets。DirectX 仅在 Windows 上可用。
DIN Deploy 支持的 AI 任务
在自动语音识别(ASR)方面,DIN Deploy 同时支持离线和流式流水线。OpenAI Whisper 覆盖各模型规模的离线转写,NVIDIA Parakeet TDT 和 NVIDIA Nemotron ASR Streaming 则提供流式流水线。
这些示例展示了如何在原生应用中处理音频并返回转写结果,同时在有条件的情况下利用 GPU 加速。
Meta SAM 2.1 示例支持图像和视频的交互式遮罩。它将模型输出转换为分割掩码,供本地应用程序在对象选择、跟踪及其他计算机视觉工作流中使用。
表 1 对比了在 DGX Spark 上测量的部分 DIN Deploy 工作负载的 GPU 与 CPU 性能。
| 模型 | GPU (DGX Spark) | CPU (DGX Spark) |
|---|---|---|
openai/whisper-large-v3-turbo | 58.5x | 3.8x |
nvidia/nemotron-3.5-asr-streaming-0.6b | 39.01x | 3.24x |
nvidia/parakeet-tdt-0.6b-v3 | 206.41x | 14.44x |
facebook/sam2.1-hiera-base-plus | 38.3 FPS | 0.5 FPS |
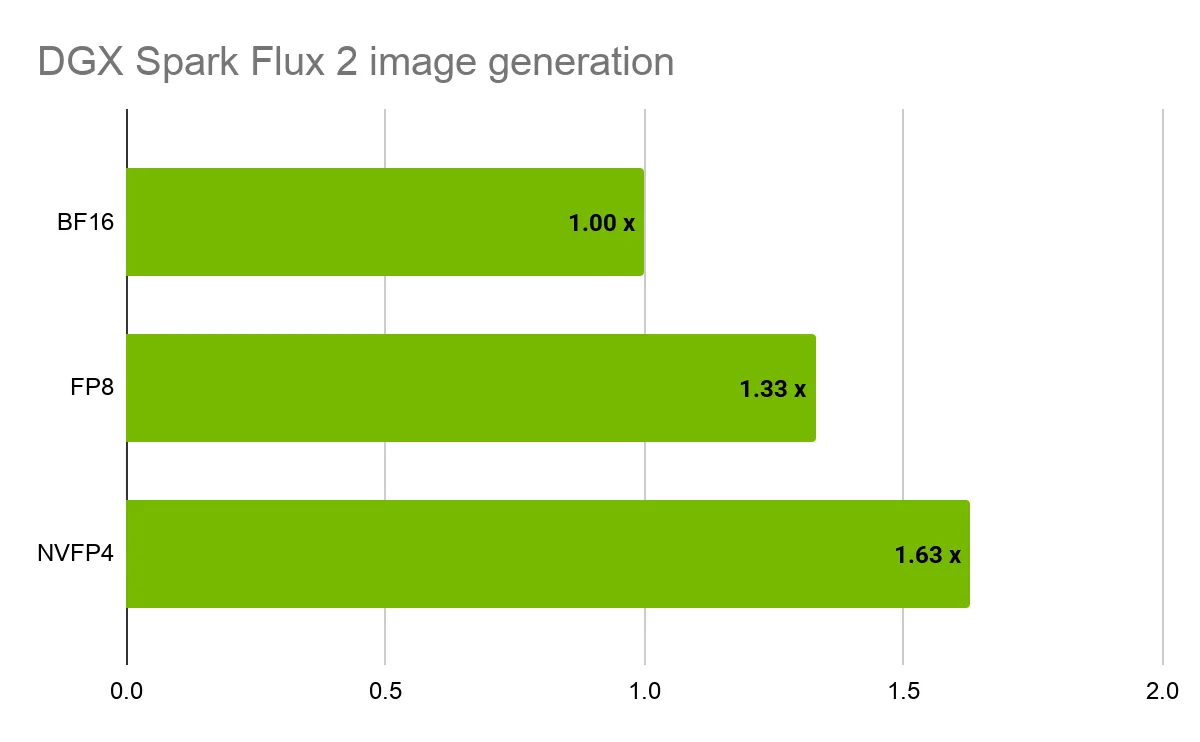
FLUX.2-klein-4B 示例提供提示词驱动的图像生成功能。该示例包含与 Vulkan 和 DirectX 的图形 API 互操作,使应用程序能够通过跨厂商着色器接口集成 GPU 驻留资源。它还展示了如何使用 NVIDIA Model Optimizer 进行训练后量化(PTQ),生成量化后的 ONNX 模型。虽然量化依赖于硬件,但由于 ONNX 接口保持不变,量化模型可作为直接替换项,无需修改应用代码。
开始使用 DIN Deploy
从支持 Windows、Linux、x86-64 和 Arm64 架构的 CMake 预设开始。项目配置并构建完成后,将模型导出为 ONNX,使用 TensorRT RTX 运行命令行工具,或将代码复制到自有应用中使用流水线实现。CMake 默认会自动下载 ONNX Runtime 和 TensorRT RTX。
欲了解更多信息,请访问 TensorRT for RTX、NVIDIA Local AI、DIN Deploy 仓库,以及 NVIDIA 关于模型量化的博客系列。