
Git 3.0 将默认采用 SHA-256:一场代价高昂的错误
从何说起?
这篇东西我搁置了几年。主要因为一直有比我聪明得多的人专注于此,我也不太喜欢在旁边指手画脚。不过,我认为 Git 3.0 的发布即将让所有人付出大量的时间和精力,却几乎得不到什么好处,而绝大多数人甚至不知道这档子事要来了。
所以,准备好爆米花,听我讲讲 Git 3.0 即将引入的一项破坏性变更有多离谱。这场全球性的灾难不仅代价高昂,而且几乎没有实际价值。
Git 中 SHA-1 简介
鉴于你们很多人对基础知识已经有所了解,这部分我尽量简短。
Git 本质上是一个内容寻址数据库。这意味着,如果你想往其中存储或传输数据,Git 会计算内容的哈希值,并把它当作键值数据库的 key(value 则是内容本身)。相同的内容在全球范围内永远对应相同的哈希值。
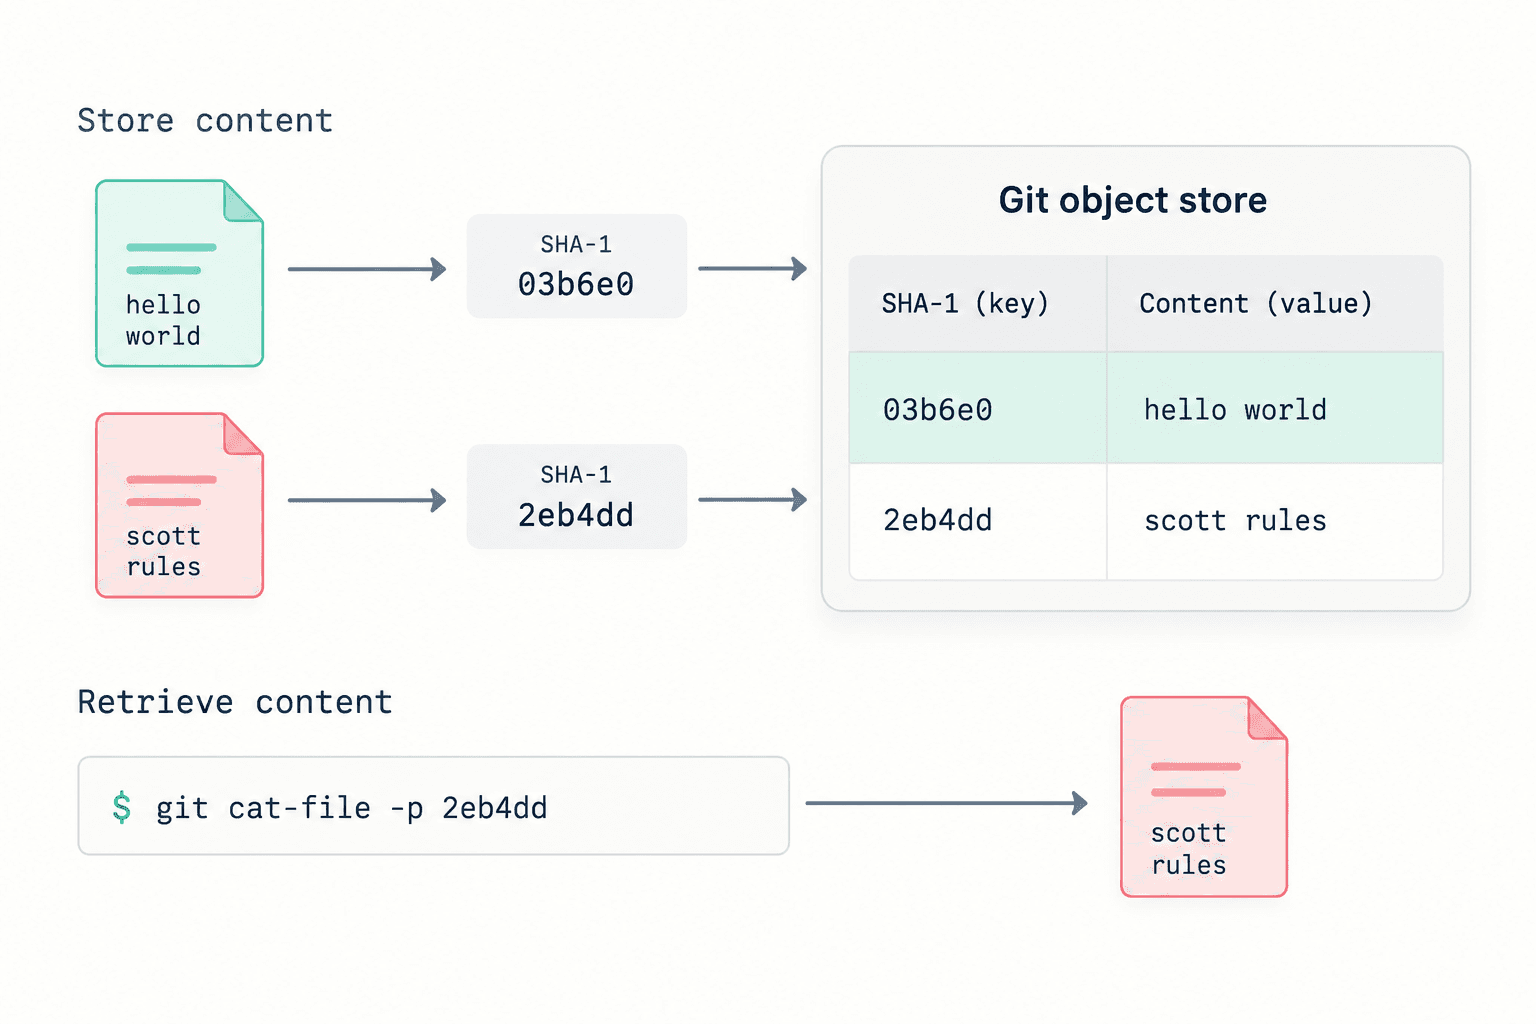
这样很好,因为相同的文件内容永远不会被存储两次。还有一个很棒的特性:每个 commit 都编码了前一个 commit 的哈希值,这就使得完整性具有了传递性——你无法在改变某个哈希值的同时不改变其后所有内容的哈希值。这赋予了它“加密完整性”,意味着对最新 commit 进行哈希运算,实际上也涵盖了其之前可能涉及的文件内容、树和 commit 的数百万条数据。
在 Git 中,这个哈希函数一直是 SHA-1。这是 Linus 在 2005 年 Git 创建之初选择的标准。过去 20 年,它运行得非常出色——速度较快,且在实用层面,两个不同文件偶然获得相同哈希值的概率几乎为零。
事实上,据我所知,在 Git 所有历史版本、所有仓库中产生的数十亿文件和 commit 里,从未发生过这种情况。
从数学上讲,SHA-1 的输出是 160 位,根据生日界的原理,你得在同一个项目里塞进大约 1.4×10²⁴ 个随机文件(1.4 quadrillion billion 个——这个数字大到已经无法直观描述),才可能出现文件哈希意外碰撞。
SHA-1 已经"沦陷"
但问题在于,SHA-1 如今在数学上已被视为半"broken"(失效),因为已有碰撞攻击论文公开发表(2017 年的 SHAttered、2020 年的 SHA-1 is a Shambles)——虽然在实际演示中都不具备可操作性,但理论上已经可行了。
于是,在一众聪明人大量工作之后,即将发布的 Git 3.0 计划把默认哈希算法从半"失效"的 SHA-1 换成更强的 SHA-256。
不过先别急。在深入讨论之前,"broken" 到底是什么意思?
这一点很重要,因为它和普通人理解的"失效"恐怕不太一样。从密码学哈希的角度看,这里的"失效"本质上是指:构造碰撞不再是不可能的事。
换句话说,只要投入足够的钱和 GPU,对于某些特定构造的内容,你就可以故意造出两个不同的东西,让它们的哈希值完全相同。
这意味着,两个内容不同的正常文件意外发生碰撞仍然几乎不可能,但从技术上讲,人为制造两个哈希相同的文件已经不是不可能的了。
由此在理论上存在这样的攻击路径:攻击者把某个文件替换成恶意版本,而 Git 无法察觉,因为两者的哈希在数学上完全一致。
这些论文表明,SHA-1 存在某种理论上可被现代 GPU 农场利用的特性,如今花上几万美元就能刻意构造碰撞;而 SHA-256 没有这个缺陷(如果你特别较真的话,可以去搜一下 "linear message schedule sha-1 vs sha-256"……)。
听起来很吓人很值得担忧,对吧?谁来救救孩子们啊!?!
碰撞攻击
其实也不完全是这样。
让我们花一分钟停下来,谈谈这些碰撞问题。
在考虑对哈希函数的攻击时(假设我必须非常、极其愚蠢地简化问题),主要有两个问题。一个是“碰撞攻击”,另一个是“二次原像攻击”。
“碰撞攻击”是指你明知自己是攻击者,却先伪装成善者以获取信任。你故意生成两个具有相同哈希值的文件——一个无害,一个恶意。在获得信任之前,你给人们无害的那个,一旦信任建立,就利用哈希值匹配且 Git 无法区分两者的特点,将其替换为恶意文件。你甚至可以为包含无害文件的树获取签名标签或提交,使得恶意文件看起来也经过了签名。
“二次原像攻击”是指当你看到想要替换的文件时,创建另一个具有恶意功能的文件,该文件恰好也匹配该哈希值,从而诱使人们无意中拉取它。重要的是,这意味着原始文件的作者不需要也是攻击者。
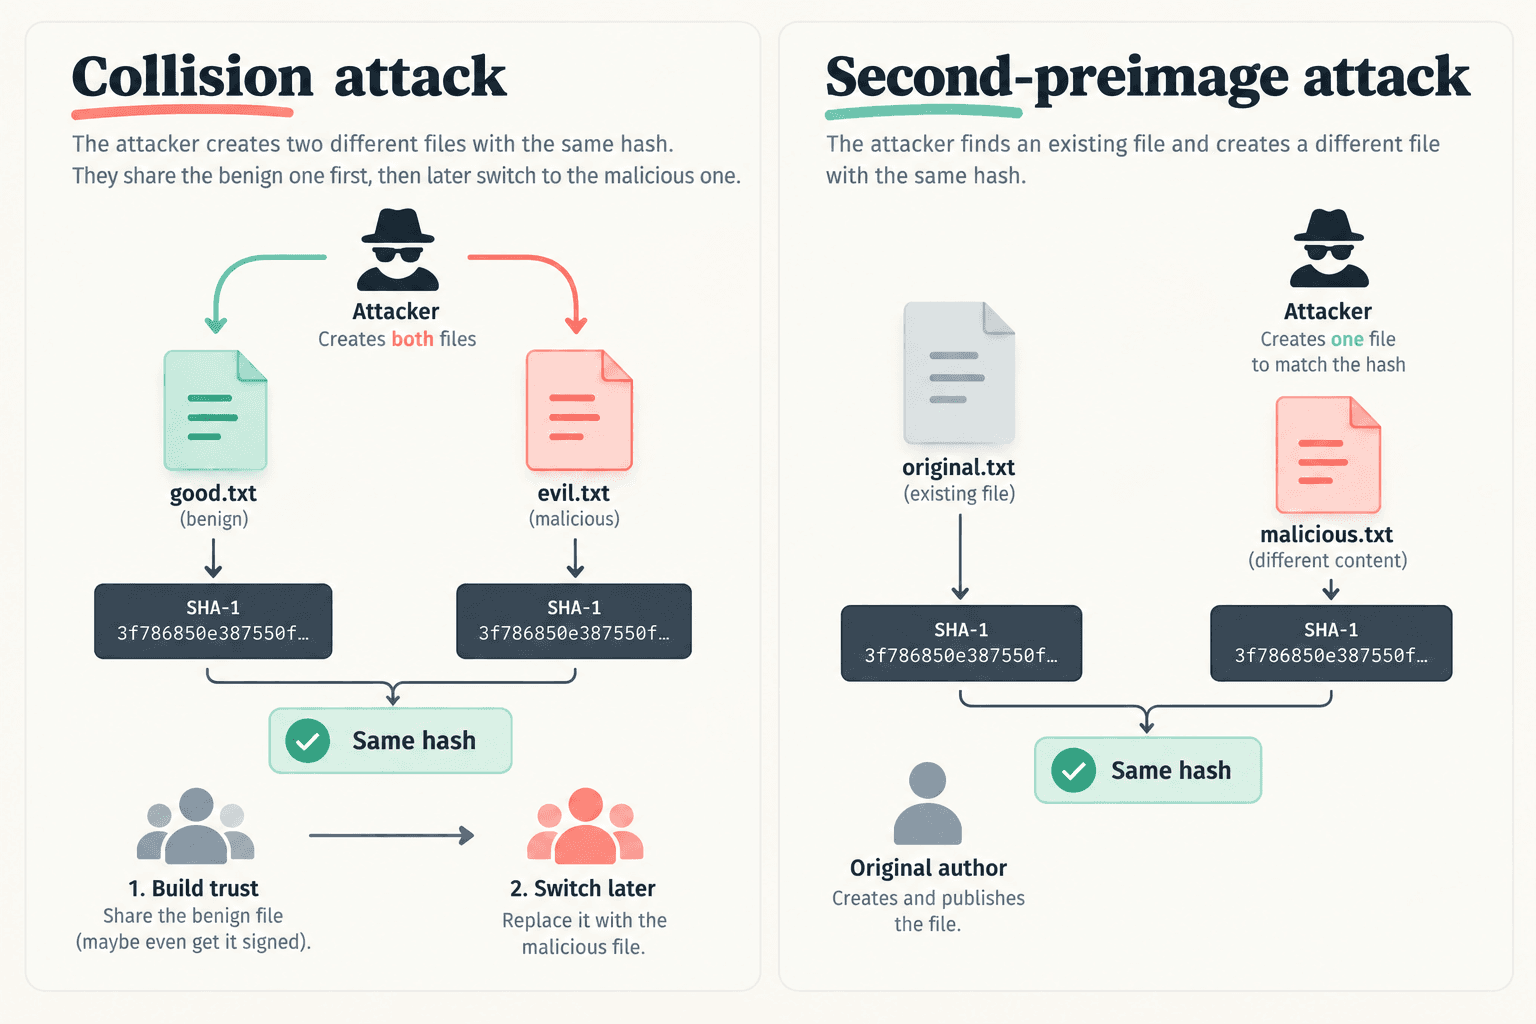
因此,在开始这篇抱怨之前,我想强调的最重要的一点是:虽然二次原像攻击有一些令人担忧的方面,但几乎没有广泛使用的哈希函数对其敏感。
Git 甚至可以使用 MD5(被认为是一个极度脆弱的哈希函数),仍然能有效抵御二次原像攻击。再次强调,MD5 被认为是完全“损坏”的哈希函数,而 SHA-1 并非如此——它的强度要高得多。
我所说的“有效免疫”是什么意思?如果地球上大约 30 亿块 GPU 神奇地全部被替换为 RTX 5090,并且每一块都 100% 的时间只用于计算 MD5,那么暴力破解某个特定原像的预期时间仍约为 160 亿年(中位值约为 110 亿年),大致相当于宇宙的年龄。
3.4×1038次检查 ÷ 3×10⁹块 GPU × 2.2×10¹¹次哈希/秒 ≈ 5.2×10¹⁷ 秒 ≈ 160 亿年理论攻击向量
因此,任何现实且有意义的攻击路径都依赖于碰撞攻击,这意味着引入原始文件的人已经预先计算了恶意版本,并打算在文件被接受后将其注入。
不过,让我们采取极其、甚至不切实际的保守假设,即便为了论证方便,假设原像是容易生成的。假设你找到了一种方法,能在一个小时内为笔记本上任意已知文件创建一个匹配其哈希值的第二原像。
现在,你可以轻松地为想要替换的任何目标文件生成一个哈希值匹配的恶意文件。恭喜!你现在可以“攻陷”世界上任何代码库了!
嗯。等等,有一个小问题。你如何:
- 让那些不认识你、且从未拉取过该内容旧版本的开发者获取该文件
- 让他们以对你有用的方式运行该文件
后续所有的论证和问题集合都取决于这些问题的答案,但在关于此问题的讨论中,这些答案通常被忽略。
即使我们假设 SHA-1 很容易被破解,即使我们假设生成第二原像是可能的(甚至是廉价的),现存的攻击路径在实际利用上依然非常困难。
原因在于,在版本控制(SCM)领域中,哈希并不是信任的真正机制。它确实提供了某种程度的密码学完整性,但信任从根本上并非基于此。
Linus 在 Git 诞生之初就< a href="https://lore.kernel.org/git/Pine.LNX.4.58.0504291221250.18901@ppc970.osdl.org/">明确论证了这一点。
我认为人们不应将 sha1 视为“安全”。真正的 安全在于分发渠道。
信任基于“你从哪里拉取代码”,这一原则始终未变。
实际攻击
花一分钟,让我们看看将不受信任的内容引入代码库的实际攻击是什么样的。这当然是我们要关注的最坏情况。某个源代码文件(在哈希攻击中更可能是二进制文件)被恶意插入,而你毫无察觉。
事实证明,这种事其实发生得相当频繁。 倒不是因为有人花几十万美元买 GPU 来生成随机熵、塞在空字节后面,好让某个二进制文件碰巧匹配一个 SHA-1 校验和。 现实中它的发生方式是:有人通过社会工程拿到某个被数百万项目使用的 npm 包的写权限。这样一来,难以检测的就不只是一个二进制文件了,而是依赖中所有文件——每个在 `package.json` 里引用了这个包的项目,都会在毫无校验比对的情况下盲目拉取它们。 相比暴力制造哈希碰撞再操纵一次不可信的 fetch,这条路简单、便宜,成功率高出可能十亿倍。 如果我想往 Android 里塞不可信的代码,去贿赂或说服某个热门下游项目的维护者、接手项目、然后把难以检测的代码注入一个已被信任的源 URL,可比制造一个极易被发现的哈希碰撞、再放进一个根本没人会去拉取的 URL 简单太多了。 你觉得会没有哪个疲惫的开源维护者,愿意以 4 万美元的一次性付款交出某个使用量巨大却无人疼爱的项目的维护权吗?就这么简单——不用租 GPU,一天搞定,想替换哪个文件就替换哪个文件,内容随意。 换句话说,只要 unpaid 开源维护者和低信任度的包管理平台还存在,哈希碰撞攻击可能就是往系统里塞不可信代码的最愚蠢方式。 回到 Git 世界的信任问题 回到 Linus 的论点:我从 https://github.com/rust-lang/rust 拉代码,并不是因为我信任给最新 commit SHA 签名的那个 GPG 签名,然后随便什么源都照单全收。 我从那里拉代码,是因为我相信 GitHub 的认证体系足够靠谱,恶意人士不太可能在维护者不知情的情况下往上面推送东西。同样,我也不会因为某封邮件让我这么做,就去 https://randomhash.onion/hAAAxx0r/rust 拉代码。哈希算法到底用哪种,以及生成碰撞究竟需要多少算力,我其实毫不在意。更不用说,Rust 显然根本不会把那些导致碰撞的大二进制文件提交到仓库里。
这个前提本身就很荒谬。
在行业内即将被迫全面转向昂贵且复杂的 SHA-256 的背景下,我所知道的每个为其辩护的攻击场景,在我看来都完全不切实际。相对于略微增强哈希算法,用许多其他更强大、更简单的源代码和内容保护机制来缓解风险,既容易又便宜。
如果我们承认 SHA-1 在生成受信任仓库中内容的唯一键时已经足够好、足够快,并接受哈希值本身不应被直接用作信任依据,那就没有理由替换它。哪怕我们继续用 MD5,实际上大概率也没问题。
在任何合理的代码库中,内容的意外碰撞在数学上几乎不可能发生,而其余风险可以由签名内容验证、外部认证和社会信任机制来解决。
如果我们不承认这一点,就会陷入死循环:每隔一段时间有人发现新的理论碰撞漏洞,Git 生态就得再被迫整体迁移一次。我们先经历漫长的 SHA-1 到 SHA-256 迁移,将来量子计算机一旦攻破 256 位,我们就又得重蹈覆辙,陷入同样的窘境。
根本原因在于,我们将密码学完整性与信任混淆了。
会不会是一场灾难?
稍等,Scott,你说这会是一场灾难。这该不会只是夸张的说法吧?
也许吧。
但无论怎么估算成本,这都不轻松、也不便宜。Emily Shaffer 刚做完一场演讲,介绍 Google 如何准备应对这个问题,前景不容乐观。
这会如何发展?
让我们来拆解一下 Git 3.0 推出这个新默认值后会发生什么。
首先,所有使用 git init 创建的新仓库,都将默认采用 SHA-256 内容哈希算法。你今天就可以运行 git init --object-format=sha256 亲自验证。
❯ git init --object-format=sha256 /tmp/twofiddy
Initialized empty Git repository in /private/tmp/twofiddy/.git/

❯ cd /tmp/twofiddy

❯ echo 'sha 256' > README.md

❯ git add README.md; git commit -am 'first'
[main (root-commit) 11043f6] first
 1 file changed, 1 insertion(+)
 create mode 100644 README.md

❯ git log
commit 11043f6a3be7d21e999dc84550886306bee65f4faf4fc9226979108fd1a0b1af (HEAD -> main)
Author: Scott Chacon <schacon@gmail.com>
Date:   Wed Sep 30 10:36:13 2026 +0200

    first
除了哈希值明显变长外,你首先会注意到,目前无法将这段代码推送到 GitHub。不过,预计到 Git 3.0 正式发布时,这个问题应该会得到解决。事实上,这很可能也是当前阻碍 Git 3.0 全面上线的主要瓶颈之一。
但当你确实想推送到 GitHub(或任何托管平台)时,在服务器端创建仓库时需要明确告知对方这是一个 SHA-256 项目。今后,每个项目将被严格划分为 SHA-256 或现有格式两类,两者不能混用。
这会立即让用户感到困惑,因为他们必须清楚自己使用的是哪个版本的 Git 执行了 git init,并在前往 GitHub 创建远程仓库时,确保选对对应的格式。
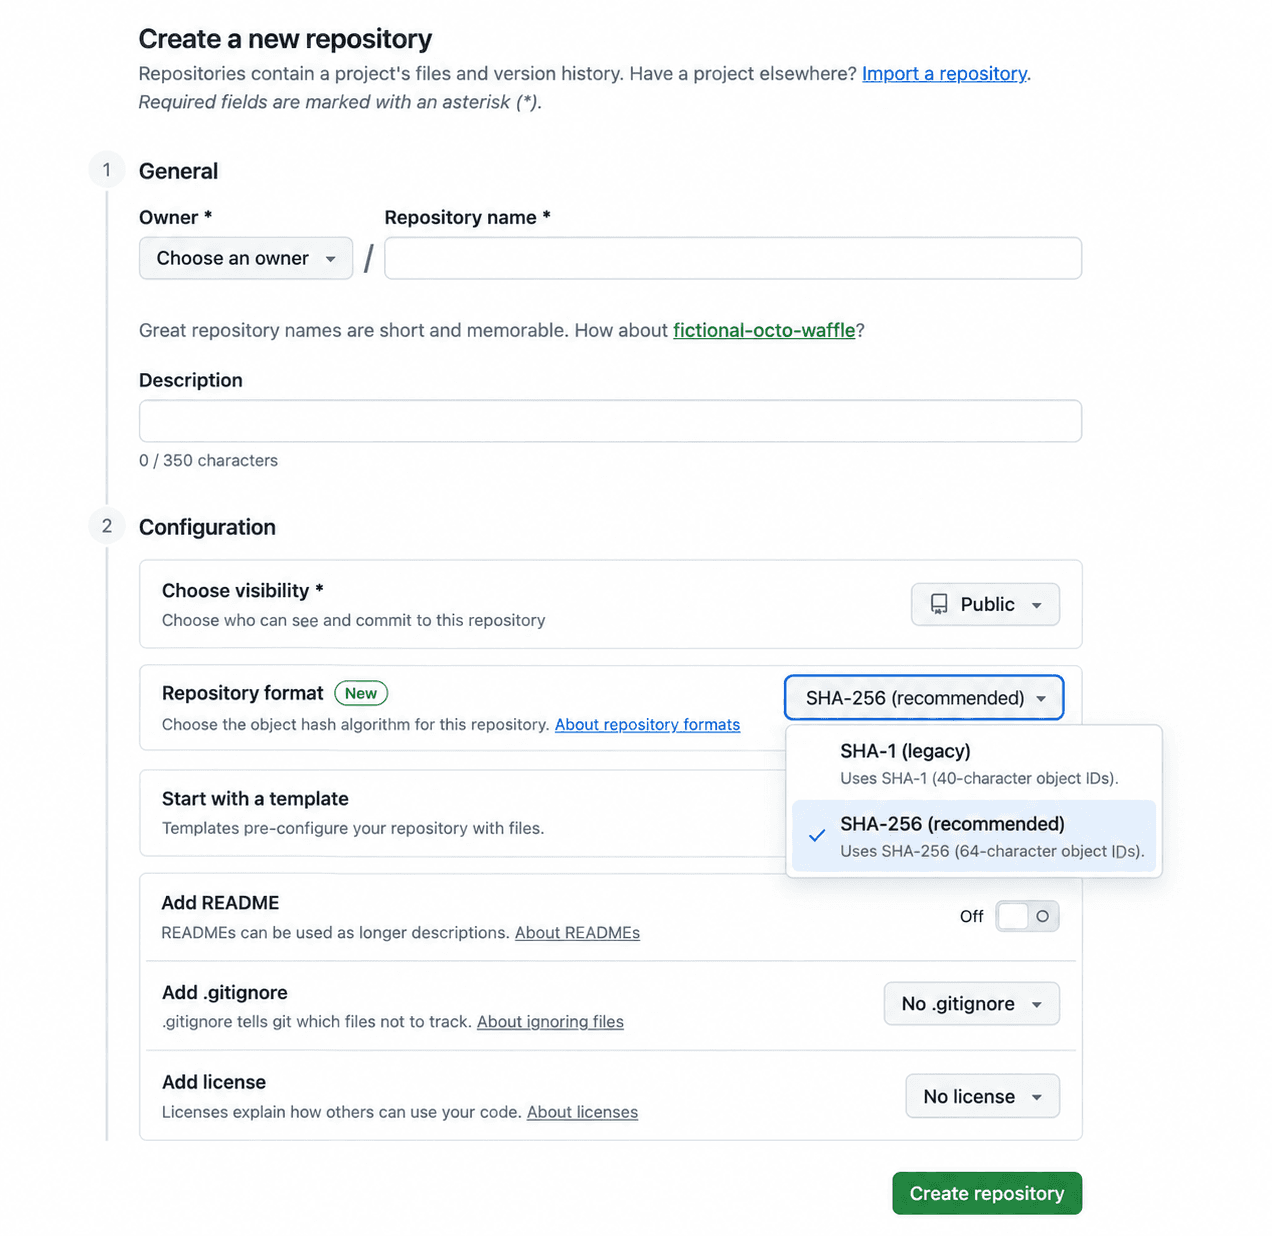
我们将很快看到大量类似的情况:
❯ git push origin main
fatal: the receiving end does not support this repository's hash algorithm
这主要有两个原因。首先,由于各托管平台对该格式的命名方式不一,用户很难判断上游仓库应采用哪种初始化格式。你可能用 SHA-256 格式初始化了远程仓库,却试图从本地使用 3.0 之前版本 Git 初始化的仓库推送代码。反过来也一样。
库、链接与工具,真够乱的!
而且对库来说,这问题尤其严重:submodule 只能在同类型的仓库间使用,所以库必须同时维护两个版本,才能既服务现有项目又支持新项目。
托管平台或许可以通过互为镜像来兼容两种格式,但这几乎会让 GitHub 这类网站在几乎每次操作上都增加负载,而且还会进一步加剧信任问题。
对于决定从 SHA-1 迁移到 SHA-256 的现有项目,它们需要把仓库里的每个对象都转换成新格式,这会让所有已有的签名全部失效。同时,所有参与或使用该项目的人必须在同一时间完成切换,否则会出现 head 分裂的问题。或者,再次退回到镜像方案:先建镜像,再把写权限从一个仓库切到另一个。但这仍然解决不了没有 256 版本镜像的仓库的对象替换问题。
即便他们真的完成了迁移,Slack、邮件以及其他任何地方出现过的 SHA-1 哈希的 URL 或链接都会失效,需要做重定向(前提是能做到——前提是你没换过托管平台,或者换到了一个没有映射关系的地方)。
所有假定哈希长度为 40 字符的内部或第三方工具,要么直接挂掉,要么得改造成能猜测或自动识别哈希格式。
另外,虽然 Git 核心支持处理两种格式的仓库,但并非所有库都支持,而且几乎没有库有完整的支持。
Git 最初是作为一个不可重入、GPL 授权、无法被链接的库来开发的,因此整个 Git 生态中的大多数项目都选择从零开始重新实现。由于这些库对双格式的支持要么为零要么不完整,所有不通过 fork-exec 调用 Git 二进制文件的脚本和工具,在处理这些新仓库时都会出现不同程度的问题。
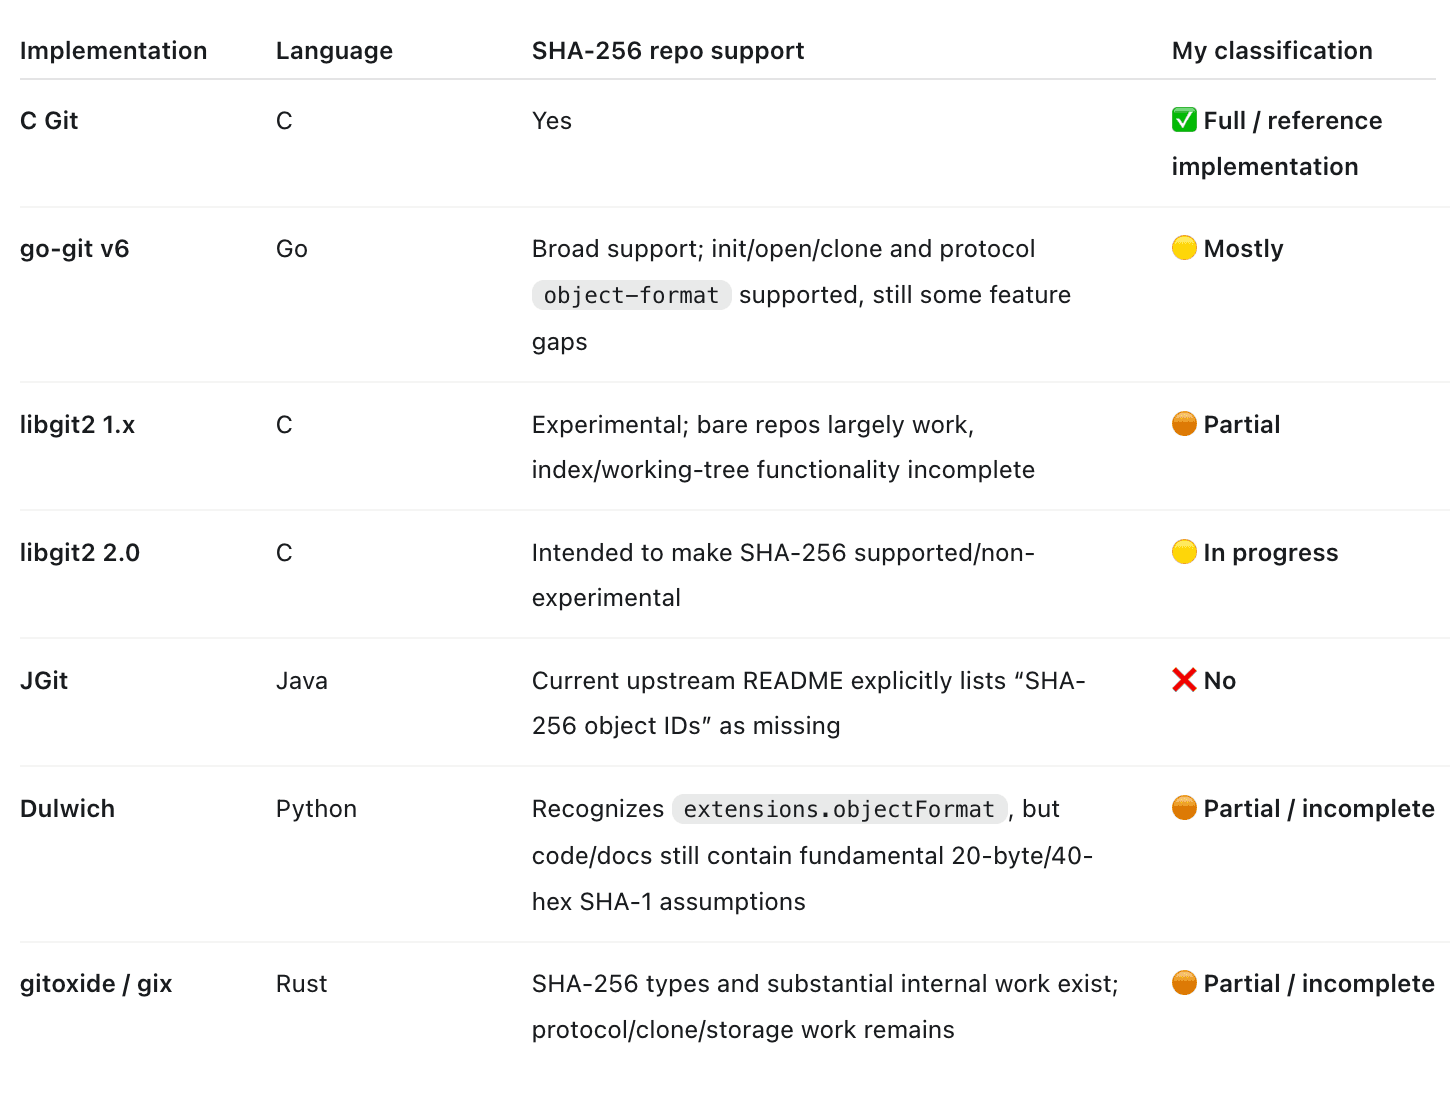
我可以继续列举更多实例,但这确实是一个范围广泛、影响深远且尚未解决的大难题。目前大家并未达成任何共识,也找不到什么简便的解决方案。Emily 甚至指出,谷歌可能会设置内部的全局系统级覆盖,以确保所有新项目仍使用 SHA-1,争取在尽可能长的时间里维持现状,避免 3.0 的新默认值生效。
那我们可以做些什么?
就我个人而言,我认为这是一个为了解决理论问题而强行引入的不必要方案。而且即便那个理论上的、实际上并不常见的问题,针对少数真正关心此事的项目,也有更简单直接的办法可以解决。
不要依赖哈希来验证内容可信度。
你看,就像 Linus 二十年前说的那样。
如果你假设仓库源码是可信的,那么以上这些问题统统无所谓。完全无所谓。因为我们中 99% 的人只与可信的仓库源码打交道。对于绝大多数 Git 用户来说,花哨的后门哈希碰撞攻击毫无意义:如果你只在一个仓库上工作,且该仓库的写权限被攻破,任何人都能往主分支里塞任何东西,大概也不会有人察觉。你不需要那些高明的对象替换技巧来愚弄别人。
如果你不完全信任源码(剩下的那 1%),那在全球性哈希灾难来临之前,我们或许应该先尝试其他更简单、更优的方法。
独立的树哈希头
如果我们换一种思路呢?也许可以做个简单的改动:用不同的算法对树内容独立重新哈希,然后将该头部注入到我们签名的对象中,从而对 两个 哈希进行签名?一个(SHA-1)用于内容获取,另一个(比如 SHA-256)用于独立的内容验证。
我想深入探讨一下,因为我觉得这种方案几乎可以解决所有 即便只是理论上的 问题,而无需让整个 Git 生态系统分叉,也不必惹恼所有人。
Git 3.0 即将默认启用 SHA-256,这将是一个代价高昂的错误 假设你想依赖外部库或供应商,并希望缓解潜在的哈希碰撞攻击。你无法信任提交或标签上的 SSH/GPG 签名,因为签名对象是用于存储内容的 SHA-1 哈希,而该哈希已被证明可被替换且不被检测,或者在不改变被签名对象本身的情况下进行修改。 因此,将它们分离。 在签名提交或标签时,独立计算树中所有内容的 SHA-256(或 BLAKE3 或其他)哈希,并将其作为新头部注入该对象,随后对该对象进行签名。此时,签名将基于 *既* 包含 SHA-1 的内容和 *又* 包含历史,*还* 额外包含在签名时独立计算的树内容哈希。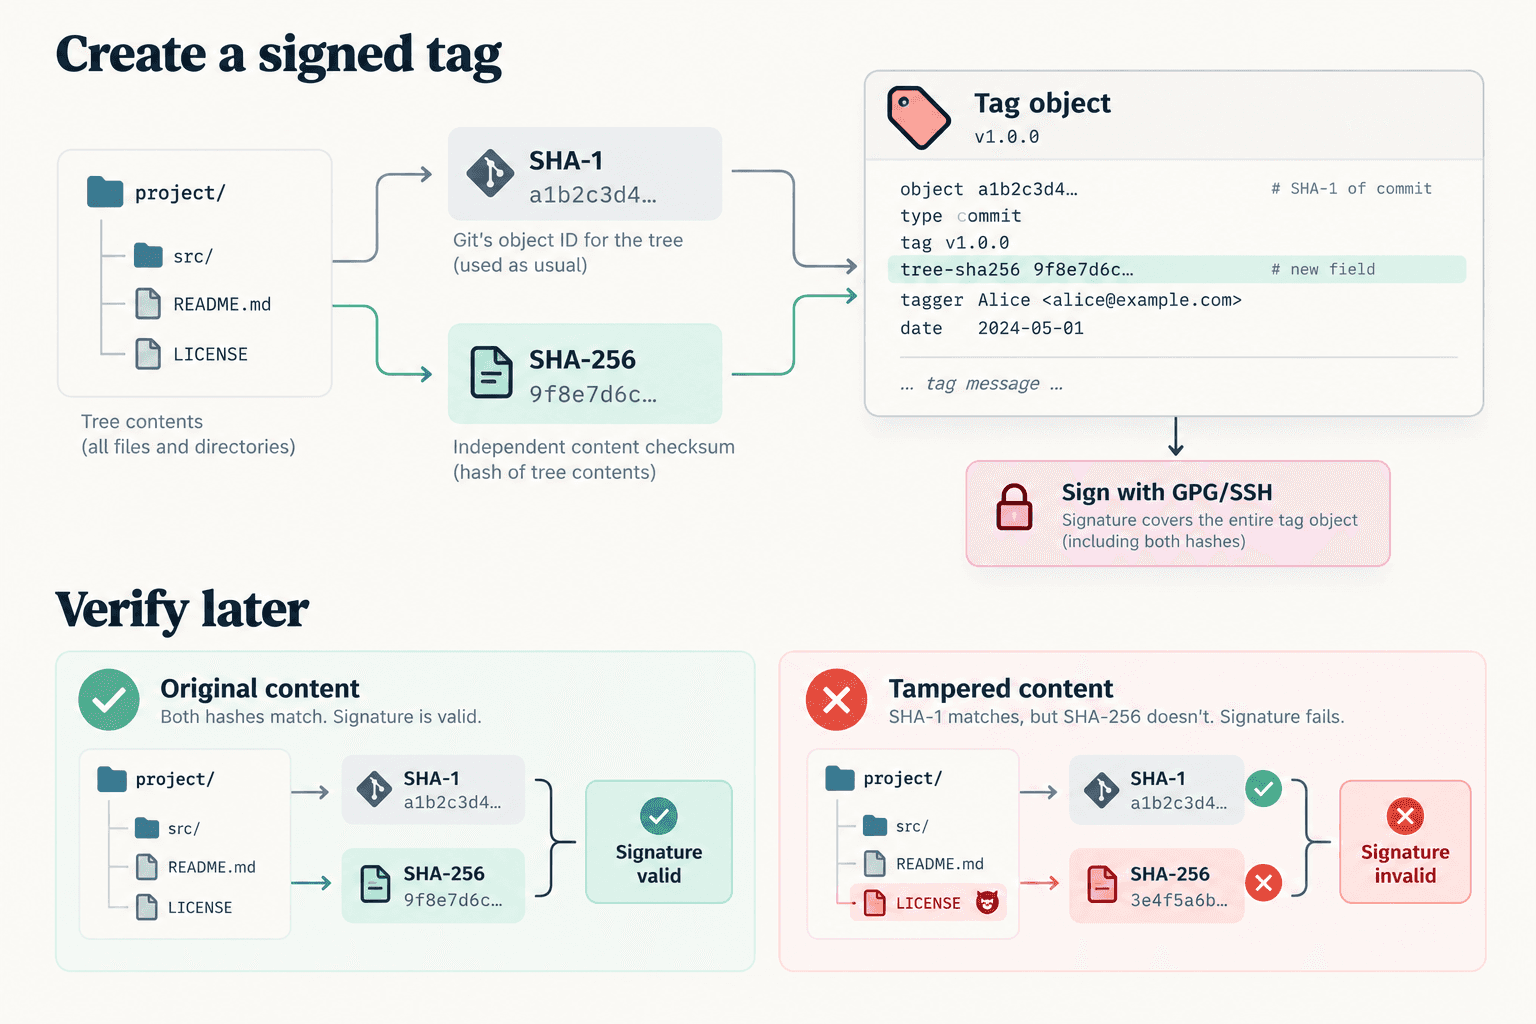
git tag -s 的直接替代工具,在标签签名前,会在提交、树和每个 blob(递归进入子模块)上添加一个 Git-EVTag-v0-SHA512 校验和,该校验和可以独立于同一树的 SHA-1 进行验证。
如果 SHA-256 ever 受到攻击,我们可以支持新的哈希函数,关心安全性的项目可以开始强制要求使用它(例如 tree-blake3 头部或其他)。我们甚至可以使用多个哈希,并选择验证其中没有、任意或全部内容以建立内容信任。每当某种算法的可信度受到损害,我们只需添加新的哈希和验证方法,而无需迁移所有现有项目。
缺点是,我们可能无法信任所有 commit,只能信任那些带有签名头部的对象。但对几乎所有在意这个问题的项目来说,这大概已经足够了。这种情况下,签名无法沿整条历史向下传递信任——可这真的是个大问题吗?这类项目本来几乎都会以打标签的发布版本为锚点。
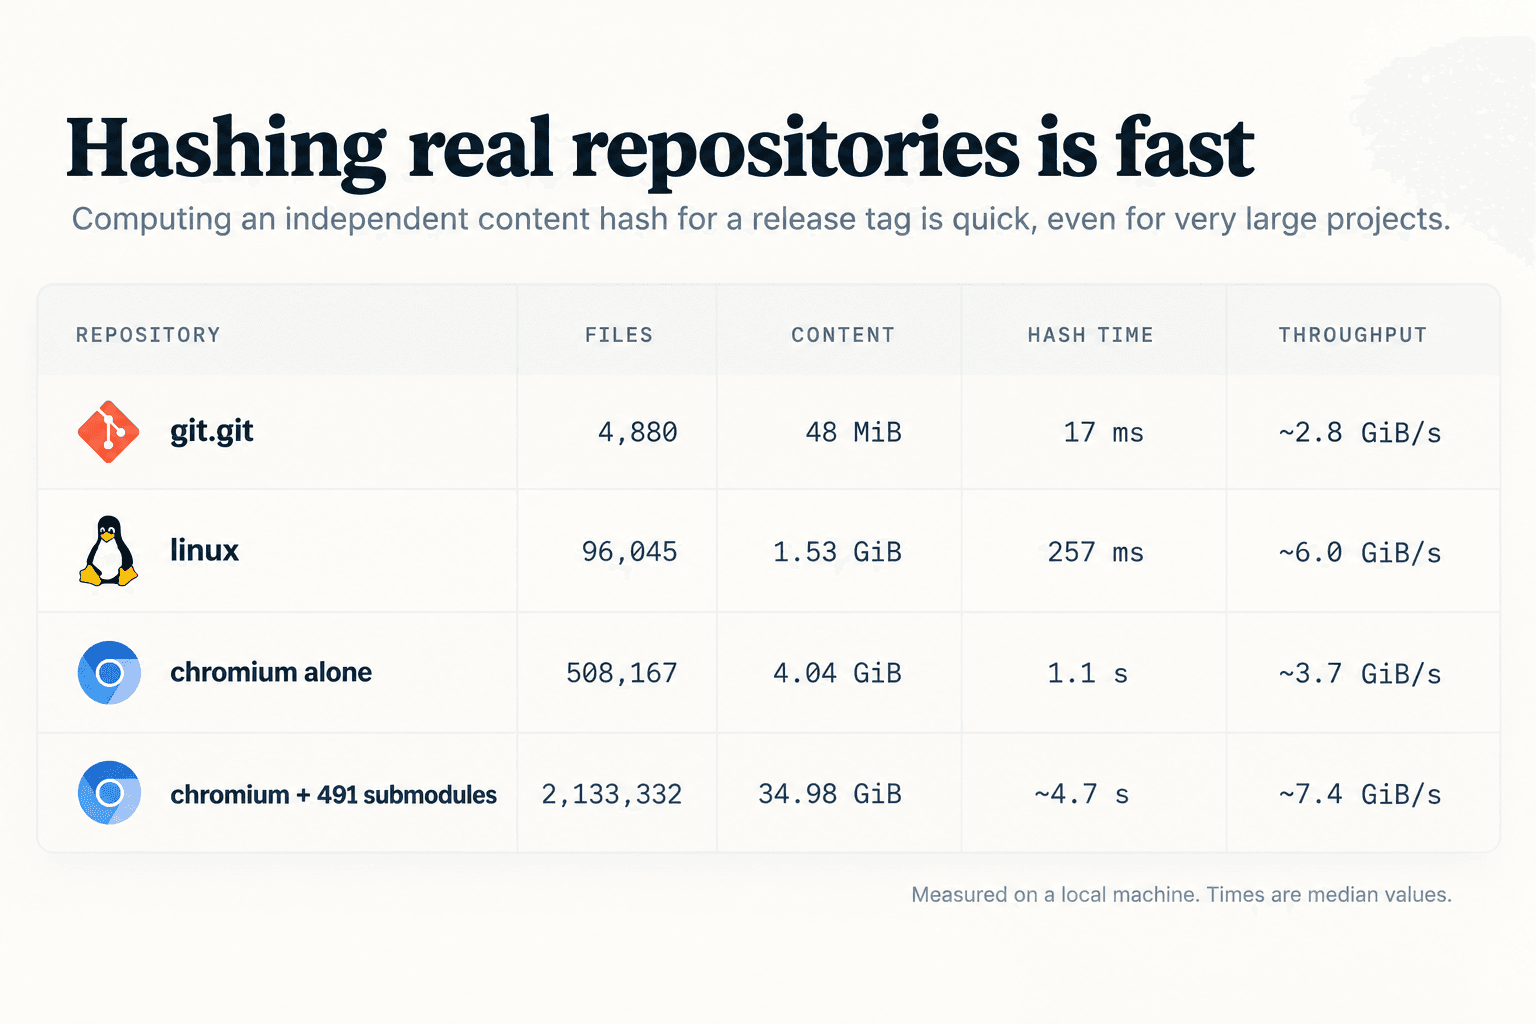
创建这种独立的内容签名会稍微增加一些开销,但也只在你需要签名时才会产生。我做了一个概念验证,并用能想到的最坏场景做了测试——递归校验 Chromium 及其全部 submodule。
这个场景涉及 35GB 的工作区、210 万个文件。我的工具生成校验和(主树的所有文件加上所有 submodule 的文件)只用了 5 秒(M5 Mac 多线程)。这已经是最极端的情况了。
Linux 内核 1.5GB 的代码树耗时 257 毫秒,Git 项目只要 17 毫秒。对大多数项目来说,你甚至可以把这个放进每个 commit 里。它还支持回填——你可以追溯历史,轻松地给过去任意项目的 commit 打上带签名的校验和标签。
任何人关心的树都可以独立校验并签名,核心的哈希模型完全不用改动。而且严格来说,这甚至比单独用 SHA-256 更安全,因为现在要出问题,得让内容在两种哈希算法下同时碰撞才行。
我们可以在不抛弃 SHA-1、不破坏整个生态的前提下,用 SHA-1 实现内容信任;也可以为极少数有信任需求的项目增加一种内容信任机制,而不给整个社区带来巨大的混乱。
感谢收看我的 TED 演讲。
这一切都不新鲜。以上论证在 Git 邮件列表上已经争论了多年,而且提出观点的人比我高明得多。本文只是想让大家在按下 Git 3.0 的“启动键”前稍作停顿,反思一下在 SHA-256 波及 Git 生态更多部分之前,是否值得重新审视这个决定。
在 Git 3.0 中,这种双签名方法也合理地解决了 NIST 合规性问题。NIST 关于 2030 年 SHA-1 的截止日期,针对的是“将 SHA-1 用于加密保护”,而非 SHA-1 是否存在于你的技术栈中。如果每个签名都同时覆盖 SHA-256 的内容哈希,那么 SHA-1 就不再承担任何保护功能。它只是一个内容寻址的键。FIPS 模式下的系统已经支持这种做法:OpenSSL 3 允许应用程序请求一个非 FIPS 版本的哈希实现,用于非安全目的(Python 的 `usedforsecurity=False` 参数正是如此)。此外,Git 甚至不会通过 OpenSSL 来处理对象 ID,而是使用其内置的 SHA-1 代码,这完全处于任何 FIPS 加密模块之外。 我还可以进一步认为,我们可以完全移除 sha1dc(“碰撞检测”)计算带来的开销。这种开销是我们为了尽量避免特定类型的碰撞而共同承担的成本。如果我们假设这类检查并不是在克隆或推送操作中需要处理的地方,那么在很多情况下都能加快克隆和推送的速度。