
高产、耐用、通用:NVIDIA AI 工厂如何最大化投资回报率
AI 工厂以兆瓦乃至吉瓦为单位进行建设。每兆瓦工厂的成本约为 6000 万美元,运营方在投入如此规模的资金前,必须清晰了解投资回报率(ROI)。决定 AI 工厂收益的核心因素有三:
- 创收能力:若工厂出售所有能生产的 token,一年能赚多少钱。
- 使用寿命:AI 硬件能持续产生收益多久。
- 市场需求:这些 token 有多少实际需求。
单一优势无法弥补另一项的短板。若工厂只能销售部分产能,其高创收能力意义有限;若硬件仅满负荷运行一年便停止产出,高市场需求也无关痛痒。这三者并非独立存在。能运行更多类型工作负载的工厂,能吸引更广泛的需求,从而年复一年地保持收益。
NVIDIA 的 AI 工厂在工程上追求三项指标的最优:
- 高产:每兆瓦吞吐量最高,单 token 成本最低,最大化创收能力。
- 耐用:NVIDIA GPU 及系统在出货多年后仍能持续创收,延长使用寿命。
- 通用:支持 AI 全生命周期、全场景的运行,以及大量非 AI 工作负载,拓宽可服务的需求面。
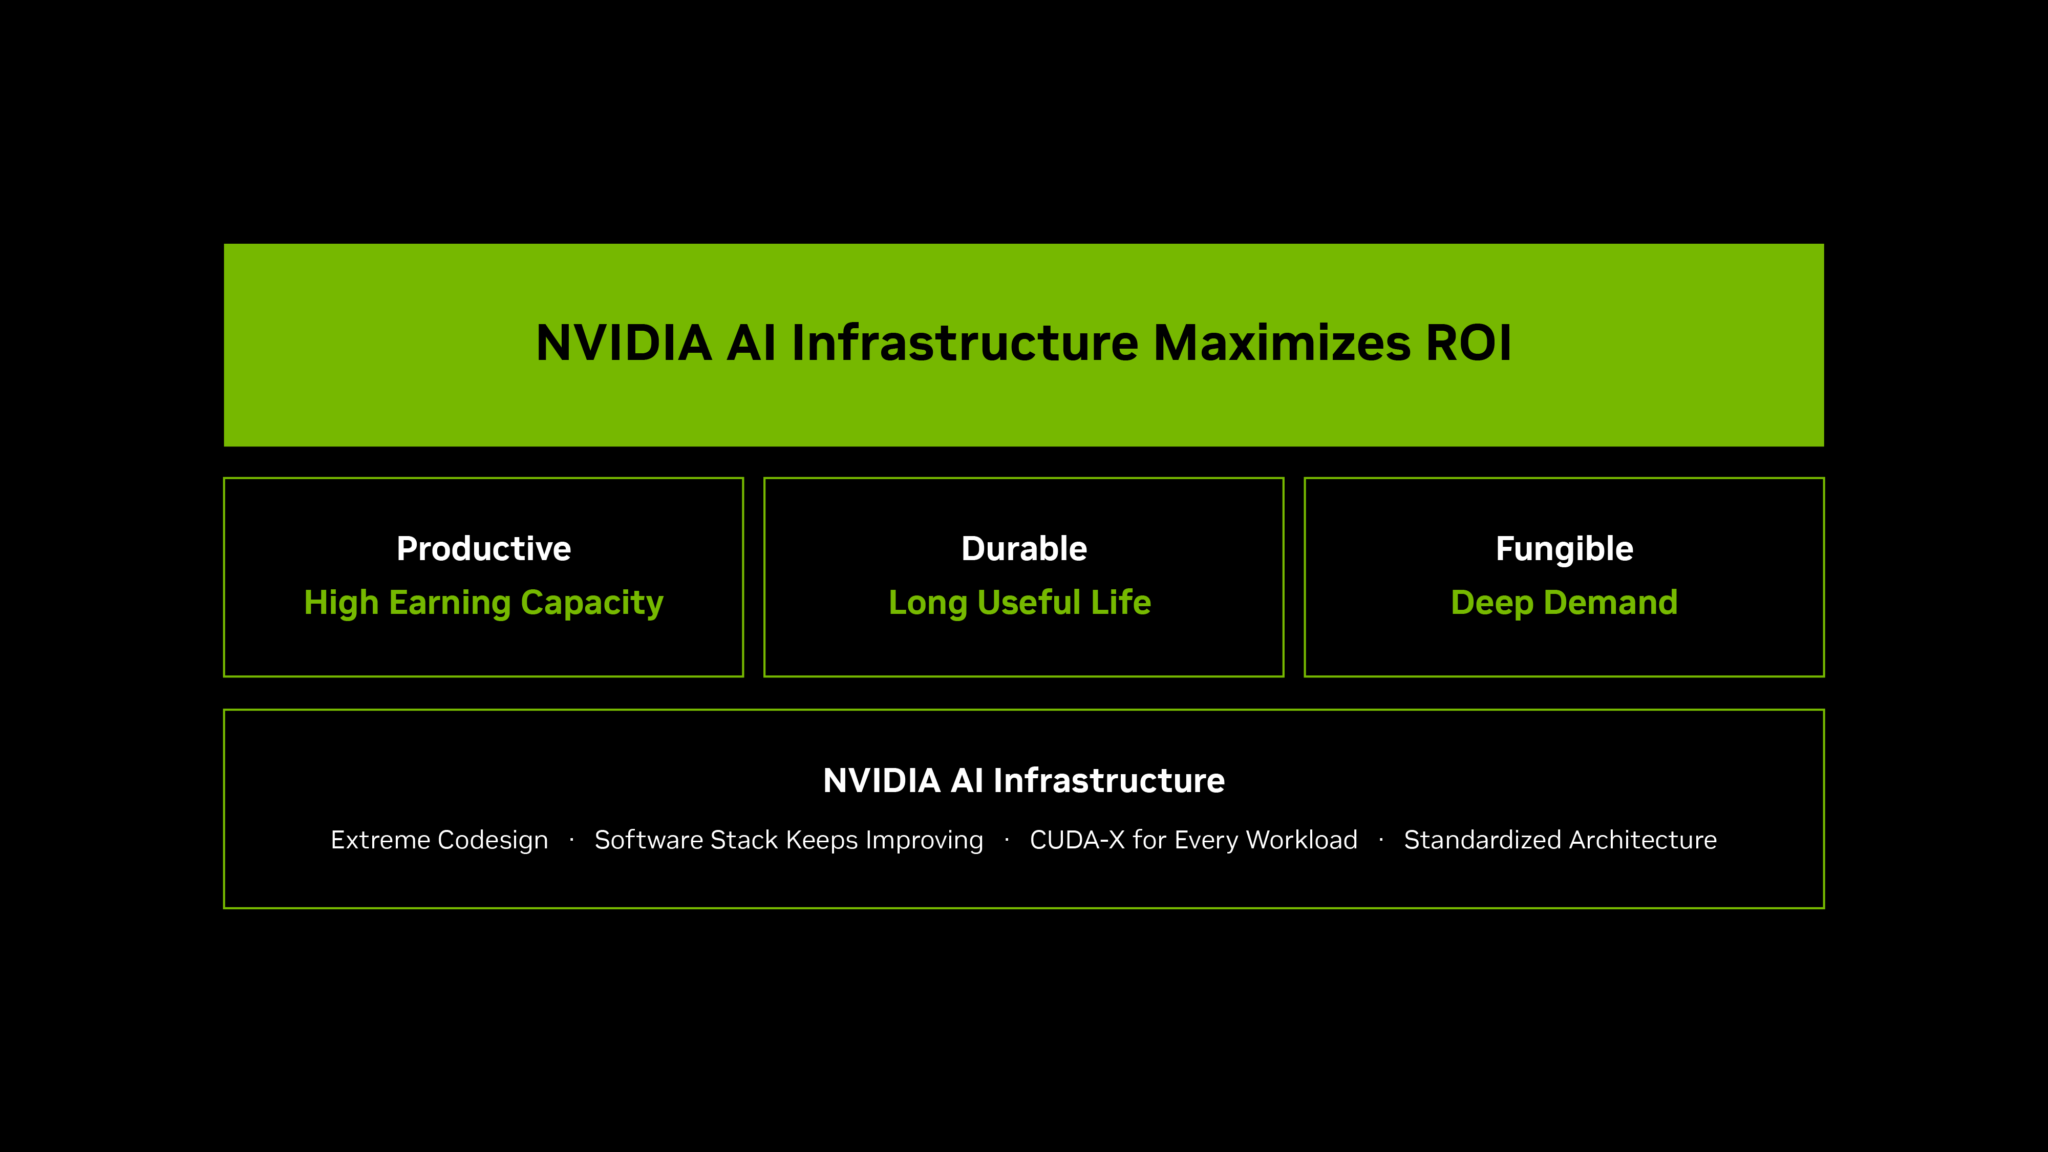
全栈协同工程化设计最大化 AI 工厂吞吐量,持续的软件优化确保已部署硬件在出货数年后仍保持高产出。NVIDIA CUDA-X 库使工厂能运行任何加速工作负载。标准化架构让所有运营者都能通过经验证的参考设计轻松部署这些能力。
高产:每兆瓦 token 数最高,单 token 成本最低
电力是制约 AI 工厂的关键瓶颈。因此,每兆瓦每秒生成的 token 数决定了创收能力。在固定功耗下,token 生成速度越快,收入越高;单 token 成本越低,利润率越高。
SemiAnalysis AgentX 的数据显示,NVIDIA Vera Rubin NVL72 系统相比 NVIDIA GB300 NVL72,每兆瓦吞吐量高出 30 倍以上,在 DeepSeek V4 Pro 模型上每百万 token 的成本最高可降低 45 倍。如此巨大的收益来自全栈的深度协同设计:从模型和工作负载,到软件、计算、网络和内存,全部一体化优化。
由此引出两个问题。既然每一代产品都让 token 大幅降价,对算力的需求会不会随之萎缩?
不会,反而会扩大。
token 变便宜让更多应用场景变得划算,而这些场景消耗的 token 远超效率提升所省下的部分。
第二个问题关乎设备的持久价值。既然每一代都比上一代强这么多,那老一代设备怎么办?
Durable:存量设备持续创造收益
并非所有工作负载都需要最新系统。选什么设备取决于工作负载的复杂度和形态,这也是为什么新一代发布后,上一代依然能持续赚钱。
NVIDIA A100 GPU 于 2020 年发布,六年后仍在商用,持续体现其经济价值;CoreWeave 最近将 2020 年首批设备的订单延长到了 2029 年。这些年来,各大运营商都延长了服务器的折旧年限——折旧年限本质上是对硬件何时停止创造收益的预估,而这个时间点一直在往后推。Sprout 在 2026 年 9 月发布的分析文章《数据中心 GPU 的使用寿命有多长》追踪了各家主要运营商这一时间表的变化。
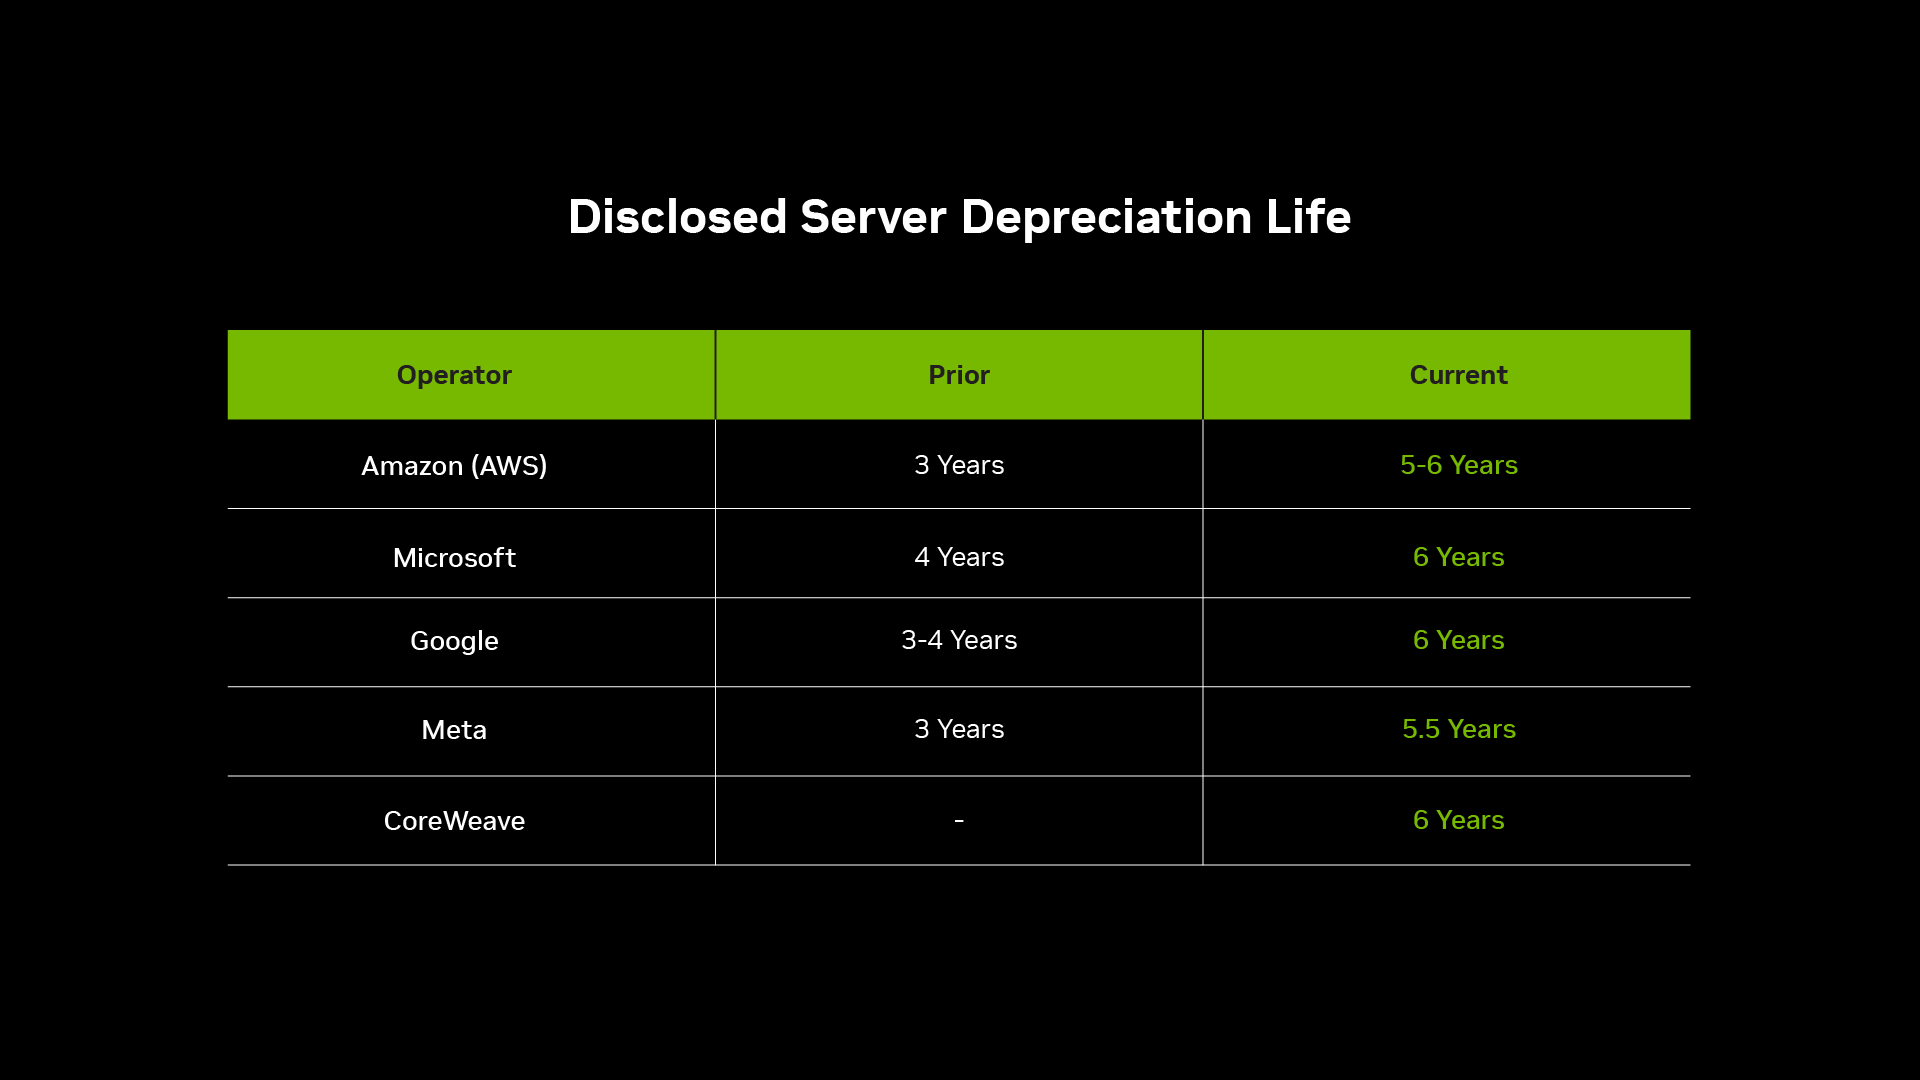
Barkr 根据系统转售价格判断,八卡 H100 系统的有效寿命为五到六年,GB300 NVL72 为九到十年。Silicon Data 显示,一块六年前购买的 A100 GPU 目前仍值原价的 25%,而按五年折旧计划,它早在一年多前就已被计提为零。Ornn Data 发现,市场对五年合约租赁 A100 GPU 的支付意愿是月租合约的 80%。
CUDA 是用于编程 NVIDIA GPU 的软件平台,具备跨代兼容性。因此,当新架构问世时,运营商现有的设备并不会闲置。持续的软件和内核优化不断提升现有硬件的性能表现。
同一个平台支持机器学习、深度学习、生成式 AI、推理、智能体 AI 以及物理 AI。每类新工作负载都能在已部署的硬件上运行。
这就是通用品质(fungibility)。系统能承载的工作负载类型越多,其持续产生价值的时间就越长。
通用品质:各类 AI、所有阶段、全场景覆盖
专为单一任务构建的工厂,本质是对该任务持续存在的赌注。而能够运行所有任务的工厂,即便任务类型发生变化,依然保持有用并持续创收。
NVIDIA AI 工厂运行所有类型的 AI 模型——无论开源还是专有——覆盖语言、视觉、生物学、物理学和机器人学领域。它们贯穿全生命周期,从数据处理到预训练、后训练及推理。此外,它们适用于所有场景,从超大规模和 AI 云到主权项目、企业数据中心及边缘计算设备。
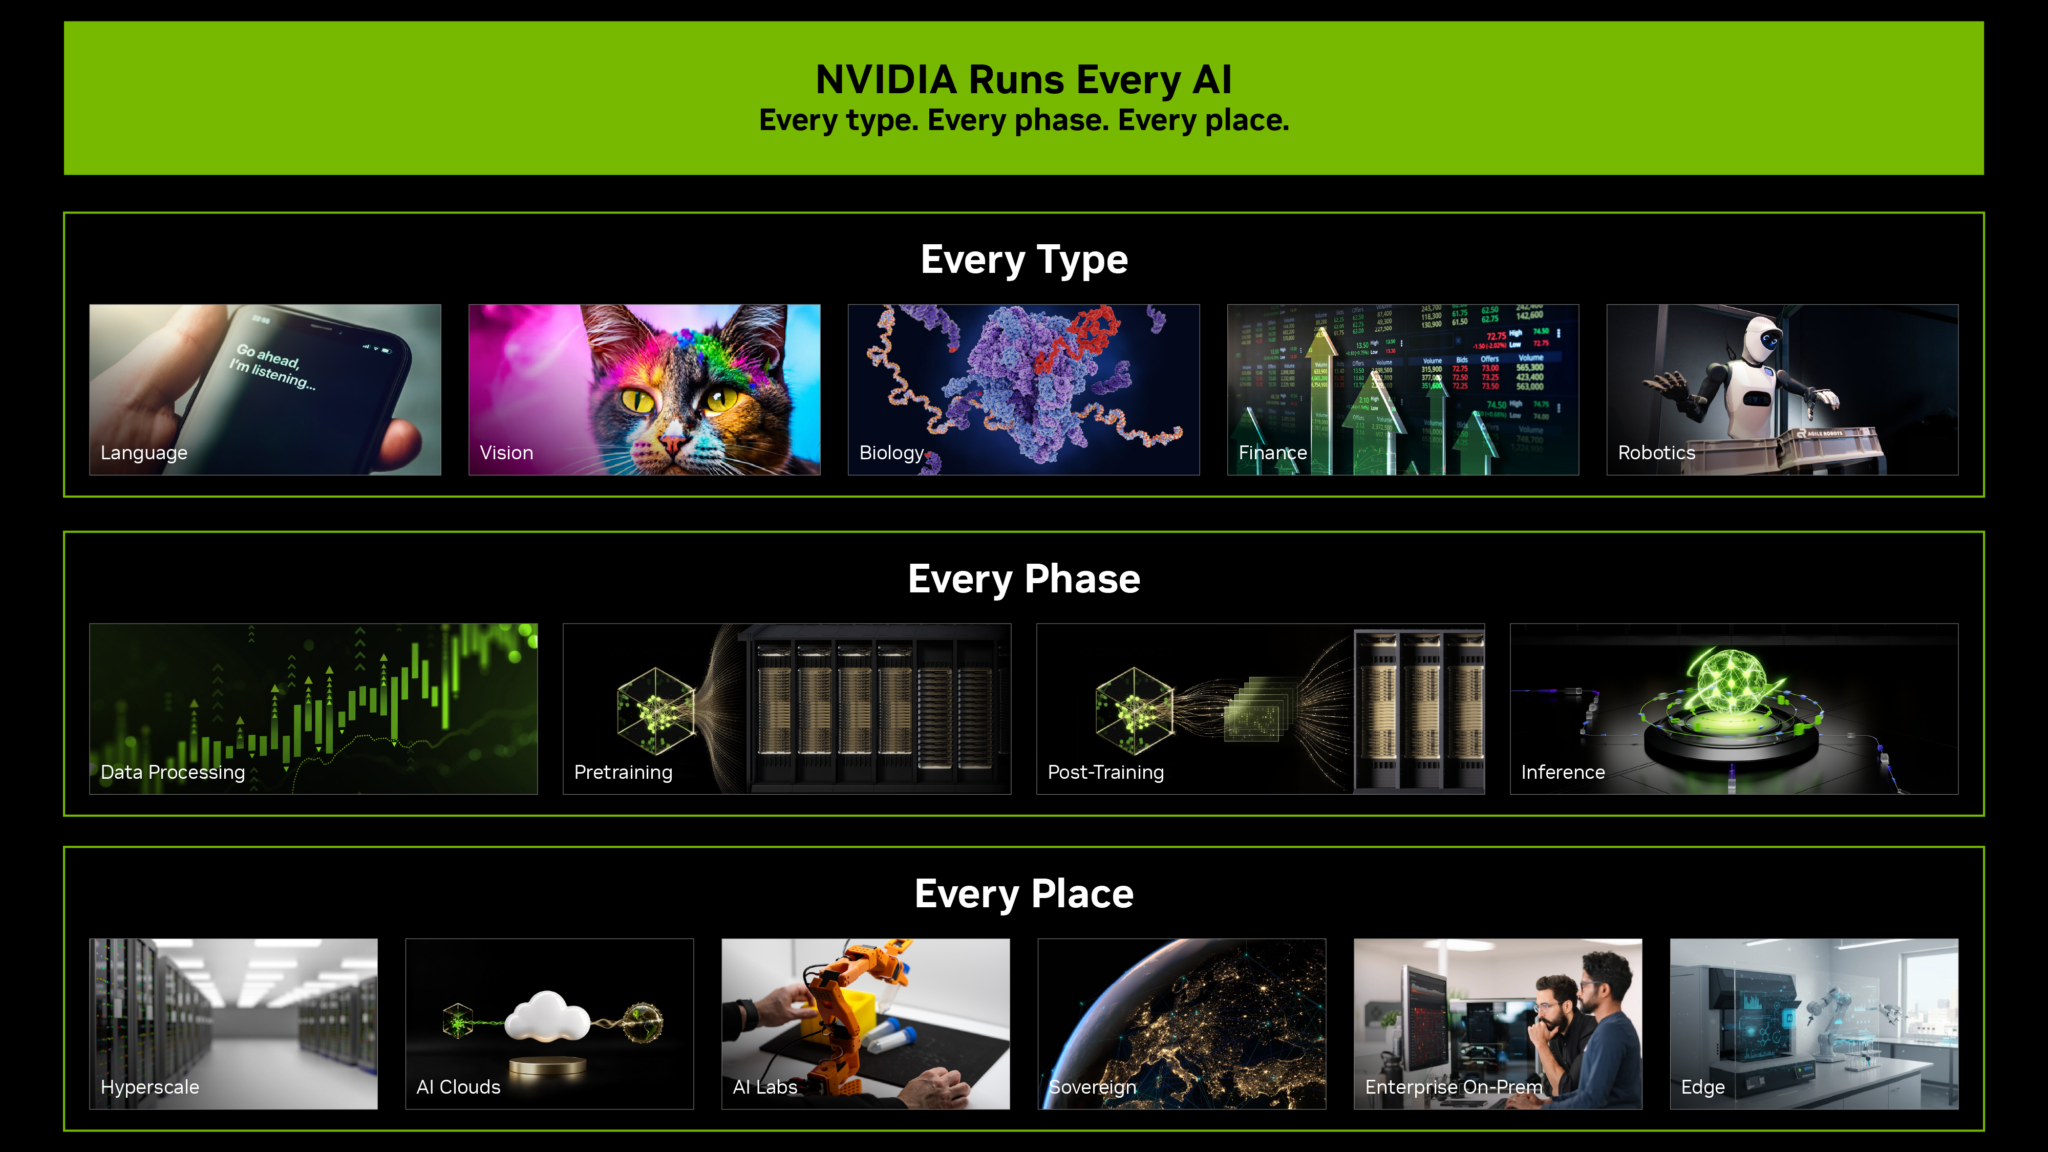
这些工作负载不仅是构建和运行 AI 模型。同一套基础设施还支持数据处理、科学计算、仿真、图形渲染等领域。
无论是 AI 还是非 AI 任务,底层逻辑都是并行数学运算,而 NVIDIA GPU 正是为了在数千个核心上高效执行这类运算而生。CUDA 让同一块芯片既能模拟光线、折叠蛋白质,又能预测下一个 token。其上层拥有超过 1,000 个即插即用的 CUDA-X 库,涵盖深度神经网络、计算光刻、量子电路仿真、向量检索、气候建模等诸多领域,目前已有超 1,000 万开发者基于此构建应用。
这使得 NVIDIA GPU 成为通用的加速计算芯片,而非为单一任务定制的 ASIC。通用并不意味着通用:Tensor Cores 和 Transformer Engine 将面向 AI 优化的硬件整合进可编程序架构,在单芯片内实现了专用性与灵活性的统一。这种“一架构通吃”的能力保持了高利用率,进而保障了投资回报率。
这种通用性在客户的生产环境中得到了验证:
- Lilly:在包含 1,016 块 GPU 的本地集群上构建并运行蛋白质、小分子及基因组学模型,同时为内部团队提供聊天机器人和智能体工作流服务。
- Pinterest:在超大云平台上进行视觉语言模型的后训练与部署,工作负载横跨 14,000 块 GPU,支持 NVIDIA Blackwell、Hopper 及早期架构。
- Revolut:使用 NVIDIA cuDF 处理数十亿条交易记录数据,随后在 AI 云上训练并部署基础模型。
- Runway:利用云基础设施,在 NVIDIA Hopper 上训练世界模型,并部署在 NVIDIA Blackwell 平台上提供服务。
- 德克萨斯农工大学:在超级计算机上运行分子模拟和 AI 药物研发,26 个项目、7 家机构的利用率达 95-98%。
不仅在 AI 领域如此。达索系统(Dassault Systèmes)为威奇托州立大学的飞机适航认证和 Lucid Motors 的汽车设计提供数字孪生仿真支持。联合利华则用数字孪生生成产品图像,取代实地拍摄,将制作成本砍掉一半。
这样的案例不胜枚举——而这正是关键所在。
NVIDIA AI 工厂专为高效产出、持久耐用、灵活通用而设计:产出更多有价值的 token、延长设备使用寿命、挖掘更深层的算力需求。这正是其投资回报最大化的原因。
想深入了解 NVIDIA AI 工厂,欢迎观看 NVIDIA 创始人兼 CEO 黄仁勋于欧洲中部时间 10 月 21 日周三上午 11 点发表的 GTC 柏林主题演讲。