
AI击败军棋史上最强人类选手,攻克棋类游戏最后的人类堡垒之一
来自卡内基梅隆大学、纽约大学、斯坦福大学和麻省理工学院的一个团队构建了一个AI,决定性击败了历史上最成功的军棋选手。据报道,其训练成本不到8,000美元。
卡内基梅隆大学、纽约大学、斯坦福大学和麻省理工学院的 researchers 在《自然》杂志上发表的一篇论文中介绍了军棋AI Ataraxos。据作者所知,这是首个在该棋类游戏中达到超越人类水平的AI。在官方20局系列赛中,Ataraxos以15胜1负4平的战绩击败了荷兰选手 Pim Niemeijer。
Niemeijer 被认为是军棋历史上成就最高的选手。他曾四次获得世界冠军,15次荷兰全国冠军,两次线上世界冠军,并连续600多周位居世界排名第一。自1997年以来,唯一参加每一届世界锦标赛的选手 George Franka 称 Niemeijer 为"史上最优秀的军棋选手"。
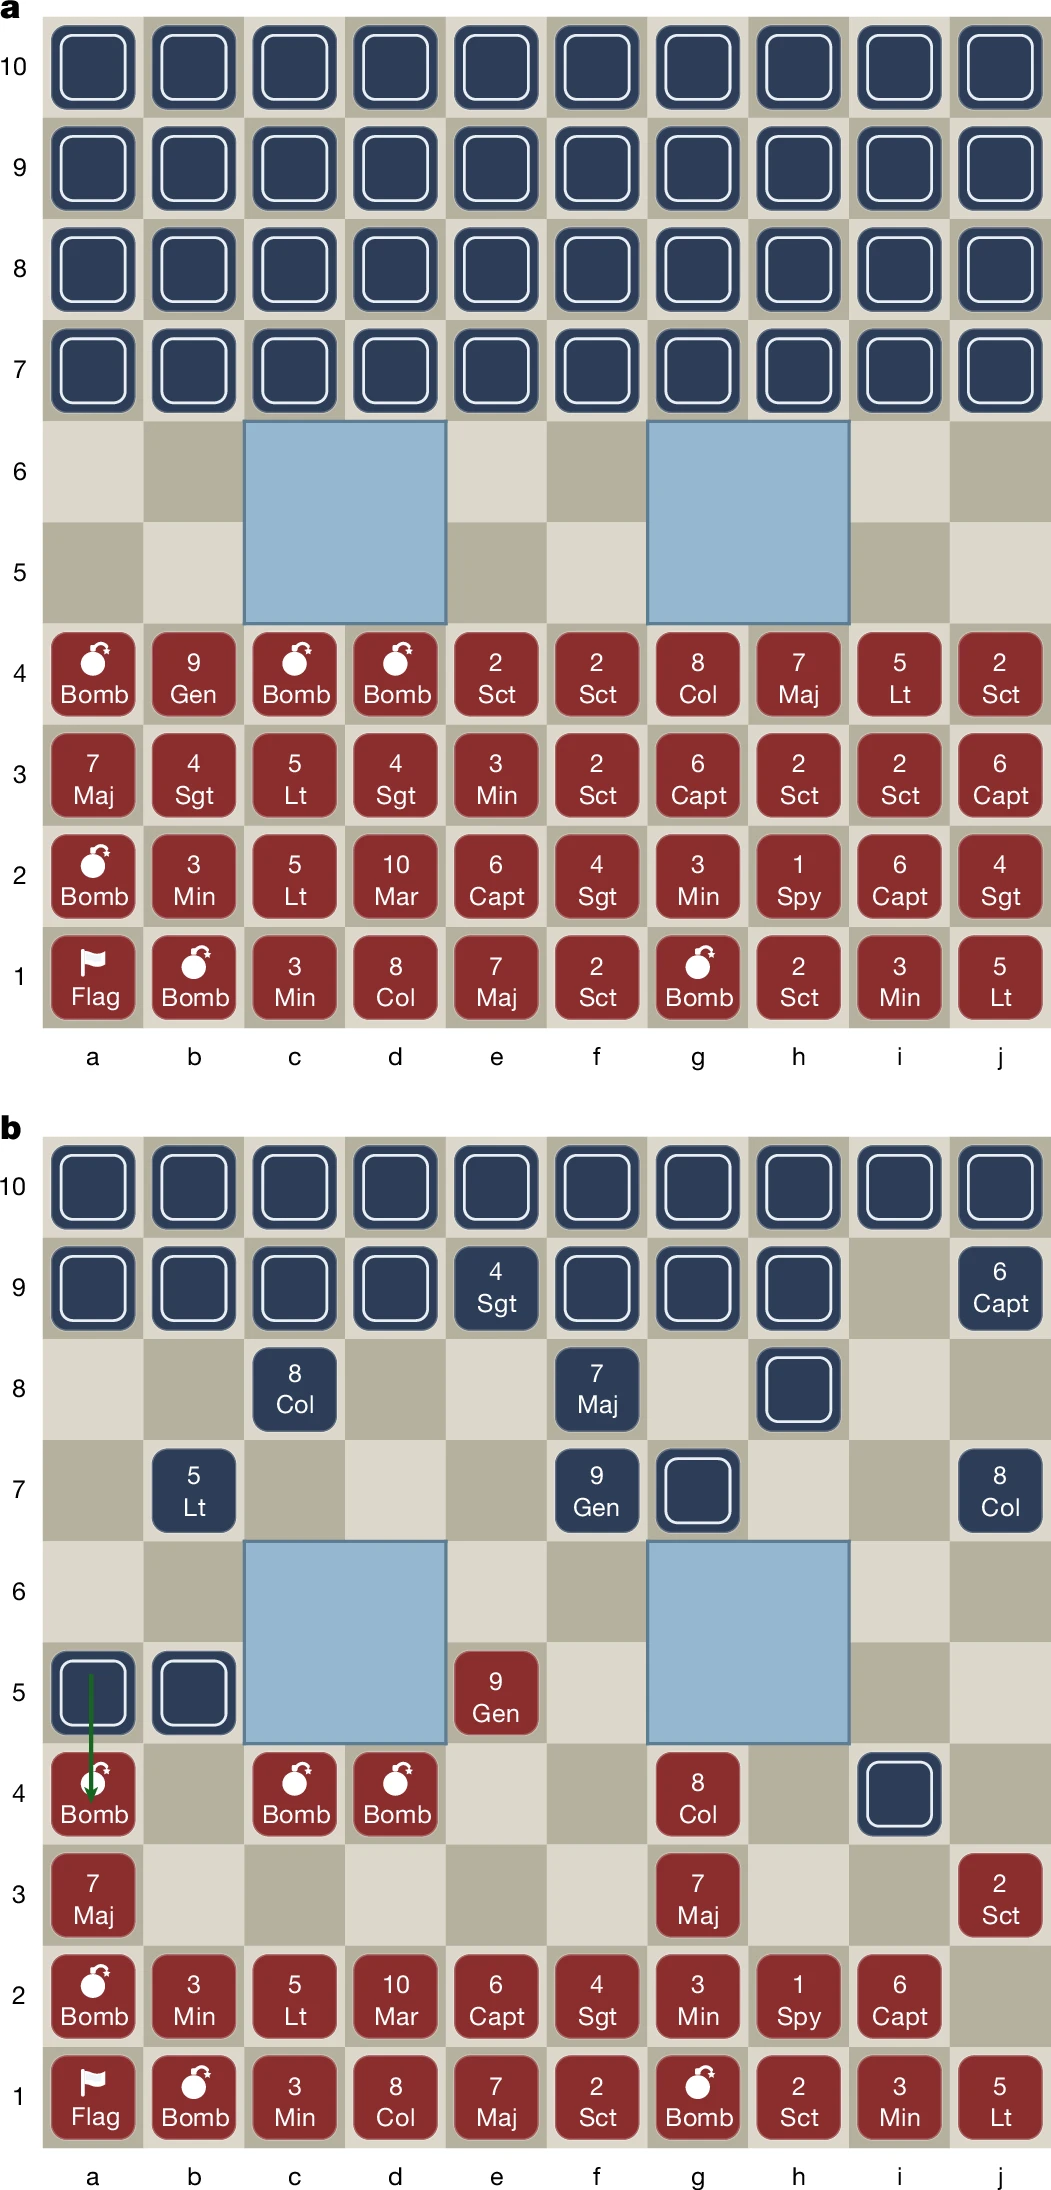
军棋对AI来说是极严峻的考验,因为双方会将40枚棋子扣着放置。根据论文,可能的开局阵型超过 $10^{33}$ 种。在这类信息不完全的博弈中,一步棋的价值不仅取决于之后的局势演变,还取决于决策前和决策过程中的情况,第一作者 Samuel Sokota 在 X 上写道。
据 Sokota 介绍,源自扑克AI的方法确实绕过了这一问题,但仅在隐藏信息较少的情况下有效。在德州扑克中,只有1,326种可能的起手牌,而论文指出,这些方法所需的计算量随隐藏信息量的增加而上升。因此,军棋曾是少数几个人类仍胜过AI的主要竞技棋类游戏之一。
大学预算击败了 DeepMind 数百万美元都做不到的事
DeepMind 此前曾在同一款游戏上未能突破顶级人类选手的水平。据论文所述,DeepNash 的作者回忆,该系统用了 1,024 个 TPU 节点训练了两到三个月。Ataraxos 团队估算,按 2025 年的价格,这要花掉 300 万到 450 万美元。
相比之下,Ataraxos 只用了 16 块 Nvidia H100 GPU 训练一周,外加其信念网络在 4 块 GPU 上多训练四天。按 2025 年的价格算,成本不到 8,000 美元。研究人员估算,其算力成本约为前者的 1/500,自对弈局数约为 1/30,训练样本约为 1/100。他们将此归功于自研的 GPU 模拟器,以及高得多的样本效率。Sokota 写道,团队受限于学术界的计算资源,多年来积累了大量实用技巧。
两套系统并没有进行过正面对决。研究人员表示,他们曾主动提出搭建对弈所需的基础设施,但 DeepMind 告知这不可行,因为 DeepNash 的代码已无法运行。在 2023 年的世界锦标赛上,DeepNash 在 28 局中赢了 19 局,但输给了大多数顶级选手,其中包括 Niemeijer。
迫使 AI 打法多样化,避免陷入僵局
Ataraxos 不使用任何人类数据,完全靠自对弈学习。论文指出,关键在于训练中施加的“变化压力”强度。训练中的一个额外约束条件会让 AI 分散自己的布阵和走法,而不是过早锁定固定策略。这就是所谓的正则化(regularization)。作者表示,这在 Stratego 中尤为重要,因为高水平对局需要大量随机性,打法可预测的玩家很容易被针对。
研究人员会随训练推进逐渐放松这种压力,并相应调整学习步长。早期,Ataraxos 打法变化很大,学习步伐也大;后期则打得更谨慎,只做小幅修正。这能避免学习过程陷入循环或变得混乱——这类问题在不完全信息博弈中很常见。研究人员把正则化比作一份能量储备:如果 AI 消耗得太快,虽然早期进步迅速,但会逐渐丧失持续学习的能力,而且往往变得容易被利用。
Atarixos 还采用了一种信念网络来预测对手藏起的棋子。在每次走棋前,AI 会利用该网络生成可能的游戏状态,推演候选着法,并针对当次决策执行额外的学习步骤。作者指出,以往的工作之所以跳过这种搜索,是因为在海量隐藏信息下,大家普遍认为其难度过高。
AI 克服内置劣势实现大胜
为避免疲劳并给 Niemeijer 留出备战时间,研究人员将对抗系列赛安排在整整三周内进行。Niemeijer 知道 Atarixos 不会针对他的风格做出调整。他因参与比赛获得 1,000 美元报酬,每赢一局再得 100 美元,每平一局得 50 美元,因此他有充分的动力去全力以赴。
作者表示,若将平局折算为半胜,Atarixos 的有效胜率高达 85%,这在最高竞技水平上前所未有。三届世界冠军亚军 Max Roelofs 指出,由于该游戏迫使玩家冒险,顶尖选手之间的差距本就毫厘必争。此外,AI 在结构上处于劣势。Niemeijer 可以在多局比赛中针对它进行调整,但 AI 却无法反向针对他。论文提到,三届世界冠军 Vincent de Boer 认为这是一个重大 handicap。
在 2025 年 Stratego 世界锦标赛期间的展示赛中,Atarixos 对阵参赛选手的 40 局里赢了 38 局。选手们形容它的棋风难以捉摸。AI 常做出人类认为风险过高的诈唬,落后时又极其顽强地拖延,让部分对手觉得不礼貌。它还显得幸运得近乎诡异,因为其棋子似乎总恰好位于最关键的位置。Atarixos 与 Niemeijer 的对局录像 已在线上公开。
该方法在 Stratego 之外的表现同样出色
研究人员利用同一方法构建了其他系统。在 Barrage 变体中,他们的 AI 击败了前四名中三位顶级选手,并在三场 50 局的系列赛中获胜,这三位选手均为两届 Barrage 世界冠军。在合作卡牌游戏《花火》(Hanabi)中,该 AI 在所有变体中均刷新纪录;在双人对局版本中,其算力需求比此前的领先者低两个数量级。在中国卡牌游戏《斗地主》中,它击败了 PerfectDou 和 DouZero 这两个先前的基准系统。
作者据此得出一个结论:大量隐藏信息已不再是强化学习和搜索算法的障碍。这意味着,只要能为这些策略决策问题构建快速且精确的模拟器,实用型AI便触手可及。文中举例称,金融市场、军事冲突和谈判等场景均属于此类不完全信息环境。
研究人员承认存在一项局限:由于搜索过程仅模拟了单次学习步骤,仅靠增加计算时间无法持续提升性能。若采用更复杂的搜索方法,或许能打破这一瓶颈。研究团队已将 Ataraxos 的代码 公开。